Passo 1 de 9
Erro, correção e incerteza
Diferencie erro, correção, dispersão e incerteza residual em medições.
Trilha de aprendizado · Nível 15 · Tutorial 6
Escolher modelos simples para representar informações de medição e obter incertezas padrão sem confundir limites garantidos, dispersão das leituras e incerteza da média.
 Erro, correção e incerteza
Diferencie erro, correção, dispersão e incerteza residual em medições. 2 min
 O que uma distribuição representa
Use distribuições como modelos de probabilidade para interpretar faixas, distinguir parâmetros de estimativas amostrais e entender a incerteza padrão sem tratá-la como limite garantido. 3 min
 Probabilidades no modelo retangular
Identifique a semilargura e calcule probabilidades de faixas sob uma hipótese retangular explicitamente declarada. 3 min
 Da semilargura à incerteza padrão
Converta limites de uma contribuição retangular em incerteza padrão, identificando a semilargura, mantendo a unidade e registrando a hipótese do modelo. 3 min
 Como interpretar o modelo normal
Interprete áreas, concentração e a faixa μ ± σ no modelo normal, distinguindo-o do modelo retangular sem inferir normalidade apenas pela aparência dos dados. 3 min
 Quando as repetições trazem informação nova
Avalie estabilidade e independência a partir da sequência temporal e do procedimento de aquisição, sem presumir que um gráfico irregular prove independência. 3 min
 Incerteza padrão da média
Use o desvio-padrão amostral e o número de leituras para estimar a contribuição de repetibilidade da média, reconhecendo as hipóteses e os limites dessa redução. 3 min
 O que repetir a medição não resolve
Reconheça por que contribuições comuns, como referência, offset estável e incerteza residual de correção, permanecem mesmo ao calcular a média de muitas leituras. 2 min
 Aplicação final: escolher, calcular e justificar
Aplicação final com um monitor de temperatura: escolha de modelo, cálculos separados e justificativas de limitações. 4 min
Passo 1 de 9
Diferencie erro, correção, dispersão e incerteza residual em medições.
Ao medir uma temperatura, compare a indicação com uma referência caracterizada, mas não a trate como verdade perfeita.
A dispersão já observada descreve a série; ela não resume, sozinha, tudo o que permanece incerto.
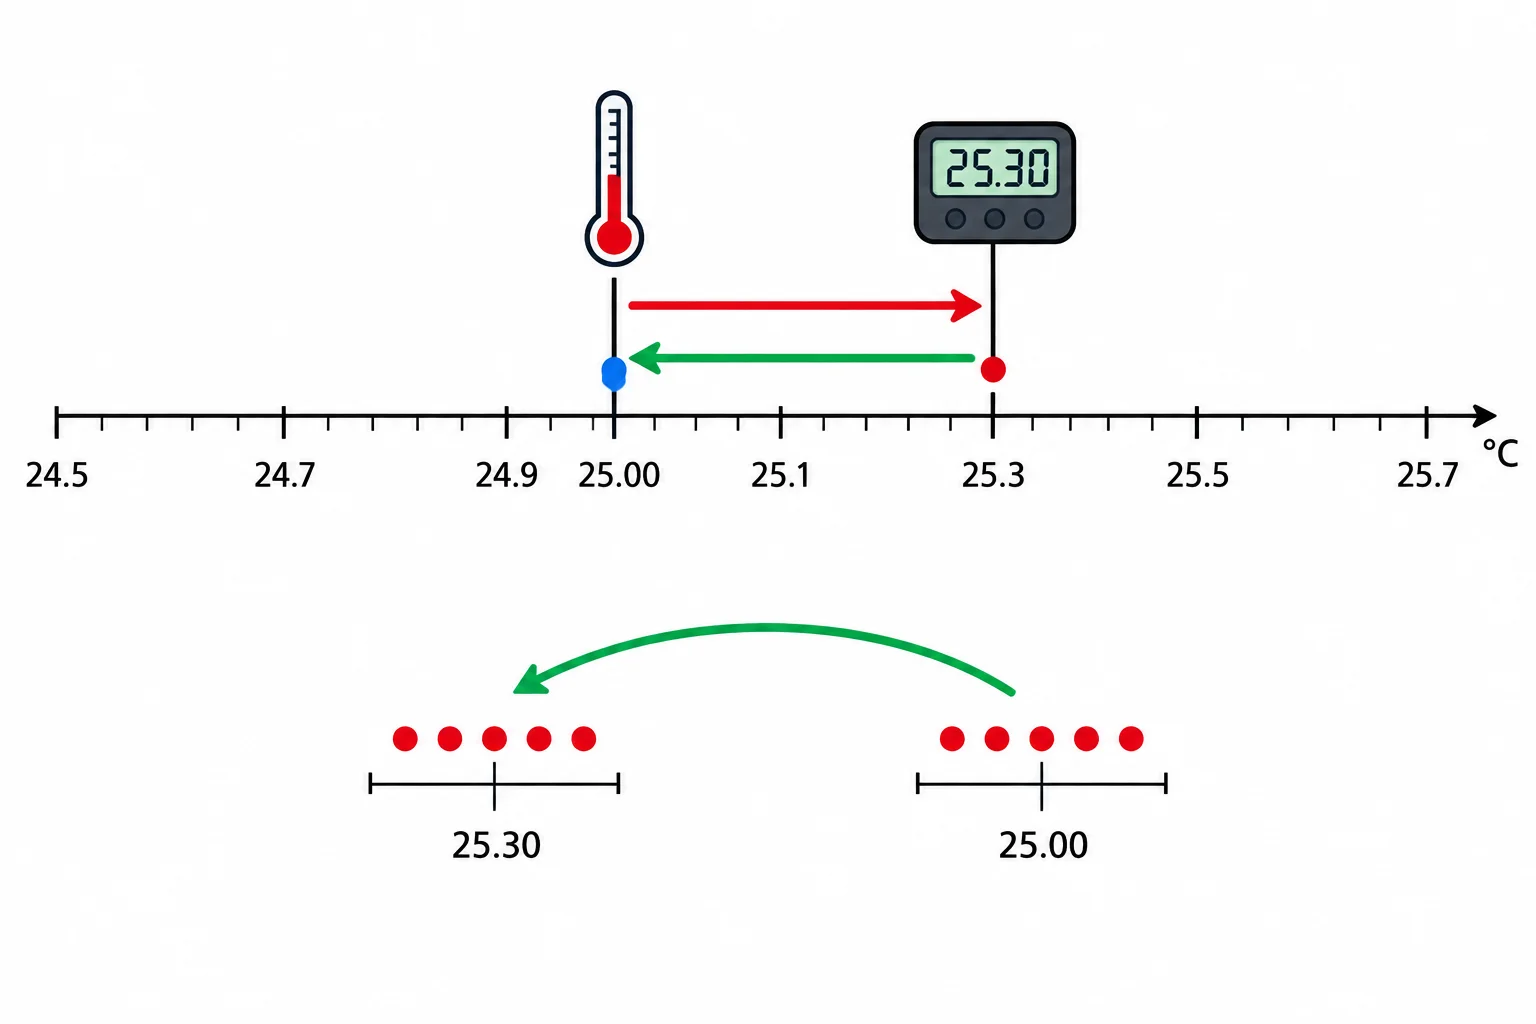
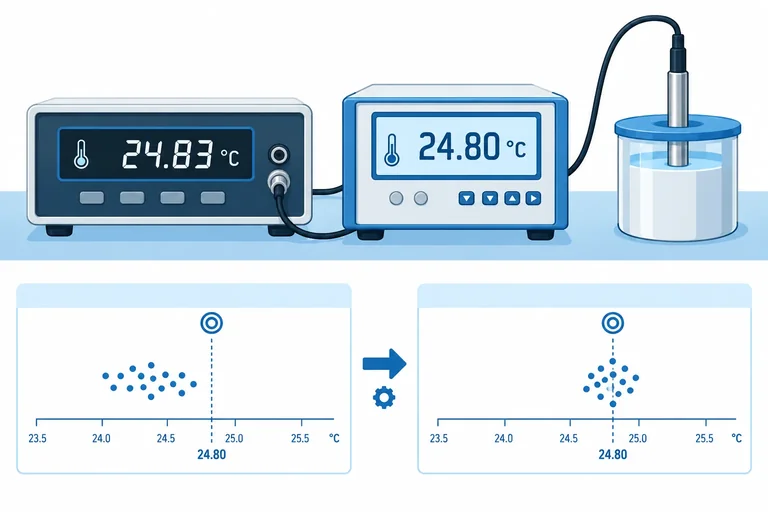
Uma correção pode deslocar o centro das leituras, mas não apaga automaticamente o espalhamento nem a incerteza sobre a própria correção.
Considere uma referência que indica 25,00 °C, com incerteza própria documentada. Um instrumento, nas mesmas condições, indica 25,30 °C.
Adotando a referência para esta comparação:
erro = indicação − referência = 25,30 − 25,00 = +0,30 °C
O sinal positivo diz que a indicação está acima da referência. Não significa que a referência seja exatamente 25,00 °C; ela também tem limitação conhecida.
Exemplo
Para compensar o efeito estimado de +0,30 °C, aplique a correção de −0,30 °C:
resultado corrigido = indicação + correção
resultado corrigido = 25,30 °C + (−0,30 °C) = 25,00 °C
A correção é uma estimativa, não uma prova de valor exato. Se o valor do desvio foi estimado com informação limitada, permanece incerteza sobre a correção. Também podem restar efeitos do sensor, da referência e das condições de medição.
Em cinco leituras de uma fonte estável, um instrumento forneceu valores próximos de 25,30 °C. Após aplicar −0,30 °C a cada leitura, os valores ficam próximos de 25,00 °C.
O que mudou — e o que não mudou? Faça as associações.
Relacione a informação à interpretação mais adequada.
Faça as correspondências.
Toque em um item e depois no par correspondente.
A correção trata um efeito estimado; ela não torna uma medição automaticamente exata.
Em uma análise bem registrada, anote separadamente:
Nos próximos passos, você vai usar modelos de distribuição para expressar algumas dessas incertezas de modo quantitativo.
Resumo
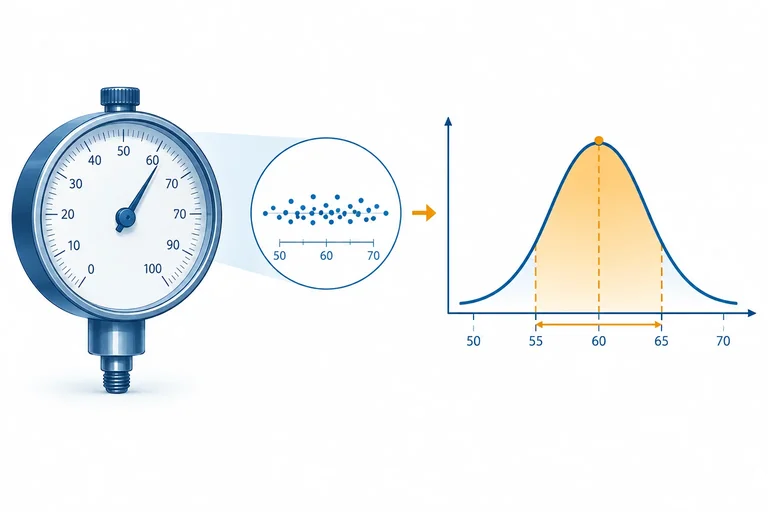
Passo 2 de 9
Use distribuições como modelos de probabilidade para interpretar faixas, distinguir parâmetros de estimativas amostrais e entender a incerteza padrão sem tratá-la como limite garantido.
Probabilidade é uma medida de 0 a 1: por exemplo, 0,25 equivale a 25%. Uma distribuição é um modelo que reparte essa probabilidade entre faixas possíveis de uma grandeza.
Ao olhar uma curva de distribuição, a probabilidade de uma faixa é representada pela área sob a curva naquela faixa. A altura da curva em um único valor não é, sozinha, uma probabilidade: um ponto isolado não tem largura de faixa.
O modelo descreve o que se considera plausível sob certas hipóteses; ele não cria uma garantia física sobre a próxima leitura.
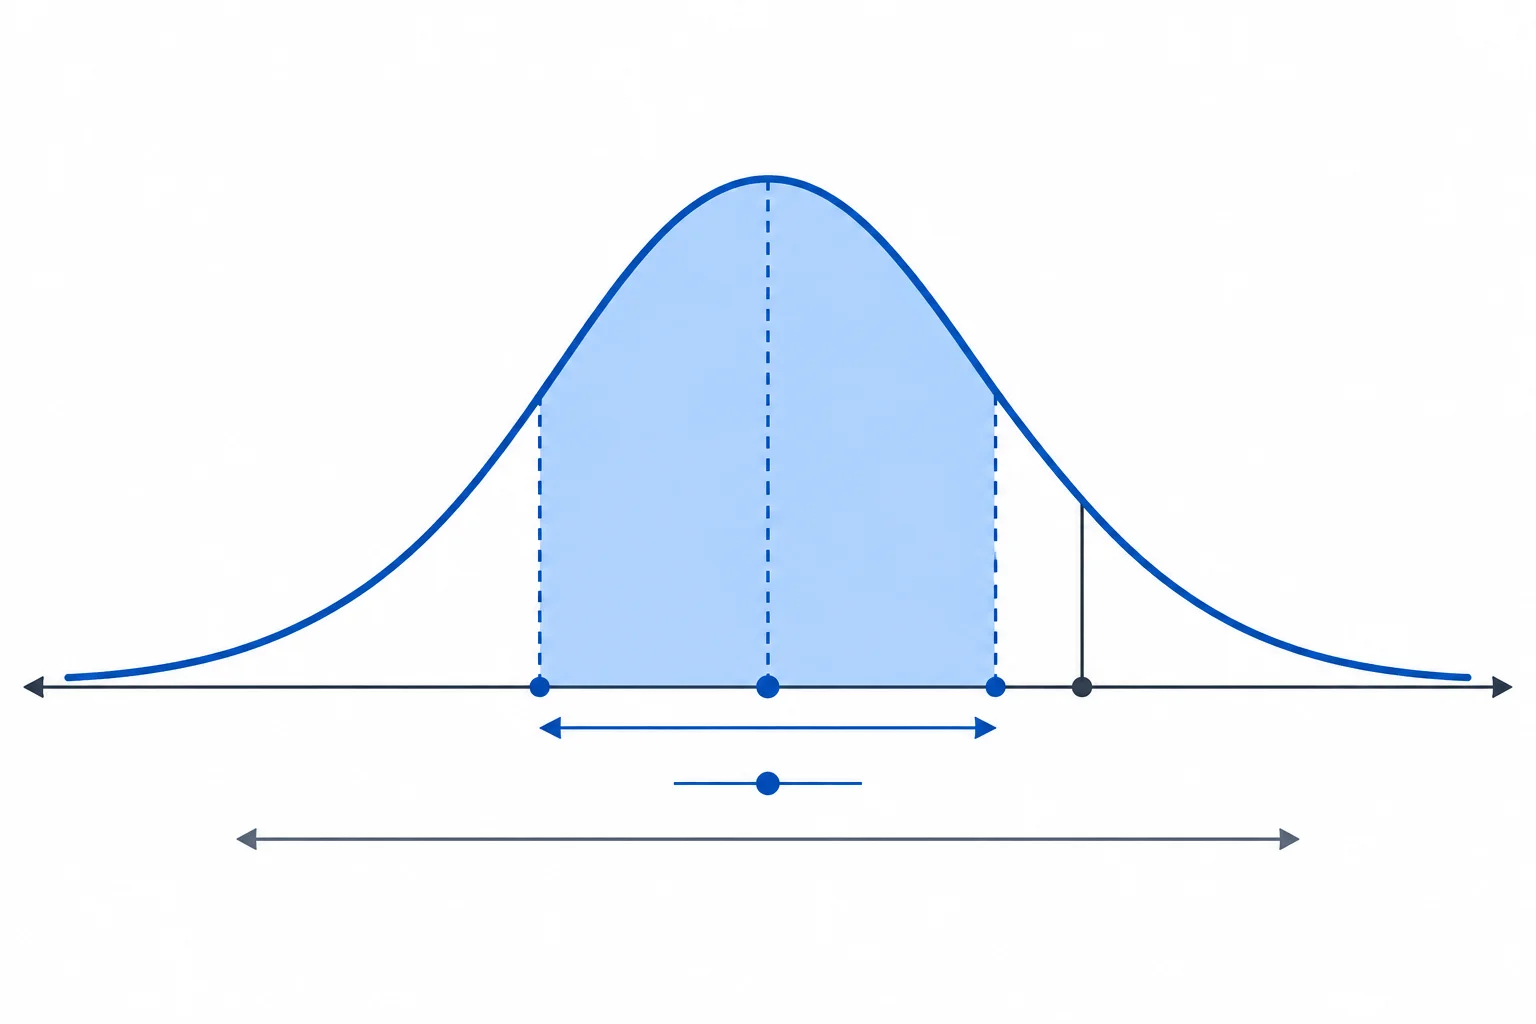
A probabilidade de uma faixa corresponde à área sombreada sob o modelo nessa faixa; não à altura da curva em um ponto.
As leituras que você já organizou são uma amostra finita. Sua média e seu desvio-padrão amostral resumem os dados observados. Já uma distribuição descreve um modelo probabilístico com parâmetros próprios.
Não conclua que uma frequência observada é uma promessa para o futuro. Por exemplo, observar 8 resultados em certa faixa entre 10 leituras não garante que as próximas leituras ficarão nessa faixa, nem transforma os extremos observados em limites garantidos.
Use a notação de acordo com o que está descrevendo:
| Elemento | No modelo probabilístico | Na amostra de leituras |
|---|---|---|
| Centro | Média μ | Média amostral x̄ |
| Dispersão | Desvio-padrão σ | Desvio-padrão amostral s |
| Origem | Hipóteses e parâmetros adotados | Dados finitos observados |
A incerteza padrão, indicada por u, expressa uma incerteza na forma de um desvio-padrão. Ela mantém a unidade da grandeza: se o resultado está em °C, u também está em °C; se está em V, u está em V.
Ela não é:
A origem da informação e o modelo adotado determinam como obter u. Nos próximos steps, você verá modelos específicos e conversões justificadas.
Qual interpretação está correta?
Passo 3 de 9
Identifique a semilargura e calcule probabilidades de faixas sob uma hipótese retangular explicitamente declarada.
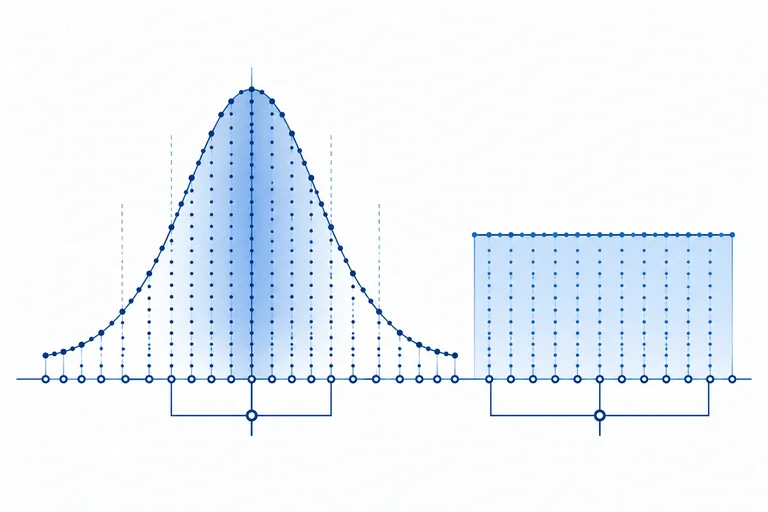
Use o modelo retangular quando houver justificativa para tratar todos os valores de um intervalo como igualmente plausíveis.
Se o centro é m e a distância do centro a cada limite é a, o intervalo vai de m − a até m + a:
A grandeza a é a semilargura: ela mede apenas do centro até um limite. Não confunda com a largura total do intervalo.
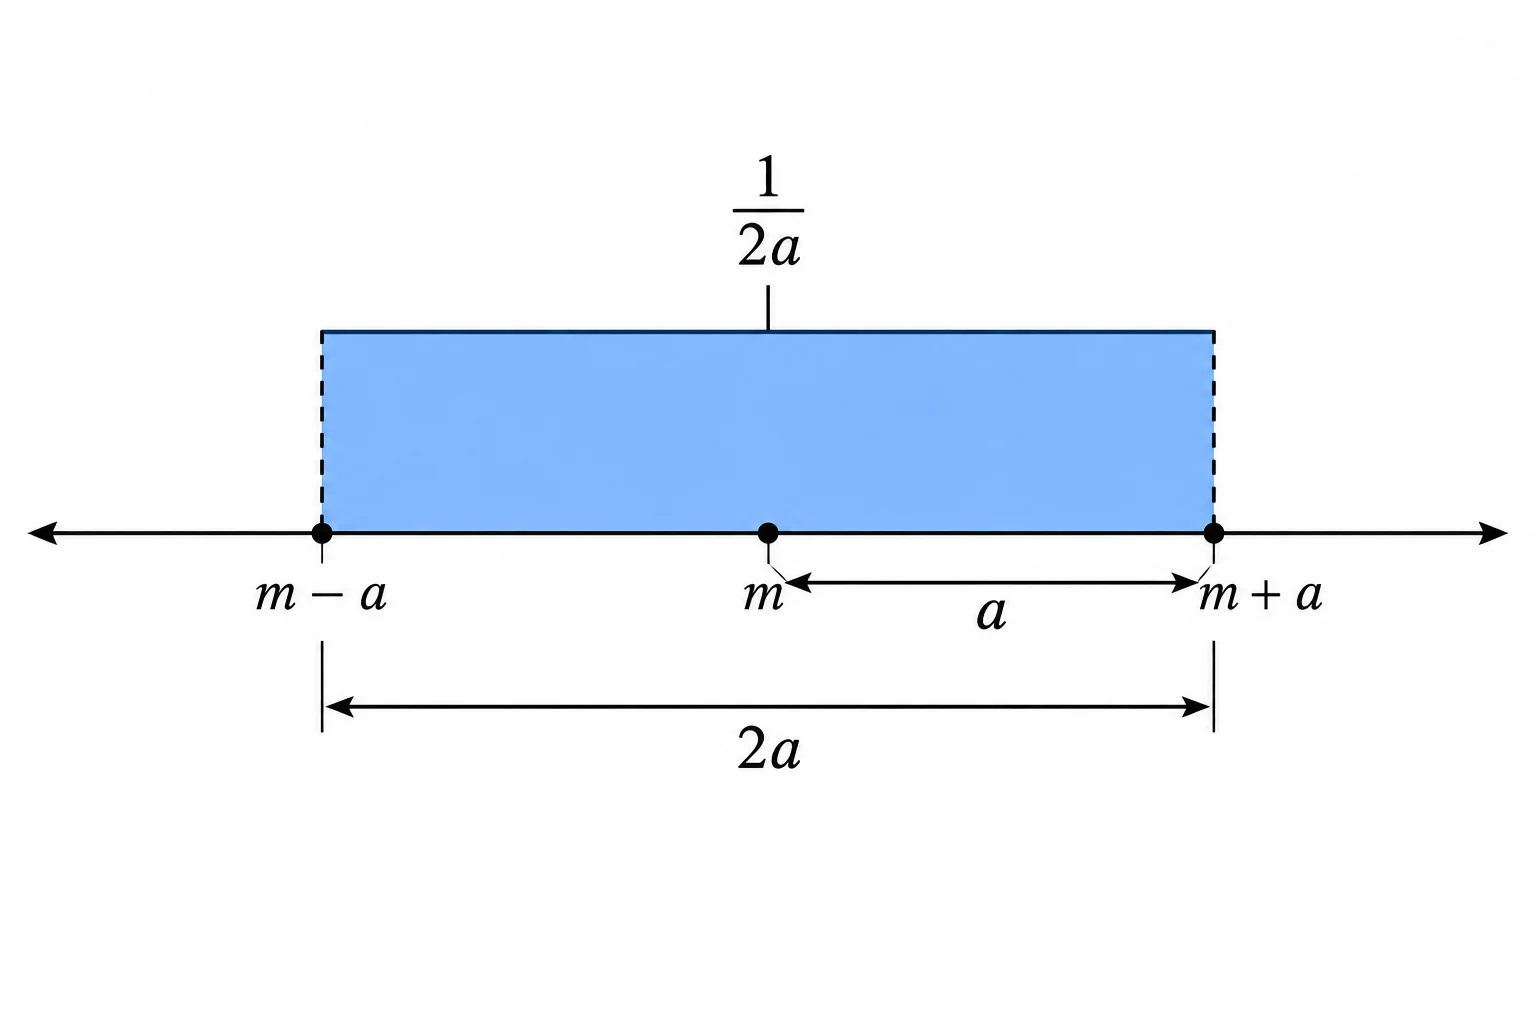
No modelo retangular, a altura é constante dentro do intervalo adotado.
Em um modelo retangular, faixas internas de mesma largura têm a mesma probabilidade, mesmo que estejam em posições diferentes.
Para uma faixa totalmente contida no intervalo, calcule:
probabilidade da faixa = largura da faixa ÷ largura total
Como a largura total é 2a:
P = largura da faixa ÷ 2a
A altura do retângulo não é a probabilidade de um ponto. A probabilidade é representada pela área; neste modelo de altura constante, isso equivale à proporção das larguras.
Exemplo
Considere um intervalo de 8,0 °C a 12,0 °C, com centro m = 10,0 °C.
Sob o modelo retangular justificado:
P(9,0 °C a 10,0 °C) = 1,0 ÷ 4,0 = 0,25 = 25%
Uma faixa de 11,0 °C a 12,0 °C também tem 1,0 °C de largura e, portanto, também recebe 25%.
Atenção
O retângulo não surge apenas porque existe um limite numérico.
Por exemplo, uma ficha pode informar “erro máximo de ±2 °C” em certas condições. Essa informação, sozinha, não demonstra que todos os valores entre −2 °C e +2 °C sejam igualmente plausíveis. Para usar o modelo retangular, registre a hipótese que o sustenta.
Também não transforme o resultado do modelo em uma garantia física: dizer que a probabilidade é zero fora do intervalo é uma propriedade do modelo adotado, não uma prova de que uma ocorrência externa seja impossível no experimento real.
Ao documentar uma análise, diferencie estas duas frases:
A escolha do modelo deve acompanhar a informação disponível e o objetivo da análise.
Qual diagrama representa duas faixas com a mesma probabilidade em um modelo retangular?
Escolha o diagrama correto.
No exemplo de 8,0 °C a 12,0 °C, complete a probabilidade da faixa de 9,0 °C a 10,0 °C: {{blank}}.
Passo 4 de 9
Converta limites de uma contribuição retangular em incerteza padrão, identificando a semilargura, mantendo a unidade e registrando a hipótese do modelo.
No modelo retangular, a contribuição pode assumir valores igualmente plausíveis entre m − a e m + a. A semilargura a é a distância do centro a um limite.
A incerteza padrão desse modelo é:
u = a / √3
Essa relação transforma a semilargura em uma medida de dispersão equivalente ao desvio-padrão do modelo. Ela não altera a unidade: se a está em °C, u também estará em °C.
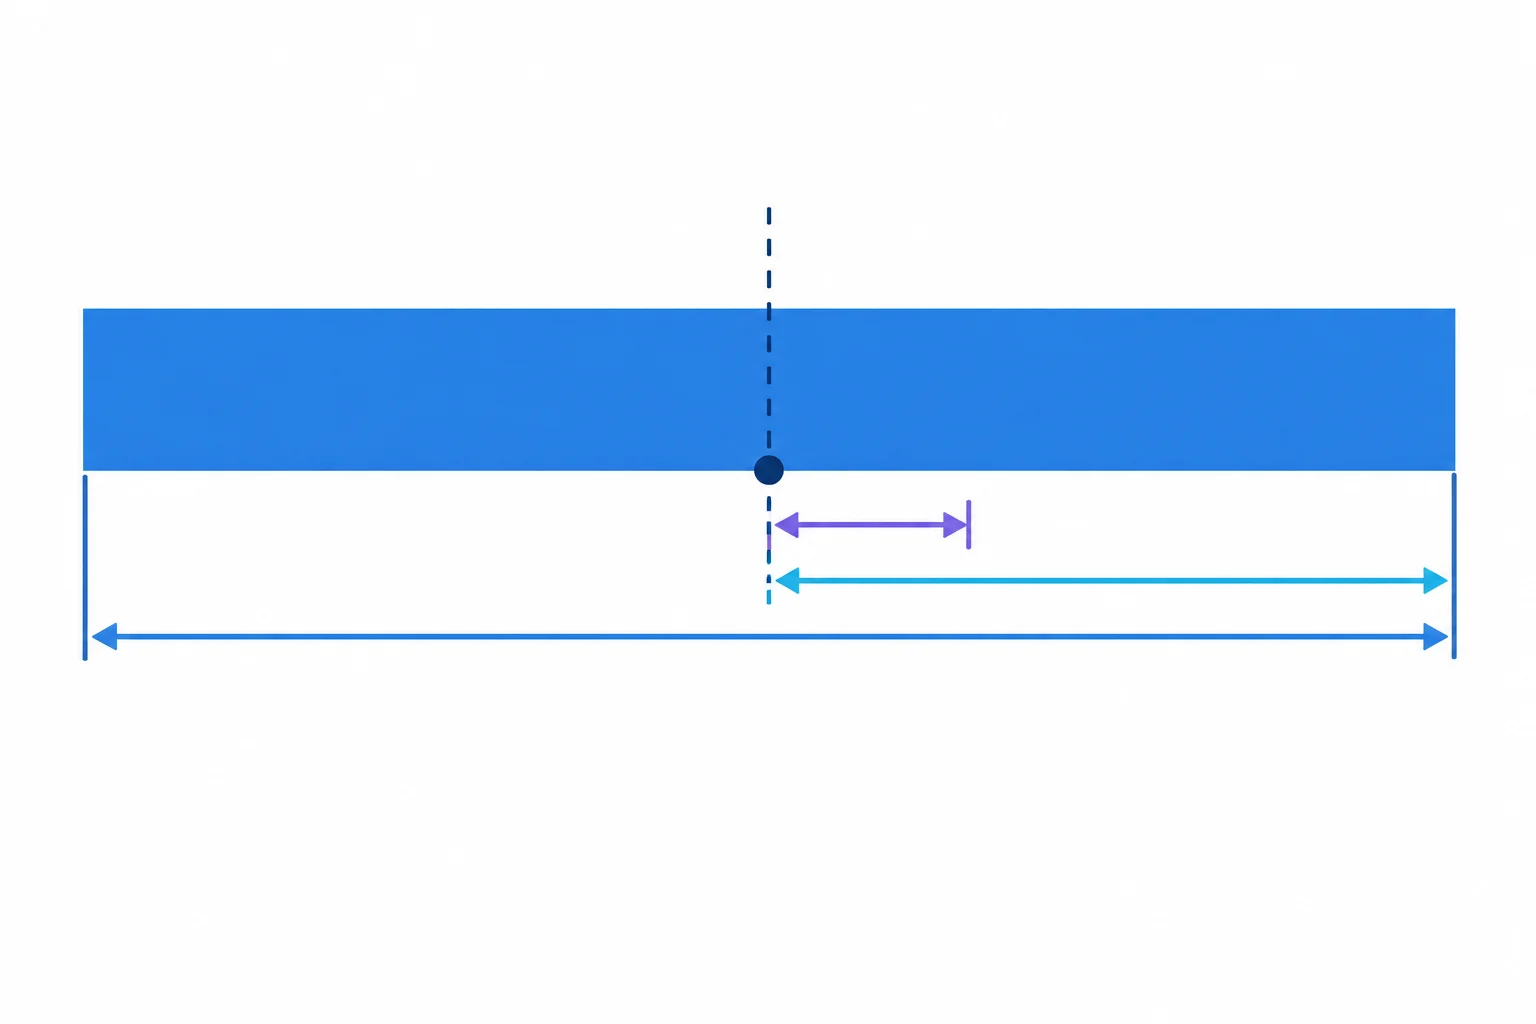
A largura total é 2a; a semilargura é a; no modelo retangular, a incerteza padrão é a/√3. Não são a mesma grandeza.
A informação disponível pode vir em formatos diferentes. Primeiro, encontre a; só então aplique u = a/√3.
Exemplos de apresentação de um mesmo intervalo centrado em 10,0 V.
| Informação apresentada | Largura total | Semilargura a | Incerteza padrão u |
|---|---|---|---|
| 9,4 V a 10,6 V | 1,2 V | 0,6 V | 0,6/√3 ≈ 0,35 V |
| 10,0 V ± 0,6 V | 1,2 V | 0,6 V | 0,6/√3 ≈ 0,35 V |
| Largura total de 1,2 V | 1,2 V | 0,6 V | 0,6/√3 ≈ 0,35 V |
Exemplo
Uma especificação declara que um efeito está entre −0,24 mV e +0,24 mV, e a análise adotou justificadamente um modelo retangular.
A semilargura é a = 0,24 mV. Portanto:
u = 0,24 mV / √3 ≈ 0,139 mV
Não use 0,48 mV na fórmula: esse é o intervalo total, ou 2a.
Atenção
A divisão por √3 é uma propriedade do modelo retangular adotado. Ela exige uma justificativa para tratar todos os valores dentro do intervalo como igualmente plausíveis.
Um limite garantido, um máximo observado ou apenas a frase “erro até 1 °C” não demonstram, por si só, que esse modelo é adequado. Registre a origem do intervalo e a hipótese usada. Se a distribuição não estiver justificada, não aplique a conversão automaticamente.
Uma contribuição é informada como ±0,30 °C e o modelo retangular foi explicitamente justificado. Complete: u ≈ [lacuna].
Passo 5 de 9
Interprete áreas, concentração e a faixa μ ± σ no modelo normal, distinguindo-o do modelo retangular sem inferir normalidade apenas pela aparência dos dados.
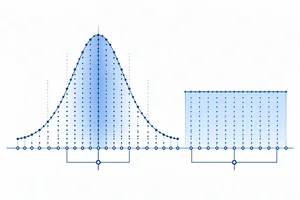
O modelo normal é uma distribuição simétrica em forma de sino, centrada na média μ. O parâmetro σ determina sua dispersão: um σ maior produz uma curva mais espalhada; um σ menor, uma curva mais concentrada.
Como nos demais modelos, probabilidades pertencem a faixas de valores: são representadas pela área sob a curva, e não pela altura da curva em um ponto.
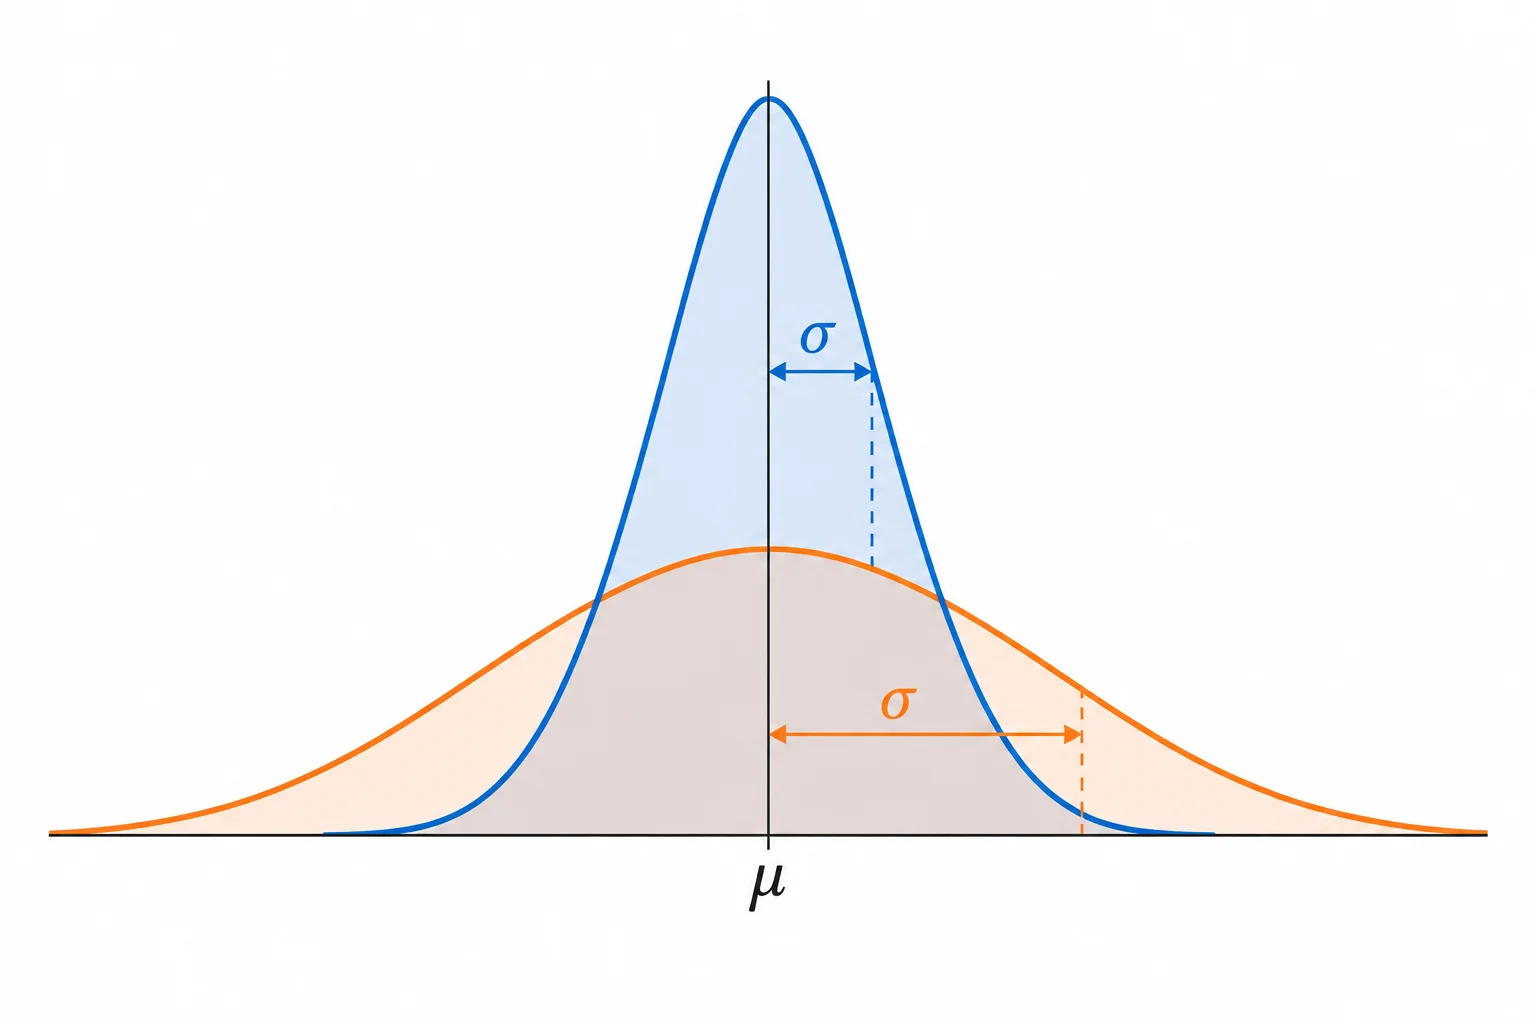
σ descreve a dispersão do modelo em torno de μ.
Dica
A curva normal não estabelece limites rígidos. O modelo atribui probabilidades cada vez menores a valores muito afastados de μ, mas não define um ponto além do qual a probabilidade passe a ser exatamente zero.
Isso contrasta com o retangular, no qual os limites adotados delimitam todo o intervalo com probabilidade diferente de zero.
Considere duas faixas com a mesma largura, posicionadas em lugares diferentes de uma curva normal. A faixa próxima de μ tem maior área sob a curva e, portanto, maior probabilidade do que a faixa afastada.
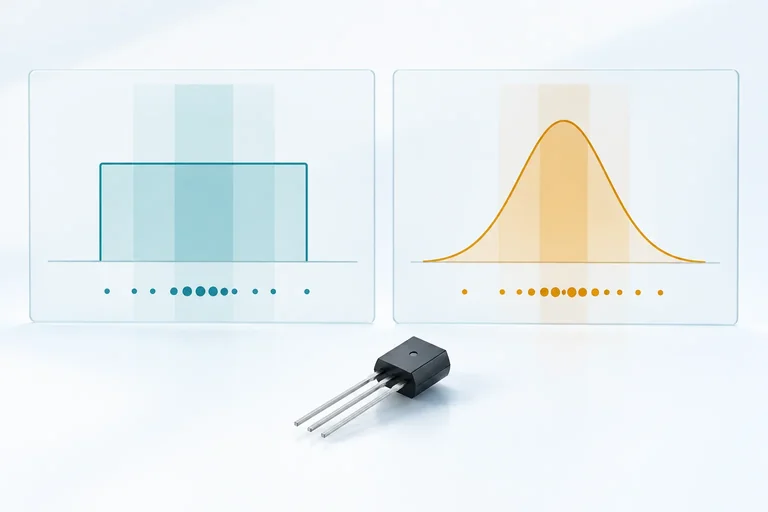
No modelo retangular, faixas internas de mesma largura têm a mesma probabilidade. Essa diferença vem da concentração de probabilidade: uniforme no retangular e maior no centro do normal.
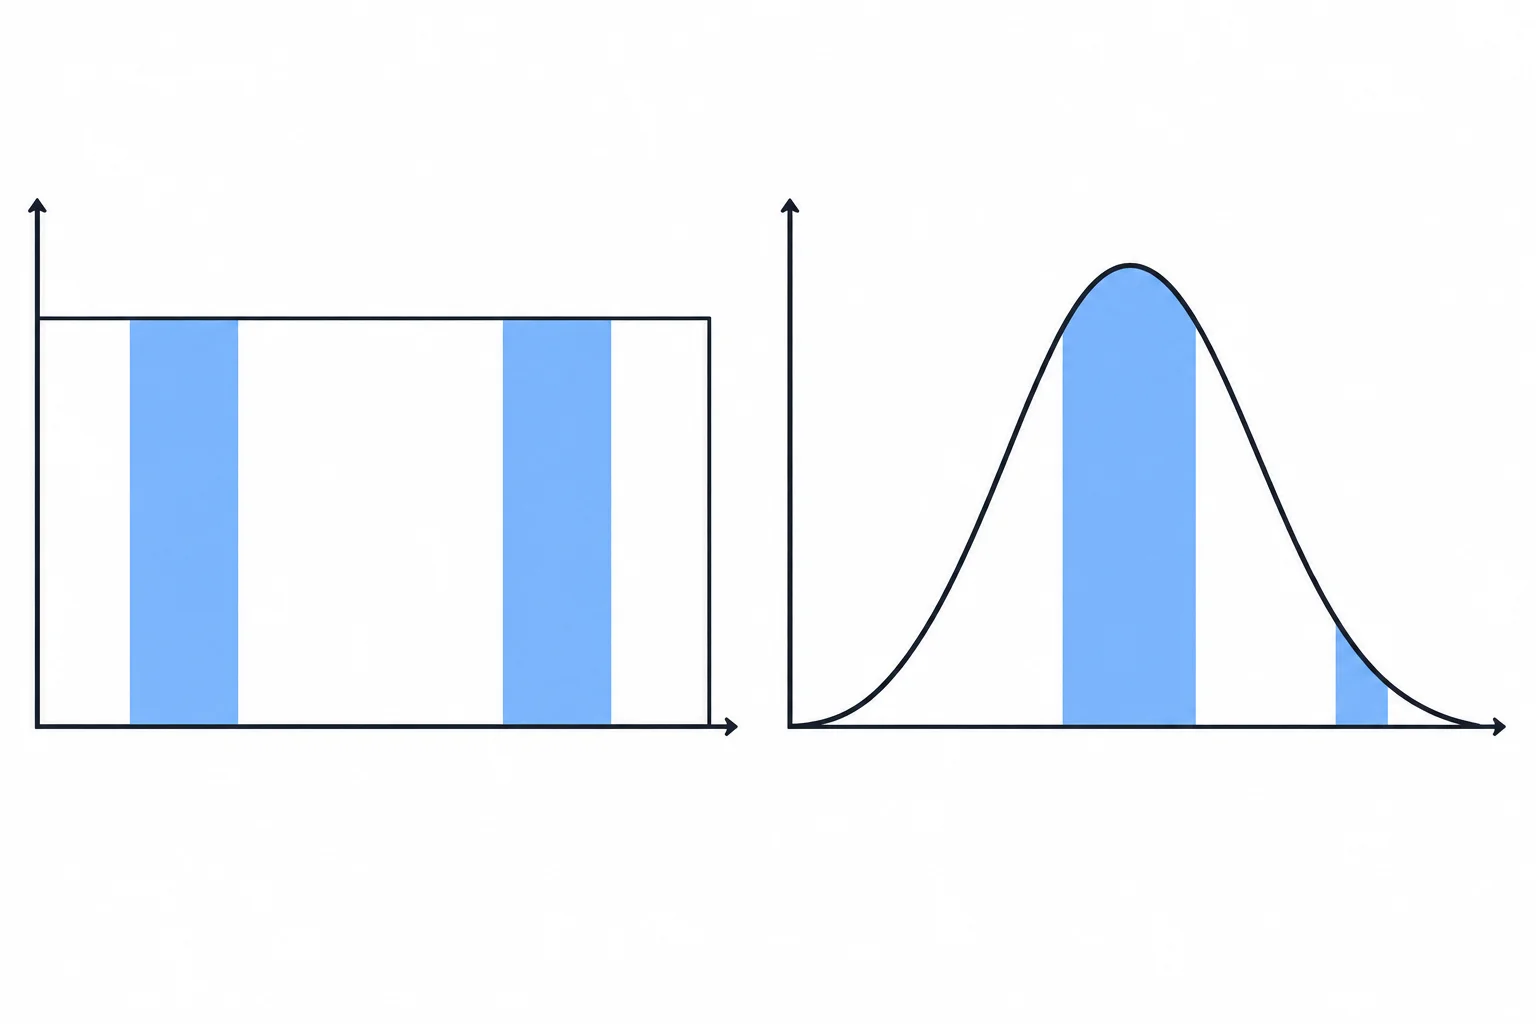
Mesma largura não significa mesma probabilidade no modelo normal.
Exemplo
Para um modelo normal cujos parâmetros são conhecidos, a faixa de μ − σ até μ + σ contém aproximadamente 68% da probabilidade.
É uma propriedade desse modelo. Não use “68%” apenas porque calculou uma média e um desvio-padrão para um conjunto de leituras.
Use a comparação abaixo para manter os dois modelos separados.
Características dos modelos probabilísticos
| Característica | Retangular | Normal |
|---|---|---|
| Concentração | Uniforme dentro do intervalo | Maior perto de μ |
| Faixas iguais | Mesma probabilidade | Probabilidades podem diferir |
| Limites | Há limites no modelo | Não há limites rígidos |
| Papel de σ | u = a/√3 no modelo | Controla o espalhamento |
| Faixa μ ± σ | Não implica 68% | Aproximadamente 68% |
Atenção
Uma sequência de leituras pode parecer simétrica e ainda assim não fornecer evidência suficiente para adotar um modelo normal. Também não basta ter calculado média e desvio-padrão.
A escolha deve ser apoiada pelo processo de medição, pela origem da variação e pelas informações disponíveis. Não conclua normalidade somente pela aparência de uma amostra; testes formais e inferências sobre parâmetros não são o foco aqui.
Julgue a afirmação:
“Em um modelo normal, uma faixa de mesma largura localizada perto de μ tem a mesma probabilidade que outra faixa, de mesma largura, muito afastada de μ.”
A afirmação é verdadeira ou falsa?
Julgue a afirmação:
“Se uma amostra tem média e desvio-padrão calculados, então a faixa média ± desvio-padrão contém aproximadamente 68% de probabilidade.”
A afirmação é verdadeira ou falsa?
Passo 6 de 9
Avalie estabilidade e independência a partir da sequência temporal e do procedimento de aquisição, sem presumir que um gráfico irregular prove independência.
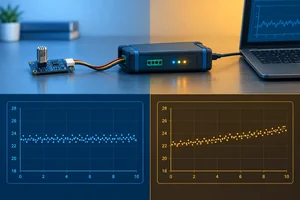
Antes de usar várias leituras como repetições comparáveis, verifique se as condições relevantes permaneceram suficientemente constantes durante a série: grandeza medida, ambiente, alimentação, instrumento e procedimento.
Uma deriva — tendência de subida ou descida ao longo do tempo — é um alerta. Nesse caso, as leituras podem estar registrando uma mudança real do sistema ou do processo de medição, e não apenas variações em torno de um estado estável.
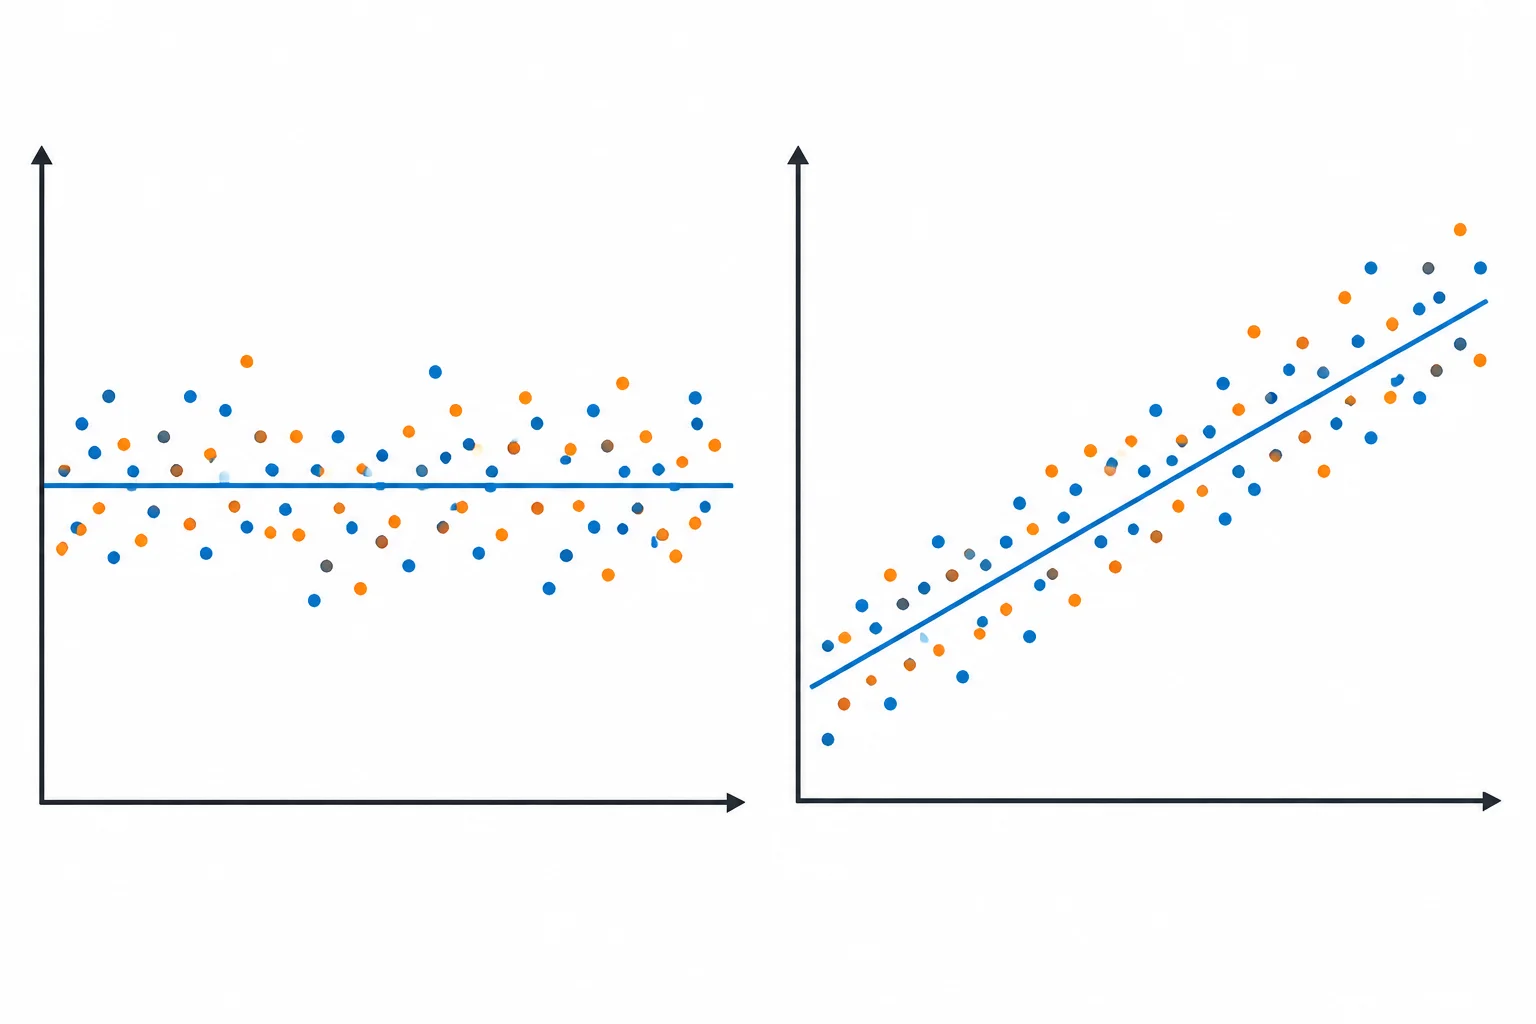
Oscilar em torno de um nível é diferente de mudar sistematicamente ao longo do tempo.
Leituras são tratadas como independentes quando saber o desvio de uma leitura em relação ao valor central não traz informação adicional sobre o desvio da próxima, nas mesmas condições.
A aparência irregular da série ajuda na investigação, mas não prova independência. Examine também como os dados foram adquiridos. Leituras muito próximas no tempo podem compartilhar efeitos lentos; e valores calculados por filtro ou média móvel podem reutilizar dados anteriores.
Exemplo
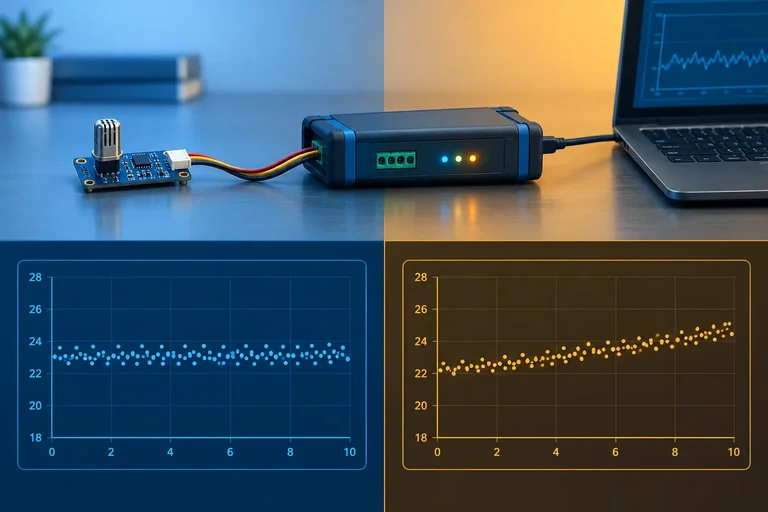
Compare dois registros de temperatura:
Mesmo que ambos os gráficos pareçam estáveis, o Registro B tem amostras compartilhadas entre valores consecutivos. Por isso, seus valores sucessivos podem ser dependentes. O Registro A ainda precisa de justificativa baseada no procedimento e no comportamento temporal, mas não tem esse compartilhamento explícito.
Dica
Filtragem e médias móveis são úteis para exibir ou controlar sinais, mas não transformam automaticamente cada valor publicado em uma repetição independente.
Uma série de 30 leituras de tensão não mostra tendência visual clara. Ela foi obtida publicando, a cada 100 ms, uma média móvel das últimas 20 conversões do ADC. Qual conclusão é mais adequada?
Escolha a melhor interpretação.
Considere esta aquisição: um monitor registra 12 temperaturas, uma a cada 2 segundos. Os valores sobem quase continuamente de 24,1 °C para 24,8 °C. Durante o registro, o circuito estava aquecendo após ser energizado.
Em poucas frases, diga qual hipótese fica enfraquecida e que informação ou mudança de procedimento ajudaria a obter repetições mais defensáveis.
Escreva pelo menos 80 caracteres (0/80).
Passo 7 de 9
Use o desvio-padrão amostral e o número de leituras para estimar a contribuição de repetibilidade da média, reconhecendo as hipóteses e os limites dessa redução.
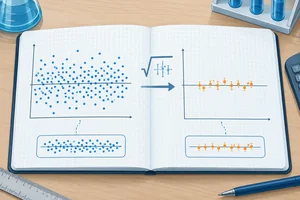
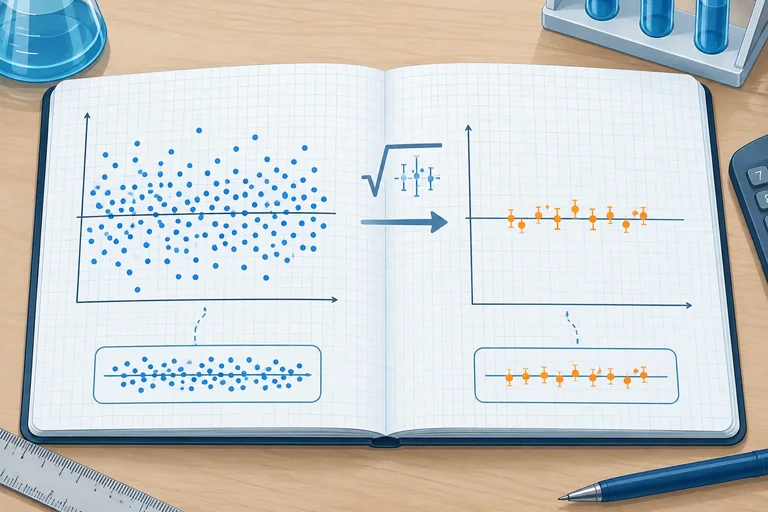
Você já calculou s, o desvio-padrão amostral das leituras individuais. Ao informar a média de uma série, a contribuição de repetibilidade associada a ela é menor: sua estimativa é
u_média = s / √n
em que n é o número de leituras.
Use essa relação somente quando as leituras representarem condições suficientemente estáveis e repetições independentes — hipóteses que devem ser justificadas pelo procedimento de aquisição.
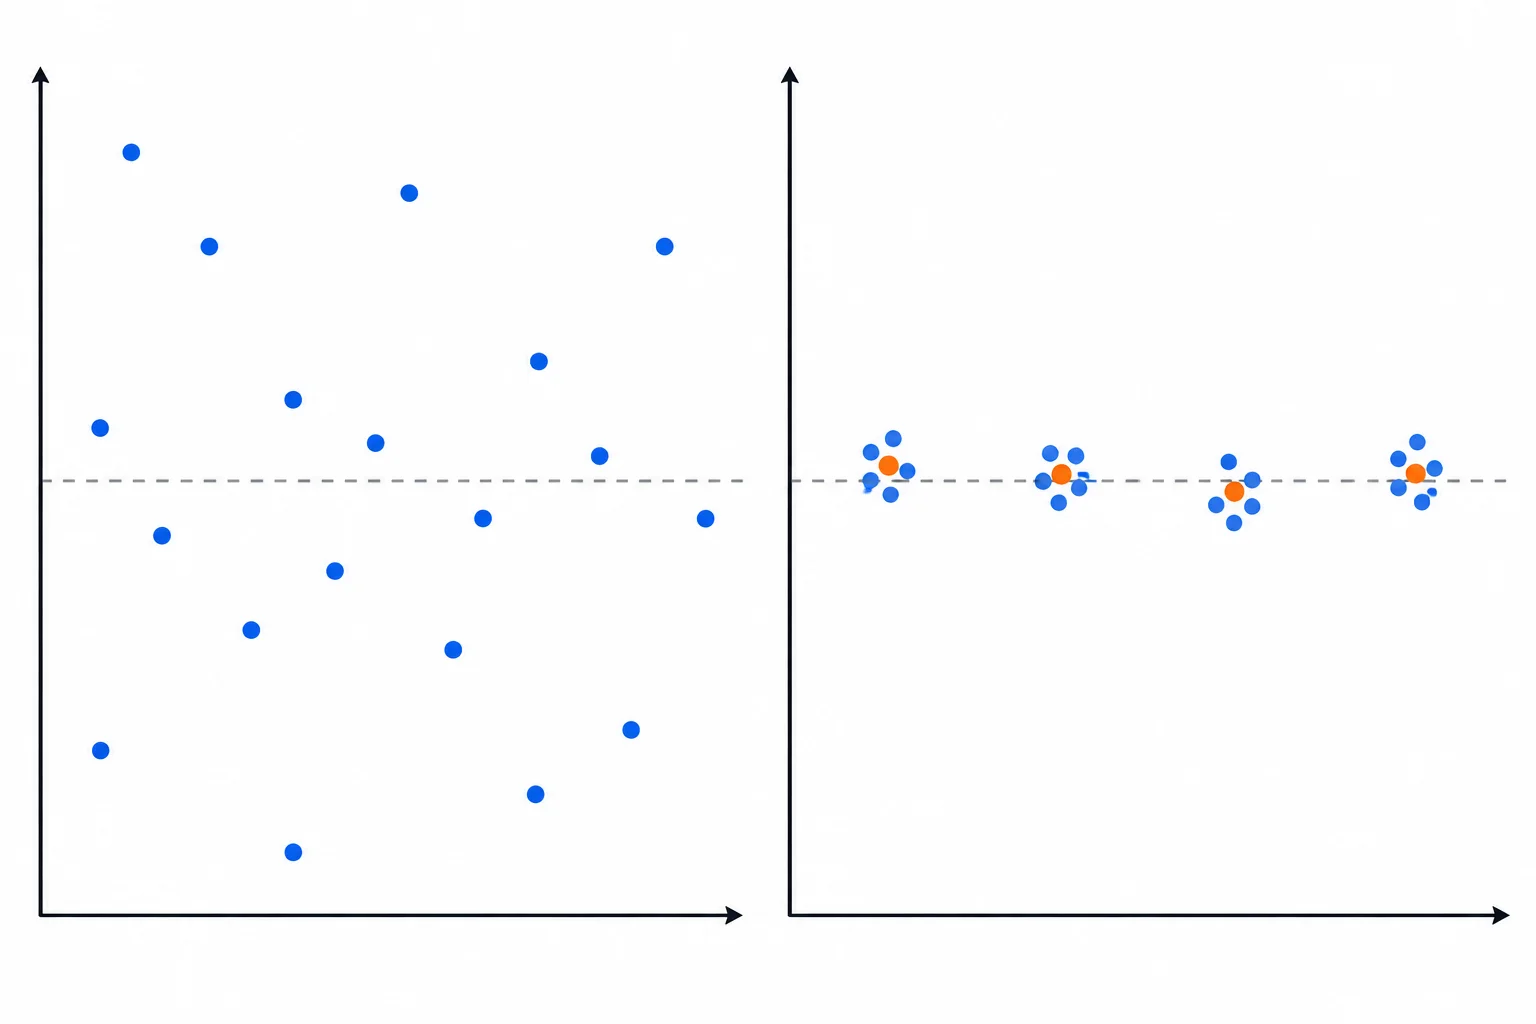
A redução se refere à variação esperada das médias, não à dispersão das leituras individuais.
Exemplo
Exemplo: uma série estável e independente tem n = 16 leituras e desvio-padrão amostral s = 0,40 °C.
u_média = 0,40 °C / √16 = 0,40 °C / 4 = 0,10 °C
O resultado mantém a unidade da grandeza medida. Aqui, 0,40 °C descreve a dispersão das leituras; 0,10 °C é a contribuição de repetibilidade para a incerteza padrão da média dessas 16 leituras.
Se n passar de 16 para 64, √n passa de 4 para 8. Mantendo s igual, u_média cai de 0,10 °C para 0,05 °C: quadruplicar n reduz essa contribuição pela metade.
Isso não faz as leituras individuais ficarem menos dispersas: s continua descrevendo a série de leituras. Tampouco reduz automaticamente contribuições comuns a todas elas, como uma referência compartilhada.
Atenção
A relação s/√n não exige que as leituras sigam uma distribuição normal. Ela depende das hipóteses de independência, estabilidade e variância finita. Isso, por si só, não autoriza declarar uma faixa de cobertura normal para a média.
Além disso, com poucas leituras, a estimativa s é menos confiável. Fazer a divisão por √n não elimina essa limitação.
Uma série de leituras estável e independente tem s = 0,30 V e n = 25. Complete: u_média = __.
Qual afirmação interpreta corretamente o efeito de aumentar o número de leituras?
Passo 8 de 9
Reconheça por que contribuições comuns, como referência, offset estável e incerteza residual de correção, permanecem mesmo ao calcular a média de muitas leituras.
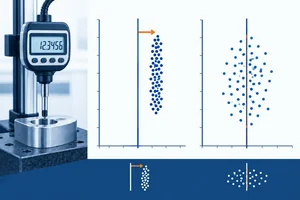
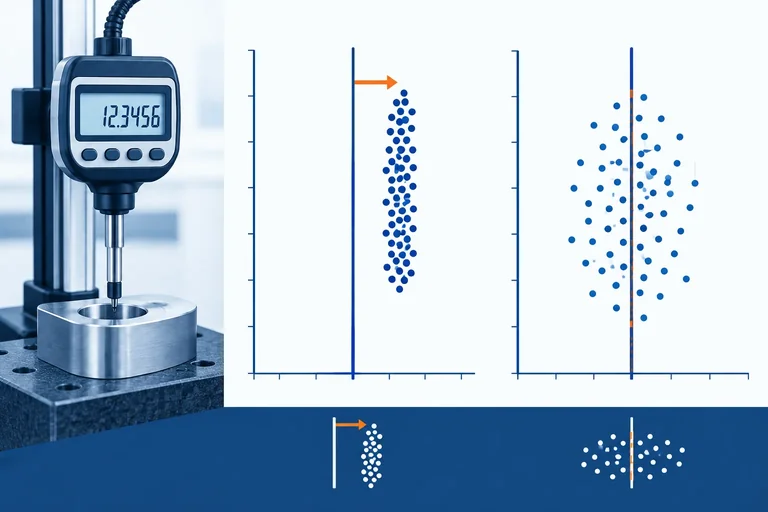
A média de muitas leituras pode reduzir a contribuição de repetibilidade quando as leituras são independentes e o processo está estável. Isso funciona porque parte do desvio muda de uma leitura para outra.
Mas nem toda contribuição é sorteada novamente. Um efeito que acompanha todas as leituras como um bloco continua presente na média.
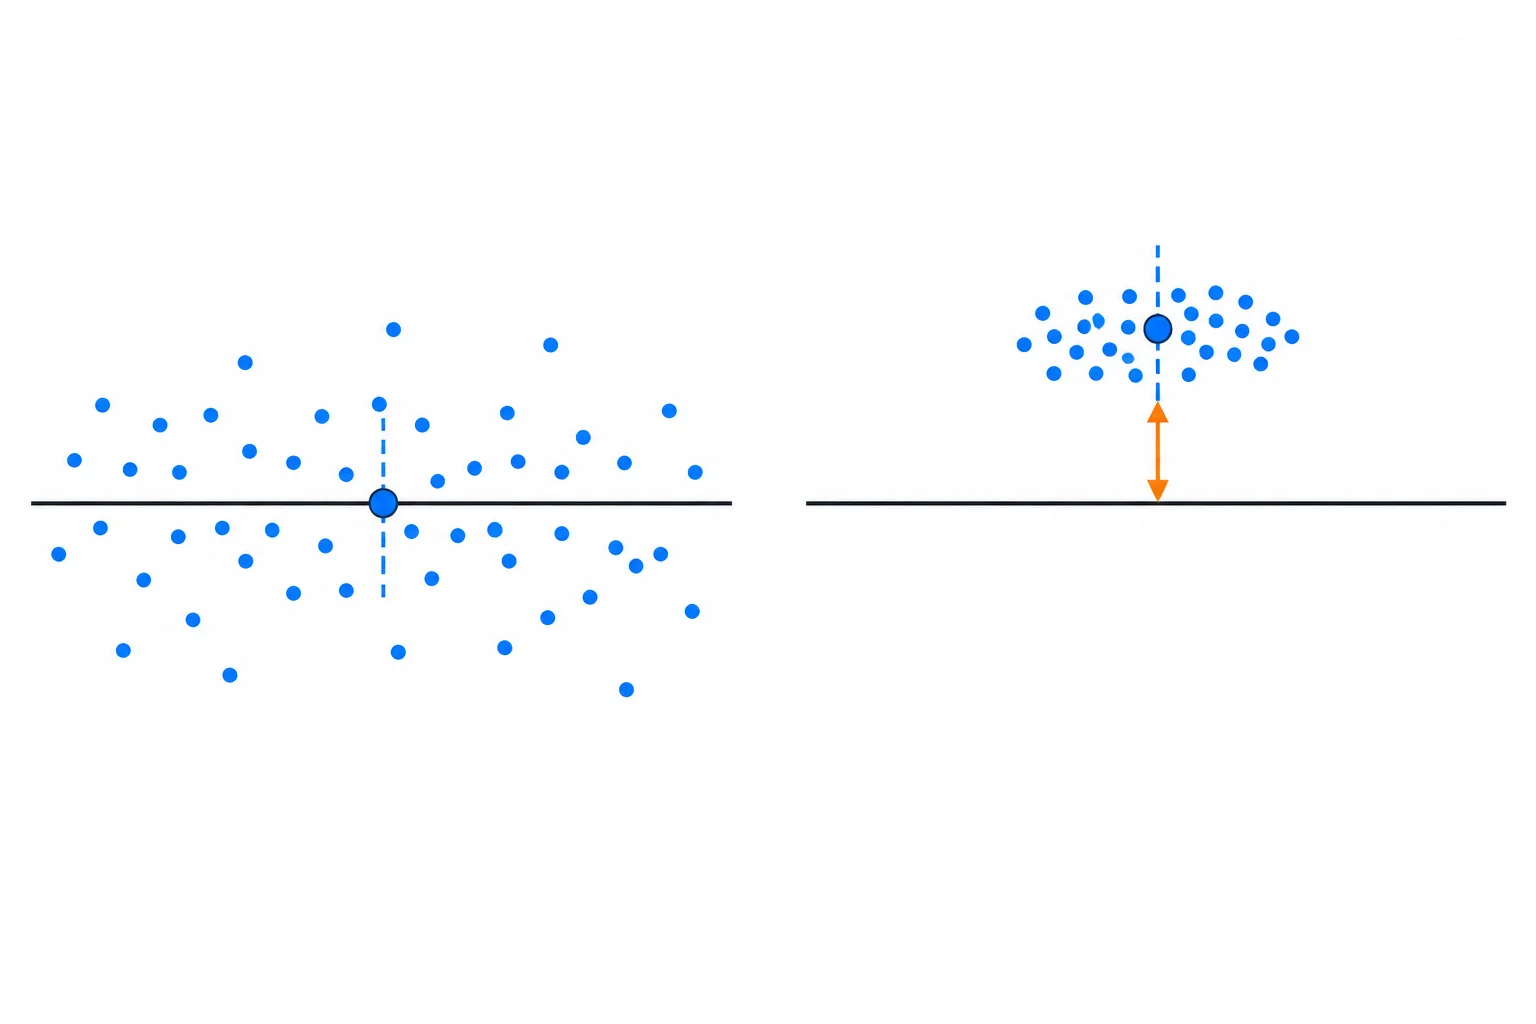
À esquerda, desvios que mudam entre leituras podem se compensar parcialmente na média. À direita, o deslocamento comum permanece, mesmo com muitas leituras.
Considere um monitor de temperatura que aplica uma correção à indicação. A correção foi estimada, mas ainda há incerteza sobre seu valor. Essa incerteza residual afeta cada leitura corrigida da mesma série.
O mesmo pode ocorrer com a referência do ADC ou com um offset estável do condicionamento: se o efeito não muda a cada aquisição, as leituras não trazem novas realizações independentes dele.
Assim, uma média pode ser muito repetível e ainda permanecer limitada por uma contribuição comum.
Exemplo
Exemplo — referência do ADC
Dez mil leituras de uma tensão estável têm pouca dispersão. A média reduz a contribuição de repetibilidade dessas leituras.
Porém, se a tensão de referência usada pelo ADC tiver uma incerteza residual, a escala de conversão de todas as dez mil leituras será afetada em conjunto. Fazer mais leituras não caracteriza melhor essa referência por si só.
Para reduzir essa limitação, seria preciso informação adicional: por exemplo, caracterizar a referência nas condições de uso, usar uma referência melhor ou obter uma calibração adequada.
Atenção
Não aplique automaticamente o fator 1/√n a toda informação de incerteza. Ele se relaciona à contribuição de repetibilidade da média sob as hipóteses já estudadas; não transforma uma incerteza comum em efeito aleatório.
Classifique cada contribuição pelo efeito esperado de aumentar o número de leituras independentes, mantendo as demais condições.
| Contribuição | Comportamento na série | Efeito de aumentar n |
|---|---|---|
| Ruído de aquisição que muda a cada leitura | Varia de uma leitura para outra | Pode diminuir na média |
| Incerteza residual da correção aplicada | Afeta todas as leituras em conjunto | Não diminui apenas repetindo |
| Incerteza da referência do ADC | Mesma escala para toda a série | Não diminui apenas repetindo |
| Offset estável não corrigido | Mesmo deslocamento em toda a série | Não diminui apenas repetindo |
Dica
Uma média de leituras pouco dispersas é evidência sobre a repetibilidade observada. Ela não prova que a referência, a correção aplicada ou o offset comum estejam exatos.
Associe cada situação ao efeito mais adequado de aumentar o número de leituras independentes. Observe se o efeito é sorteado novamente a cada aquisição ou compartilhado pela série inteira.
Faça as correspondências.
Toque em um item e depois no par correspondente.
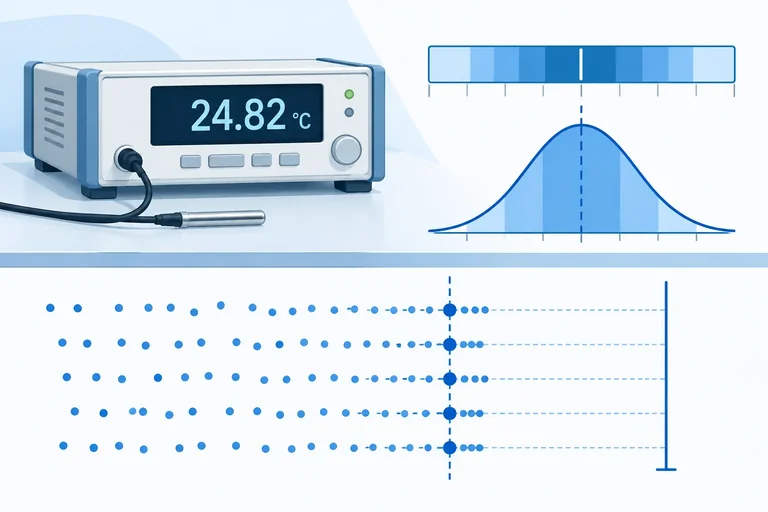
Passo 9 de 9
Aplicação final com um monitor de temperatura: escolha de modelo, cálculos separados e justificativas de limitações.
Caso didático — monitor de temperatura
O firmware aplica uma correção de +0,12 °C ao valor indicado, para compensar um efeito estimado previamente. Essa correção ajusta o resultado, mas não elimina a incerteza sobre o efeito nem outras contribuições.
Para esta análise, mantenha cada contribuição separada. Não calcule uma incerteza total neste step.
Informações disponíveis para uma leitura média do monitor.
| Origem | Informação disponível | Modelo ou ação |
|---|---|---|
| Correção estimada | Aplicar +0,12 °C | Corrigir o resultado |
| Residual da correção | Entre −0,30 °C e +0,30 °C; valores igualmente plausíveis | Retangular, a = 0,30 °C |
| 16 leituras | s = 0,20 °C; procedimento estável e independente | u_média = s/√n |
| Caracterização separada | Modelo normal, μ = 0 °C e σ = 0,10 °C | Interpretar faixa probabilística |
| Referência do ADC | Incerteza residual comum a todas as leituras | Não diminui só ao aumentar n |
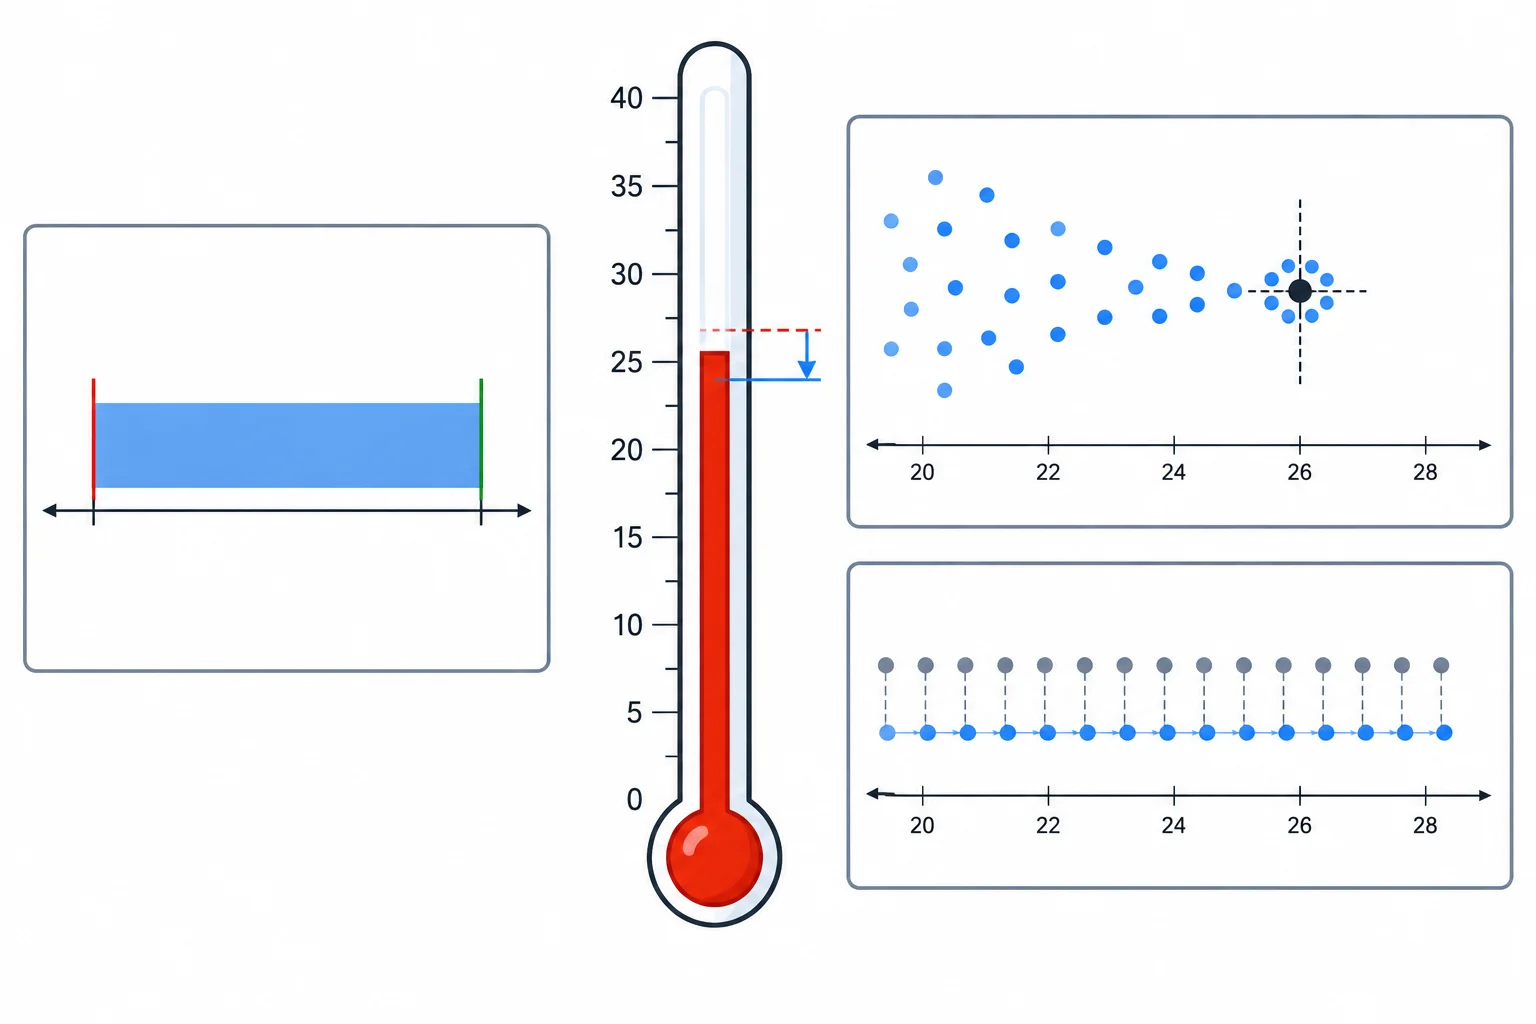
A correção desloca o resultado; a contribuição retangular, a repetibilidade da média e a referência comum continuam sendo tratadas separadamente.
Para o residual da correção, os limites são simétricos e a hipótese de valores igualmente plausíveis foi fornecida. Portanto, a semilargura é a = 0,30 °C e o modelo retangular permite usar:
u = a/√3
A correção de +0,12 °C não entra nessa divisão: ela é uma compensação aplicada ao resultado.
Complete: a incerteza padrão da contribuição retangular é aproximadamente ___ °C.
As 16 leituras foram declaradas estáveis e independentes, e seu desvio-padrão amostral é s = 0,20 °C. Para a contribuição de repetibilidade da média:
u_média = s/√n = 0,20/√16
Isso reduz a incerteza associada à média, não a dispersão s das leituras individuais.
Complete: a contribuição de repetibilidade para a média é ___ °C.
A caracterização separada informa explicitamente um modelo normal com μ = 0 °C e σ = 0,10 °C. Nesse modelo, a faixa de μ − σ a μ + σ, isto é, de −0,10 °C a +0,10 °C, contém aproximadamente 68% da probabilidade.
Essa interpretação depende do modelo normal e dos parâmetros fornecidos. Ela não decorre apenas de ter calculado uma média e um desvio-padrão de leituras.
No modelo normal explicitamente informado, qual porcentagem aproximada está entre −0,10 °C e +0,10 °C?
Agora avalie a informação: “o manual declara somente erro máximo de ±0,50 °C, sem modelo probabilístico, sem condições detalhadas e sem indicar valores igualmente plausíveis”.
Escreva qual decisão você registraria para esse dado e explique por que não aplicaria automaticamente a divisão por √3.
Escreva pelo menos 120 caracteres (0/120).
Resumo
Parabéns! Você concluiu: Modelos de distribuição e incerteza padrão
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks