Passo 1 de 8
Reconhecer a estrutura e os valores de JSON
Interprete a estrutura de um documento JSON, reconheça sua sintaxe e associe seus valores aos tipos básicos de Python.
Trilha de aprendizado · Nível 6 · Tutorial 6
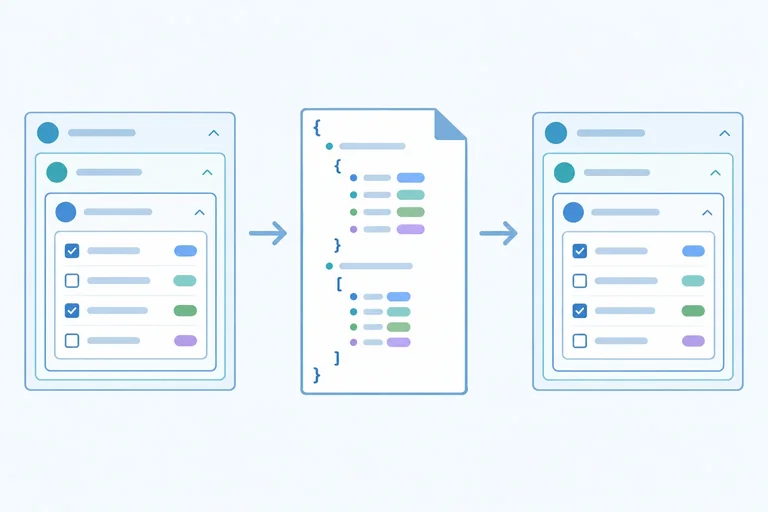
Persistir coleções compatíveis em JSON e recuperar seus dados, distinguindo erros de sintaxe, incompatibilidades de valores e problemas na estrutura esperada.
 Reconhecer a estrutura e os valores de JSON
Interprete a estrutura de um documento JSON, reconheça sua sintaxe e associe seus valores aos tipos básicos de Python. 3 min
 Converter entre dados Python e strings JSON
Use json.dumps e json.loads para fazer uma ida e volta entre uma coleção Python e sua representação como texto JSON, inteiramente em memória. 3 min
 Entender os limites da ida e volta
Observe quais características dos valores Python são alteradas ou rejeitadas em uma ida e volta por JSON. 3 min
 Produzir JSON legível com acentos
Compare formas de apresentar o mesmo documento JSON e diferencie escapes de caracteres da codificação usada ao gravar texto. 2 min
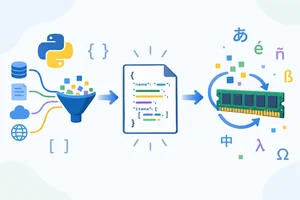 Salvar e carregar um documento por arquivo
Use as interfaces de arquivo do módulo json, mantenha um único documento por arquivo e reduza o risco de truncar o destino antes de detectar valores incompatíveis. 4 min
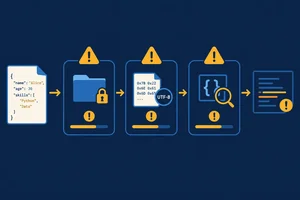 Diagnosticar falhas de leitura e de sintaxe
Diferencie problemas de acesso, decodificação e interpretação do JSON e use a posição informada por JSONDecodeError para investigar a sintaxe. 3 min
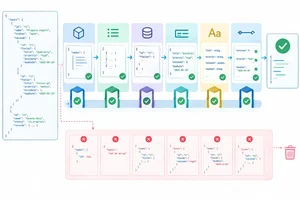 Validar os dados antes de usá-los
Verifique a estrutura, os campos e os valores de uma coleção de tarefas depois da leitura do JSON e antes de processar ou modificar os registros. 4 min
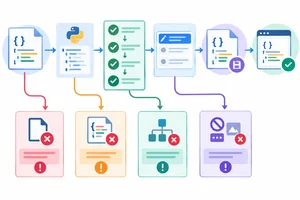 Aplicação final: atualizar tarefas e conferir a persistência
Execute localmente o ciclo completo de leitura, validação, atualização, gravação e conferência de uma coleção de tarefas, depois compare falhas de acesso, sintaxe, estrutura e serialização. 5 min
Passo 1 de 8
Interprete a estrutura de um documento JSON, reconheça sua sintaxe e associe seus valores aos tipos básicos de Python.
JSON é um formato textual de intercâmbio de dados. Ele permite representar valores e coleções de maneira independente do programa que os produziu.
Serializar é transformar valores em uma representação textual. Desserializar é interpretar essa representação para reconstruir valores utilizáveis pelo programa.
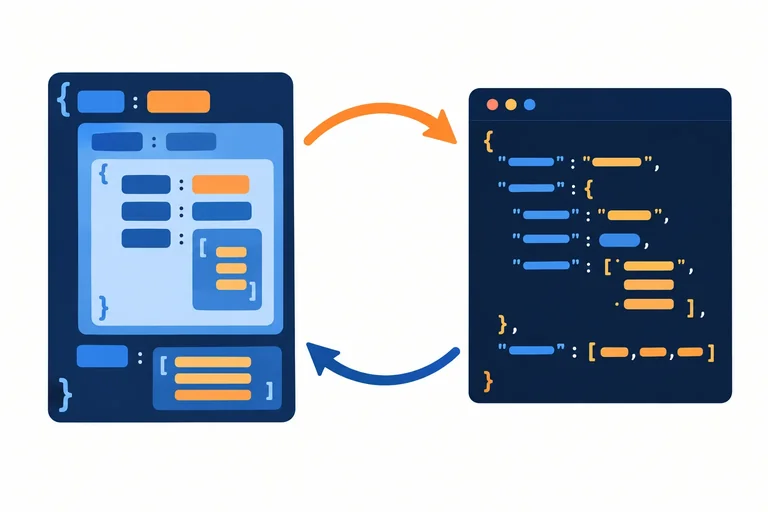
Embora um documento JSON possa lembrar listas e dicionários de Python, ele segue uma sintaxe própria.
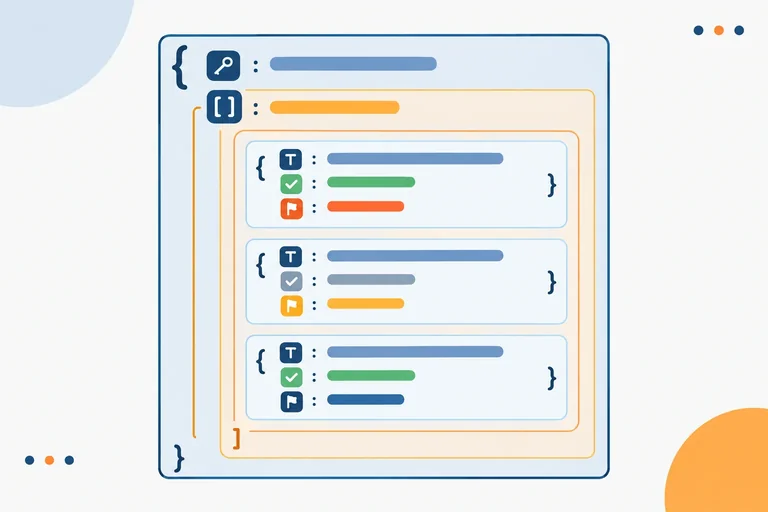
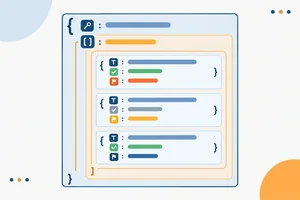
A estrutura pode ser lida do contêiner externo para os valores internos.
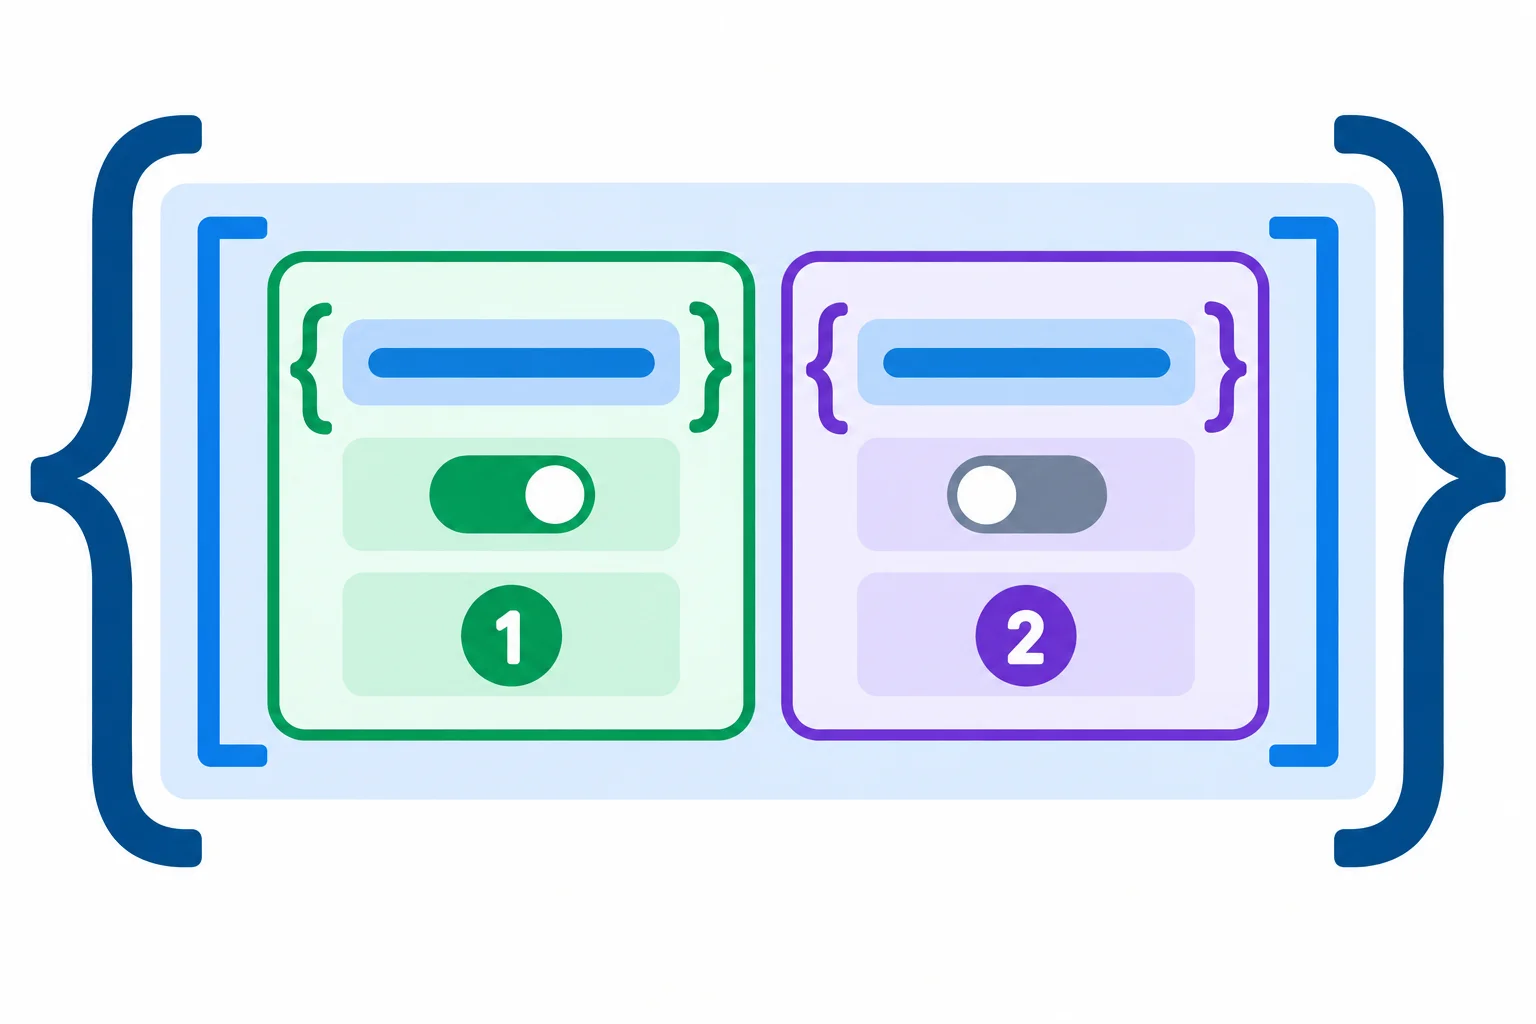
Um objeto raiz contém um array; cada posição do array contém outro objeto com os dados de uma tarefa.
Em JSON, as chaves de um objeto são textos entre aspas duplas. Strings também usam aspas duplas. Os valores booleanos são true e false, e a ausência de valor é null, sempre em minúsculas.
Comentários não fazem parte da sintaxe, e não pode haver vírgula depois do último elemento de um objeto ou array.
Leia de fora para dentro: objeto raiz, array tarefas e objetos individuais.
{
  "tarefas": [
    {
      "titulo": "Revisar JSON",
      "concluida": false,
      "prioridade": 2
    },
    {
      "titulo": "Enviar relatório",
      "concluida": true,
      "prioridade": 1
    }
  ],
  "proxima_revisao": null
}
Exemplo
Ao reconstruir esses dados em Python:
object corresponde a dict;array corresponde a list;string corresponde a str;int;float;true e false correspondem a True e False, do tipo bool;null corresponde a None.O nome object pertence ao vocabulário do JSON; nesta correspondência, ele indica uma coleção de pares chave–valor como um dicionário.
Associe cada tipo ou valor JSON ao correspondente em Python.
Toque em um item e depois no par correspondente.
Escolha o único documento JSON sintaticamente correto.
Passo 2 de 8
Use json.dumps e json.loads para fazer uma ida e volta entre uma coleção Python e sua representação como texto JSON, inteiramente em memória.
O módulo json faz parte da biblioteca padrão: basta usar import json, sem instalar dependências.
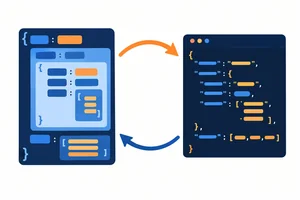
json.dumps(dados) recebe um valor Python compatível e devolve uma str contendo JSON.json.loads(texto) recebe uma str contendo um documento JSON e devolve o valor Python correspondente.O dicionário e a string JSON podem representar os mesmos dados, mas são valores de tipos diferentes. Nesta etapa, toda a conversão acontece em memória, sem leitura ou gravação de arquivos.
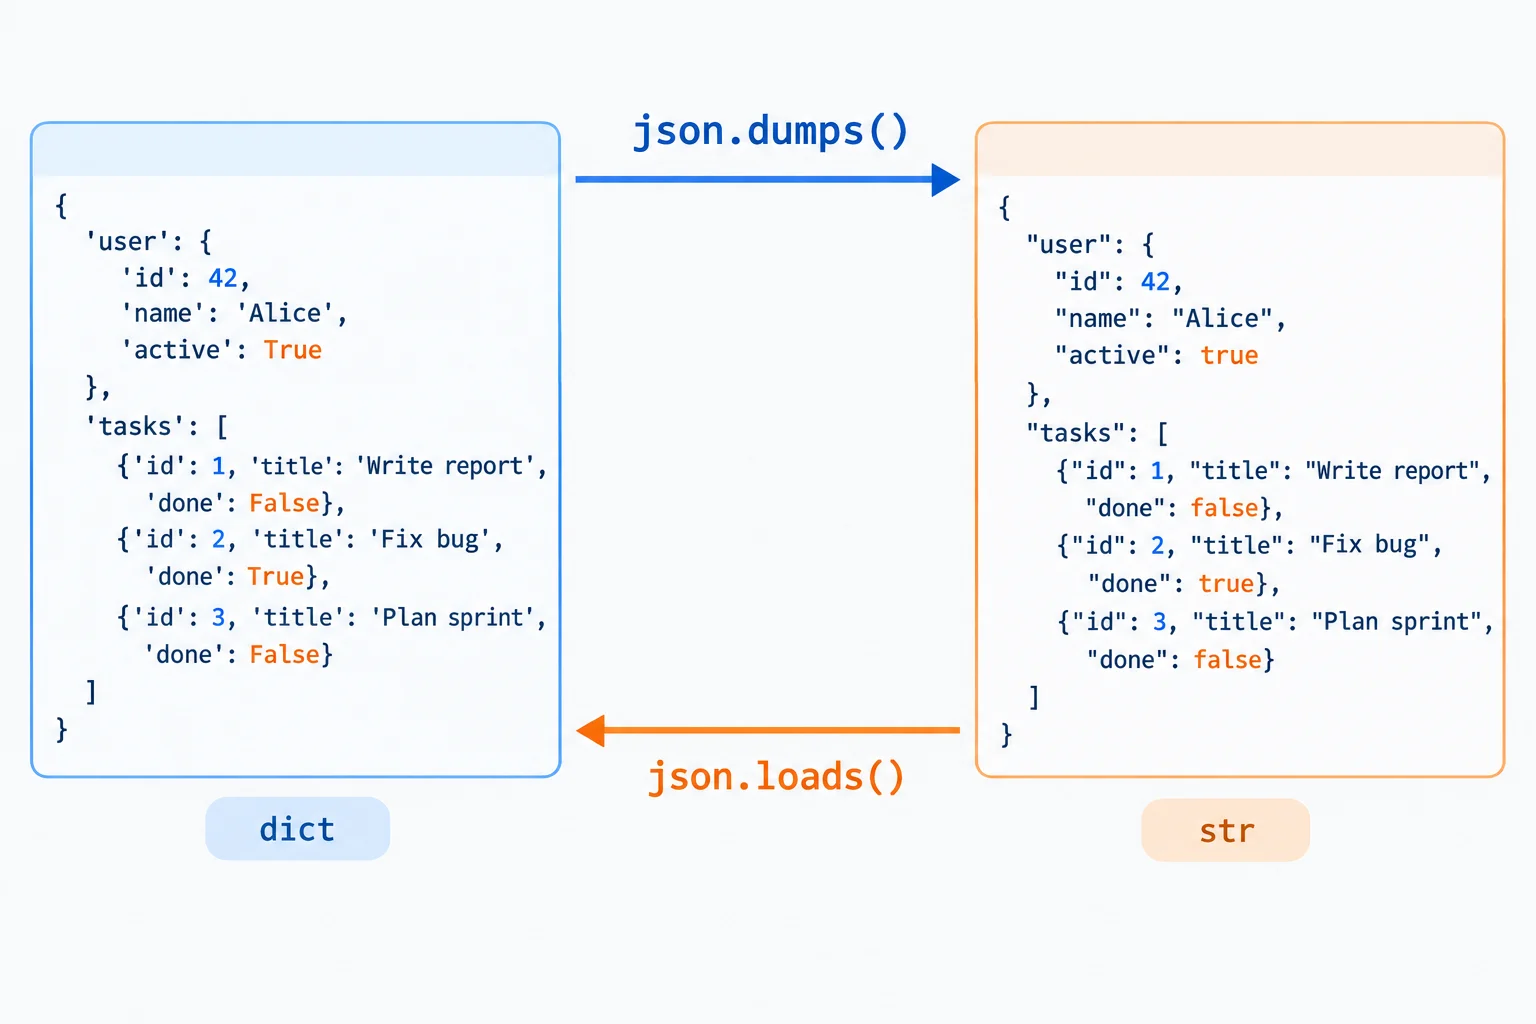
dumps: valor Python → string JSON. loads: string JSON → valor Python.
Este exemplo transforma a coleção em texto JSON e depois reconstrói uma coleção Python a partir desse texto.
import json

colecao = {
    "tarefas": [
        {
            "titulo": "Revisar JSON",
            "concluida": False,
            "prioridade": 4,
        },
        {
            "titulo": "Praticar conversoes",
            "concluida": True,
            "prioridade": 2,
        },
    ]
}

texto_json = json.dumps(colecao)
colecao_recuperada = json.loads(texto_json)

print(type(colecao).__name__)
print(type(texto_json).__name__)
print(type(colecao_recuperada).__name__)
print(colecao_recuperada["tarefas"][0]["titulo"])
Exemplo
As linhas finais exibem, nesta ordem:
dict
str
dict
Revisar JSON
texto_json não é outro dicionário: é uma string que contém um documento JSON. Depois de loads, colecao_recuperada volta a oferecer acesso por chaves e índices.
Considere que dados é um dicionário compatível com JSON. Qual alternativa completa corretamente a conversão e prevê os tipos de texto e copia?
Complete com o nome do tipo: após texto = json.dumps(dados), type(texto).__name__ resulta em _.
Passo 3 de 8
Observe quais características dos valores Python são alteradas ou rejeitadas em uma ida e volta por JSON.
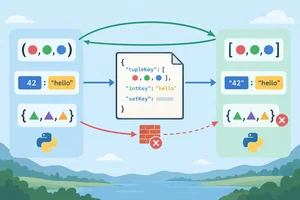
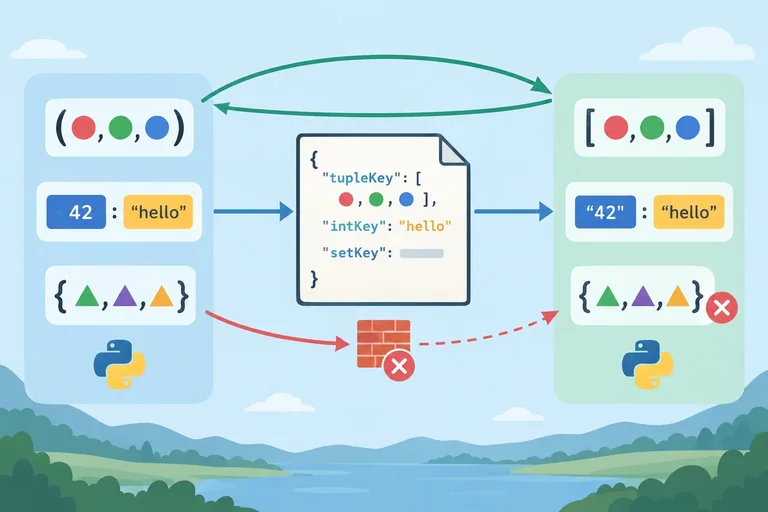
Uma ida e volta executa json.dumps(dados) e depois json.loads(texto). Mesmo quando as duas operações funcionam, o valor recuperado pode não ter exatamente os mesmos tipos do original.
Isso acontece porque JSON tem menos tipos que Python: objetos JSON só possuem chaves textuais, e arrays não distinguem listas de tuplas.
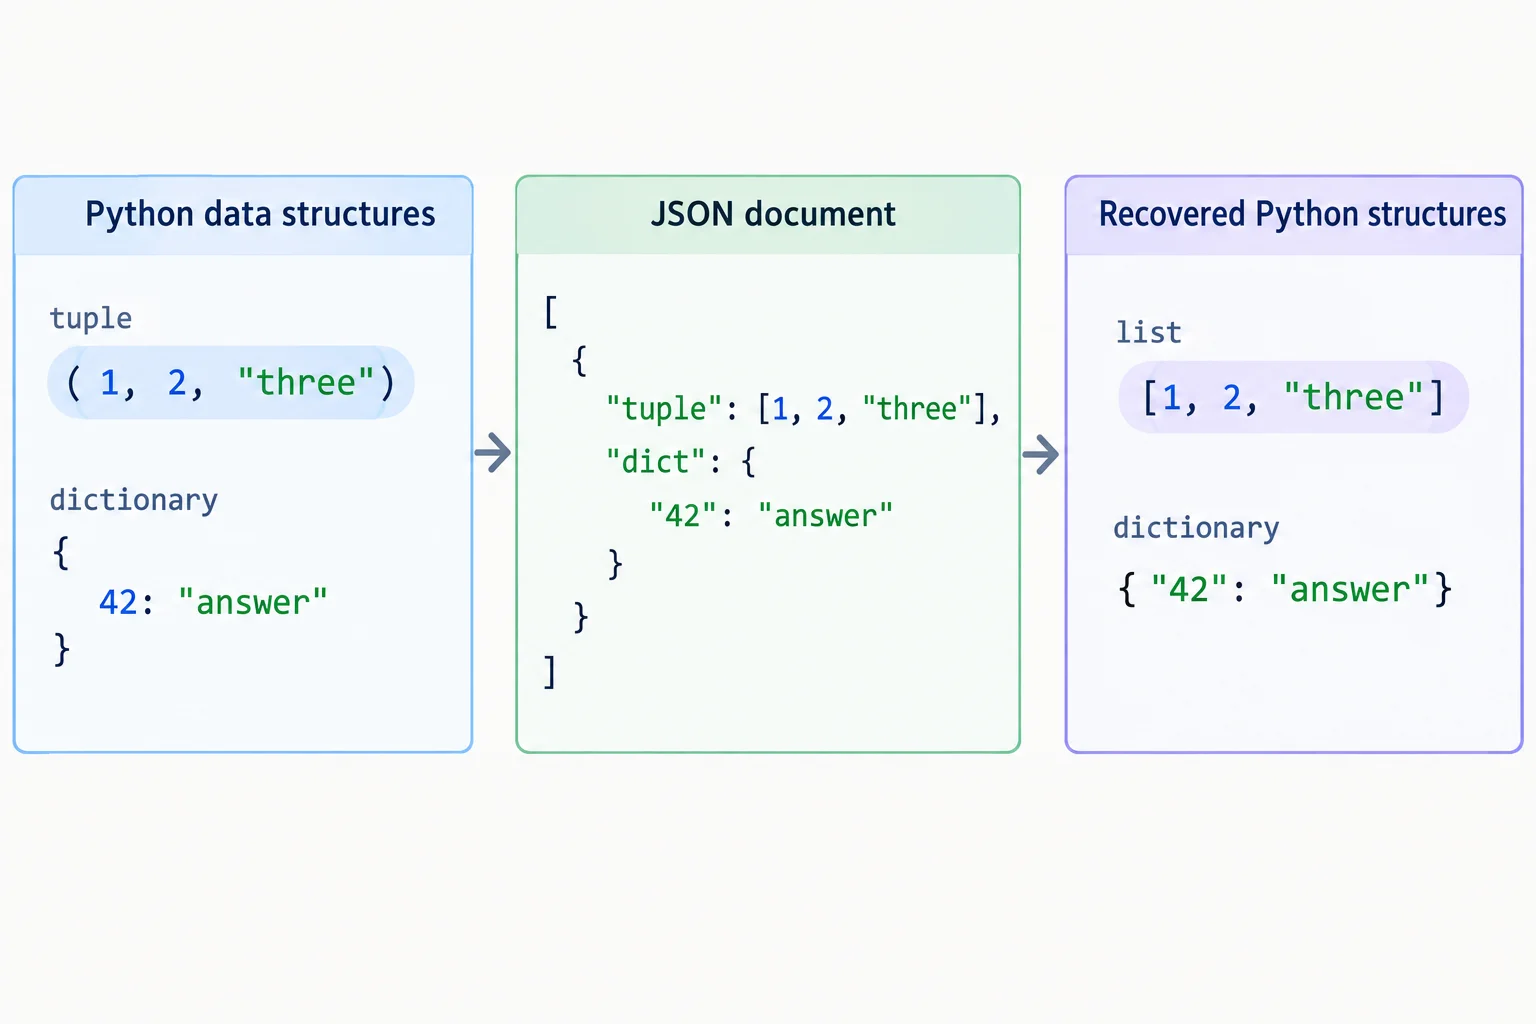
A representação intermediária em JSON não registra que um array veio de uma tupla nem que uma chave textual veio de um inteiro.
Execute o código e compare os tipos antes e depois da conversão.
import json

original = {
    1: ("estudar", "praticar")
}

texto = json.dumps(original)
recuperado = json.loads(texto)

print(texto)
print(recuperado)
print(type(next(iter(recuperado))))
print(type(recuperado["1"]))

# Saída:
# {"1": ["estudar", "praticar"]}
# {'1': ['estudar', 'praticar']}
# <class 'str'>
# <class 'list'>
Dica
Depois de loads, a chave disponível é "1", e não 1. O array volta como list, pois o documento JSON não contém informação suficiente para reconstruir a tupla.
O módulo json não possui uma representação direta para set. Tentar serializar um conjunto provoca TypeError.
Você pode convertê-lo explicitamente para uma lista, mas essa escolha altera o significado disponível após a recuperação: a lista não expressa unicidade e sua ordem pode não ser significativa quando a origem era um conjunto.
import json

etiquetas = {"python", "json"}

try:
    json.dumps(etiquetas)
except TypeError as erro:
    print(f"Não foi possível serializar: {erro}")

# Conversão explícita: adequada somente se uma lista servir ao uso futuro.
texto = json.dumps(list(etiquetas))
recuperado = json.loads(texto)

print(recuperado)
print(type(recuperado))  # <class 'list'>
Atenção
Converter um conjunto para lista não preserva automaticamente seu tipo nem a regra de unicidade. Se a ordem da saída for importante, ela também precisa ser definida de forma consciente antes da serialização.
Após json.loads(json.dumps({1: "um"})), o valor recuperado pode ser acessado com a chave inteira 1.
Uma tupla serializada como array JSON volta a ser uma tupla depois de loads.
Passar um set diretamente para json.dumps provoca TypeError.
Passo 4 de 8
Compare formas de apresentar o mesmo documento JSON e diferencie escapes de caracteres da codificação usada ao gravar texto.
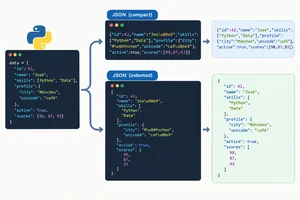
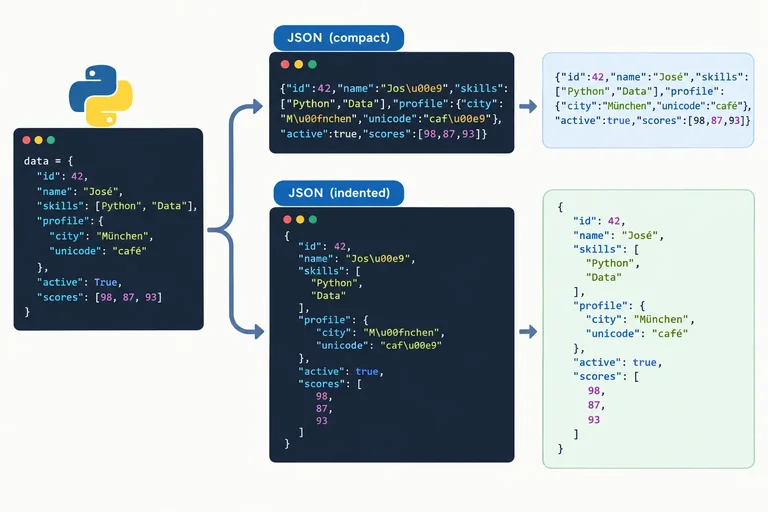
O parâmetro indent organiza objetos e arrays em várias linhas, com recuo para indicar os níveis da estrutura. Ele altera apenas a apresentação do documento: os valores representados continuam os mesmos.
Execute o código e compare as saídas. Sem indent, o JSON fica em uma linha. Com indent=2, cada nível recebe dois espaços de recuo.
import json

dados = {
    "titulo": "Revisão de português",
    "concluida": False,
}

print("SEM INDENTAÇÃO")
print(json.dumps(dados))

print("\nINDENTADO COM ESCAPES")
print(json.dumps(dados, indent=2))

print("\nINDENTADO COM ACENTOS VISÍVEIS")
print(json.dumps(dados, indent=2, ensure_ascii=False))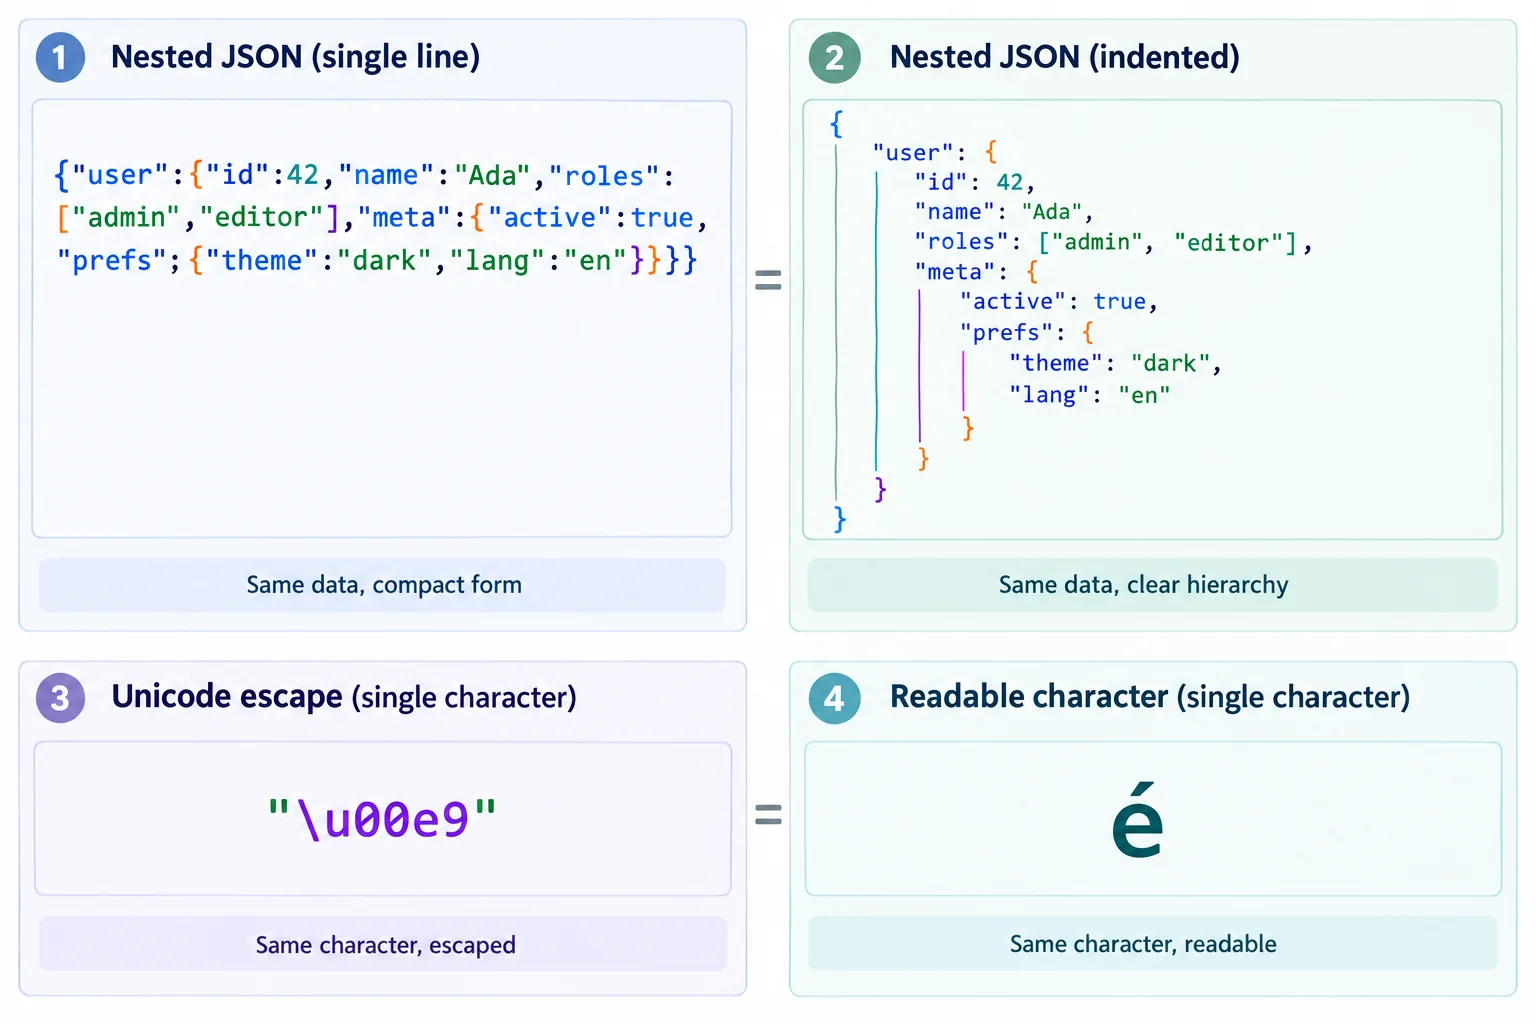
A indentação evidencia a hierarquia. A escolha entre escapes e caracteres visíveis muda a representação textual, não os dados.
Por padrão, ensure_ascii=True representa caracteres fora do conjunto ASCII usando escapes como \u00e3. Com ensure_ascii=False, caracteres como ã e ê aparecem diretamente na string JSON. As duas formas são JSON válido.
Os dois documentos têm representações diferentes, mas json.loads reconstrói valores Python iguais.
import json

texto_com_escapes = r'{"titulo": "Revis\u00e3o de portugu\u00eas"}'
texto_com_acentos = '{"titulo": "Revisão de português"}'

primeiro = json.loads(texto_com_escapes)
segundo = json.loads(texto_com_acentos)

print(primeiro)
print(segundo)
print(primeiro == segundo)  # True
Exemplo
Depois de loads, tanto "Revis\u00e3o" quanto "Revisão" produzem a string Python "Revisão". O escape pertence à representação JSON; ele não permanece como parte do conteúdo recuperado.
json.dumps sempre devolve uma str, inclusive quando usamos ensure_ascii=False. Esse parâmetro decide como caracteres não ASCII aparecem dentro do texto JSON; ele não transforma a string em bytes nem escolhe a codificação de um arquivo.
Ao gravar esse texto posteriormente, a codificação — por exemplo, UTF-8 — ainda precisa ser definida na operação de arquivo. Portanto, acentos visíveis e codificação UTF-8 são decisões relacionadas, mas distintas.
Dica
indent organiza a aparência, ensure_ascii controla a representação de caracteres no JSON e encoding="utf-8" controla a conversão entre texto e bytes durante o acesso ao arquivo.
Qual chamada produz uma str JSON com recuo de dois espaços e acentos visíveis?
Passo 5 de 8
Use as interfaces de arquivo do módulo json, mantenha um único documento por arquivo e reduza o risco de truncar o destino antes de detectar valores incompatíveis.
O módulo json oferece duas interfaces:
json.dumps(dados) produz uma str com JSON.json.loads(texto) interpreta uma str com JSON.json.dump(dados, arquivo) escreve JSON em um arquivo de texto aberto.json.load(arquivo) lê JSON de um arquivo de texto aberto.A letra s em dumps e loads ajuda a lembrar da interface com strings. Sem o s, a função recebe também o objeto de arquivo aberto.
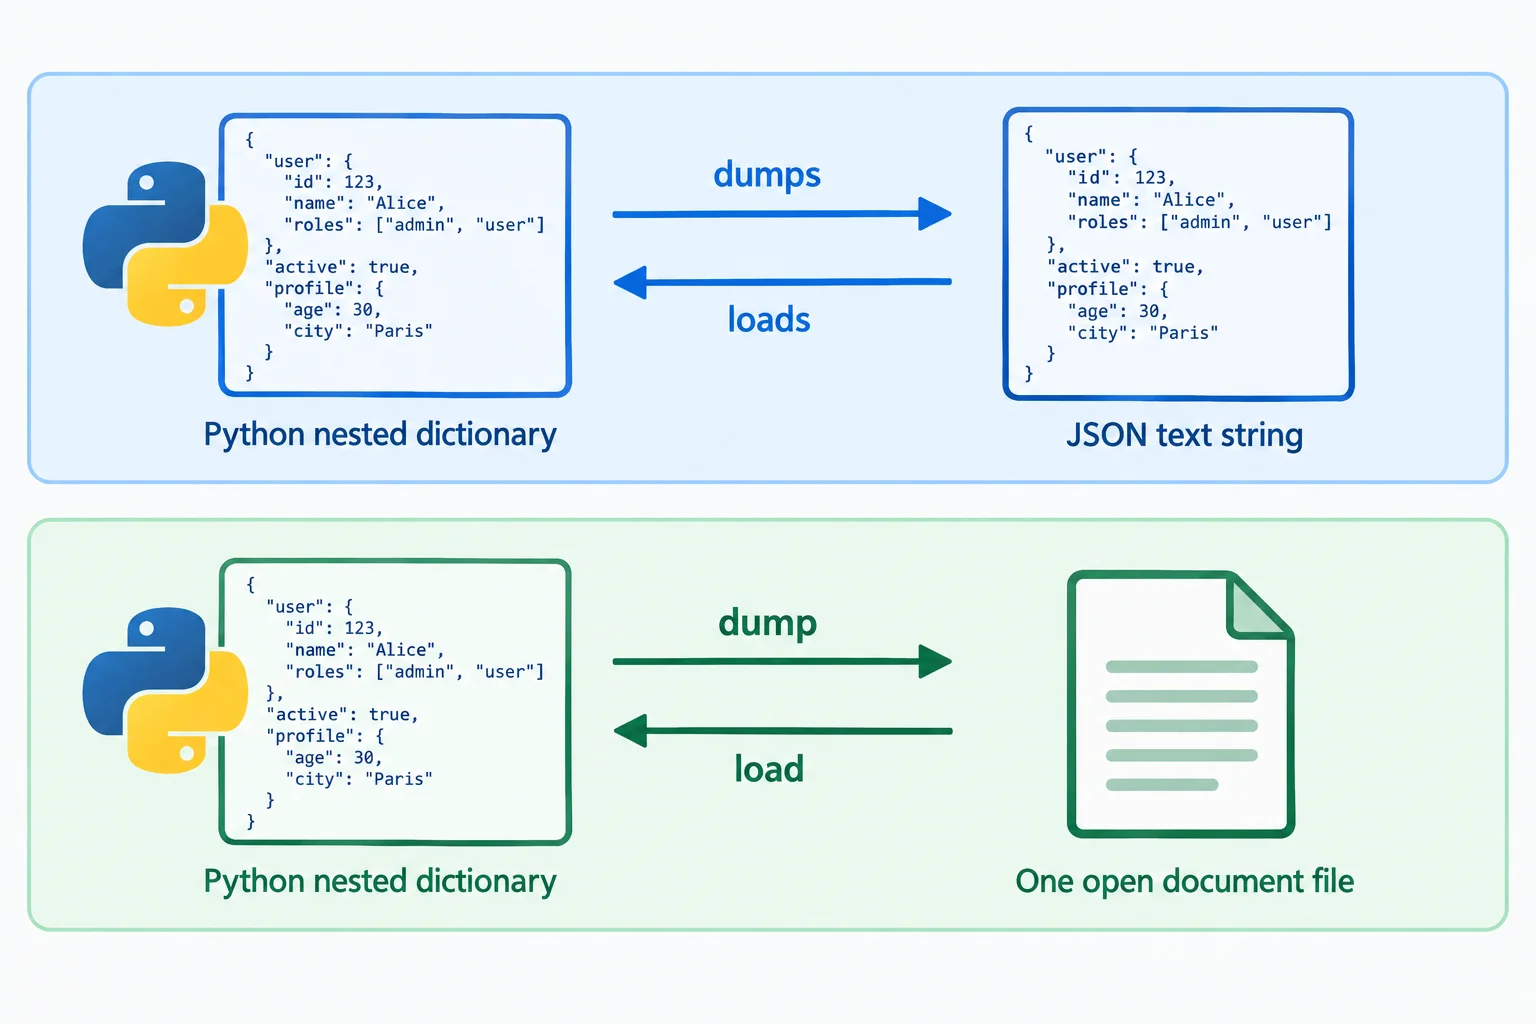
dumps e loads trabalham com texto em memória; dump e load, com um arquivo aberto.
Um arquivo JSON convencional guarda um único documento completo. Esse documento pode conter muitos registros: neste exemplo, o objeto raiz possui uma lista em tarefas.
O arquivo continua sendo texto. Por isso, abra-o com encoding="utf-8". indent organiza a apresentação e ensure_ascii=False permite exibir os caracteres acentuados diretamente; nenhum deles substitui a escolha da codificação.
Execute o código no seu computador. Ele cria tarefas.json na pasta de trabalho atual e depois recupera seu conteúdo.
from pathlib import Path
import json

caminho = Path("tarefas.json")
dados = {
    "tarefas": [
        {"titulo": "Revisar função", "concluida": False, "prioridade": 3},
        {"titulo": "Enviar relatório", "concluida": True, "prioridade": 5},
    ]
}

with caminho.open("w", encoding="utf-8") as arquivo:
    json.dump(dados, arquivo, indent=2, ensure_ascii=False)

with caminho.open("r", encoding="utf-8") as arquivo:
    recuperados = json.load(arquivo)

print(recuperados)
print(recuperados == dados)
Dica
Path.open abre o arquivo e with garante seu fechamento. json.dump e json.load cuidam da representação JSON, mas recebem o objeto de arquivo já aberto no modo adequado.
Para atualizar uma tarefa, carregue o documento, altere a coleção em memória e grave novamente todo o documento em modo w.
Abrir em modo a e chamar dump outra vez não insere um item no array existente. Isso apenas coloca um segundo documento após o primeiro, produzindo algo semelhante a {...}{...}. O resultado deixa de ser um único documento adequado para json.load.
Atenção
json.dump(primeiro, arquivo) seguido de json.dump(segundo, arquivo) não cria automaticamente uma lista com dois elementos. Para reunir registros, coloque-os em uma lista Python e serialize a coleção completa uma única vez.
O arquivo contém {"tarefas": [...]}. Qual procedimento mantém um único documento JSON válido?
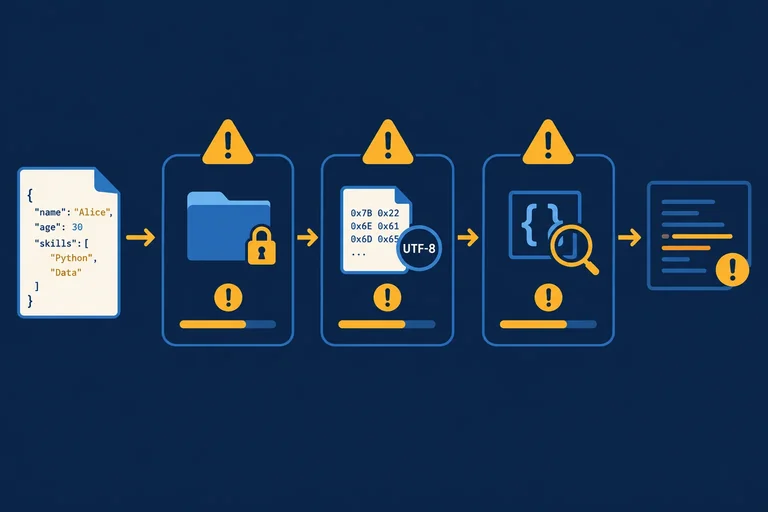
json.dump pode escrever parte do documento antes de encontrar um valor não serializável. Como o modo w também trunca o arquivo ao abri-lo, uma falha pode deixar o destino incompleto.
Uma precaução é gerar primeiro toda a string com json.dumps. Se ocorrer TypeError, isso acontece antes da abertura do destino. Depois, abra o arquivo e escreva a string pronta.
Essa estratégia reduz um risco específico, mas não protege contra falhas durante a própria escrita, como falta de espaço ou perda de acesso ao arquivo.
A serialização ocorre antes de o arquivo ser aberto em modo w.
from pathlib import Path
import json

caminho = Path("tarefas.json")

# Se houver um valor incompatível, TypeError ocorre aqui.
texto_json = json.dumps(
    dados,
    indent=2,
    ensure_ascii=False,
)

# O destino só é truncado depois da serialização bem-sucedida.
with caminho.open("w", encoding="utf-8") as arquivo:
arquivo.write(texto_json)Coloque as ações na ordem correta para atualizar a coleção e verificar sua serialização antes de truncar o arquivo.
Passo 6 de 8
Diferencie problemas de acesso, decodificação e interpretação do JSON e use a posição informada por JSONDecodeError para investigar a sintaxe.
Ao carregar JSON, três operações podem falhar por motivos diferentes:
OSError ou uma de suas subclasses.UnicodeDecodeError.json.JSONDecodeError.Capturas específicas e próximas da operação responsável preservam essa distinção. Uma única mensagem como “não foi possível carregar” esconderia a causa real.
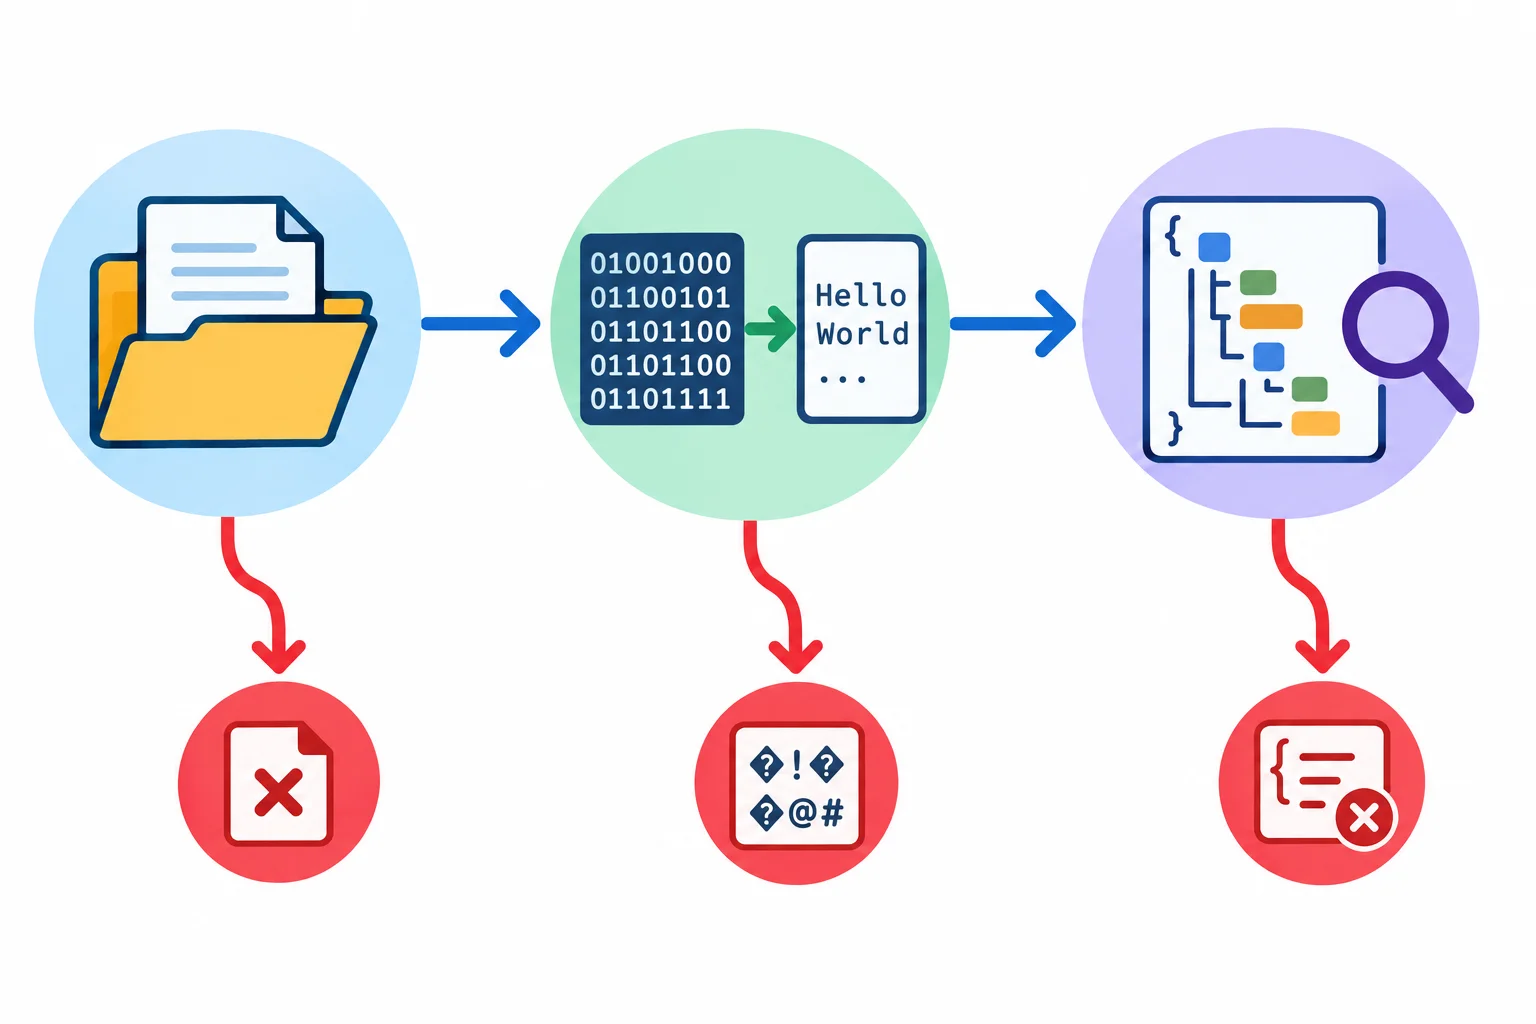
A falha deve ser associada à etapa que realmente a produziu: acesso, decodificação ou interpretação.
JSONDecodeError significa que o texto foi lido, mas não pôde ser interpretado como um documento JSON completo. O objeto da exceção oferece informações úteis:
msg: descrição do que o decodificador esperava;lineno: linha em que ele detectou o problema;colno: coluna dessa linha.A posição mostra onde a interpretação parou. Comece por ela, mas examine também o caractere anterior: uma vírgula ou aspas incorretas podem ter causado a falha percebida logo depois.
Este exemplo lê o texto antes de interpretá-lo para deixar explícita a origem de cada falha.
import json
from pathlib import Path


def carregar_json(caminho):
    try:
        texto = Path(caminho).read_text(encoding="utf-8")
    except UnicodeDecodeError as erro:
        print(f"O arquivo não contém texto UTF-8 válido: {erro}")
        raise
    except OSError as erro:
        print(f"Não foi possível acessar o arquivo: {erro}")
        raise

    try:
        return json.loads(texto)
    except json.JSONDecodeError as erro:
        print(f"JSON inválido: {erro.msg}")
        print(f"Localização: linha {erro.lineno}, coluna {erro.colno}")
        raise


dados = carregar_json("tarefas.json")
print(dados)
Dica
Linha e coluna orientam a inspeção, mas não corrigem o documento nem explicam regras da aplicação. Elas apenas indicam onde o decodificador deixou de reconhecer uma sintaxe JSON válida.
Exemplo
Aspas inadequadas: {'titulo': 'Estudar'} usa aspas simples; JSON exige aspas duplas em chaves e strings.
Vírgula final: {"tarefas": [1, 2,]} contém uma vírgula sem um próximo elemento.
Arquivo vazio: não existe valor JSON para interpretar; a falha costuma ser indicada logo na linha 1, coluna 1.
Documentos concatenados: {"a": 1}{"b": 2} contém dois documentos completos em sequência. Depois do primeiro, o decodificador encontra dados extras.
Atenção
Evite capturar uma falha de leitura ou sintaxe e retornar silenciosamente [] ou {}. Isso confunde “não foi possível carregar” com “o arquivo contém uma coleção vazia” e pode levar o programa a sobrescrever dados existentes. Informe a causa ou permita que a exceção continue até o ponto responsável pelo tratamento.
Associe cada situação ao diagnóstico mais específico.
Toque em um item e depois no par correspondente.
Uma exceção informa Expecting value, linha 4, coluna 3. Qual é a melhor ação inicial?
Passo 7 de 8
Verifique a estrutura, os campos e os valores de uma coleção de tarefas depois da leitura do JSON e antes de processar ou modificar os registros.
json.load ou json.loads confirma apenas que o documento segue a sintaxe JSON. O resultado ainda pode ser um número, uma lista inesperada ou um objeto com registros incompletos.
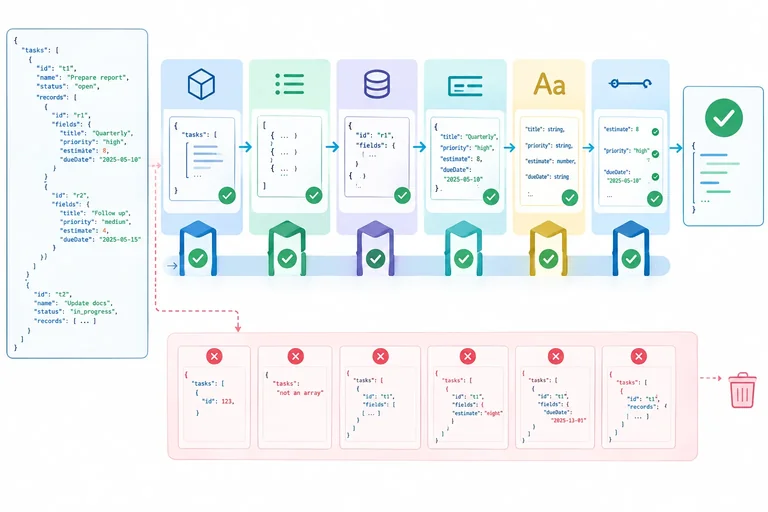
Nesta aplicação, o contrato esperado é:
dict;tarefas;tarefas é uma list;dict;titulo, concluida e prioridade com tipos e valores válidos.A validação deve seguir essa ordem, do contêiner externo para os dados internos. Assim, o programa não tenta acessar campos de uma estrutura que ainda não foi confirmada.
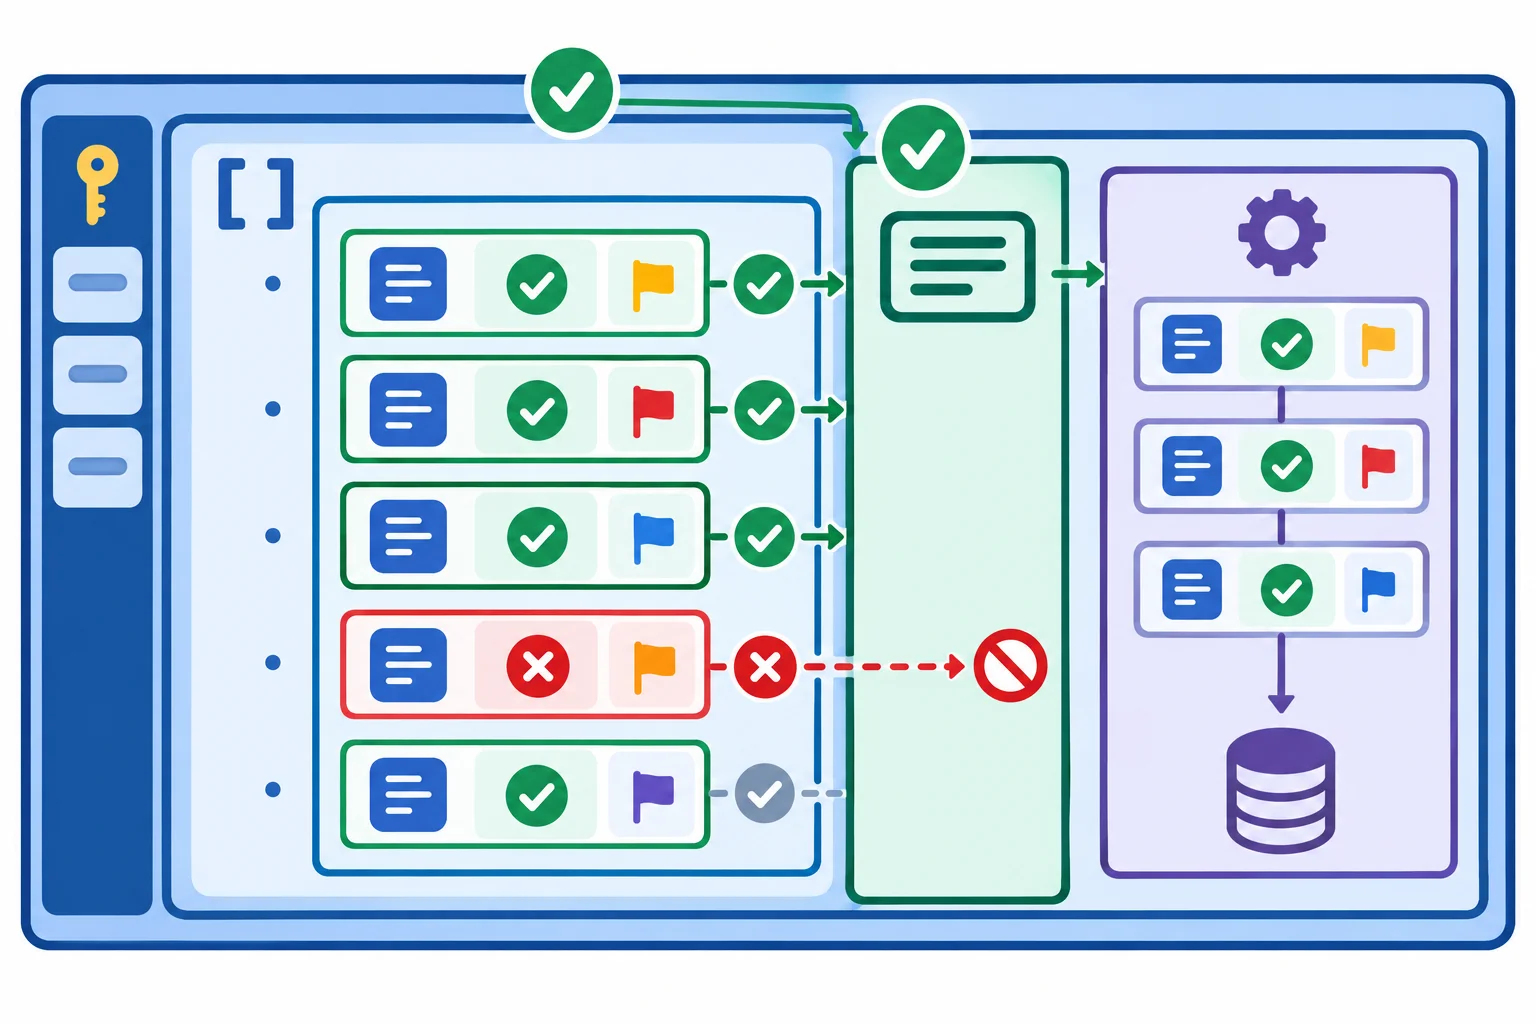
Valide primeiro a raiz, depois a lista, cada registro e, por último, os campos e seus valores.
Use TypeError quando o valor tem um tipo inadequado. Use ValueError quando falta um campo obrigatório ou quando um valor do tipo correto viola uma regra.
A prioridade merece uma verificação explícita: como bool também é aceito por isinstance(valor, int), teste e rejeite booleanos antes de aceitar inteiros.
A função termina sem retorno quando toda a coleção é válida. A primeira violação encontrada gera uma mensagem com o índice do registro.
def validar_colecao(dados):
    if not isinstance(dados, dict):
        raise TypeError("a raiz deve ser um dict")

    if "tarefas" not in dados:
        raise ValueError("a raiz deve conter o campo 'tarefas'")

    tarefas = dados["tarefas"]
    if not isinstance(tarefas, list):
        raise TypeError("o campo 'tarefas' deve ser uma list")

    campos_obrigatorios = ("titulo", "concluida", "prioridade")

    for indice, tarefa in enumerate(tarefas):
        if not isinstance(tarefa, dict):
            raise TypeError(f"tarefa {indice}: o registro deve ser um dict")

        for campo in campos_obrigatorios:
            if campo not in tarefa:
                raise ValueError(
                    f"tarefa {indice}: campo obrigatório ausente: {campo}"
                )

        titulo = tarefa["titulo"]
        if not isinstance(titulo, str):
            raise TypeError(f"tarefa {indice}: 'titulo' deve ser str")
        if not titulo.strip():
            raise ValueError(f"tarefa {indice}: 'titulo' não pode ser vazio")

        concluida = tarefa["concluida"]
        if not isinstance(concluida, bool):
            raise TypeError(f"tarefa {indice}: 'concluida' deve ser bool")

        prioridade = tarefa["prioridade"]
        if isinstance(prioridade, bool) or not isinstance(prioridade, int):
            raise TypeError(
                f"tarefa {indice}: 'prioridade' deve ser int, não bool"
            )
        if not 1 <= prioridade <= 5:
            raise ValueError(
                f"tarefa {indice}: 'prioridade' deve estar entre 1 e 5"
            )
Dica
Conclua a validação de toda a coleção antes de processar ou modificar qualquer tarefa. Isso evita que uma falha encontrada no final deixe alterações parciais nos registros anteriores.
Um JSONDecodeError pertence à interpretação do documento. Já TypeError e ValueError produzidos por validar_colecao pertencem ao contrato da aplicação.
Essa separação é especialmente importante porque JSONDecodeError deriva de ValueError. Um único except ValueError envolvendo leitura e validação esconderia a origem da falha.
Execute este trecho no mesmo arquivo da função validar_colecao. A validação só ocorre quando leitura e interpretação terminam com sucesso.
import json
from pathlib import Path

caminho = Path("tarefas.json")

try:
    with caminho.open("r", encoding="utf-8") as arquivo:
        dados = json.load(arquivo)
except OSError as erro:
    print(f"Falha ao acessar o arquivo: {erro}")
except UnicodeDecodeError as erro:
    print(f"Falha ao decodificar o texto: {erro}")
except json.JSONDecodeError as erro:
    print(
        f"JSON inválido na linha {erro.lineno}, "
        f"coluna {erro.colno}: {erro.msg}"
    )
else:
    try:
        validar_colecao(dados)
    except (TypeError, ValueError) as erro:
        print(f"Dados incompatíveis com a aplicação: {erro}")
    else:
        print("Coleção válida e pronta para uso.")
Exemplo
42 é um documento JSON sintaticamente válido, mas o validador o rejeita porque a raiz não é um dict.
{"tarefas": [{"titulo": "Revisar", "concluida": false}]} também é JSON válido, mas viola o contrato porque falta o campo prioridade.
Em nenhum dos casos a solução é substituir silenciosamente os dados por uma lista vazia: a falha deve ser informada.
O conteúdo do arquivo é apenas 42. O que acontece ao aplicar o fluxo apresentado?
Para cada caso, indique qual verificação do validador deve rejeitá-lo e se a exceção é TypeError ou ValueError:
prioridade;"prioridade": true;"titulo": " ".Escreva pelo menos 80 caracteres (0/80).
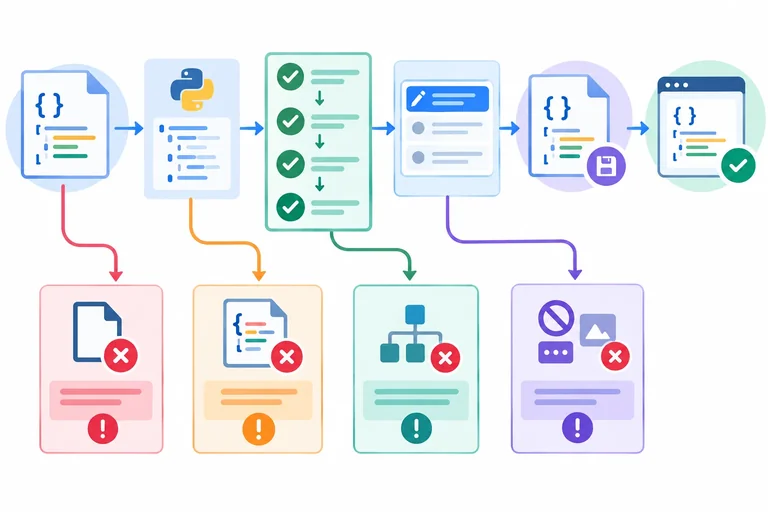
Passo 8 de 8
Execute localmente o ciclo completo de leitura, validação, atualização, gravação e conferência de uma coleção de tarefas, depois compare falhas de acesso, sintaxe, estrutura e serialização.
Crie uma pasta de treino e, dentro dela, salve o conteúdo abaixo como tarefas.json. Depois, crie o script atualizar_tarefas.py na mesma pasta. A prática seguirá este ciclo: carregar, validar, alterar, validar novamente, serializar, gravar um único documento e reabrir para conferir.
Observe que a gravação só ocorre depois que os dados carregados e os dados alterados atravessam suas validações.
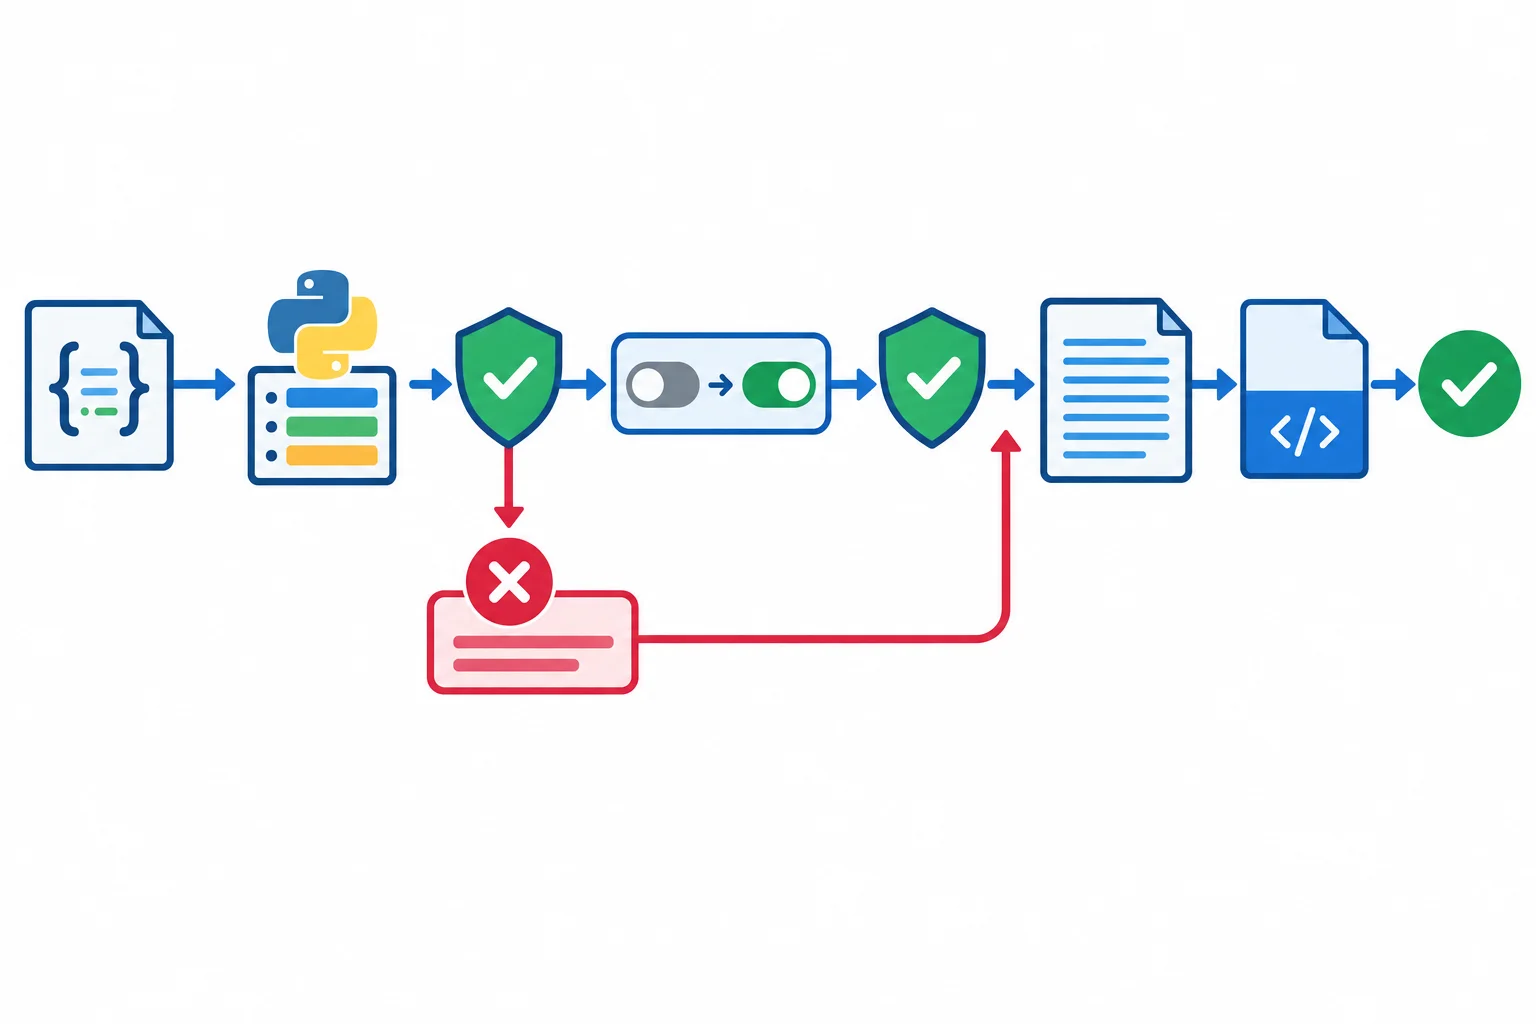
O arquivo só é substituído depois das verificações e da serialização bem-sucedidas.
Salve exatamente este documento inicial em UTF-8:
{
  "tarefas": [
    {
      "titulo": "Revisar persistência",
      "concluida": false,
      "prioridade": 4
    },
    {
      "titulo": "Conferir relatório",
      "concluida": false,
      "prioridade": 2
    }
  ]
}Salve o código como atualizar_tarefas.py e execute-o no terminal. Ele altera a primeira tarefa para concluída. A string JSON é produzida antes da abertura em modo w, evitando truncar o arquivo quando a serialização falha.
O script separa parsing, validação, serialização, escrita e conferência final:
import json
from pathlib import Path

CAMINHO = Path("tarefas.json")


def validar_colecao(dados):
    if not isinstance(dados, dict):
        raise TypeError("a raiz deve ser um dict")

    if "tarefas" not in dados:
        raise ValueError("o campo 'tarefas' é obrigatório")

    tarefas = dados["tarefas"]
    if not isinstance(tarefas, list):
        raise TypeError("o campo 'tarefas' deve ser uma list")

    obrigatorios = ("titulo", "concluida", "prioridade")

    for indice, tarefa in enumerate(tarefas):
        referencia = f"tarefas[{indice}]"

        if not isinstance(tarefa, dict):
            raise TypeError(f"{referencia} deve ser um dict")

        for campo in obrigatorios:
            if campo not in tarefa:
                raise ValueError(
                    f"{referencia}: o campo {campo!r} é obrigatório"
                )

        titulo = tarefa["titulo"]
        if not isinstance(titulo, str):
            raise TypeError(f"{referencia}.titulo deve ser str")
        if not titulo.strip():
            raise ValueError(f"{referencia}.titulo não pode ser vazio")

        concluida = tarefa["concluida"]
        if not isinstance(concluida, bool):
            raise TypeError(f"{referencia}.concluida deve ser bool")

        prioridade = tarefa["prioridade"]
        if isinstance(prioridade, bool) or not isinstance(prioridade, int):
            raise TypeError(f"{referencia}.prioridade deve ser int")
        if not 1 <= prioridade <= 5:
            raise ValueError(
                f"{referencia}.prioridade deve estar entre 1 e 5"
            )


def carregar(caminho):
    with caminho.open("r", encoding="utf-8") as arquivo:
        return json.load(arquivo)


def executar(caminho):
    try:
        dados = carregar(caminho)
    except OSError as erro:
        print(f"Falha de acesso: {erro}")
        return
    except UnicodeDecodeError as erro:
        print(f"Falha ao decodificar o arquivo como UTF-8: {erro}")
        return
    except json.JSONDecodeError as erro:
        print(
            "JSON inválido: "
            f"{erro.msg}, linha {erro.lineno}, coluna {erro.colno}"
        )
        return

    try:
        validar_colecao(dados)
    except (TypeError, ValueError) as erro:
        print(f"Dados incompatíveis com a aplicação: {erro}")
        return

    dados["tarefas"][0]["concluida"] = True
    validar_colecao(dados)

    try:
        texto_json = json.dumps(
            dados,
            indent=2,
            ensure_ascii=False,
        )
    except TypeError as erro:
        print(f"Falha de serialização: {erro}")
        return

    try:
        with caminho.open("w", encoding="utf-8") as arquivo:
            arquivo.write(texto_json)
            arquivo.write("\n")
    except OSError as erro:
        print(f"Falha de gravação: {erro}")
        return

    try:
        confirmacao = carregar(caminho)
        validar_colecao(confirmacao)
    except OSError as erro:
        print(f"Falha ao reabrir o arquivo: {erro}")
        return
    except UnicodeDecodeError as erro:
        print(f"Falha ao decodificar a conferência: {erro}")
        return
    except json.JSONDecodeError as erro:
        print(
            "JSON inválido na conferência: "
            f"{erro.msg}, linha {erro.lineno}, coluna {erro.colno}"
        )
        return
    except (TypeError, ValueError) as erro:
        print(f"Dados inválidos na conferência: {erro}")
        return

    primeira = confirmacao["tarefas"][0]
    print(f"Título reaberto: {primeira['titulo']}")
    print(f"Concluída após reabrir: {primeira['concluida']}")


if __name__ == "__main__":
    executar(CAMINHO)
Atenção
Use arquivos separados nos próximos testes. Uma entrada malformada ou incompatível deve interromper o fluxo antes da abertura em modo w; ela não deve ser silenciosamente substituída por uma coleção vazia. A serialização antecipada reduz um risco de truncamento, mas não desfaz uma falha ocorrida durante a escrita.
Primeiro, execute com o tarefas.json correto e confirme que o terminal mostra o título acentuado e True. Depois, crie os dois arquivos abaixo e altere temporariamente CAMINHO para cada nome. Para a falha de acesso, use Path("nao_existe.json"). Antes de cada teste, observe o conteúdo do arquivo e confira que entradas inválidas não foram sobrescritas.
Este documento tem uma vírgula final e deve produzir JSONDecodeError, apresentada pelo script como JSON inválido com linha e coluna:
{
  "tarefas": [
    {
      "titulo": "Revisar persistência",
      "concluida": false,
      "prioridade": 4,
    }
  ]
}Este texto é JSON válido, mas não cumpre o contrato da aplicação porque falta concluida:
{
  "tarefas": [
    {
      "titulo": "Revisar persistência",
      "prioridade": 4
    }
  ]
}Relate o valor de concluida após a reabertura, a preservação do título acentuado e o diagnóstico obtido com malformado.json, campo_ausente.json e nao_existe.json.
Escreva pelo menos 120 caracteres (0/120).
Por que uma entrada inválida não deve provocar a sobrescrita do arquivo original? Inclua na resposta o papel da validação, de json.dumps e do modo w.
Escreva pelo menos 100 caracteres (0/100).
Resumo
Você concluiu o ciclo de persistência quando consegue carregar, validar, alterar, salvar e reabrir os dados sem confundir as etapas e suas falhas.
dumps e loads para strings; use dump e load quando trabalhar diretamente com objetos de arquivo.ensure_ascii controla a representação dos caracteres, não a codificação do arquivo.w, lembrando que isso não protege contra toda falha possível durante a escrita.Parabéns! Você concluiu: Salvar e carregar dados em JSON
100 XP
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks