Passo 1 de 8
Reconhecer o trabalho repetido nas buscas
Identifique quando consultas repetidas voltam a percorrer a mesma fonte e por que isso pode justificar uma estrutura auxiliar.
Trilha de aprendizado · Nível 14 · Tutorial 4
Substitua varreduras repetidas por índices com dicionários ou conjuntos quando o ganho de consulta justificar a construção e a memória adicional.
 Reconhecer o trabalho repetido nas buscas
Identifique quando consultas repetidas voltam a percorrer a mesma fonte e por que isso pode justificar uma estrutura auxiliar. 2 min
 Usar um conjunto para consultas de existência
Prepare um conjunto de códigos uma vez e reutilize-o para responder se um código está presente no catálogo. 2 min
 Associar chaves a registros com um dicionário
Crie um índice por código para recuperar registros sem repetir varreduras e defina claramente o que ocorre quando não há correspondência. 2 min
 Preservar duplicatas, multiplicidade e ordem
Escolha uma política de indexação que mantenha o mesmo resultado observável da busca original. 3 min
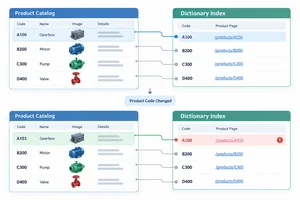 Manter o índice coerente com a fonte
Entenda quando um índice deixa de refletir a coleção original e escolha entre atualizá-lo pontualmente ou reconstruí-lo. 2 min
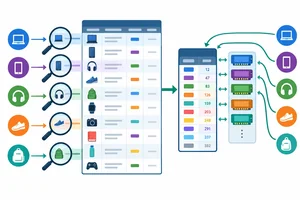 Avaliar construção, consultas e memória
Compare o custo completo das varreduras e dos índices, incluindo preparação, resultados produzidos, manutenção e memória auxiliar. 3 min
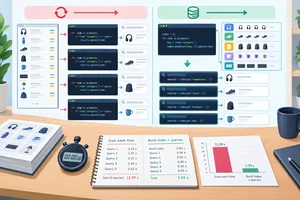 Comparar as estratégias em uma execução local
Meça uma busca por grupos com varredura e com índice de listas, incluindo o custo de construção e separando uso único de reutilização. 3 min
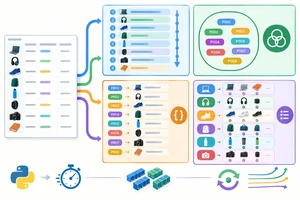 Aplicar e justificar a escolha do índice
Finalize a otimização com evidências de equivalência, custo completo, memória adicional e coerência após mudanças na fonte. 3 min
Passo 1 de 8
Identifique quando consultas repetidas voltam a percorrer a mesma fonte e por que isso pode justificar uma estrutura auxiliar.
Imagine um catálogo com n registros de produtos. Seu programa recebe m consultas: algumas procuram um código, outras uma categoria.
Uma busca sequencial pode parecer barata isoladamente. Mas, se cada consulta percorre novamente o catálogo, a mesma coleção é lida muitas vezes. Como visto no perfilamento, uma operação pouco cara por chamada pode concentrar tempo quando é chamada em grande quantidade.
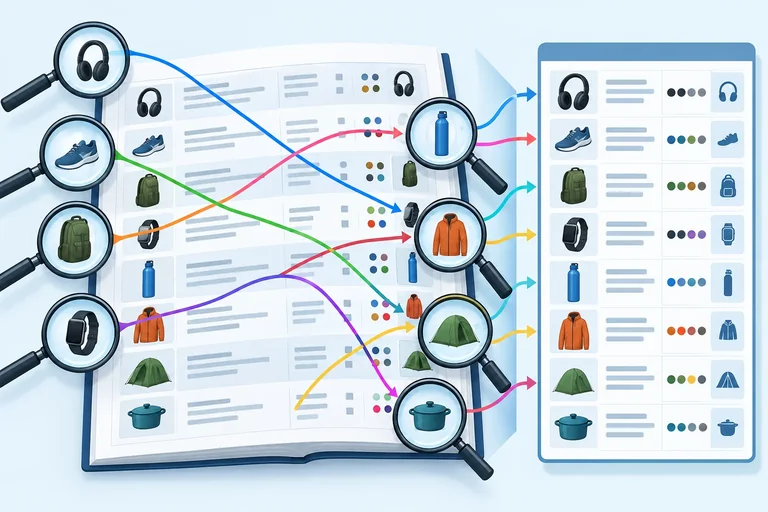
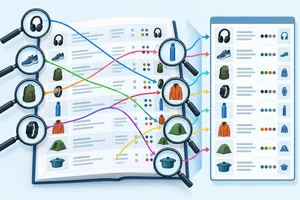
Cada seta representa uma consulta que começa novamente no catálogo.
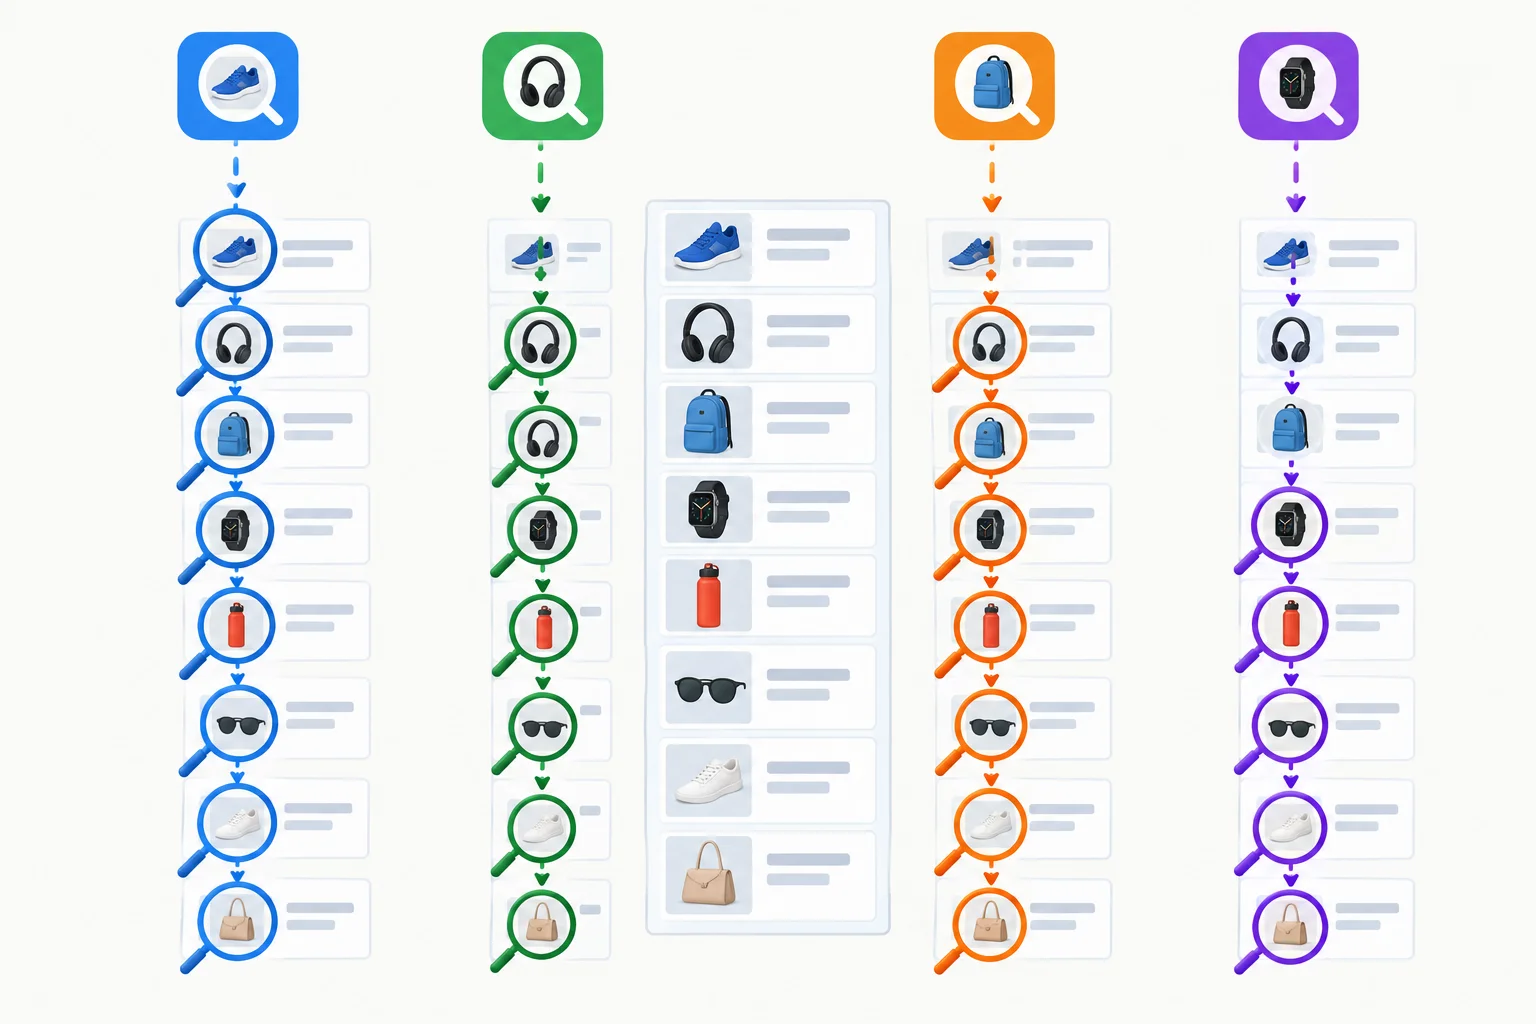
Sem uma organização auxiliar, consultas independentes podem repetir a leitura da mesma fonte.
Cada chamada pode examinar o catálogo inteiro.
catalogo = [
    {"codigo": "A10", "categoria": "livros"},
    {"codigo": "B20", "categoria": "jogos"},
    {"codigo": "C30", "categoria": "livros"},
]

consultas = ["C30", "X99", "A10"]

def buscar_por_codigo(catalogo, codigo):
    for produto in catalogo:
        if produto["codigo"] == codigo:
            return produto
    return None

resultados = []
for codigo in consultas:
    resultados.append(buscar_por_codigo(catalogo, codigo))

print(resultados)Aqui, n é a quantidade de produtos no catálogo e m é a quantidade de códigos consultados. No pior caso, cada uma das m consultas examina n registros: O(mn).
O trabalho efetivo varia: um produto no início encerra a busca cedo; um produto no fim exige mais comparações; uma ausência percorre toda a fonte. Ainda assim, repetir varreduras é a hipótese importante a investigar.
Quando muitas consultas usam a mesma fonte durante um período, vale considerar uma organização auxiliar por chave criada uma vez e reutilizada nas consultas.
A intenção não é eliminar o custo: a preparação percorre a fonte e ocupa memória adicional. A possível vantagem é evitar que cada nova consulta recomece a varredura completa. Nos próximos passos, você construirá as estruturas adequadas para cada tipo de pergunta.
Dica
Antes de otimizar, pergunte: a coleção permanece suficientemente estável e a mesma informação será consultada muitas vezes? Se a resposta for sim, um índice auxiliar é uma hipótese plausível para medir depois.
Um catálogo tem n produtos. Para cada um de m códigos solicitados, uma função percorre o catálogo desde o início até encontrar o código ou chegar ao fim. Qual afirmação descreve melhor o cenário?
Passo 2 de 8
Prepare um conjunto de códigos uma vez e reutilize-o para responder se um código está presente no catálogo.
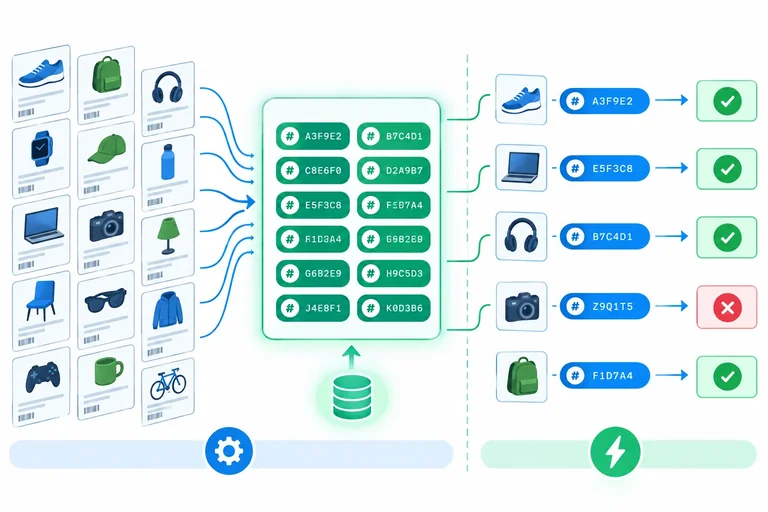
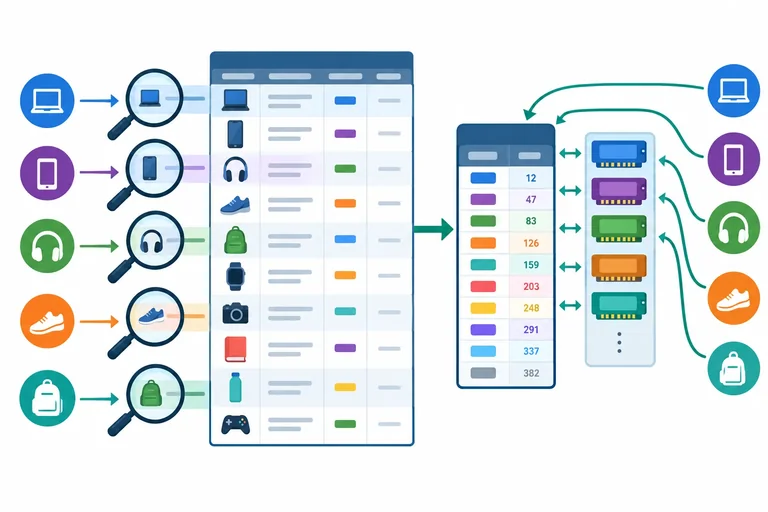
Quando cada consulta só precisa responder “este código existe?”, extraia os códigos do catálogo para um set antes do laço de consultas. Assim, a coleção original não precisa ser percorrida novamente para cada código perguntado.
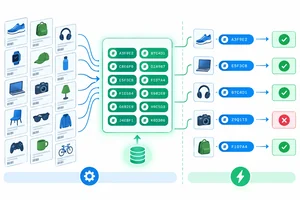
O conjunto guarda somente as chaves distintas necessárias para responder à pergunta de presença.
A fonte é percorrida na preparação; as consultas repetidas usam o conjunto auxiliar.
Cada consulta usa in no mesmo conjunto já preparado.
catalogo = [
    {"codigo": "A10", "nome": "Caderno"},
    {"codigo": "B20", "nome": "Caneta"},
    {"codigo": "A10", "nome": "Caderno - outra entrada"},
]

# Preparação: uma varredura para extrair a chave de consulta.
codigos_disponiveis = {produto["codigo"] for produto in catalogo}

consultas = ["B20", "X99", "A10", "X99"]
for codigo in consultas:
    print(codigo, codigo in codigos_disponiveis)
O conjunto responde se uma chave está presente. Ele não informa quantas vezes o código apareceu nem qual produto estava associado a ele. Para este uso, a chave extraída ao construir o conjunto deve seguir o mesmo critério usado na consulta — por exemplo, o mesmo código normalizado.
Dica
Use chaves hasháveis e estáveis durante a vida do conjunto. Strings e números são escolhas comuns. Mesmo com custo médio esperado O(1), isso depende de hashing e igualdade com custo limitado; colisões ou chaves caras impedem tratar esse custo como garantia absoluta.
Associe cada pergunta ao tipo de informação que ela exige.
Toque em um item e depois no par correspondente.
Passo 3 de 8
Crie um índice por código para recuperar registros sem repetir varreduras e defina claramente o que ocorre quando não há correspondência.
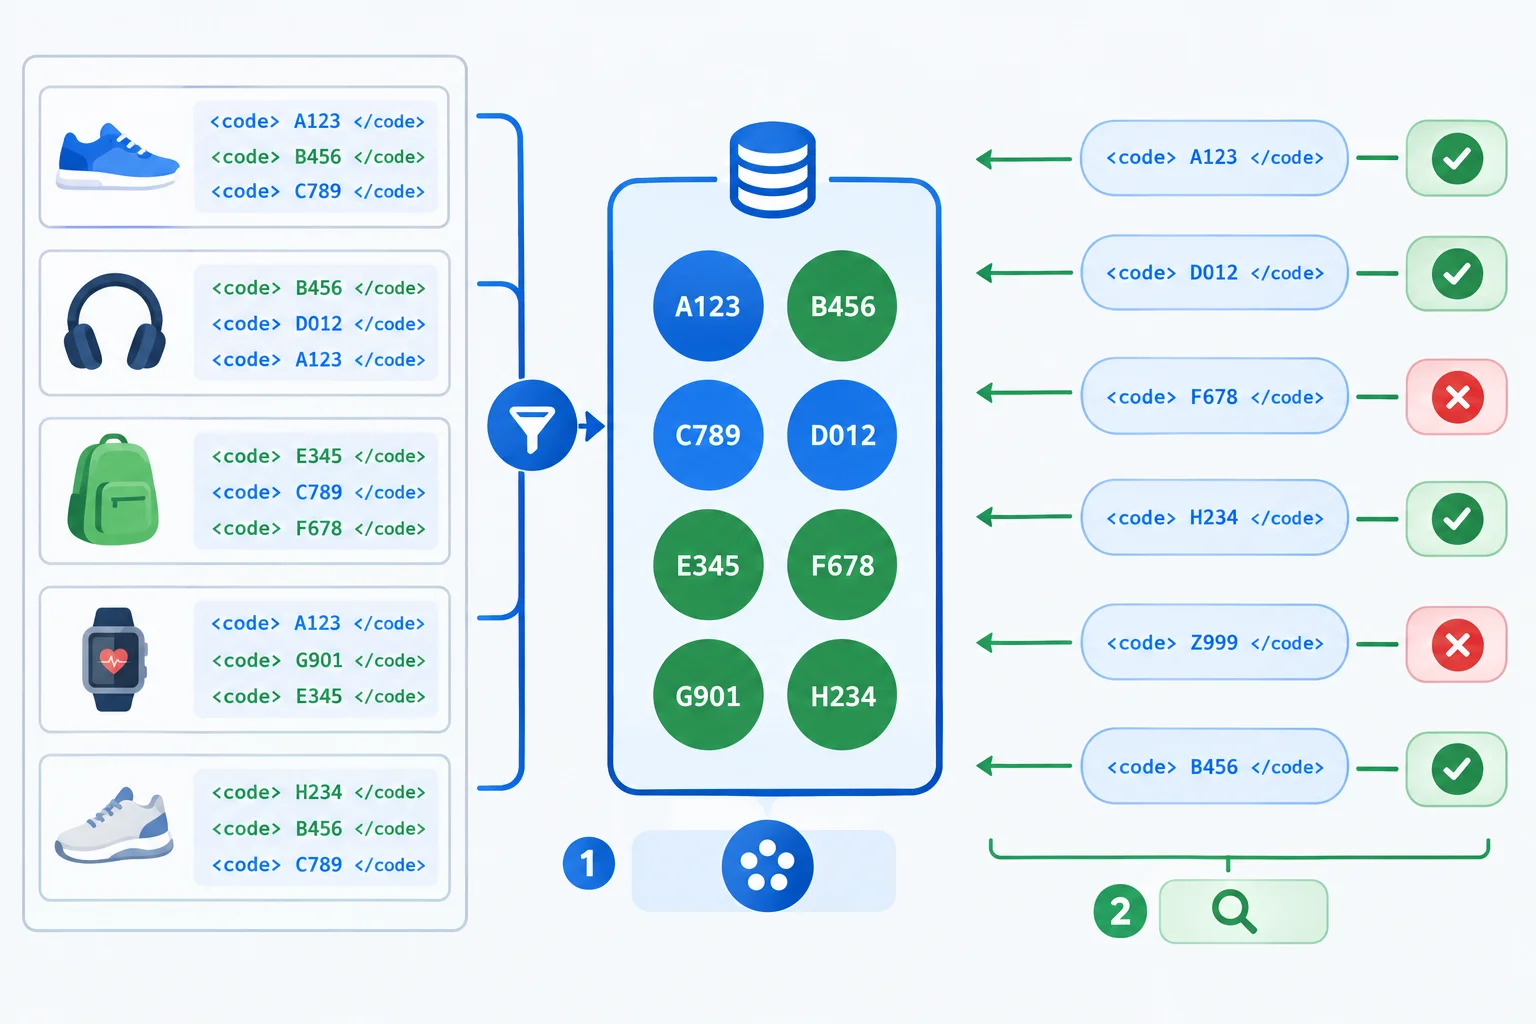
Quando cada produto tem um código único, construa um dicionário que associe cada código ao seu registro. A construção percorre o catálogo uma vez; depois, várias consultas reutilizam o mesmo índice.
A chave do índice deve representar o mesmo critério da busca original. Se a busca comparava produto["codigo"] == codigo_consultado, use exatamente produto["codigo"] como chave.
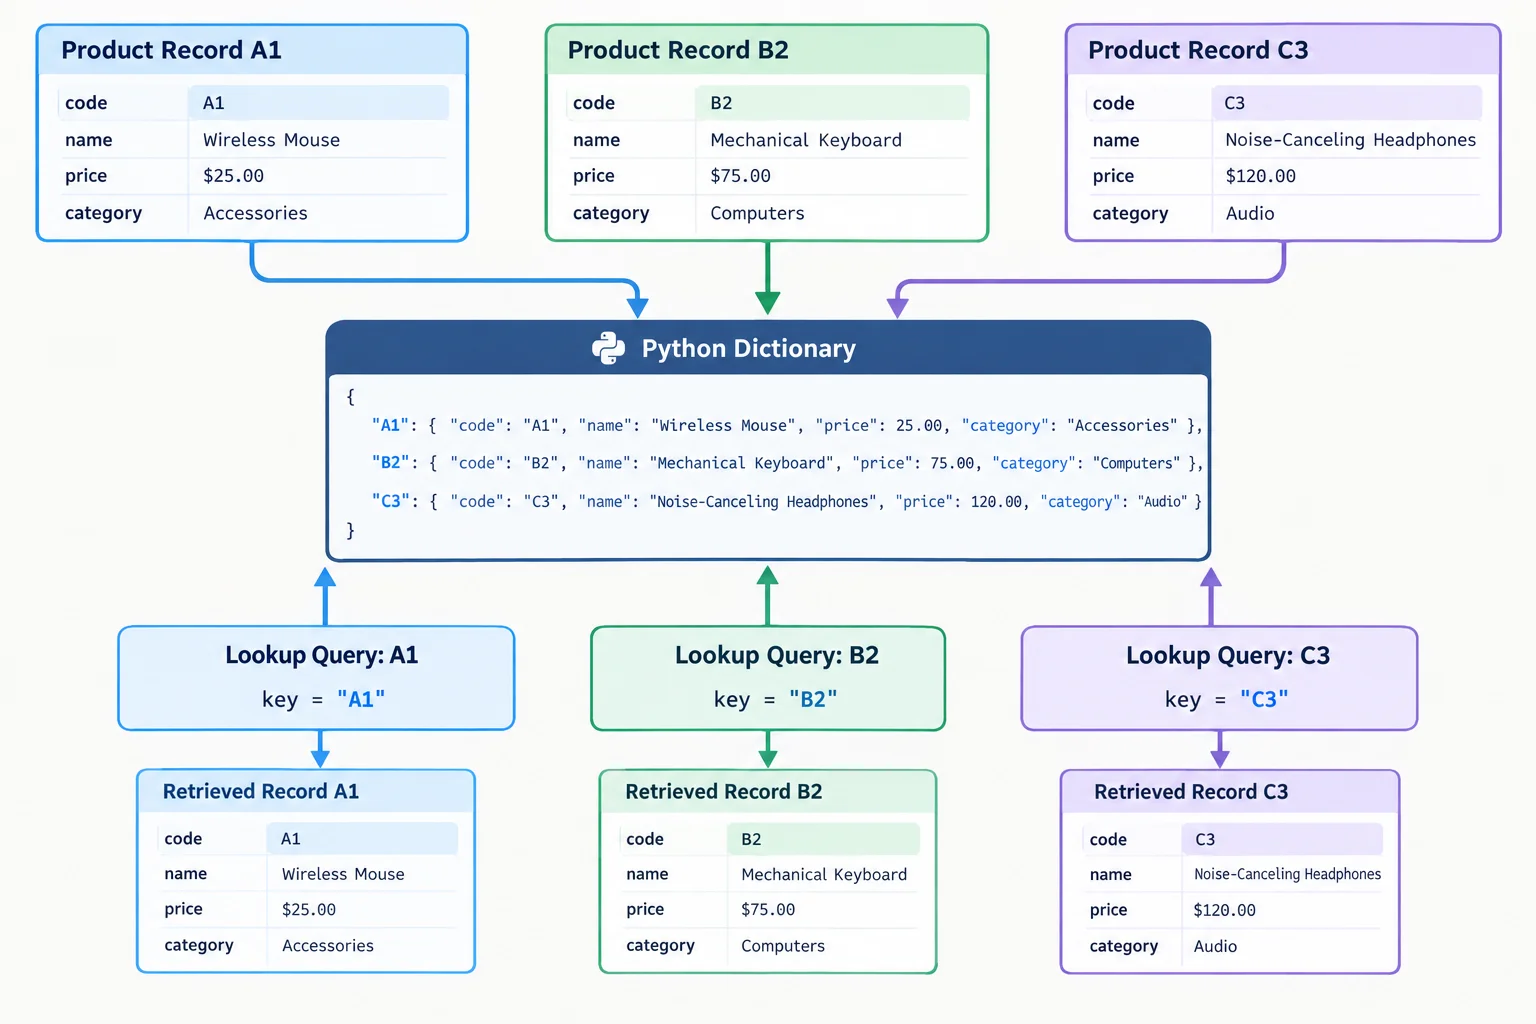
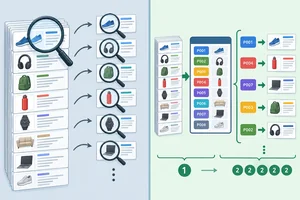
Construa uma vez a associação código → registro e consulte-a quantas vezes forem necessárias.
A compreensão cria o índice fora do laço de consultas. A hipótese de códigos únicos faz parte do contrato deste exemplo.
catalogo = [
    {"codigo": "A10", "nome": "Caderno", "preco": 18.0},
    {"codigo": "B20", "nome": "Caneta", "preco": 4.5},
    {"codigo": "C30", "nome": "Mochila", "preco": 120.0},
]

# Construção: uma associação por código único.
por_codigo = {produto["codigo"]: produto for produto in catalogo}

consultas = ["B20", "C30", "B20"]
for codigo in consultas:
    produto = por_codigo[codigo]
    print(produto["nome"])

# Caneta
# Mochila
# Caneta
Dica
Este índice simples pressupõe que dois registros não compartilham o mesmo código. Se houver repetição, uma associação pode substituir outra; as políticas para duplicatas serão tratadas no próximo passo.
Uma consulta pode exigir comportamentos diferentes para um código que não está no catálogo:
por_codigo.get(codigo) para retornar um padrão, como None;if codigo in por_codigo quando for preciso distinguir presença;por_codigo[codigo] quando o contrato determina que a ausência deve sinalizar KeyError.Escolha o comportamento que a busca anterior já prometia ao restante do programa.
Aqui, None é um valor válido do campo preco_promocional. Por isso, get sozinho não permite saber se o código existe.
por_codigo = {
    "A10": {"codigo": "A10", "nome": "Caderno", "preco_promocional": None},
}

codigo = "A10"
produto = por_codigo.get(codigo)

if codigo in por_codigo:
    print(produto["preco_promocional"])  # None: valor válido armazenado
else:
print("Código não encontrado")Complete a condição para imprimir "Código não encontrado" apenas quando a chave estiver ausente:
if codigo ____ por_codigo:
Se por_codigo.get(codigo) retorna None, então o código certamente não existe no dicionário.
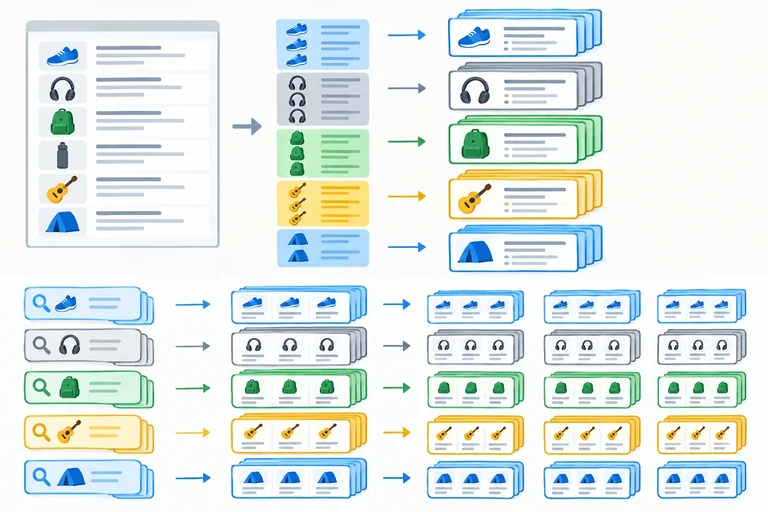
Passo 4 de 8
Escolha uma política de indexação que mantenha o mesmo resultado observável da busca original.
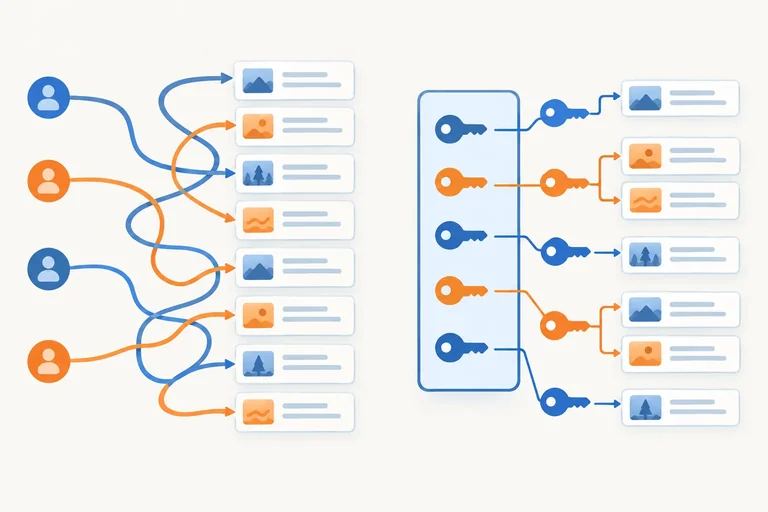
Um índice chave → registro funciona quando a chave é única. Se ela puder se repetir, a atribuição posterior substitui a anterior. Portanto, o índice pode mudar o resultado da busca, mesmo que a consulta pareça mais rápida.
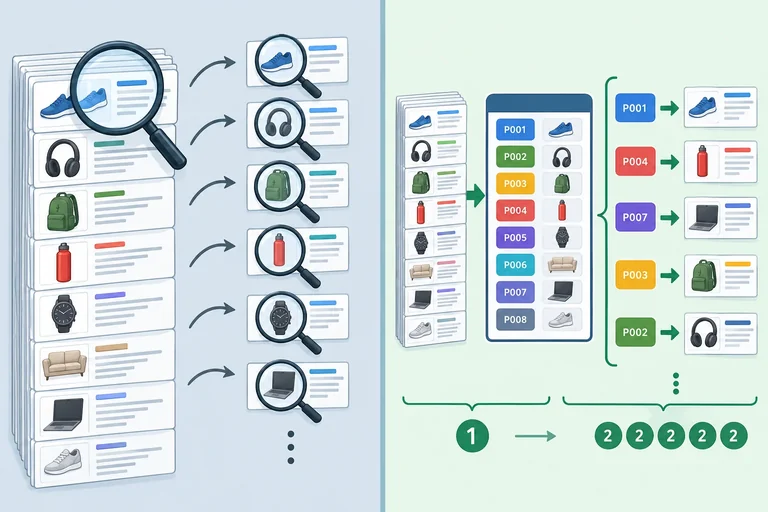
Compare o efeito de indexar produtos que compartilham a mesma categoria.
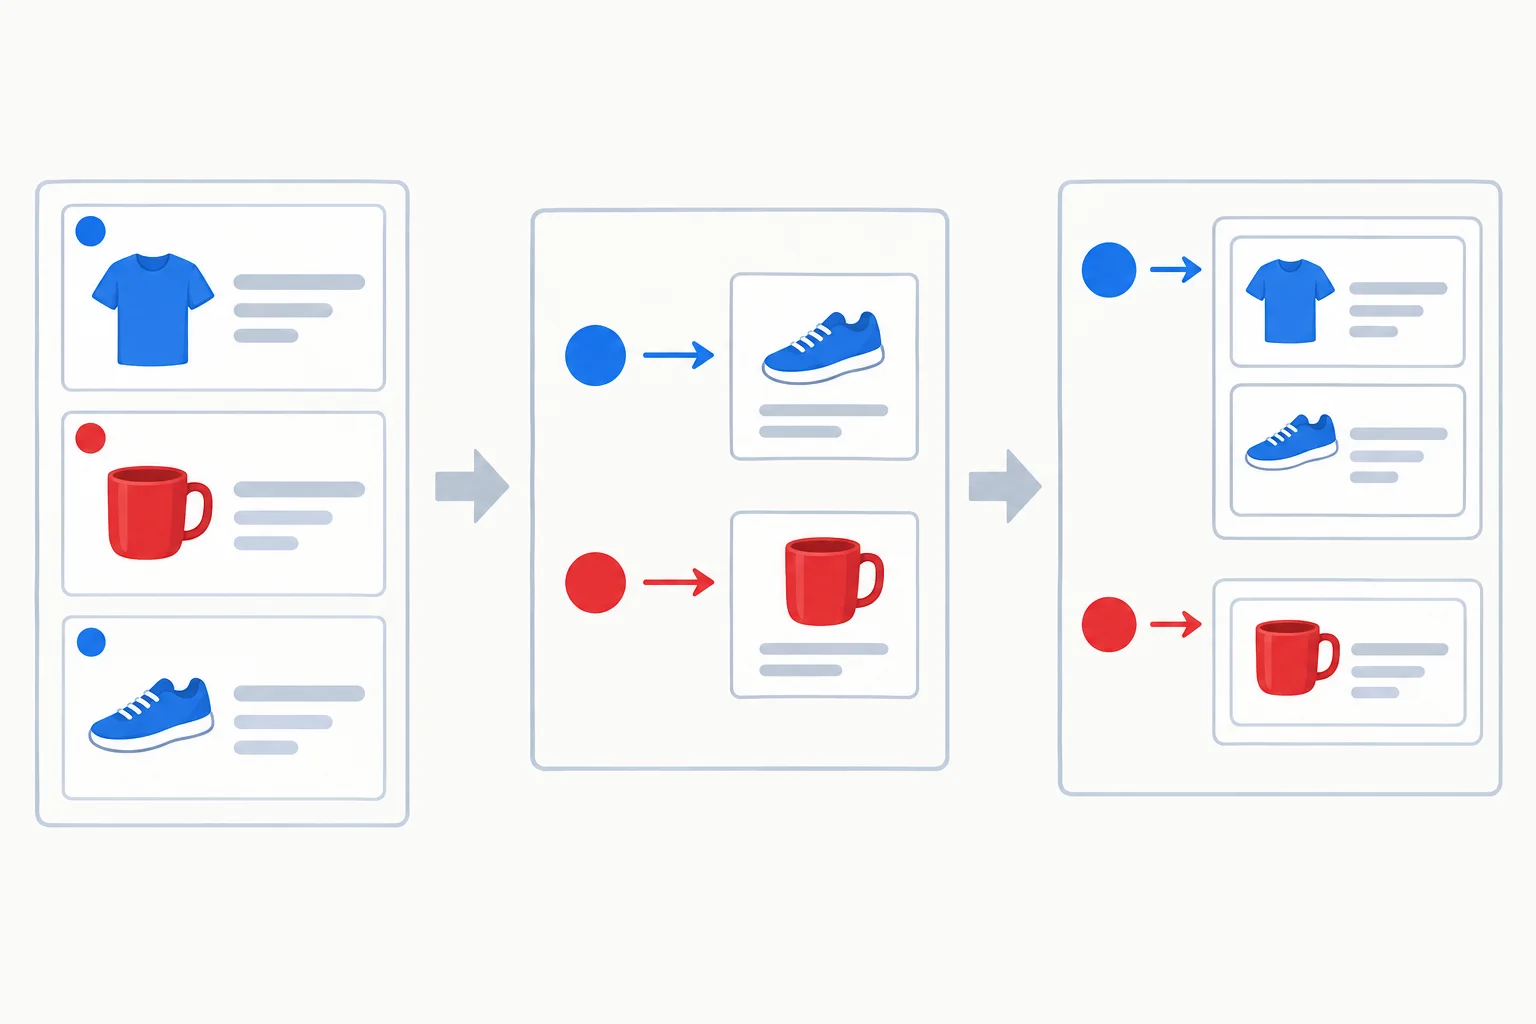
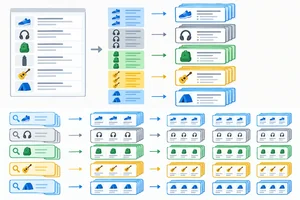
Para recuperar todas as ocorrências, a chave deve apontar para um grupo, não para apenas um registro.
Atenção
Para chaves repetidas, o contrato precisa escolher uma política: manter o primeiro registro, manter o último, rejeitar a duplicata ou guardar todos. Não deixe a política ser um efeito acidental de indice[chave] = registro.
Quando a busca original retorna todos os produtos de uma categoria, construa um dicionário de listas. Ao percorrer a fonte sequencialmente e usar append, cada lista preserva a ordem em que aqueles registros apareciam na fonte.
Cada categoria aponta para todos os produtos correspondentes.
produtos = [
    {"codigo": "A1", "categoria": "livros", "nome": "Python"},
    {"codigo": "B2", "categoria": "casa", "nome": "Luminária"},
    {"codigo": "C3", "categoria": "livros", "nome": "Algoritmos"},
]

por_categoria = {}
for produto in produtos:
    categoria = produto["categoria"]
    por_categoria.setdefault(categoria, []).append(produto)

consultas = ["livros", "inexistente", "livros"]
resultados = [por_categoria.get(categoria, []) for categoria in consultas]

print(resultados)
# [[{'codigo': 'A1', ...}, {'codigo': 'C3', ...}], [],
#  [{'codigo': 'A1', ...}, {'codigo': 'C3', ...}]]
Dica
A lista de cada categoria segue a ordem da fonte. Já resultados segue a ordem das consultas, inclusive quando uma consulta se repete. Percorrer as chaves do dicionário não recompõe nenhuma dessas duas sequências.
Localizar a lista de uma categoria no dicionário tem custo médio esperado constante. Porém, se a aplicação precisar percorrer, copiar ou exibir os itens encontrados, esse trabalho cresce com a quantidade de registros do grupo. Uma consulta que retorna 500 produtos ainda precisa lidar com 500 resultados.
A fonte tem dois produtos na categoria livros. As consultas são ['livros', 'ausente', 'livros'], e a busca original devolve todos os produtos encontrados por consulta, em ordem. Por que um dicionário categoria → produto altera o resultado? Qual estrutura e qual comportamento de ausência você escolheria para preservar esse contrato?
Escreva pelo menos 80 caracteres (0/80).
Passo 5 de 8
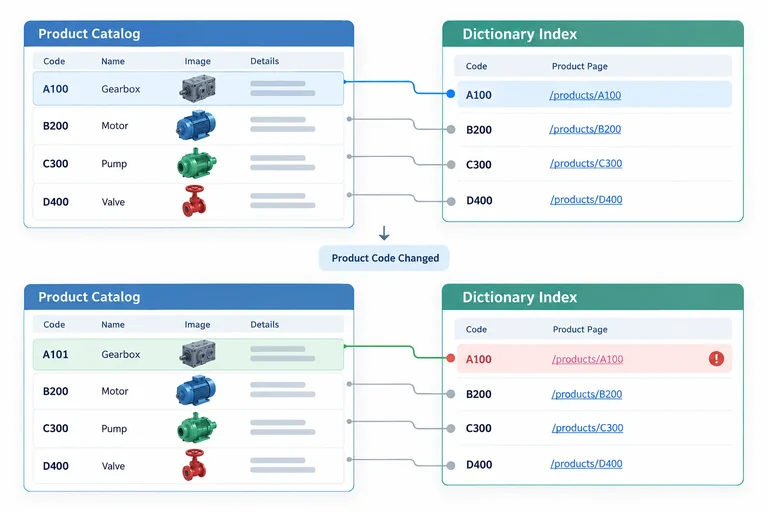
Entenda quando um índice deixa de refletir a coleção original e escolha entre atualizá-lo pontualmente ou reconstruí-lo.
Um dicionário usado como índice é uma estrutura auxiliar: ele não acompanha automaticamente inserções, remoções ou substituições feitas na lista de produtos.
Se você construiu por_codigo e depois alterou a fonte, faça uma pergunta antes de consultar: o índice ainda representa o estado que deve ser pesquisado?
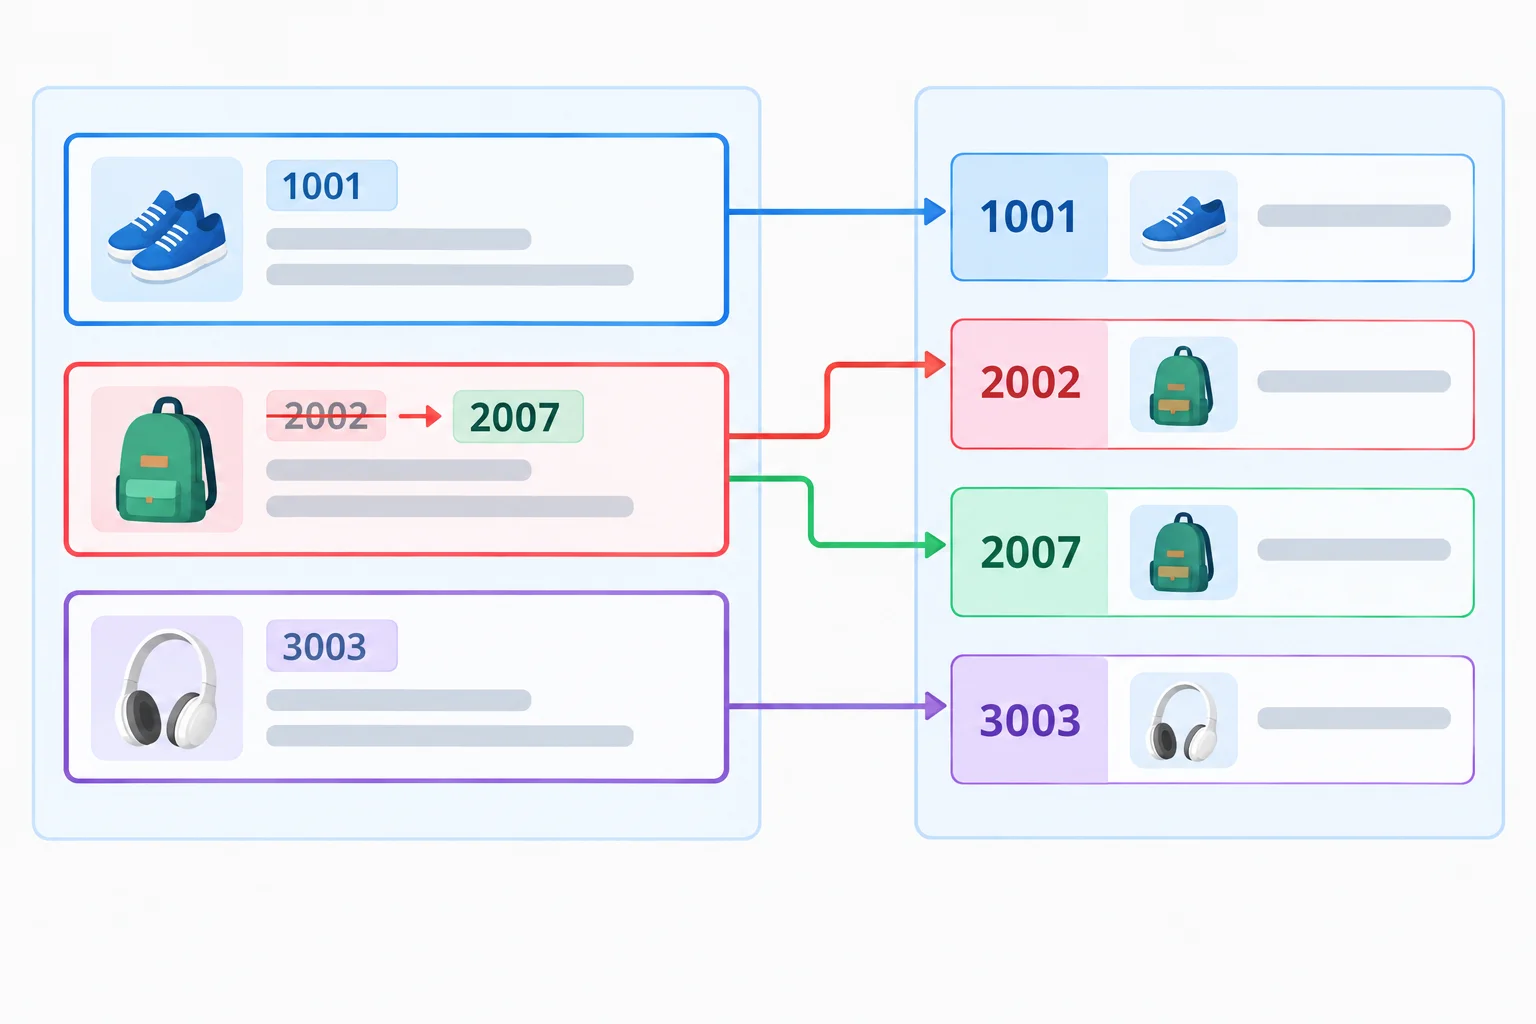
Alterar a fonte não atualiza automaticamente a chave já armazenada no índice.
Atenção
Se o campo usado como chave muda, o registro pode continuar existindo, mas o índice ainda o associa à chave antiga. Remova o vínculo antigo e crie o novo vínculo — ou reconstrua o índice antes das consultas atuais.
Quando o índice guarda referências aos mesmos dicionários da fonte, alterar um campo não indexado é visível pela consulta: a referência continua sendo a mesma.
Já substituir um item da lista por outro dicionário não troca a referência guardada no índice. E alterar a própria chave exige atualizar o mapeamento, mesmo que o objeto seja compartilhado.
Execute este exemplo localmente para observar o índice antes e depois da alteração.
produtos = [
    {"codigo": "A10", "nome": "Caderno", "preco": 18.0},
    {"codigo": "B20", "nome": "Caneta", "preco": 4.5},
]

por_codigo = {produto["codigo"]: produto for produto in produtos}

# Campo não indexado: a referência compartilhada mostra o novo preço.
produtos[0]["preco"] = 20.0
print(por_codigo["A10"]["preco"])  # 20.0

# Campo indexado: atualize também os vínculos do índice.
produto = produtos[1]
codigo_anterior = produto["codigo"]
novo_codigo = "B21"

del por_codigo[codigo_anterior]
produto["codigo"] = novo_codigo
por_codigo[novo_codigo] = produto

print(por_codigo.get("B20"))  # None
print(por_codigo["B21"])      # registro da Caneta
Dica
A atualização incremental só é simples quando a mudança é conhecida e a política de duplicatas está clara. Por exemplo, antes de inserir uma nova chave em um índice de chaves únicas, valide se ela já existe; em um índice de listas, atualize o grupo correto sem perder sua ordem.
Atualize incrementalmente quando cada alteração é conhecida, pequena e simples de refletir no índice. Reconstrua quando houve um lote de mudanças, remoções e substituições, ou quando conferir todos os vínculos seria mais complexo e arriscado.
Defina um período de validade: construa ou atualize o índice antes do conjunto de consultas que precisa enxergar dados atuais. Um índice pode ser reutilizado apenas enquanto sua fonte permanecer compatível com ele.
Um índice por_codigo associa códigos únicos aos registros. Ordene as ações para trocar o código de um produto de B20 para B21 e manter o índice coerente.
Você recebeu um lote que removeu produtos, substituiu vários registros e alterou códigos. Quando reconstruir o índice tende a ser mais seguro do que atualizá-lo pontualmente? Justifique.
Escreva pelo menos 40 caracteres (0/40).
Passo 6 de 8
Compare o custo completo das varreduras e dos índices, incluindo preparação, resultados produzidos, manutenção e memória auxiliar.
Considere n registros na fonte e m consultas exatas.
Isso pressupõe chaves com hashing e igualdade de custo limitado, além de uma tabela hash com comportamento médio esperado. O índice não elimina o custo de produzir a resposta.
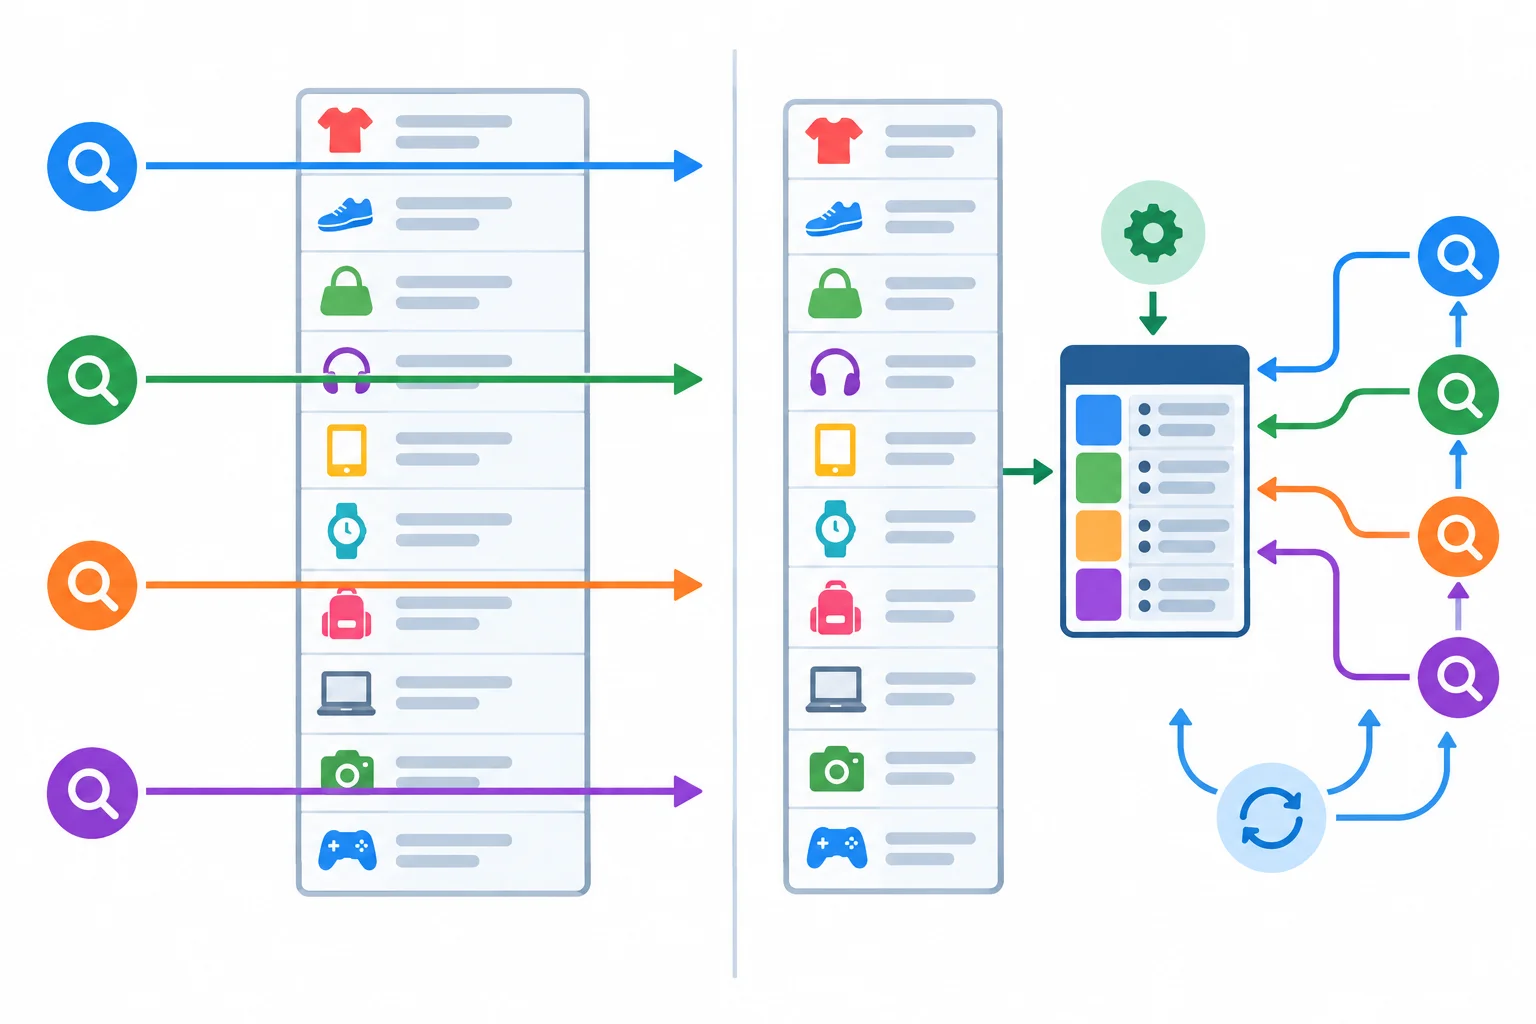
A preparação troca uma passagem inicial e memória auxiliar por evitar novas varreduras completas.
Exemplo
Para consultar um produto por código único, o resultado tem tamanho limitado: a análise O(n + m) descreve construção e consultas.
Para consultar categorias, uma consulta pode devolver vários produtos. Se, somando todas as respostas, forem produzidos r registros, o custo esperado passa a ser O(n + m + r).
Mesmo que localizar a lista da categoria seja esperado como constante, percorrer ou materializar 80 produtos retornados custa trabalho proporcional a esses 80.
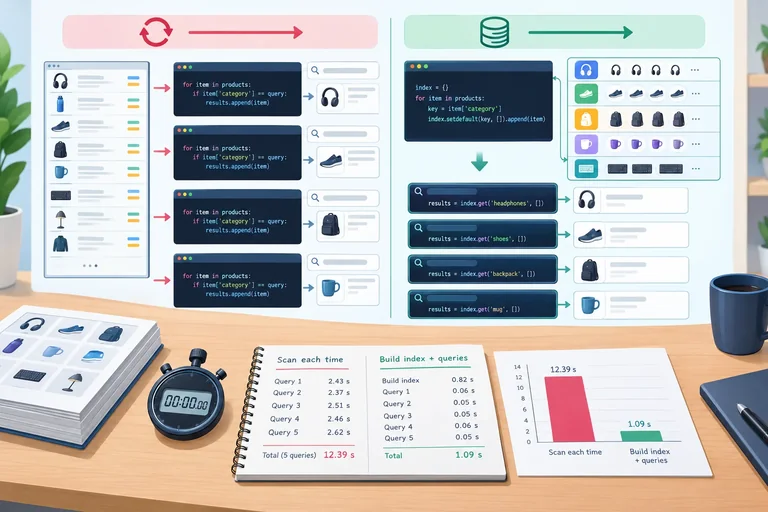
A construção só é amortizada pelas consultas feitas enquanto o índice continua válido. Em um uso único, o custo de construir — e talvez manter — o índice pode não compensar uma varredura simples. Em muitas consultas sobre a mesma fonte estável, esse custo inicial é dividido entre elas.
Não existe um número universal de consultas a partir do qual o índice vence: depende de n, m, distribuição das buscas, tamanho das respostas, custo das chaves, manutenção e memória disponível.
Se u é o número de chaves distintas:
A fonte e o índice coexistem. Guardar uma referência ao registro não cria uma cópia integral dele, mas a tabela, as listas e as próprias referências ainda ocupam memória. Essas ordens e contagens não informam, sozinhas, o total real em bytes.
Dica
Se a fonte muda durante o período de uso, some o custo de atualizar ou reconstruir o índice. Compare o cenário real: construção + consultas + manutenção + memória auxiliar.
Um catálogo pequeno tem n = 20 produtos. O programa fará apenas uma consulta por código e descartará o catálogo em seguida. Qual decisão é mais justificável antes de medir?
Cenário A: 20 registros e 1 consulta exata. Cenário B: 200 mil registros, milhares de consultas por categoria, fonte estável durante o lote e grupos com resultados que precisam ser percorridos. Qual estratégia você tenderia a escolher em cada caso? Justifique incluindo construção, consultas, saída e memória.
Escreva pelo menos 80 caracteres (0/80).
Passo 7 de 8
Meça uma busca por grupos com varredura e com índice de listas, incluindo o custo de construção e separando uso único de reutilização.
Use uma carga sintética determinística: o catálogo contém produtos repetidos por categoria, e as consultas incluem categorias presentes, ausentes e repetidas. Primeiro, confirme que as duas estratégias produzem exatamente o mesmo resultado.
Depois, compare quatro medidas: varrer o lote inteiro; construir e consultar no mesmo lote; consultar um índice já pronto; e construir isoladamente. A terceira medida representa reutilização. Sozinha, ela não responde se o investimento de construir o índice compensou para um único lote.
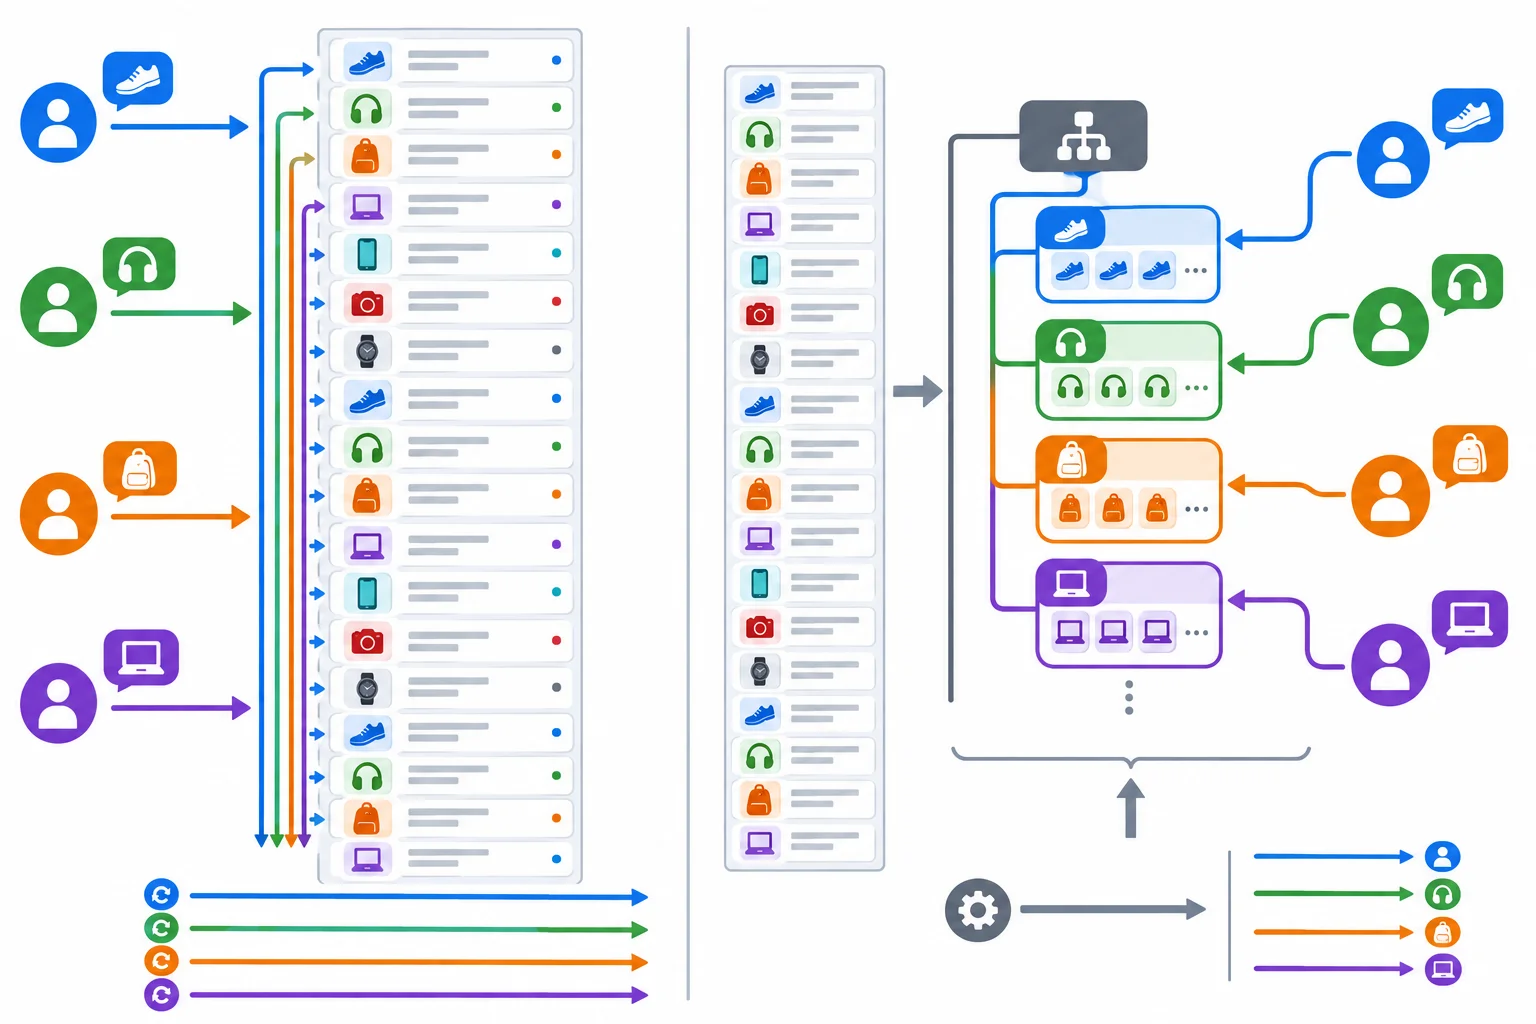
A construção pertence ao cenário de uso único; ela pode ser amortizada quando o mesmo índice atende a novos lotes de consultas.
Crie um arquivo chamado comparar_indices.py, copie o código abaixo e execute python comparar_indices.py. Ele usa somente a biblioteca padrão. O assert vem antes das medições porque tempo menor não serve se o contrato de resultado mudou.
import timeit

# Ajuste estes quatro controles e execute novamente.
N = 10_000             # registros na fonte
M = 600                # consultas no lote
U = 40                 # categorias distintas (cardinalidade de chaves)
FRACAO_AUSENTES = 0.25 # parte das consultas sem correspondência
REPETICOES = 5
NUMERO = 3


def criar_catalogo(n, u):
    u = min(u, n)
    return [
        {
            "id": i,
            "codigo": f"P{i:06d}",
            "categoria": f"categoria-{i % u}",
        }
        for i in range(n)
    ]


def criar_consultas(m, u, fracao_ausentes):
    presentes = round(m * (1 - fracao_ausentes))
    consultas_presentes = [f"categoria-{i % u}" for i in range(presentes)]
    consultas_ausentes = [f"ausente-{i % 7}" for i in range(m - presentes)]
    return consultas_presentes + consultas_ausentes


def buscar_varrendo(catalogo, consultas):
    # Uma tupla por consulta preserva inclusive consultas repetidas e ausências.
    return tuple(
        tuple(produto for produto in catalogo if produto["categoria"] == categoria)
        for categoria in consultas
    )


def construir_indice(catalogo):
    indice = {}
    for produto in catalogo:
        indice.setdefault(produto["categoria"], []).append(produto)
    return indice


def buscar_no_indice(indice, consultas):
    # tuple() evita expor a lista interna e mantém o mesmo formato da varredura.
    return tuple(tuple(indice.get(categoria, ())) for categoria in consultas)


def consumir(resultados):
    # Percorre também os grupos retornados: não mede só a localização da chave.
    return sum(produto["id"] for grupo in resultados for produto in grupo)


def melhor_por_execucao(comando):
    tempos = timeit.Timer(comando, globals=globals()).repeat(
        repeat=REPETICOES,
        number=NUMERO,
    )
    return min(tempos) / NUMERO


catalogo = criar_catalogo(N, U)
consultas = criar_consultas(M, U, FRACAO_AUSENTES)
indice_pronto = construir_indice(catalogo)

# Equivalência: grupos, ordem da fonte, ausências e ordem/repetições das consultas.
resultado_varredura = buscar_varrendo(catalogo, consultas)
resultado_indice = buscar_no_indice(indice_pronto, consultas)
assert resultado_varredura == resultado_indice
assert consumir(resultado_varredura) == consumir(resultado_indice)


def medir_varreduras():
    return consumir(buscar_varrendo(catalogo, consultas))


def medir_construcao_e_consultas():
    indice = construir_indice(catalogo)
    return consumir(buscar_no_indice(indice, consultas))


def medir_consultas_com_indice_pronto():
    return consumir(buscar_no_indice(indice_pronto, consultas))


def medir_construcao():
    return len(construir_indice(catalogo))


print(f"n={N}, m={M}, u={len(indice_pronto)}, ausentes={FRACAO_AUSENTES:.0%}")
print(f"estruturas mantidas: 1 dicionário e {len(indice_pronto)} listas de grupos")
print(f"varreduras do lote:          {melhor_por_execucao('medir_varreduras()'):.6f} s")
print(f"construção + consultas:      {melhor_por_execucao('medir_construcao_e_consultas()'):.6f} s")
print(f"consultas, índice pronto:    {melhor_por_execucao('medir_consultas_com_indice_pronto()'):.6f} s")
print(f"construção isolada: {melhor_por_execucao('medir_construcao()'):.6f} s")Dica
Anote os quatro tempos junto com n, m, u e a fração de ausentes. Altere uma variável por execução: aumente M para avaliar reutilização, altere U para mudar a cardinalidade e modifique FRACAO_AUSENTES para mudar a distribuição das consultas.
As contagens de chaves, listas e registros descrevem as estruturas auxiliares; elas não são uma medição em bytes. Para um lote único, compare principalmente “varreduras do lote” com “construção + consultas”. Para vários lotes durante a validade do índice, compare as consultas com índice pronto, sem esquecer que a construção ocorreu antes.
Não troque a carga de consultas entre versões para favorecer uma estratégia. Ambas precisam processar as mesmas ausências, repetir as mesmas consultas e consumir todos os registros de cada grupo retornado. Se você alterar a fonte, reconstrua ou atualize o índice antes de reutilizá-lo.
Execute o script com uma configuração sua. Registre n, m, u, a fração de ausentes e os quatro tempos. Em seguida, explique por que o tempo de consultas com o índice pronto, isoladamente, não decide se a indexação compensa para um único lote.
Escreva pelo menos 180 caracteres (0/180).
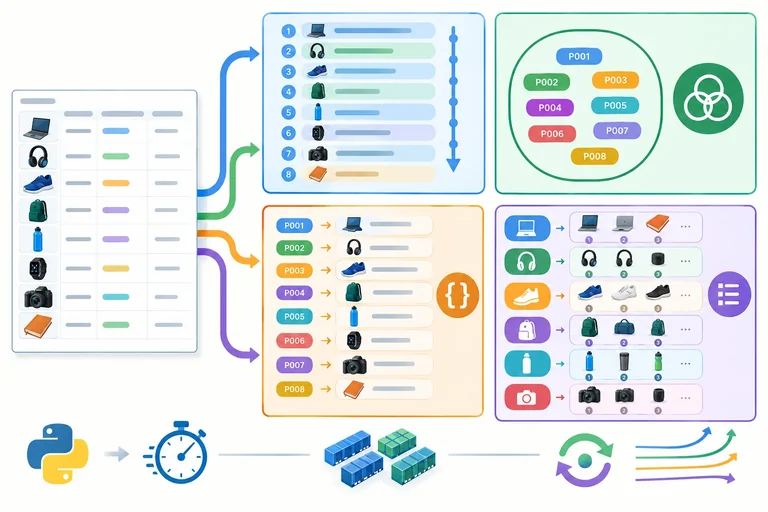
Passo 8 de 8
Finalize a otimização com evidências de equivalência, custo completo, memória adicional e coerência após mudanças na fonte.
A estrutura deve reproduzir o contrato da consulta antes de buscar velocidade:
set): responde apenas se uma chave existe.dict): recupera um registro por chave, quando a política para chaves repetidas está definida.A decisão final inclui o tempo de construção, as consultas durante a validade do índice, a memória auxiliar e o comportamento para duplicatas, ausências e ordem.
Compare o que cada estrutura consegue responder sem perder informação necessária.
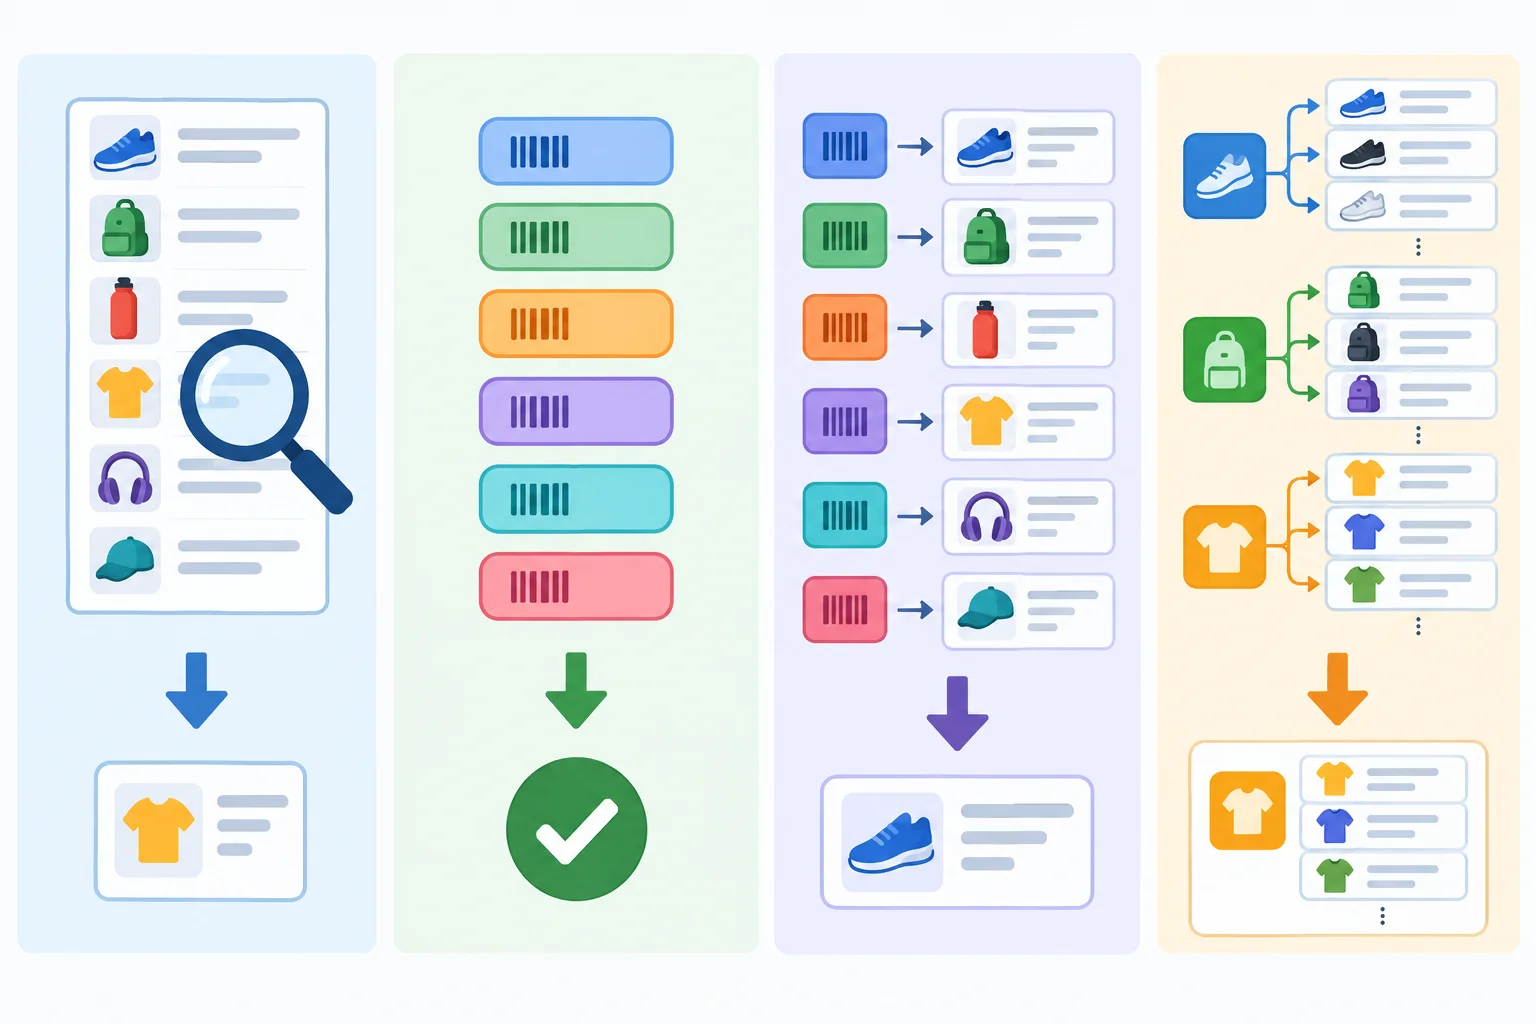
A pergunta define a estrutura: existência, um registro ou todos os registros de um grupo.
Dica
Adote o índice somente se ele preservar o resultado exigido e se a troca de memória por tempo for adequada à carga medida. Um resultado mais rápido que muda duplicatas, ausências ou ordem não é uma otimização correta.
No seu script local do step anterior, escolha uma configuração de carga que você mediu. Em seguida, altere a fonte e atualize ou reconstrua o índice antes de repetir a consulta. O exemplo abaixo usa reconstrução: uma opção simples e segura após um lote de alterações.
Adapte os nomes das chaves ao seu catálogo local.
from collections import defaultdict

# A fonte pode ter sido alterada por um lote de operações.
produtos.append({"codigo": "P-900", "categoria": "casa", "nome": "Luminária"})

# Reconstrua quando o lote terminar, antes das consultas atuais.
por_categoria = defaultdict(list)
for produto in produtos:
    por_categoria[produto["categoria"]].append(produto)

consultas = ["casa", "inexistente", "casa"]
resultado_indexado = [list(por_categoria.get(categoria, [])) for categoria in consultas]
resultado_varrido = [
    [produto for produto in produtos if produto["categoria"] == categoria]
    for categoria in consultas
]

assert resultado_indexado == resultado_varrido
print(resultado_indexado)
Atenção
Alterar a lista de origem não atualiza automaticamente o dicionário auxiliar. Se você optar por atualização incremental em vez de reconstrução, aplique a mesma política de duplicatas e de ordem usada na construção original.
Com base no experimento local, registre sua decisão: manter varredura ou usar qual índice? Inclua: (1) o contrato da consulta; (2) como verificou duplicatas, ausências, repetições e ordem; (3) quais tempos comparou, incluindo ou separando a construção; (4) a memória auxiliar estrutural; e (5) a política após mudanças na fonte.
Escreva pelo menos 220 caracteres (0/220).
Resumo
Use este checklist ao otimizar buscas repetidas.
Parabéns! Você concluiu: Reduzir buscas repetidas com índices em memória
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks