Passo 1 de 8
Mapear o que permanece vivo em cada fase
Identifique o pico de memória observando quais estruturas coexistem durante cada fase do processamento.
Trilha de aprendizado · Nível 14 · Tutorial 9
Use medições para reduzir a quantidade de dados mantida ao mesmo tempo, eliminando cópias dispensáveis e referências que prolongam a vida de estruturas auxiliares.
 Mapear o que permanece vivo em cada fase
Identifique o pico de memória observando quais estruturas coexistem durante cada fase do processamento. 2 min
 Remover cópias sem mudar o contrato
Elimine contêineres intermediários apenas quando a leitura, a mutação e o compartilhamento de referências permitirem. 3 min
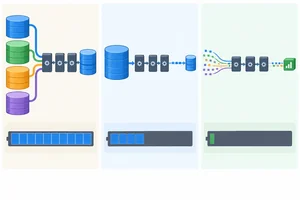 Reduzir a materialização no fluxo completo
Compare o pico de memória de três fluxos equivalentes: materialização completa, gerador sobre uma fonte ainda materializada e processamento incremental desde a origem. 3 min
 Dimensionar lotes e buffers pelo orçamento
Estime uma capacidade inicial de lote a partir de um orçamento de memória e valide-a com medições representativas. 3 min
 Distinguir pico temporário de retenção crescente
Compare a memória atual e o pico em ciclos equivalentes para reconhecer sobreposição temporária, estabilização e retenção que merece investigação. 3 min
 Encurtar a vida das estruturas auxiliares
Revise vínculos que mantêm lotes alcançáveis e conserve apenas o histórico exigido pelo contrato. 3 min
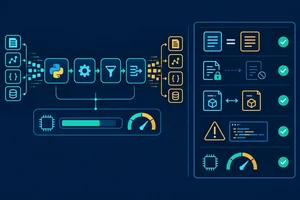 Confirmar o ganho sem quebrar o contrato
Teste os riscos específicos de uma otimização de memória antes de aceitar o ganho medido. 3 min
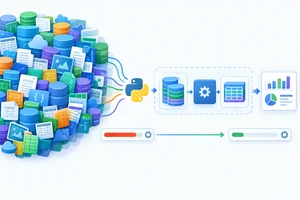 Aplicação final: reduzir e comprovar
Aplique uma versão inicial e uma versão ajustada do mesmo processamento, compare as medições e registre evidências de correção. 4 min
Passo 1 de 8
Identifique o pico de memória observando quais estruturas coexistem durante cada fase do processamento.
O pico acontece na fase em que a maior quantidade de dados ainda está viva ao mesmo tempo. Ele não é a soma de tudo o que foi alocado desde o início: estruturas temporárias que já deixaram de existir não contribuem para o mesmo instante do pico.
Ao analisar um fluxo, pergunte em cada fase: quais objetos e contêineres ainda podem ser alcançados? Some mentalmente a entrada, os contêineres auxiliares e a saída que coexistem naquele ponto.
A faixa mais carregada representa a fase que reúne entrada, coleção auxiliar e resumo antes que a auxiliar deixe de ser necessária.
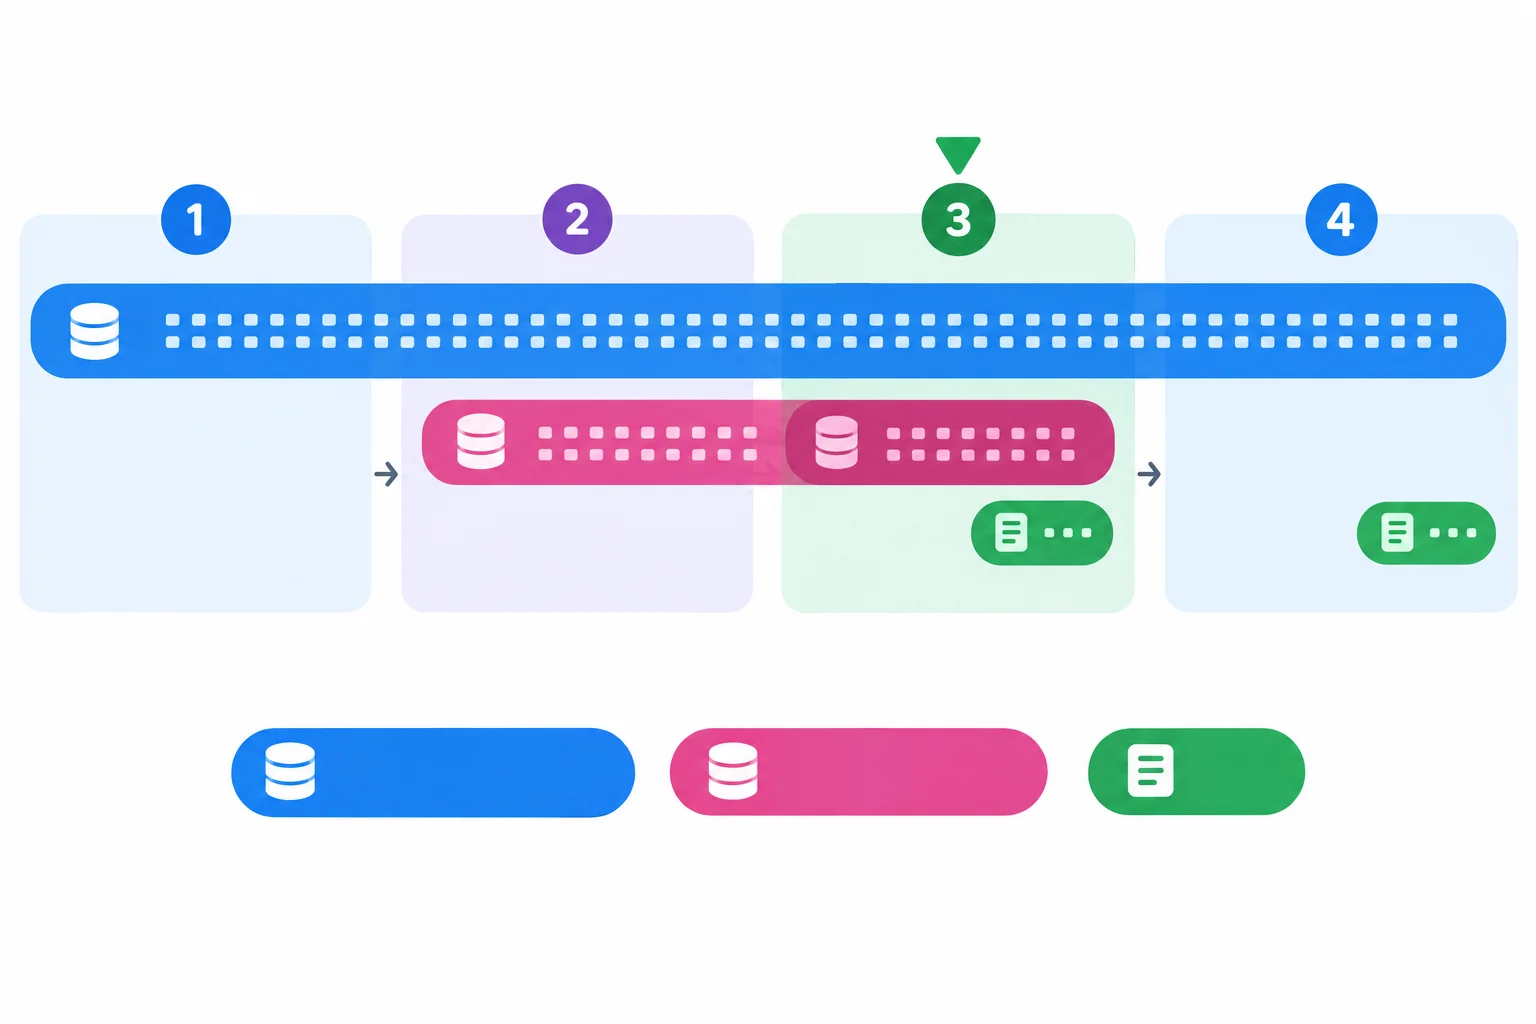
O pico vem da sobreposição temporal das estruturas, e não da quantidade total de alocações feitas.
Exemplo
Considere uma função que cria registros sintéticos, monta uma coleção auxiliar e por fim entrega apenas um resumo:
registros está viva.registros e normalizados estão vivos.registros, normalizados e resumo estão vivos.resumo precisa permanecer vivo para quem chamou a função.A fase 3 tende a ser o maior pico, mesmo que o resumo seja pequeno. A coleção auxiliar é memória de trabalho daquela fase; o resumo é memória exigida pelo resultado.
Dica
Se dois contêineres apontam para os mesmos registros, há dois contêineres e um único conjunto de objetos referenciados. Considere o custo dos dois contêineres, mas não trate os registros compartilhados como cópias completas.
No momento em que registros, normalizados e resumo coexistem, associe cada estrutura à descrição mais adequada.
Toque em um item e depois no par correspondente.
Desenhe as fases antes de alterar o código. Marque quando cada estrutura nasce, quando deixa de ser necessária e qual fase concentra mais sobreposição. Em seguida, use a medição com tracemalloc já conhecida para verificar se o pico ocorre perto dessa fase.
Nos próximos passos, você avaliará como reduzir estruturas que coexistem — sem assumir que toda estrutura auxiliar ou toda cópia pode desaparecer.
No exemplo, qual fase tende a produzir o maior pico? Cite as estruturas vivas e diferencie a que precisa permanecer após o retorno das que só participam do processamento.
Escreva pelo menos 80 caracteres (0/80).
Passo 2 de 8
Elimine contêineres intermediários apenas quando a leitura, a mutação e o compartilhamento de referências permitirem.
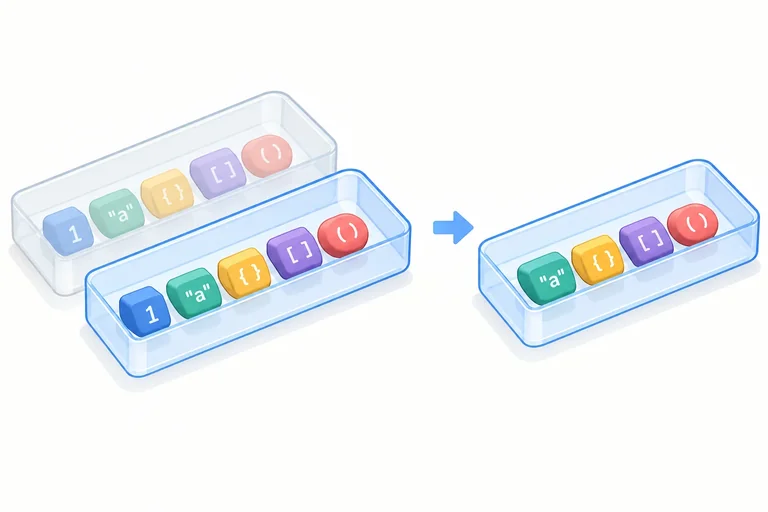
Uma fatia como registros[:] e list(registros) cria um novo contêiner e copia suas referências. Os elementos internos não são duplicados, mas há trabalho e memória adicionais proporcionais ao número de posições copiadas.
No pico, origem e cópia coexistem. Portanto, não conclua que a cópia é barata só porque os objetos internos são compartilhados.
A cópia possui outro conjunto de posições, mas aponta para os mesmos dicionários da origem.
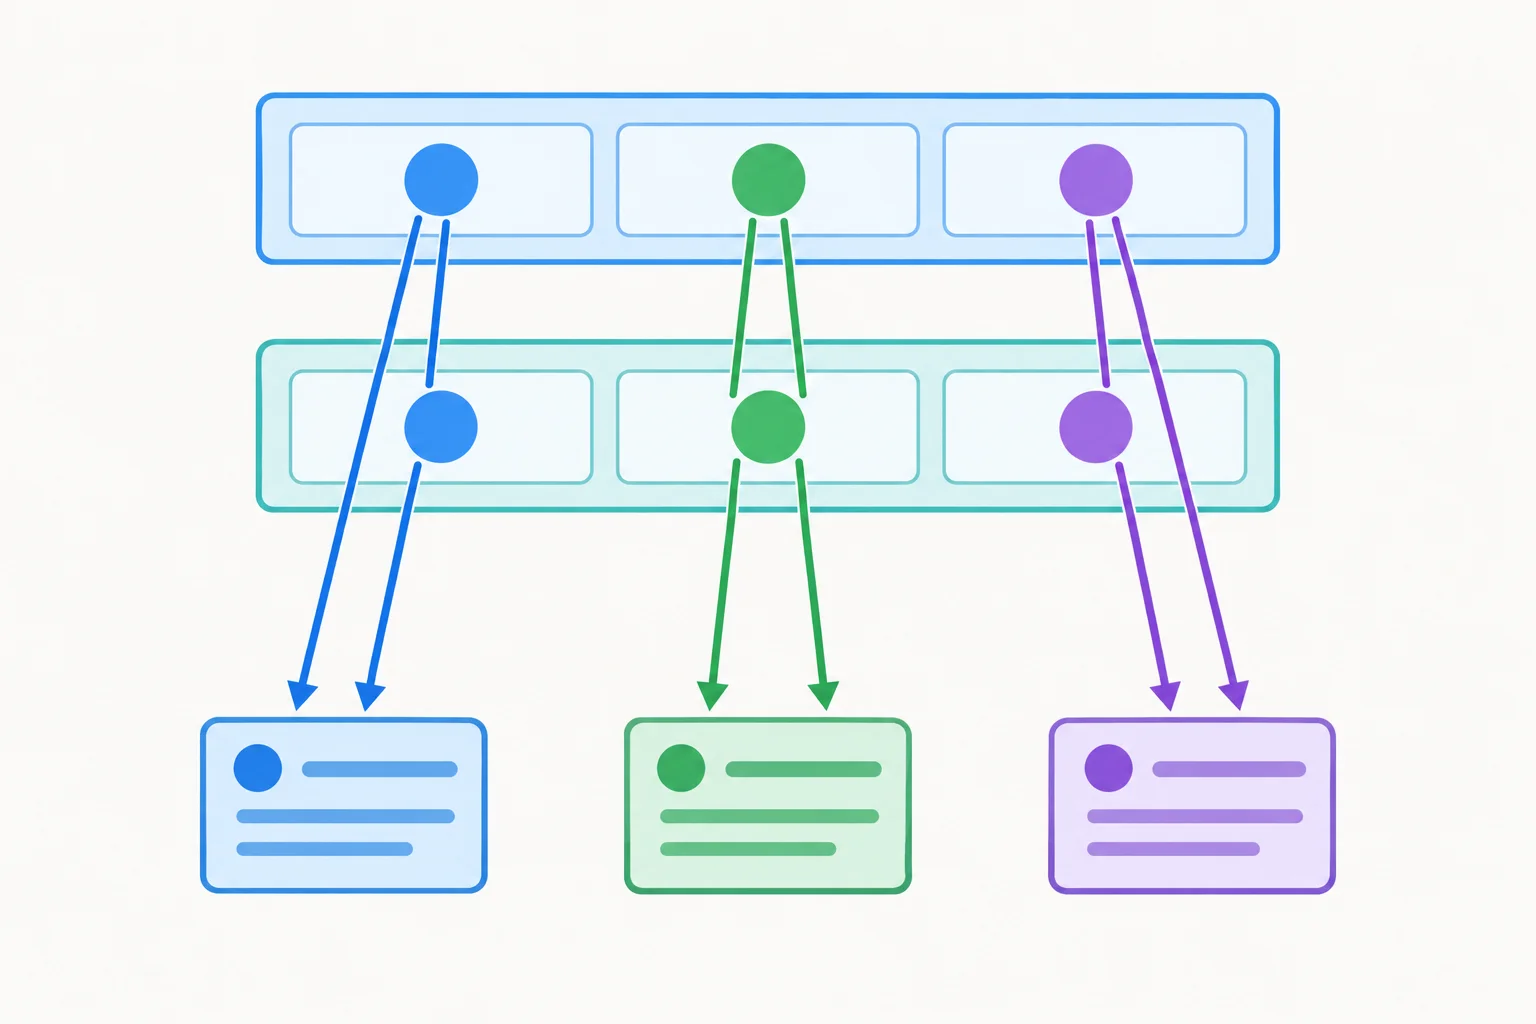
Dois contêineres, os mesmos elementos: a cópia rasa aumenta o pico sem clonar cada registro.
Dica
Para cada cópia, pergunte: ela protege a entrada contra mutação, cria resultados independentes ou apenas prepara uma etapa que só lê os dados? Só o último caso sugere uma cópia possivelmente redundante.
A função não altera registros nem a lista copiada.
def ids_ativos(registros: list[dict[str, object]]) -> list[int]:
    trabalho = registros[:]  # novo contêiner com as mesmas referências
return [registro["id"] for registro in trabalho if registro["ativo"]]O resultado continua sendo uma nova lista; apenas o contêiner intermediário foi removido.
def ids_ativos(registros: list[dict[str, object]]) -> list[int]:
    return [registro["id"] for registro in registros if registro["ativo"]]
Atenção
trabalho = registros não copia nada: os dois nomes apontam para a mesma lista. Se uma etapa fizer trabalho.sort(), pop() ou outra mutação, a entrada também será alterada. Nesse contrato, a cópia pode ser necessária; alternativamente, use uma operação que produza uma saída nova quando isso atender ao comportamento esperado.
A função deve preservar a lista nomes e retornar uma nova lista com os nomes normalizados. Qual implementação elimina uma cópia redundante sem quebrar esse contrato?
Passo 3 de 8
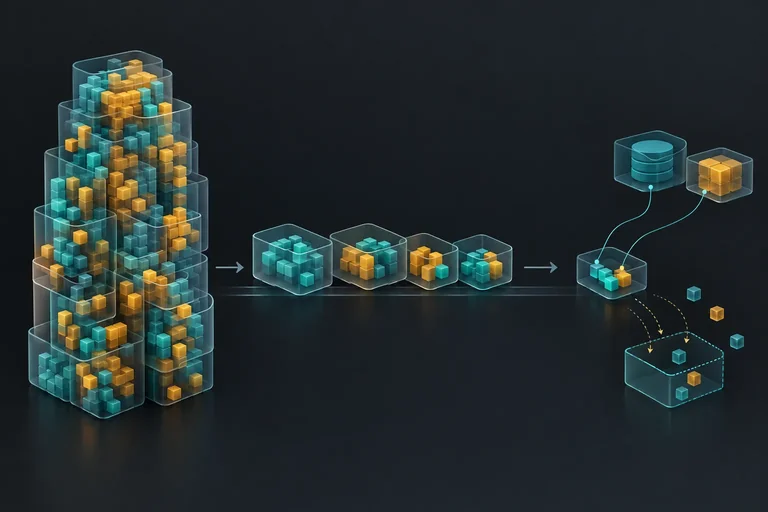
Compare o pico de memória de três fluxos equivalentes: materialização completa, gerador sobre uma fonte ainda materializada e processamento incremental desde a origem.
Um gerador pode remover listas intermediárias, mas isso não torna automaticamente o processamento incremental. Para entender o pico, observe fonte + transformações + consumidor no mesmo instante.
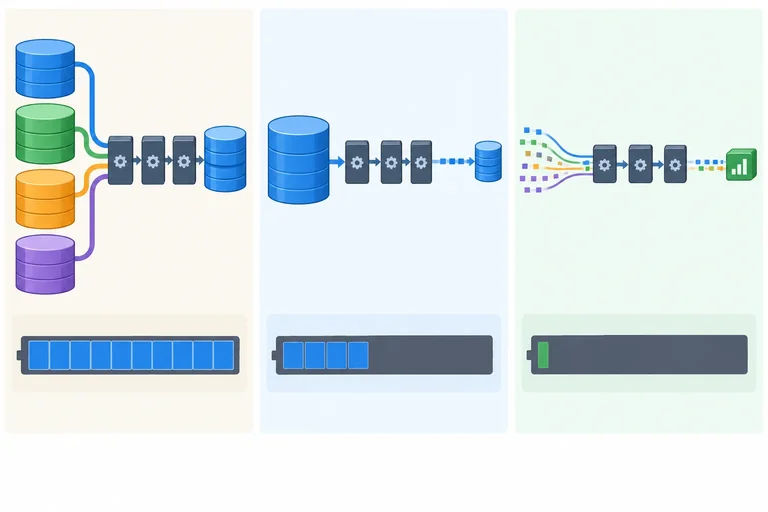
Considere três versões com o mesmo resumo final:
Também examine o consumidor: se ele fizer list(fluxo), criará uma nova coleção com todos os resultados e poderá recuperar grande parte do pico que o gerador evitou.
A largura dos blocos representa aproximadamente a quantidade de dados vivos em cada estratégia.
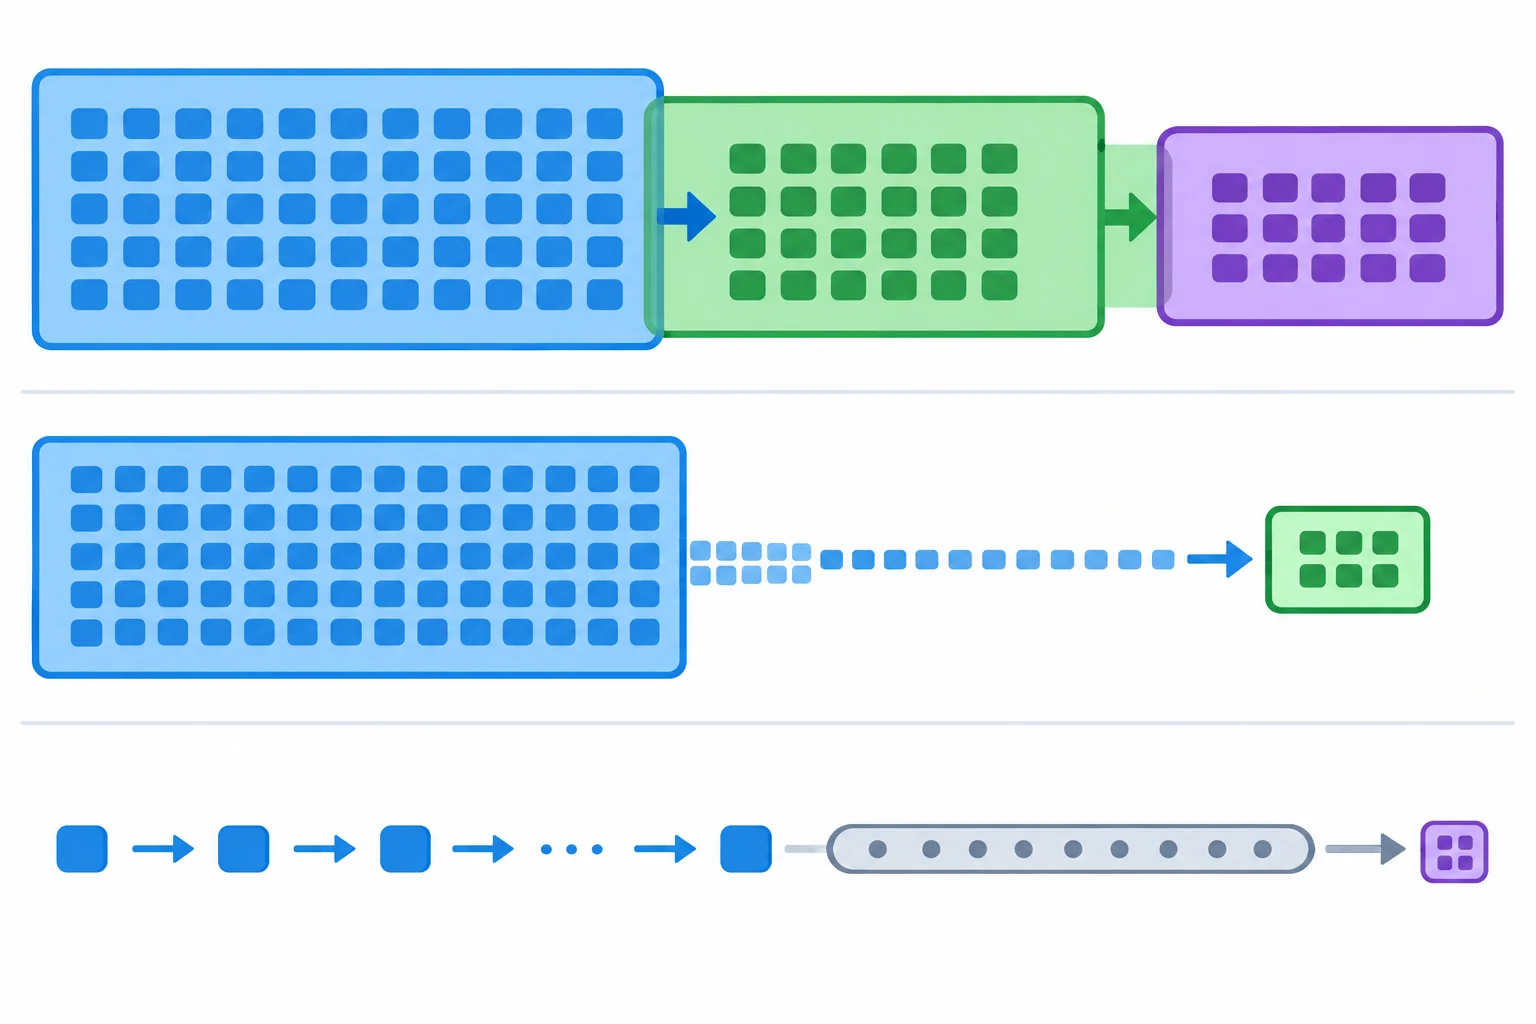
Eliminar intermediários ajuda, mas o maior ganho ocorre quando a fonte também é produzida sob demanda e a saída não é acumulada sem necessidade.
Dica
Só descarte resultados quando o contrato pedir um resumo, uma contagem ou outro resultado compacto. Se quem chama a função precisa receber todos os registros transformados, a coleção final é necessária — embora a fonte e os intermediários ainda possam ser revistos.
Crie um arquivo comparar_fluxos.py, copie o código completo abaixo e execute-o. Cada medição recria uma fonte equivalente, inicia o rastreamento antes da criação dessa fonte e consome todo o fluxo dentro da fronteira medida.
As três funções retornam o mesmo resumo, mas mantêm quantidades diferentes de dados vivas.
import tracemalloc

QUANTIDADE = 30_000


def criar_registro(indice: int) -> dict[str, object]:
    return {
        "id": indice,
        "ativo": indice % 3 == 0,
        "texto": f"registro-{indice:06d}-" + ("x" * 240),
    }


def criar_lista(quantidade: int):
    return [criar_registro(indice) for indice in range(quantidade)]


def gerar_registros(quantidade: int):
    for indice in range(quantidade):
        yield criar_registro(indice)


def normalizar(registro: dict[str, object]) -> dict[str, int]:
    return {
        "id": int(registro["id"]),
        "tamanho": len(str(registro["texto"])),
    }


def resumir(registros) -> dict[str, int]:
    quantidade = 0
    total_caracteres = 0
    for registro in registros:
        quantidade += 1
        total_caracteres += registro["tamanho"]
    return {
        "quantidade": quantidade,
        "total_caracteres": total_caracteres,
    }


# Fonte, seleção e saída transformada coexistem.
def versao_materializada(quantidade: int) -> dict[str, int]:
    entrada = criar_lista(quantidade)
    selecionados = [registro for registro in entrada if registro["ativo"]]
    normalizados = [normalizar(registro) for registro in selecionados]
    return resumir(normalizados)


# Não há listas intermediárias, mas entrada permanece viva.
def versao_gerador_sobre_lista(quantidade: int) -> dict[str, int]:
    entrada = criar_lista(quantidade)
    normalizados = (
        normalizar(registro)
        for registro in entrada
        if registro["ativo"]
    )
    return resumir(normalizados)


# A própria fonte é incremental; só o resumo é retido.
def versao_totalmente_incremental(quantidade: int) -> dict[str, int]:
    normalizados = (
        normalizar(registro)
        for registro in gerar_registros(quantidade)
        if registro["ativo"]
    )
    return resumir(normalizados)


def medir(nome: str, funcao, quantidade: int) -> dict[str, int]:
    tracemalloc.start()
    try:
        # O rastreamento já está ativo; a fonte será criada dentro da função.
        tracemalloc.reset_peak()
        resultado = funcao(quantidade)
        atual, pico = tracemalloc.get_traced_memory()
    finally:
        tracemalloc.stop()

    print(f"{nome:28} atual={atual / 1024 / 1024:6.2f} MiB  "
          f"pico={pico / 1024 / 1024:6.2f} MiB  resumo={resultado}")
    return resultado


resultados = [
    medir("materializada", versao_materializada, QUANTIDADE),
    medir("gerador sobre lista", versao_gerador_sobre_lista, QUANTIDADE),
    medir("totalmente incremental", versao_totalmente_incremental, QUANTIDADE),
]

assert resultados[0] == resultados[1] == resultados[2]
print("Resumos equivalentes.")
Atenção
Não passe uma lista pronta para apenas uma das versões nem crie a lista antes de iniciar o tracemalloc. Isso excluiria justamente o custo da entrada. Cada versão deve recriar dados equivalentes dentro da própria medição.
Após executar o script, relate: qual versão teve o maior e o menor pico? Explique por que a versão com gerador sobre lista não elimina o custo da entrada. Depois diga o que mudaria se resumir(normalizados) fosse trocado por list(normalizados).
Escreva pelo menos 180 caracteres (0/180).
Passo 4 de 8
Estime uma capacidade inicial de lote a partir de um orçamento de memória e valide-a com medições representativas.
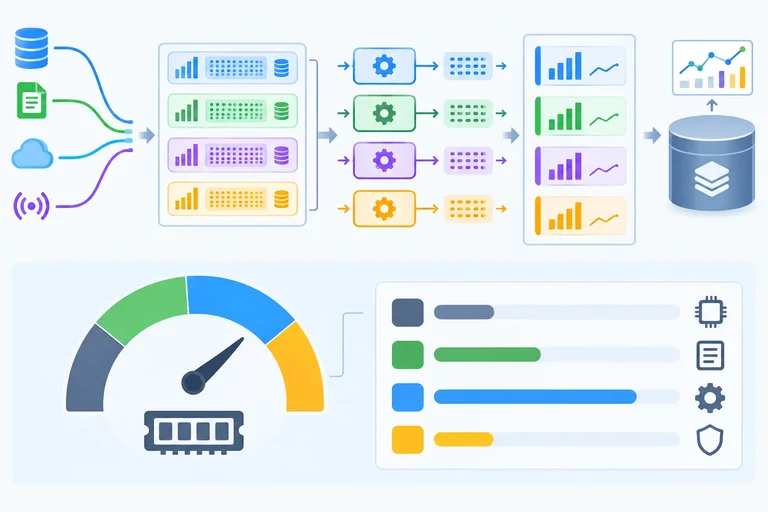
O tamanho do lote não pode ocupar todo o orçamento. Separe a memória rastreada disponível em quatro partes:
Uma capacidade inicial pode ser estimada por:
capacidade = floor((orçamento - fixa - retida - margem) / custo_efetivo_por_registro)
O custo efetivo deve representar o pico por registro no fluxo real, não somente o tamanho superficial do objeto de entrada.
Observe que o lote ativo inclui estruturas simultâneas da transformação.
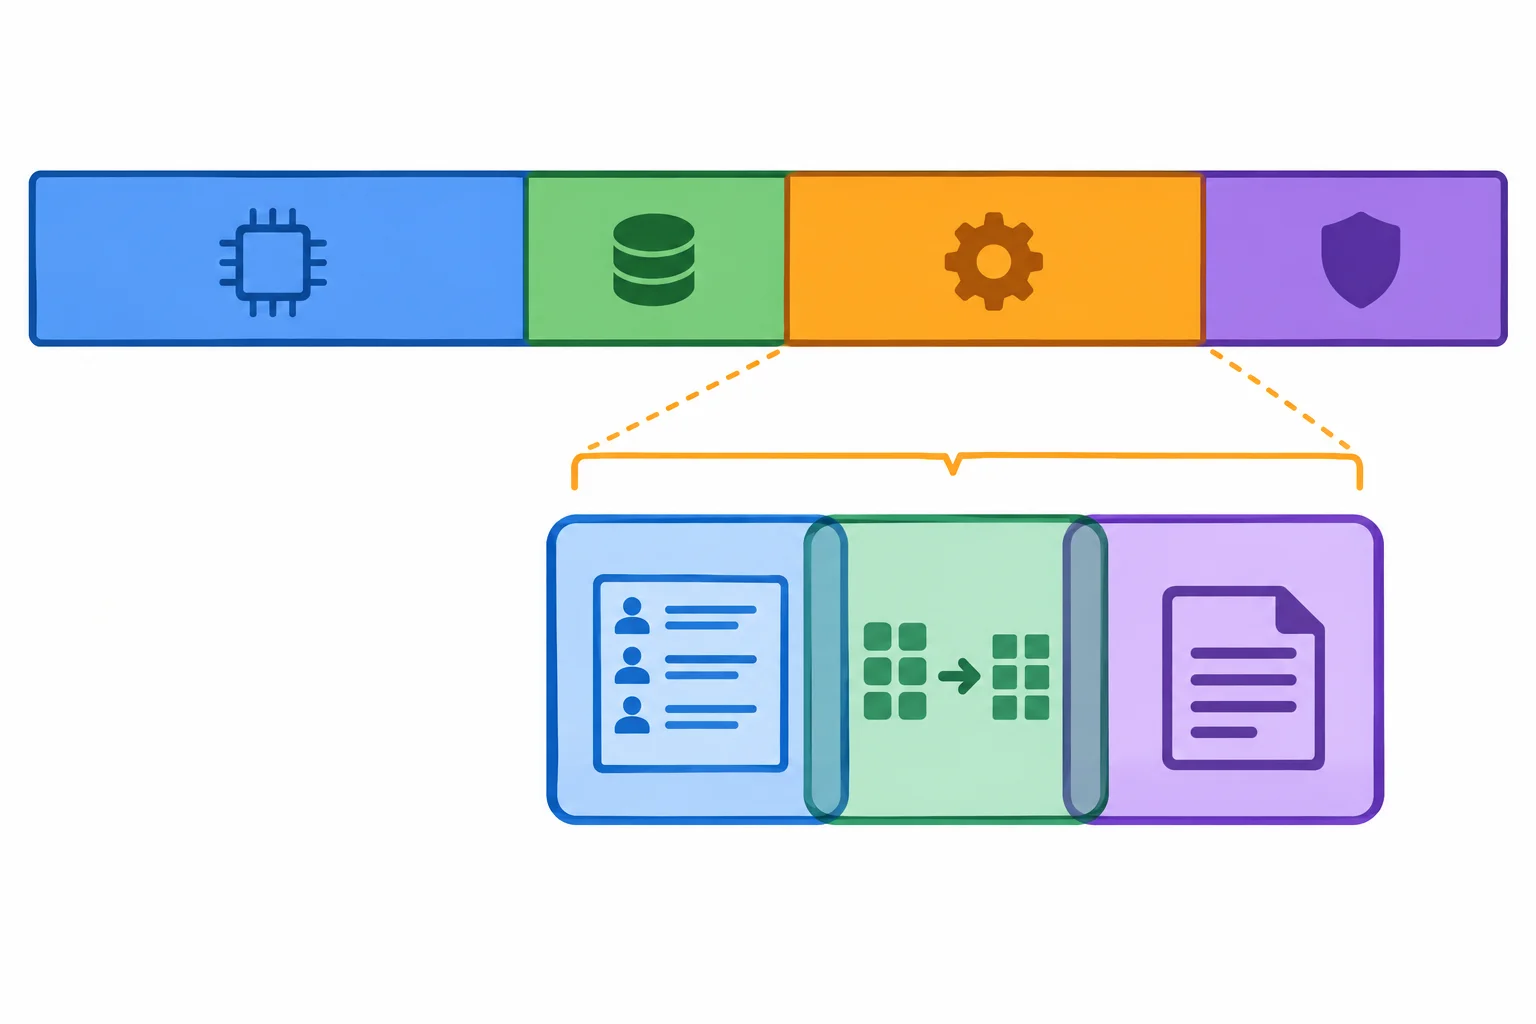
O espaço destinado ao lote é o que sobra depois das parcelas fixas, retidas e da margem.
Exemplo
Considere um orçamento rastreado de 12 MiB, com 2 MiB de memória fixa, 1 MiB de resultados retidos e 1 MiB de margem. Restam 8 MiB para o lote.
Se uma medição representativa indicar 4 KiB por registro no pico do lote, a capacidade inicial é:
8 MiB / 4 KiB = 2048 registros
Esse valor é uma hipótese para testar, não uma garantia para qualquer distribuição de registros.
Meça um lote que crie as mesmas estruturas que coexistem na transformação real. Registros com campos maiores, saídas expandidas ou coleções auxiliares podem elevar o custo por registro. Compare um lote vazio com um lote representativo para reduzir o efeito da parcela fixa observada.
Execute localmente e ajuste amostra e a forma de transformar para se aproximarem da sua carga.
import tracemalloc

MIB = 1024 * 1024


def criar_registros(quantidade: int) -> list[dict[str, object]]:
    return [
        {
            "id": indice,
            "categoria": f"grupo-{indice % 20}",
            "payload": "x" * (300 + (indice % 5) * 200),
        }
        for indice in range(quantidade)
    ]


def transformar(registros: list[dict[str, object]]) -> int:
    # A lista transformada é uma estrutura temporária que coexiste com a entrada.
    saida = [
        f"{registro['id']}|{registro['categoria']}|{registro['payload']}"
        for registro in registros
    ]
    return sum(len(item) for item in saida)  # resumo compacto


def pico_do_lote(quantidade: int) -> int:
    tracemalloc.start()
    registros = criar_registros(quantidade)
    transformar(registros)
    _, pico = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    return pico


amostra = 1_000
pico_vazio = pico_do_lote(0)
pico_amostra = pico_do_lote(amostra)
custo_por_registro = (pico_amostra - pico_vazio) / amostra

print(f"Pico vazio: {pico_vazio / MIB:.2f} MiB")
print(f"Pico da amostra: {pico_amostra / MIB:.2f} MiB")
print(f"Custo efetivo estimado: {custo_por_registro:.0f} bytes/registro")
Dica
O tamanho superficial de um registro não inclui automaticamente os objetos alcançados por ele, a capacidade dos contêineres nem a saída temporária. Use a medição do fluxo representativo para obter uma estimativa operacional.
Com orçamento de 12 MiB, memória fixa de 2 MiB, resultados retidos de 1 MiB, margem de 1 MiB e custo efetivo de 4 KiB por registro, a capacidade inicial é de ____ registros.
Teste a capacidade calculada e valores próximos com fontes equivalentes recriadas a cada execução. Cada lote deve ser consumido antes de pedir o próximo; neste exemplo, o contrato permite reter somente um total numérico. Se seu contrato exigir guardar resultados individuais, inclua essa retenção no orçamento.
O pico rastreado é um indicador para esta carga e este interpretador; ele não é um limite rígido da memória residente do processo.
import tracemalloc
from itertools import islice

MIB = 1024 * 1024
ORCAMENTO = 12 * MIB


def registros_sinteticos(quantidade: int):
    for indice in range(quantidade):
        yield {
            "id": indice,
            "categoria": f"grupo-{indice % 20}",
            "payload": "x" * (300 + (indice % 5) * 200),
        }


def em_lotes(fonte, capacidade: int):
    while lote := list(islice(fonte, capacidade)):
        yield lote


def resumir_lote(lote: list[dict[str, object]]) -> int:
    # Esta saída temporária pode ser maior que a entrada do lote.
    codificados = [
        f"{registro['id']}|{registro['categoria']}|{registro['payload']}"
        for registro in lote
    ]
    return sum(len(item) for item in codificados)


def medir(capacidade: int, quantidade_total: int = 10_000) -> tuple[int, int]:
    tracemalloc.start()
    total = 0

    for lote in em_lotes(registros_sinteticos(quantidade_total), capacidade):
        total += resumir_lote(lote)  # consome o resumo antes do próximo lote
        del lote

    atual, pico = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    return total, pico


for capacidade in (1536, 2048, 2560):
    total, pico = medir(capacidade)
    situacao = "dentro" if pico <= ORCAMENTO else "acima"
    print(
        f"lote={capacidade:4d} | total={total} | "
        f"pico={pico / MIB:.2f} MiB | {situacao} do orçamento"
)Execute o código com sua carga sintética ou adapte-o a uma carga local representativa. Qual capacidade respeitou o orçamento rastreado? Relate os picos medidos e diga se registros ou resultados de tamanhos variados exigiriam uma margem maior.
Escreva pelo menos 80 caracteres (0/80).
Passo 5 de 8
Compare a memória atual e o pico em ciclos equivalentes para reconhecer sobreposição temporária, estabilização e retenção que merece investigação.
Em ciclos de trabalho equivalentes, observe dois valores: a memória atual depois que a saída esperada foi consumida e o pico atingido durante aquele ciclo.
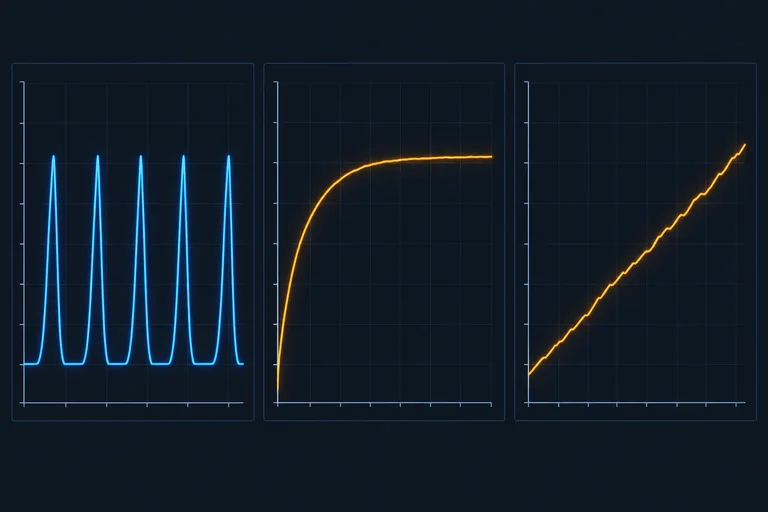
Um pico alto que volta a um patamar semelhante pode indicar apenas estruturas que coexistiram temporariamente. Já a memória atual que aumenta em pontos equivalentes de vários ciclos é um sinal para investigar o que continua sendo mantido.
Compare sempre o mesmo ponto do ciclo: depois de processar e consumir a saída prevista pelo contrato.
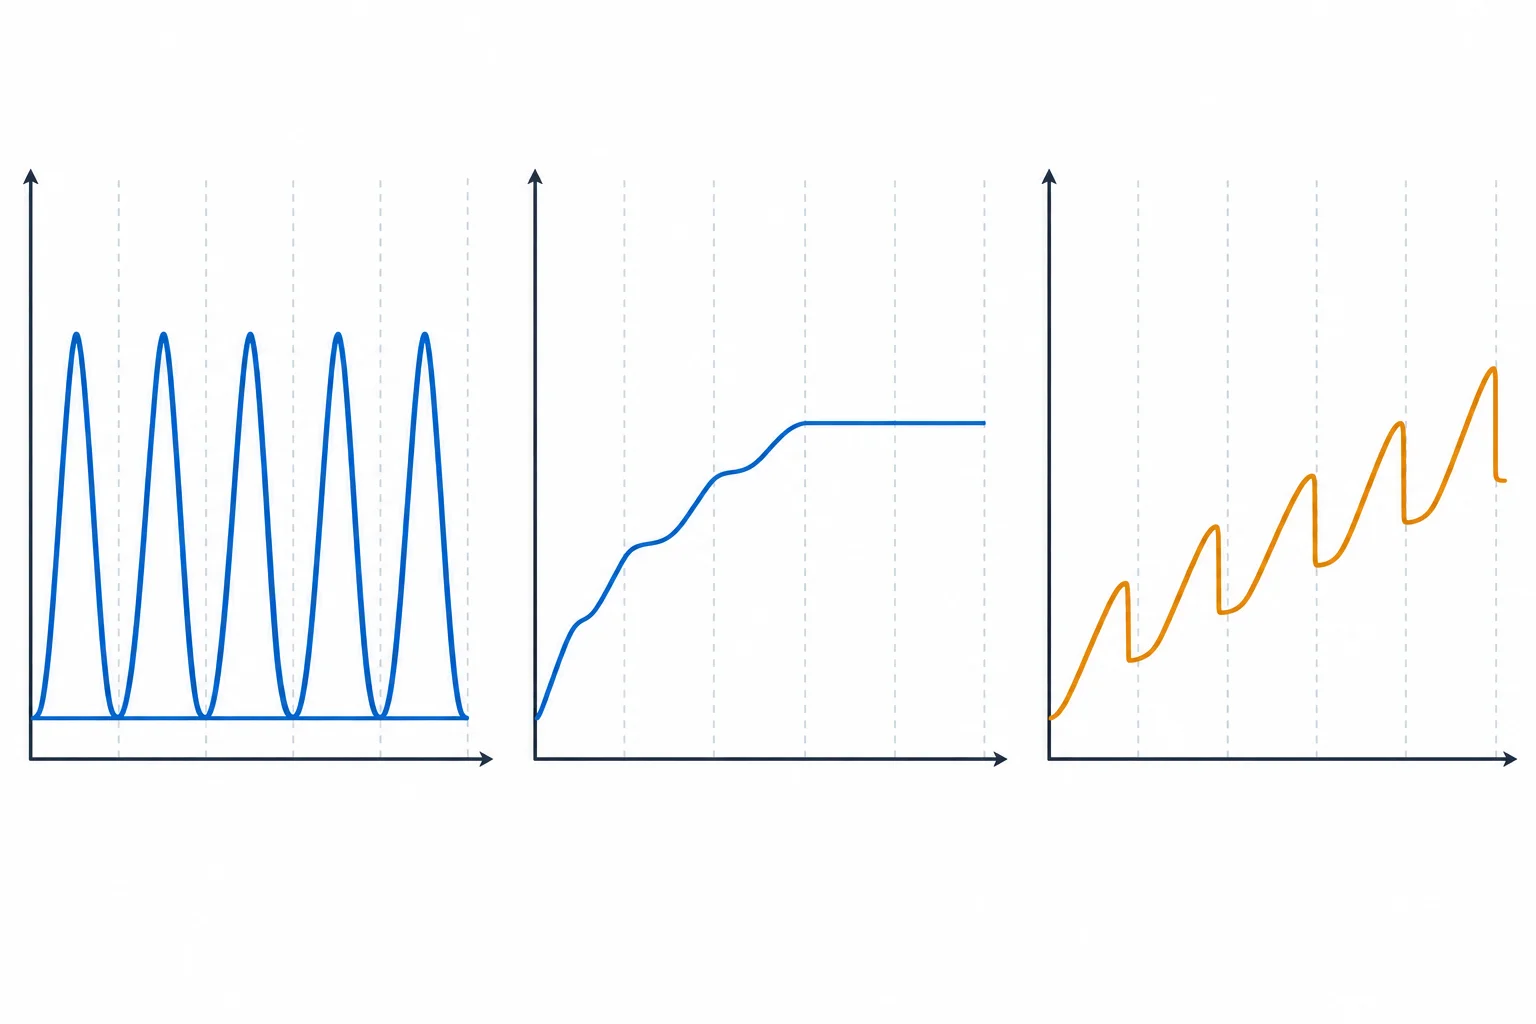
Picos temporários, aquecimento que estabiliza e crescimento persistente têm leituras diferentes.
Atenção
Crescimento entre ciclos não prova sozinho um vazamento. Pode haver inicialização tardia, estruturas reutilizadas ou retenção deliberada pelo contrato. O padrão indica onde procurar: coleções e atributos persistentes que podem estar acumulando dados de ciclos anteriores.
Faça um ciclo de aquecimento com a mesma carga antes de registrar a série. Depois, execute ciclos equivalentes e registre somente números compactos. A saída deve ser totalmente consumida dentro de cada ciclo; caso contrário, você estará comparando fronteiras diferentes.
Execute este exemplo no seu computador. Ele cria uma carga equivalente em cada ciclo, consome o resultado como uma soma e guarda apenas tuplas numéricas de métricas.
import tracemalloc


def processar(quantidade: int):
    registros = [
        {"id": i, "valor": i % 97, "texto": f"registro-{i}"}
        for i in range(quantidade)
    ]
    return (registro["valor"] * 2 for registro in registros)


def executar_ciclo(quantidade: int) -> int:
    # sum consome toda a saída; nenhum lote é devolvido ao chamador.
    return sum(processar(quantidade))


quantidade = 30_000
ciclos_medidos = 6
medidas = []  # apenas (ciclo, atual, pico), não os registros

tracemalloc.start()

# Aquecimento: mesmo trabalho, mas fora da série comparada.
executar_ciclo(quantidade)
tracemalloc.reset_peak()

for ciclo in range(1, ciclos_medidos + 1):
    resultado = executar_ciclo(quantidade)
    atual, pico = tracemalloc.get_traced_memory()
    medidas.append((ciclo, atual, pico))
    print(f"ciclo={ciclo} resultado={resultado} atual={atual:,} pico={pico:,}")
    tracemalloc.reset_peak()

tracemalloc.stop()Relacione cada padrão de memória atual após o consumo da saída à interpretação mais adequada.
Toque em um item e depois no par correspondente.
Dica
Não adicione os lotes, saídas completas ou objetos de diagnóstico à lista de medições. Guarde contadores, tamanhos e valores de memória; do contrário, a instrumentação pode criar exatamente a retenção que você quer detectar.
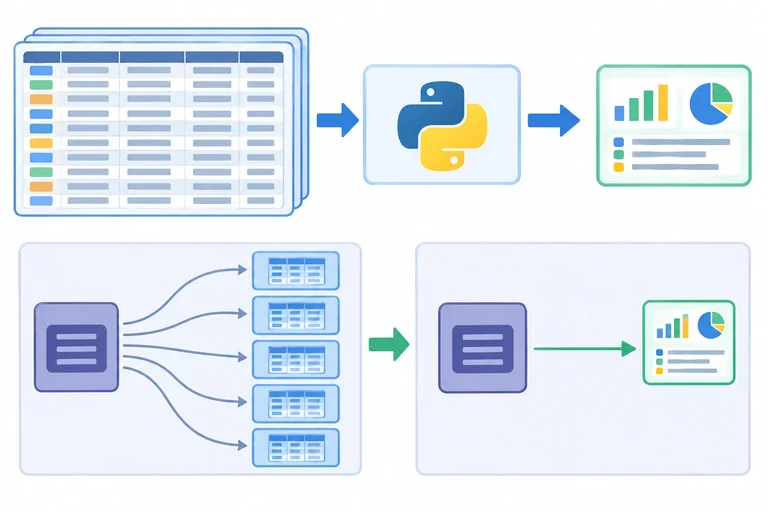
Passo 6 de 8
Revise vínculos que mantêm lotes alcançáveis e conserve apenas o histórico exigido pelo contrato.
Depois de processar um lote, examine quem ainda aponta para ele: um nome local, uma lista persistente, um atributo de objeto ou outra estrutura auxiliar. Um nome local pode desaparecer no fim da função, mas um atributo como self.ultimo_lote mantém o lote alcançável enquanto o processador existir.
A pergunta prática é: o histórico precisa do lote inteiro ou apenas de um resumo? Se quantidade, total e identificador bastam, guardar todos os registros é retenção desnecessária.
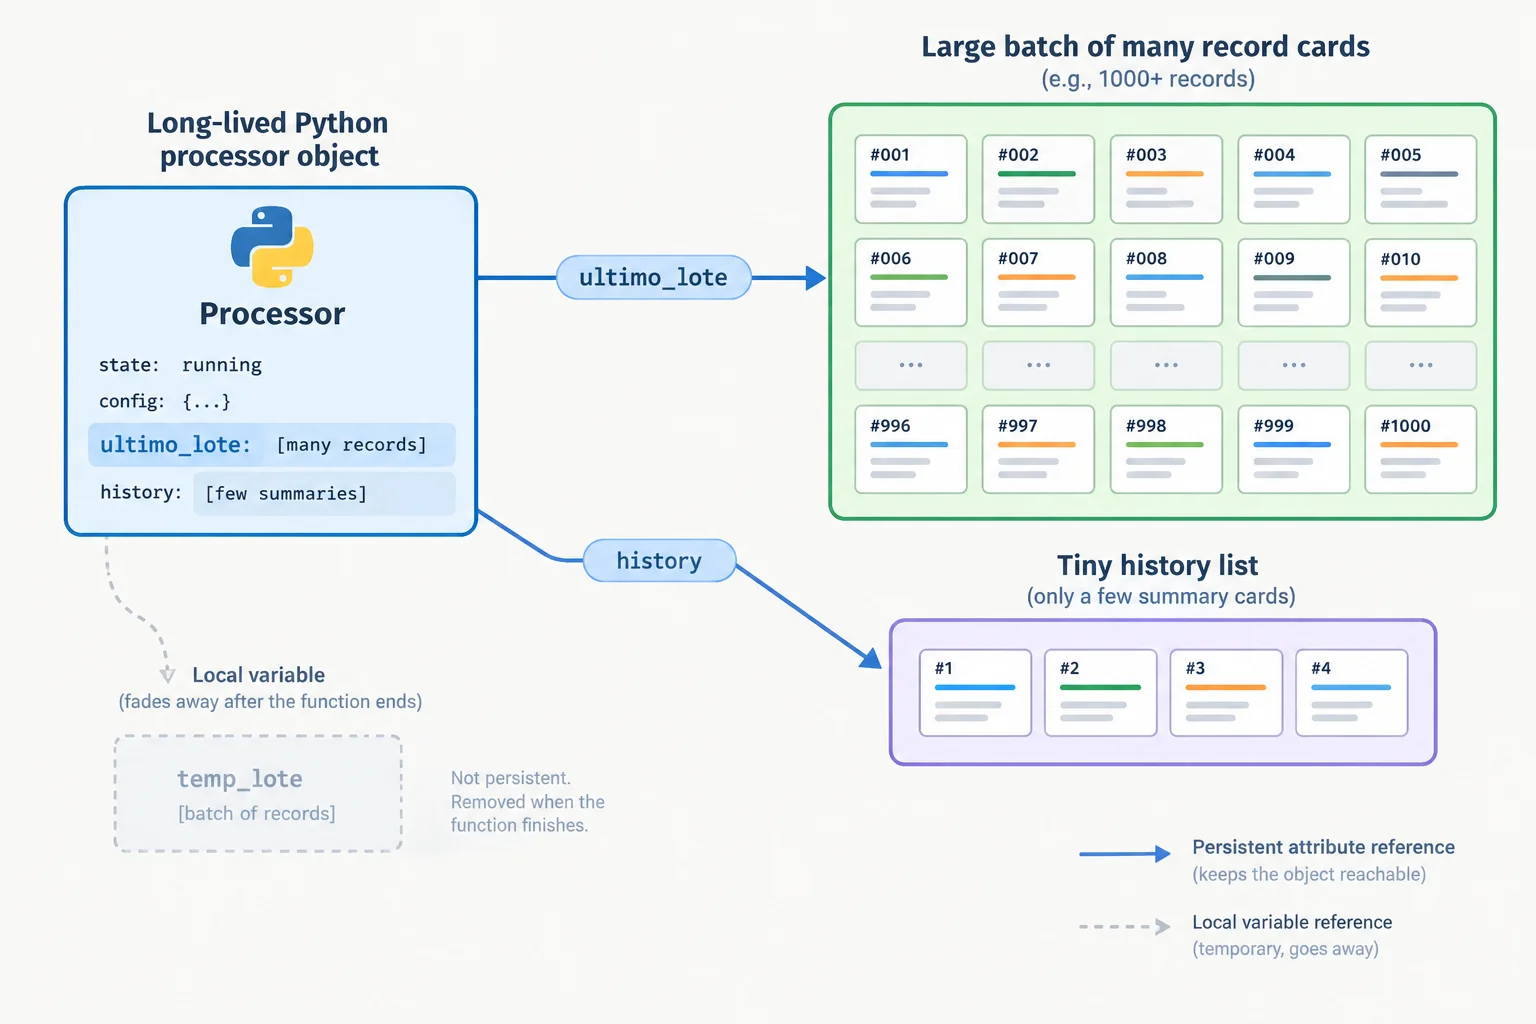
Mesmo após o fim da função, o atributo do processador ainda alcança o lote completo.
Atenção
del lote remove apenas o nome local. Se self.ultimo_lote, uma lista ou outro atributo ainda referenciar o mesmo objeto, ele continua alcançável. Quando não restam vínculos, Python pode recuperar o objeto, mas não há um momento exato garantido em toda implementação. Além disso, no CPython a memória pode ficar disponível para reutilização interna sem que a memória residente informada pelo sistema operacional caia imediatamente.
A versão inicial mantém o lote inteiro em um atributo de longa duração, embora o histórico só precise de métricas. A versão ajustada limita o que persiste ao resumo previsto pelo contrato. O lote permanece apenas no escopo da chamada enquanto é processado.
class Processador:
    def __init__(self) -> None:
        self.historico: list[dict[str, int]] = []
        self.ultimo_lote: list[dict[str, int]] | None = None

    def processar_antes(self, lote: list[dict[str, int]]) -> dict[str, int]:
        self.ultimo_lote = lote  # mantém todos os registros após o retorno
        resumo = {
            "quantidade": len(lote),
            "total": sum(registro["valor"] for registro in lote),
        }
        self.historico.append(resumo)
        return resumo


class ProcessadorAjustado:
    def __init__(self) -> None:
        self.historico: list[dict[str, int]] = []

    def processar(self, lote: list[dict[str, int]]) -> dict[str, int]:
        resumo = {
            "quantidade": len(lote),
            "total": sum(registro["valor"] for registro in lote),
        }
        self.historico.append(resumo)  # persiste somente o contrato de histórico
return resumoApós del lote, qual diagrama mostra por que o lote completo continua vivo e qual alteração é apropriada quando o histórico exige apenas resumos compactos?
Passo 7 de 8
Teste os riscos específicos de uma otimização de memória antes de aceitar o ganho medido.
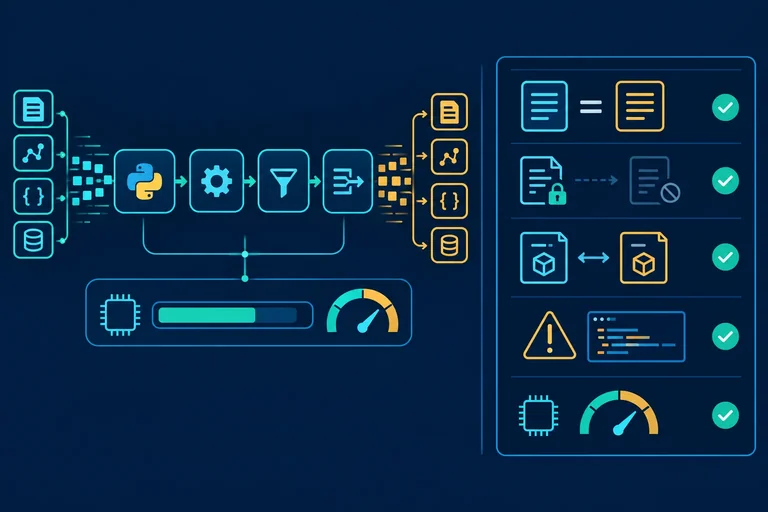
Depois de reduzir cópias, materializar menos dados ou limitar lotes, não compare apenas o número do pico. Verifique: resultado equivalente, entrada sem mutação quando essa é a regra, saídas mutáveis independentes, casos-limite e a propagação de erros.
Em fluxos sob demanda, uma falha de um registro pode aparecer somente quando aquele ponto do fluxo é consumido. Isso é aceitável se esse já for o comportamento previsto pelo contrato.
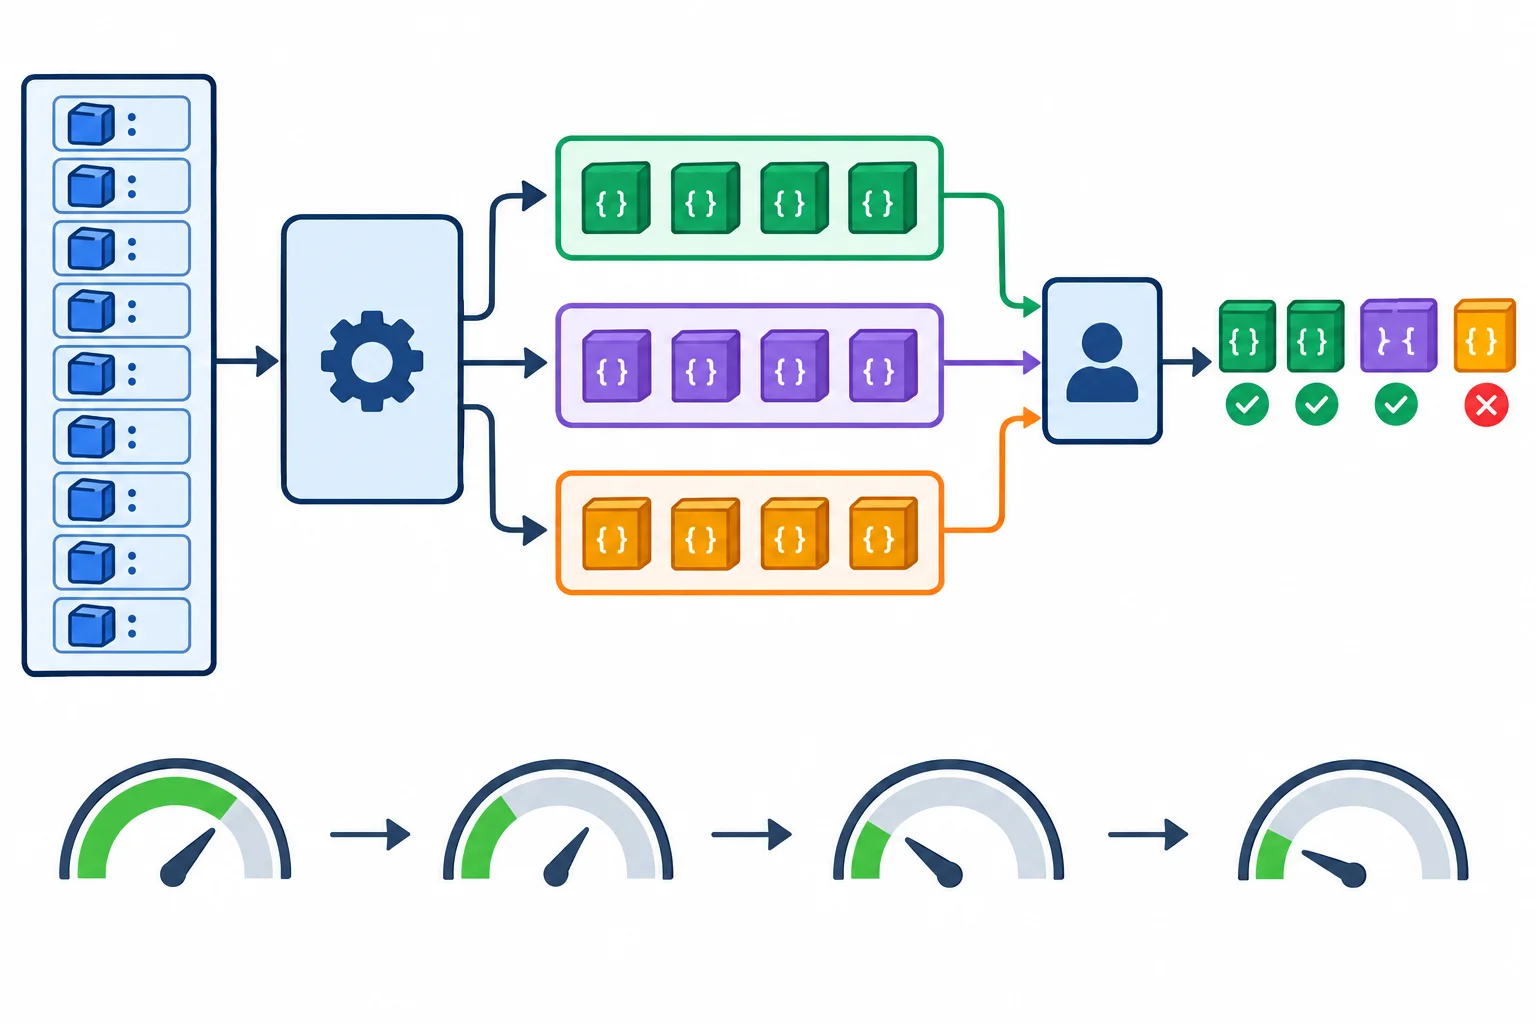
Uma validação completa cobre valores, estado compartilhado e comportamento durante o consumo.
Dica
Testes de correção podem guardar uma saída de referência; a medição de memória não deve. Meça cada versão em uma execução própria, consumindo a saída e retendo apenas uma métrica compacta, como contagem e soma.
Salve esta função em um módulo, por exemplo, processamento.py.
def resumir_em_lotes(registros, tamanho_lote):
    """Produz lotes de resumos sem alterar os registros de origem."""
    if tamanho_lote <= 0:
        raise ValueError("tamanho_lote deve ser positivo")

    lote = []
    for registro in registros:
        # KeyError é preservado se um registro não tiver "valor".
        resumo = {
            "id": registro["id"],
            "dobro": registro["valor"] * 2,
        }
        lote.append(resumo)

        if len(lote) == tamanho_lote:
            yield lote
            lote = []

    if lote:
yield loteCrie um arquivo teste_processamento.py ao lado do módulo e execute pytest -q. Estes testes exercitam inclusive lote vazio, último lote incompleto, registro grande e dado inválido.
import pytest
from processamento import resumir_em_lotes


def consumir(registros, tamanho_lote):
    return [item for lote in resumir_em_lotes(registros, tamanho_lote)
            for item in lote]


def test_resultado_e_entrada_preservada():
    origem = [{"id": 1, "valor": 3}, {"id": 2, "valor": 5}]
    antes = [registro.copy() for registro in origem]

    assert consumir(origem, 2) == [
        {"id": 1, "dobro": 6},
        {"id": 2, "dobro": 10},
    ]
    assert origem == antes


def test_saidas_mutaveis_nao_compartilham_estado():
    saida = consumir([{"id": 1, "valor": 7}, {"id": 2, "valor": 9}], 1)

    saida[0]["dobro"] = 999
    assert saida[1]["dobro"] == 18
    assert saida[0] is not saida[1]


def test_vazio_e_lote_incompleto():
    assert list(resumir_em_lotes([], 3)) == []
    assert list(resumir_em_lotes([{"id": 1, "valor": 4}], 3)) == [
        [{"id": 1, "dobro": 8}]
    ]


def test_registro_grande_e_dado_invalido():
    grande = {"id": 1, "valor": 10**1000}
    assert consumir([grande], 1)[0]["dobro"] == 2 * 10**1000

    fluxo = resumir_em_lotes([{"id": 1, "valor": 2}, {"id": 2}], 1)
    assert next(fluxo) == [{"id": 1, "dobro": 4}]
    with pytest.raises(KeyError):
        next(fluxo)


def test_tamanho_invalido():
    with pytest.raises(ValueError):
list(resumir_em_lotes([], 0))Exemplo
Este padrão é perigoso:
resumo = {}
for registro in registros:
    resumo["id"] = registro["id"]
    resumo["dobro"] = registro["valor"] * 2
    lote.append(resumo)
Ao final, cada posição de lote aponta para o mesmo dicionário. Os valores podem parecer corretos em uma inspeção rápida — todos refletem o último registro —, mas alterar um resultado altera todos. Criar um novo dicionário a cada iteração, como na implementação anterior, preserva a independência.
Se dois resultados mutáveis têm o mesmo conteúdo, um teste de igualdade (resultado_a == resultado_b) é suficiente para garantir que eles não compartilham estado.
Execute este código após importar a função. Ele recria a fonte para cada execução, consome tudo e retém somente contagem e soma. Para comparar uma versão anterior e a ajustada, passe cada função separadamente para medir_memoria e medir_tempo.
import timeit
import tracemalloc
from processamento import resumir_em_lotes


def fonte(quantidade=20_000):
    for indice in range(quantidade):
        yield {"id": indice, "valor": indice}


def consumir_compacto(funcao):
    quantidade = 0
    total = 0
    for lote in funcao(fonte(), 200):
        for resumo in lote:
            quantidade += 1
            total += resumo["dobro"]
    return quantidade, total


def medir_memoria(funcao):
    tracemalloc.start()
    tracemalloc.reset_peak()
    resultado = consumir_compacto(funcao)
    atual, pico = tracemalloc.get_traced_memory()
    tracemalloc.stop()
    return resultado, atual, pico


def medir_tempo(funcao):
    # Sem tracemalloc: a instrumentação alteraria a comparação de tempo.
    temporizador = timeit.Timer(lambda: consumir_compacto(funcao))
    return min(temporizador.repeat(repeat=5, number=3)) / 3

resultado, atual, pico = medir_memoria(resumir_em_lotes)
tempo = medir_tempo(resumir_em_lotes)
print(f"resultado={resultado}, atual={atual}, pico={pico}, tempo={tempo:.6f}s")Execute os testes e as medições para a versão anterior e a ajustada. Qual contrato você confirmou, qual foi o efeito no pico e o que ocorreu com o tempo?
Escreva pelo menos 80 caracteres (0/80).
Passo 8 de 8
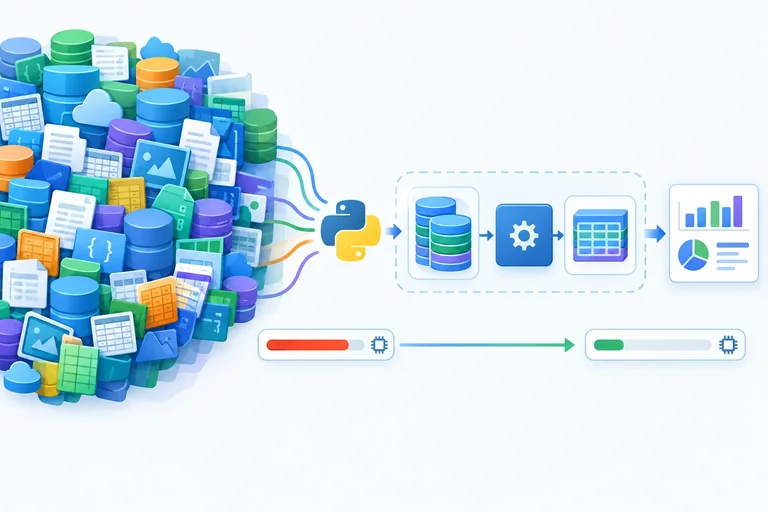
Aplique uma versão inicial e uma versão ajustada do mesmo processamento, compare as medições e registre evidências de correção.
Nesta aplicação, a versão inicial cria uma lista completa de registros e também todas as fatias de lote. Durante o processamento, a fonte, as fatias e os resultados temporários podem coexistir: essa sobreposição eleva o pico.
Além disso, o atributo last_batch mantém o último lote processado depois que o ciclo termina. Isso é retenção: a memória atual após o ciclo pode permanecer acima do necessário, mesmo que o pico temporário já tenha passado.
A versão ajustada produz registros sob demanda, mantém apenas um lote de tamanho limitado e retorna somente um resumo compacto. Ela também não guarda o lote em um objeto persistente.
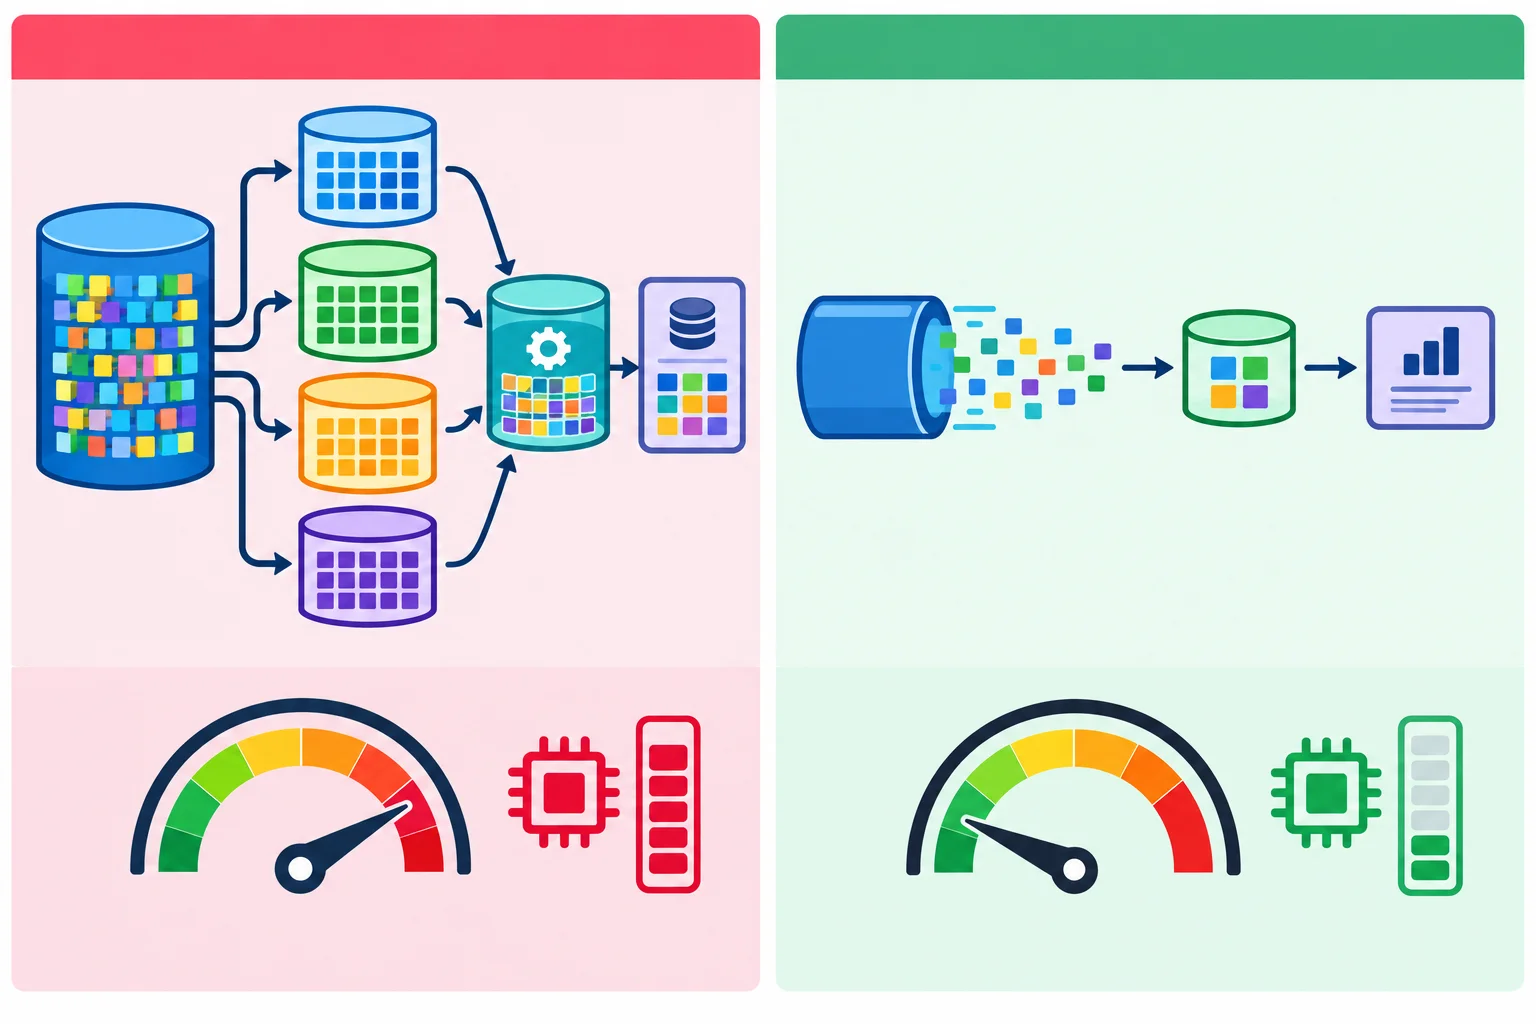
À esquerda, a sobreposição aumenta o pico e o último lote continua alcançável. À direita, há somente um lote de cada vez e o histórico é compacto.
Dica
Compare fontes equivalentes criadas dentro da medição. Aceite a alteração quando os resumos e os testes de contrato continuarem corretos e o pico observado couber no orçamento definido para a carga. A memória residente do processo não precisa cair imediatamente para que a memória rastreada tenha sido reduzida.
Crie um arquivo, por exemplo comparar_memoria.py, cole o código abaixo e execute python comparar_memoria.py. Ele inicia o rastreamento antes de cada fonte, processa três ciclos equivalentes e mostra memória atual e pico em KiB.
from itertools import islice
import tracemalloc

N_REGISTROS = 40_000
TAMANHO_LOTE = 200
CICLOS = 3


def gerar_registros(quantidade: int):
    for indice in range(quantidade):
        yield {
            "id": indice,
            "valor": (indice * 17) % 1_000,
            "ativo": indice % 3 != 0,
        }


def transformar(registro: dict) -> int:
    # Leitura בלבד: não altera o registro recebido.
    return registro["valor"] * 2 if registro["ativo"] else 0


class ProcessadorInicial:
    def __init__(self, tamanho_lote: int):
        if tamanho_lote <= 0:
            raise ValueError("tamanho_lote deve ser positivo")
        self.tamanho_lote = tamanho_lote
        self.last_batch = None  # vínculo persistente desnecessário

    def processar(self, registros: list[dict]) -> dict:
        # Fonte completa + todas as fatias coexistem.
        lotes = [
            registros[inicio : inicio + self.tamanho_lote]
            for inicio in range(0, len(registros), self.tamanho_lote)
        ]
        total = 0
        quantidade = 0
        for lote in lotes:
            transformados = [transformar(registro) for registro in lote]
            total += sum(transformados)
            quantidade += len(transformados)
            self.last_batch = transformados
        return {"quantidade": quantidade, "total": total}


class ProcessadorAjustado:
    def __init__(self, tamanho_lote: int):
        if tamanho_lote <= 0:
            raise ValueError("tamanho_lote deve ser positivo")
        self.tamanho_lote = tamanho_lote

    def processar(self, registros) -> dict:
        total = 0
        quantidade = 0
        fonte = iter(registros)
        while lote := list(islice(fonte, self.tamanho_lote)):
            # O lote é consumido antes de obter o próximo.
            for registro in lote:
                total += transformar(registro)
                quantidade += 1
        return {"quantidade": quantidade, "total": total}


def medir(processador, criar_fonte) -> tuple[dict, int, int]:
    tracemalloc.start()
    try:
        resultado = None
        for _ in range(CICLOS):
            # A fonte é recriada e consumida dentro da fronteira medida.
            resultado = processador.processar(criar_fonte())
        atual, pico = tracemalloc.get_traced_memory()
        return resultado, atual, pico
    finally:
        tracemalloc.stop()


def verificar_contrato() -> None:
    registros = list(gerar_registros(20))
    entrada_antes = [registro.copy() for registro in registros]

    inicial = ProcessadorInicial(4)
    ajustado = ProcessadorAjustado(4)
    resumo_inicial = inicial.processar(registros)
    resumo_ajustado = ajustado.processar(gerar_registros(20))

    assert resumo_inicial == resumo_ajustado
    assert registros == entrada_antes, "a entrada não pode ser alterada"
    assert resumo_inicial is not resumo_ajustado, "cada chamada retorna seu próprio resumo"

    for classe in (ProcessadorInicial, ProcessadorAjustado):
        try:
            classe(0)
        except ValueError:
            pass
        else:
            raise AssertionError("lote inválido deve continuar falhando")


verificar_contrato()

inicial = ProcessadorInicial(TAMANHO_LOTE)
ajustado = ProcessadorAjustado(TAMANHO_LOTE)

resumo_inicial, atual_inicial, pico_inicial = medir(
    inicial,
    lambda: list(gerar_registros(N_REGISTROS)),
)
resumo_ajustado, atual_ajustado, pico_ajustado = medir(
    ajustado,
    lambda: gerar_registros(N_REGISTROS),
)

assert resumo_inicial == resumo_ajustado
assert inicial.last_batch is not None
assert not hasattr(ajustado, "last_batch")

print("Testes de contrato: OK")
print(f"Resumo equivalente: {resumo_ajustado}")
print(f"Inicial  — atual: {atual_inicial / 1024:.1f} KiB | pico: {pico_inicial / 1024:.1f} KiB")
print(f"Ajustado — atual: {atual_ajustado / 1024:.1f} KiB | pico: {pico_ajustado / 1024:.1f} KiB")
print(f"Lote escolhido: {TAMANHO_LOTE} registros")Após executar o arquivo, registre: (1) quais estruturas causavam a sobreposição no pico, (2) qual referência prolongava a vida de um lote, (3) o tamanho de lote escolhido, (4) os valores de memória atual e pico antes e depois, e (5) quais verificações de contrato passaram. Se houver um orçamento local, diga se o pico ajustado ficou dentro dele.
Escreva pelo menos 180 caracteres (0/180).
Resumo
Use este roteiro ao otimizar um fluxo semelhante.
Parabéns! Você concluiu: Reduzir o pico e a retenção de memória
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks