Passo 1 de 9
Selecionar cálculos adequados à memoização
Reconheça quando reutilizar um resultado preserva o contrato da função e quando estado externo ou efeitos colaterais impedem essa decisão.
Trilha de aprendizado · Nível 14 · Tutorial 10
Aplique cache a cálculos adequados e avalie se a reutilização compensa a memória retida, os custos de consulta e as exigências de invalidação.
 Selecionar cálculos adequados à memoização
Reconheça quando reutilizar um resultado preserva o contrato da função e quando estado externo ou efeitos colaterais impedem essa decisão. 2 min
 Aplicar lru_cache a argumentos estáveis
Configure uma função síncrona com capacidade limitada de cache e reconheça os requisitos dos argumentos usados como chave. 3 min
 Interpretar métricas e prever o descarte LRU
Leia as estatísticas do cache e acompanhe como acessos repetidos alteram a ordem de recência e o descarte. 3 min
 Identificar a memória mantida pelo cache
Observe quais referências um cache conserva e meça por que um limite de entradas não equivale a um limite fixo de bytes. 3 min
 Invalidar resultados quando a fonte muda
Defina uma política explícita de invalidação e teste localmente como cache_clear impede a reutilização de um valor desatualizado. 2 min
 Proteger o contrato de resultados mutáveis
Evite que um resultado mutável armazenado em cache seja alterado por um consumidor e reapareça modificado em chamadas futuras. 2 min
 Comparar cache vazio, aquecido e ausência de cache
Meça localmente três estados de execução e use tempos, contadores e distribuição de chaves para decidir se o cache compensa. 4 min
 Distinguir coerência entre threads de execução única
Entenda por que um cache coerente entre threads ainda pode executar o mesmo cálculo mais de uma vez durante um miss simultâneo. 2 min
 Concluir uma decisão de cache com evidências
Integre correção, tempo, memória e invalidação para recomendar um cache limitado ou rejeitá-lo. 3 min
Passo 1 de 9
Reconheça quando reutilizar um resultado preserva o contrato da função e quando estado externo ou efeitos colaterais impedem essa decisão.
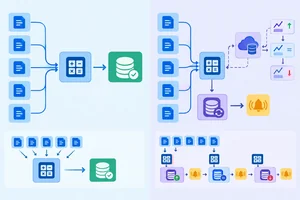
Memoização guarda o resultado de uma chamada para associá-lo aos argumentos usados. Em uma chamada futura com os mesmos argumentos, o programa pode devolver o resultado já obtido em vez de executar novamente o corpo da função.
Isso só é correto quando deixar de executar o corpo não altera o comportamento que a função promete.
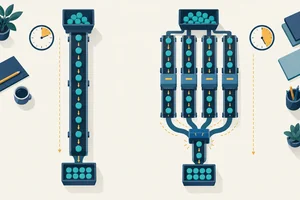
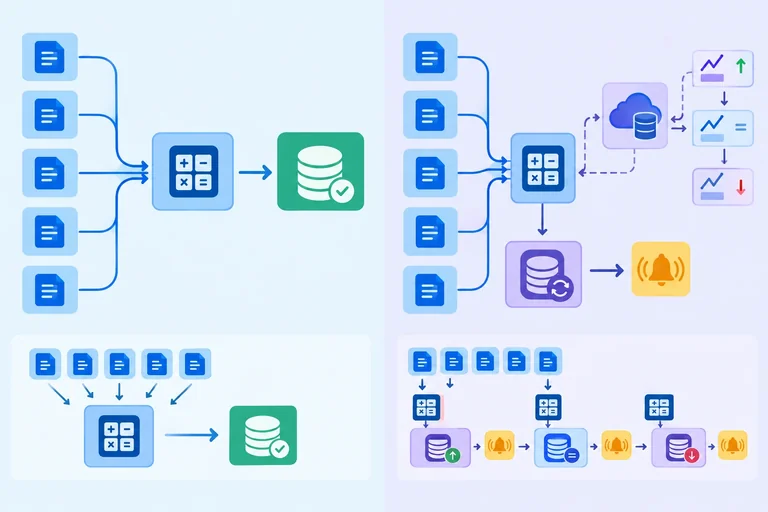
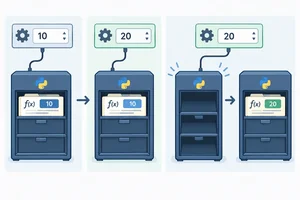
A mesma entrada pode seguir por dois caminhos: calcular na primeira vez e reutilizar o resultado nas repetições.
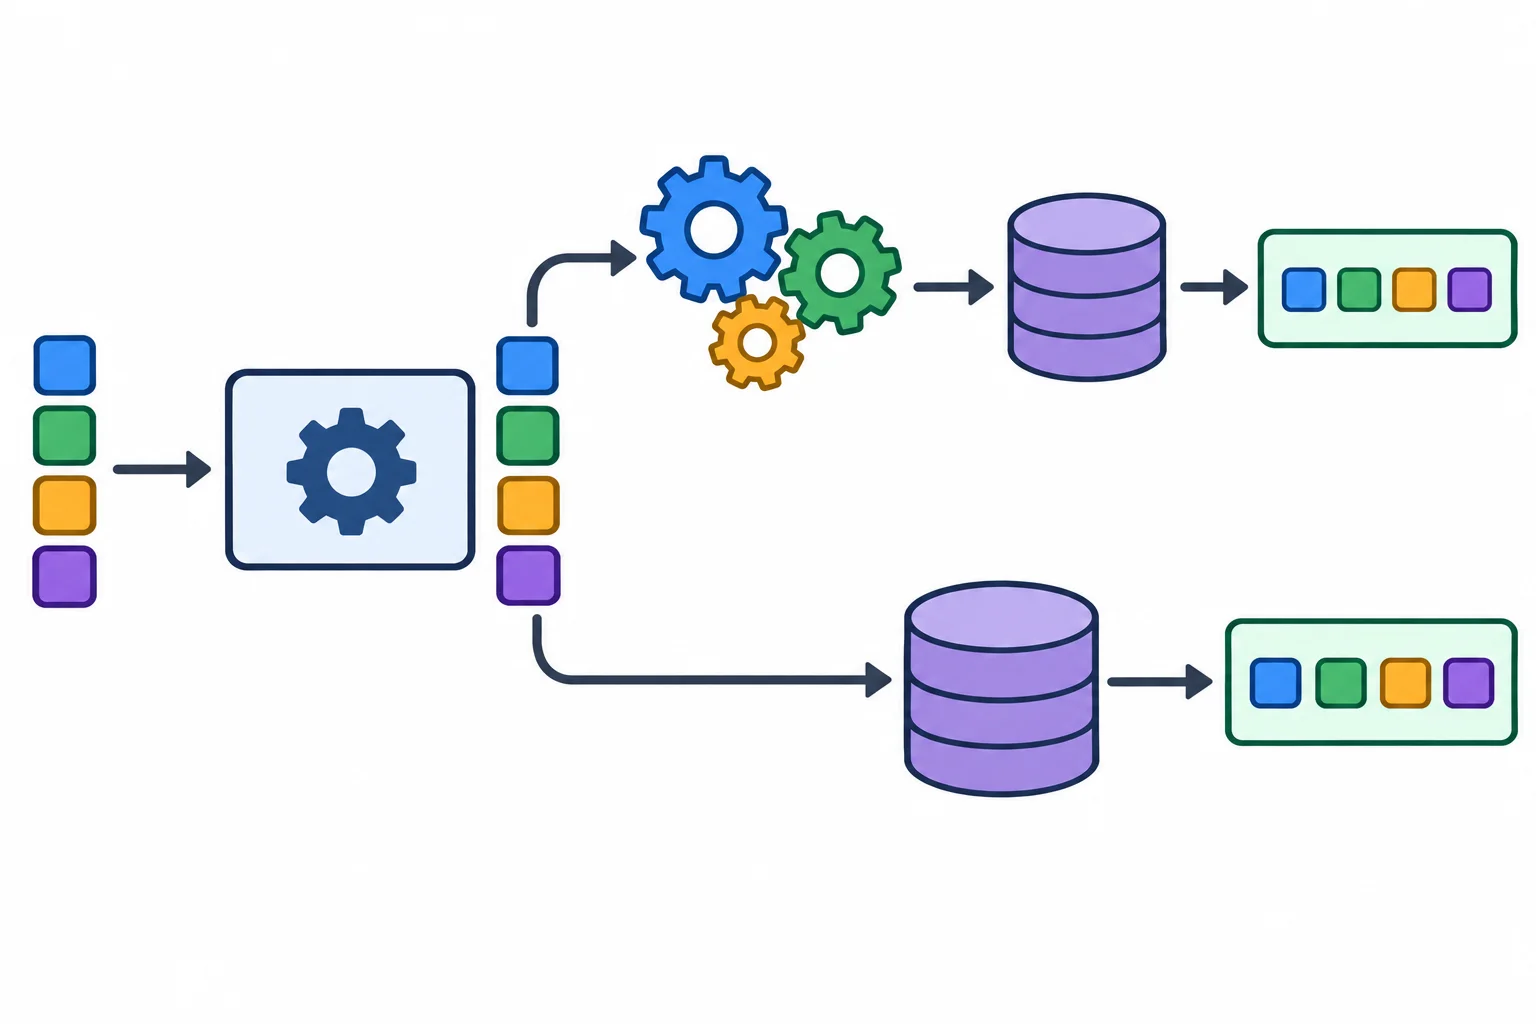
A reutilização é baseada nos argumentos da chamada; ela não refaz automaticamente o trabalho original.
Exemplo
def area_circulo(raio: float) -> float:
    return 3.14159 * raio ** 2
Para um mesmo raio, a função retorna o mesmo valor e não precisa produzir nenhum efeito observável a cada chamada. É uma candidata à memoização, desde que chamadas repetidas façam parte da carga real.
Exemplo
cotacao_atual = {"USD": 5.10}

def converter_para_reais(valor: float, moeda: str) -> float:
    return valor * cotacao_atual[moeda]

def registrar_acesso(usuario: str) -> None:
    print(f"Acesso registrado para {usuario}")
converter_para_reais(10, "USD") também depende de cotacao_atual. Se a cotação mudar, repetir apenas os argumentos não assegura um resultado atual. Já registrar_acesso precisa imprimir em toda chamada: pular seu corpo elimina um efeito exigido pelo contrato.
Dica
Antes de considerar cache, pergunte: para os mesmos argumentos, o resultado continua válido? E é aceitável que o corpo deixe de rodar? Uma resposta negativa indica que você deve evitar cache ou definir, mais adiante, uma política explícita para mudanças da fonte.
Considere que os argumentos recebidos são valores estáveis. Qual função pode reutilizar com segurança um resultado para a mesma chamada?
Uma função adequada não necessariamente merece cache. Se quase todas as chamadas usam argumentos novos, haverá pouca oportunidade de reutilizar resultados. Além disso, consultar e manter um cache também tem custos de tempo e memória.
A decisão completa exige observar o padrão real de chamadas. Nos próximos passos, você aplicará um cache limitado e verificará seus sinais de uso.
Escolha uma função que você conheça ou imagine. Explique por que ela seria adequada para memoização ou por que deveria ser rejeitada, citando argumentos, estado externo e efeitos colaterais quando forem relevantes.
Escreva pelo menos 80 caracteres (0/80).
Passo 2 de 9
Configure uma função síncrona com capacidade limitada de cache e reconheça os requisitos dos argumentos usados como chave.
Importe lru_cache de functools e aplique @lru_cache(maxsize=...) imediatamente acima de uma função síncrona. Use um maxsize positivo e explícito: ele define quantas entradas o cache poderá manter, não o tamanho delas em bytes.
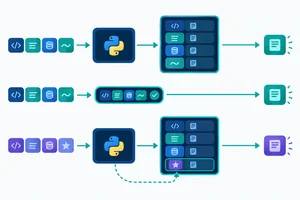
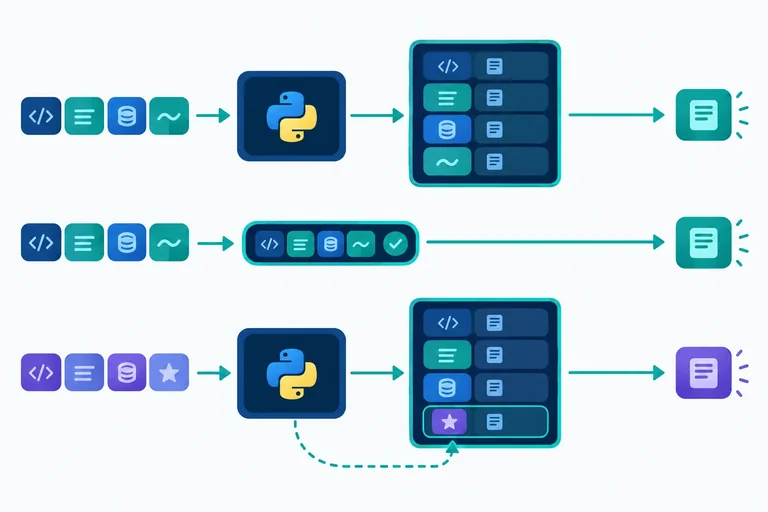
A cada chamada, o decorador monta uma chave a partir dos argumentos posicionais e nomeados. Se encontra essa chave, devolve o resultado guardado; se não encontra, executa a função e armazena o resultado para uma chamada futura equivalente.
A chamada repetida pode evitar a execução do corpo da função.
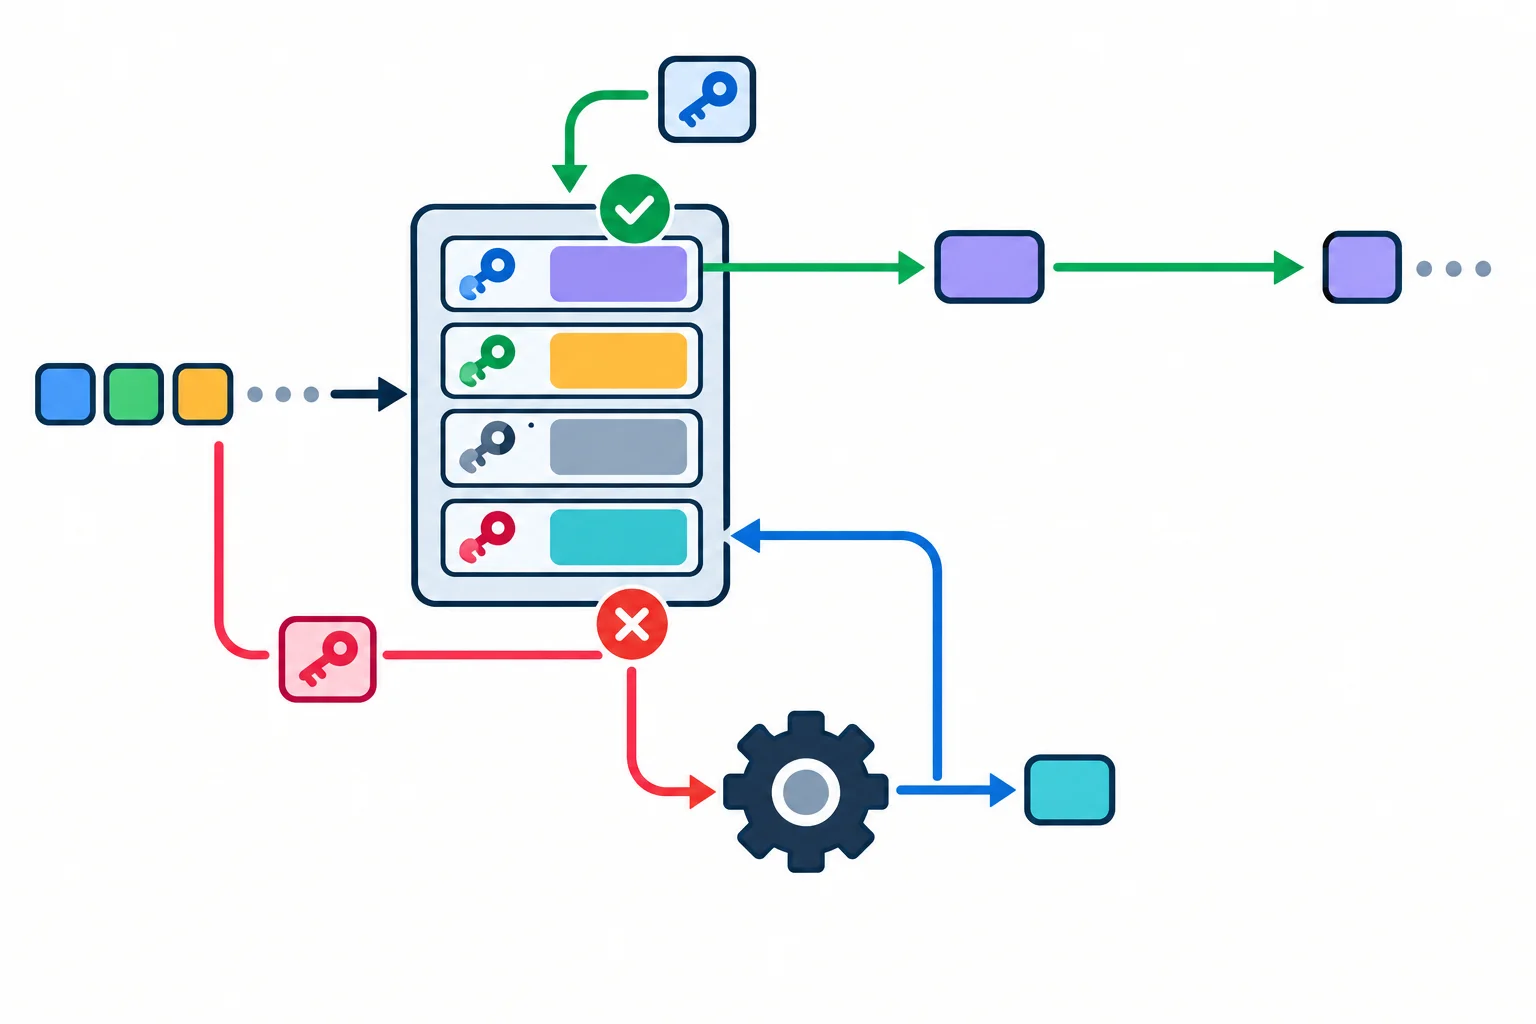
A chave é consultada antes de o corpo da função ser executado.
Crie um arquivo Python, cole o código completo abaixo e execute-o. O print dentro da função torna visível quando o corpo realmente foi executado.
Exemplo completo para execução local.
from functools import lru_cache


@lru_cache(maxsize=4)
def area_retangulo(largura: int, altura: int) -> int:
    print(f"calculando {largura} x {altura}")
    return largura * altura


print(area_retangulo(8, 5))
print(area_retangulo(8, 5))
print(area_retangulo(largura=8, altura=5))
print(area_retangulo(3, 7))
Exemplo
A primeira chamada com 8, 5 imprime calculando 8 x 5. A segunda chamada posicional igual devolve 40 sem imprimir novamente: ela reutiliza o resultado. A chamada com argumentos nomeados também é aceita; seus argumentos participam da chave conforme a forma da chamada.
Todos os argumentos posicionais e nomeados usados em uma chamada devem ser hasháveis. Valores como int, str, bytes e tuplas formadas apenas por valores hasháveis são candidatos usuais. Uma list é mutável e não é hashável; por isso não pode compor a chave.
A exigência é dos argumentos, não do retorno: a função pode retornar uma lista. Ainda assim, escolha argumentos cuja igualdade e hash não mudem enquanto puderem ser usados como chave.
Acrescente estas linhas ao mesmo arquivo e execute novamente.
@lru_cache(maxsize=4)
def ordenar(valores: tuple[int, ...]) -> list[int]:
    return sorted(valores)


print(ordenar((9, 2, 5)))   # funciona: tupla de inteiros é hashável
print(ordenar([9, 2, 5]))   # TypeError: unhashable type: 'list'
Atenção
Não contorne esse requisito criando hashes que mudam conforme o objeto é alterado. Se igualdade ou hash de uma chave mudar, a consulta ao cache deixa de ter um comportamento confiável. Converta dados mutáveis para uma representação estável — como uma tupla — quando isso preservar o contrato da função.
Para configurar uma capacidade explícita de quatro entradas, escreva o argumento que falta:
@lru_cache(____)
Depois de executar os exemplos, explique por que a chamada repetida de area_retangulo(8, 5) pode evitar novo cálculo e por que ordenar([9, 2, 5]) é rejeitada.
Escreva pelo menos 80 caracteres (0/80).
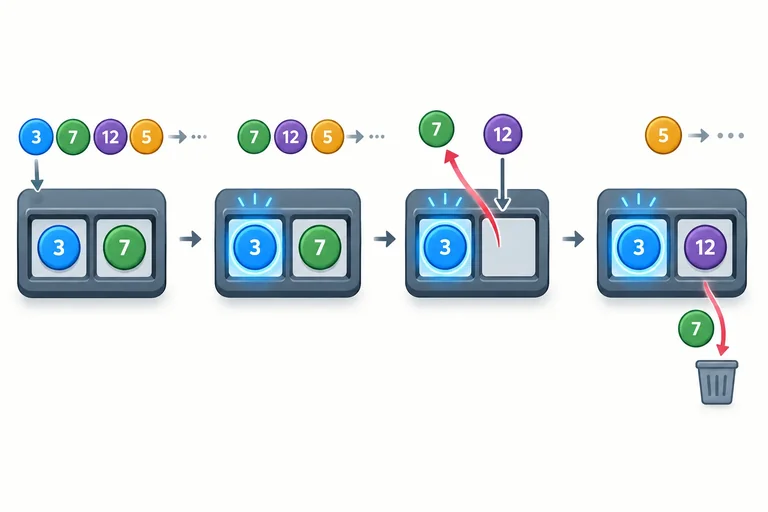
Passo 3 de 9
Leia as estatísticas do cache e acompanhe como acessos repetidos alteram a ordem de recência e o descarte.
O método cache_info() retorna uma estrutura com quatro números importantes:
hits: chamadas que reutilizaram uma entrada já armazenada.misses: chamadas cuja chave não estava no cache e, por isso, executaram a função antes de armazenar o resultado.maxsize: capacidade máxima configurada em quantidade de entradas.currsize: quantidade de entradas armazenadas agora.Um miss não é uma exceção: é apenas uma ausência normal no cache. E maxsize limita entradas, não bytes; duas entradas podem reter quantidades de memória muito diferentes.
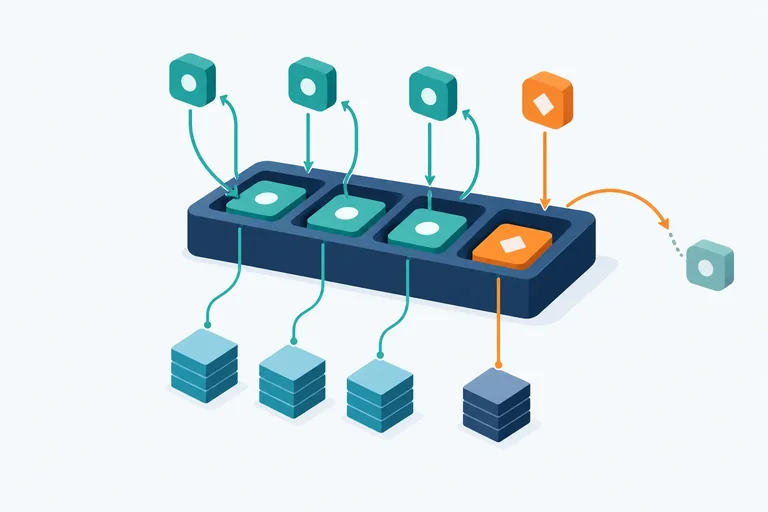
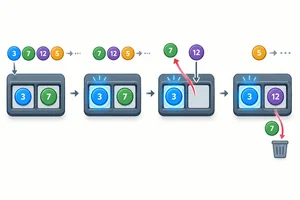
A sequência abaixo ilustra um cache com duas entradas.
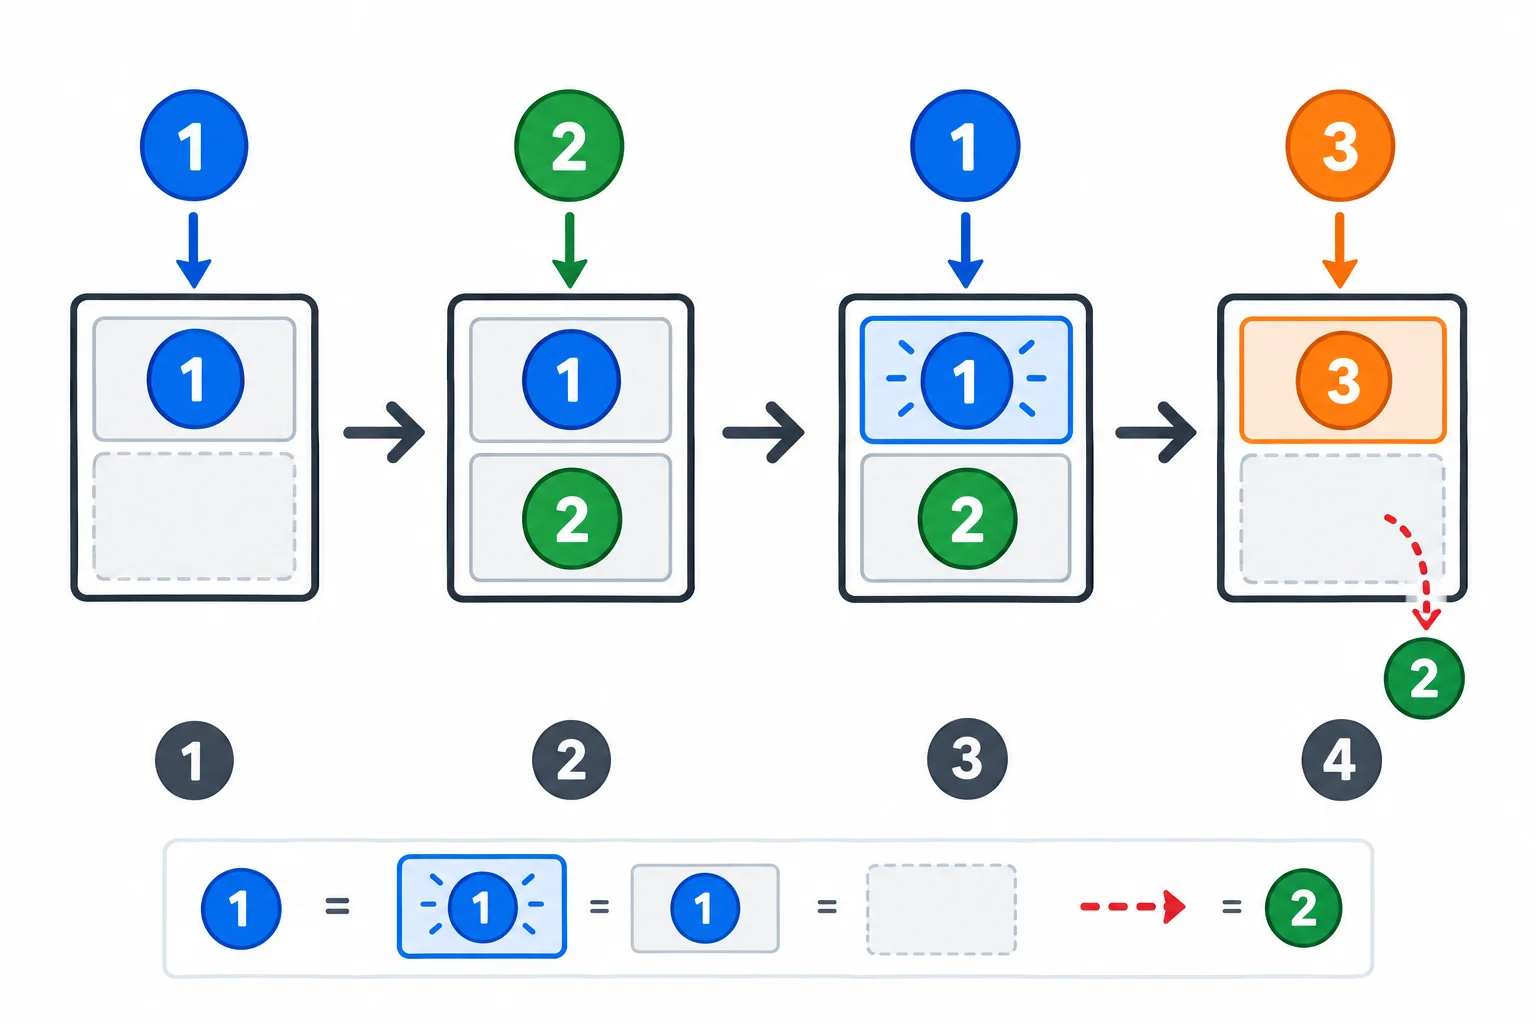
Em LRU, um hit também atualiza qual entrada foi usada mais recentemente.
Execute este exemplo localmente após as chamadas para inspecionar o estado.
from functools import lru_cache

@lru_cache(maxsize=2)
def dobrar(numero: int) -> int:
    return numero * 2

for numero in (1, 2, 1, 3):
    print(numero, "->", dobrar(numero))

print(dobrar.cache_info())
# CacheInfo(hits=1, misses=3, maxsize=2, currsize=2)Com maxsize=2, acompanhe dobrar(1), dobrar(2), dobrar(1), dobrar(3):
1: miss; cache contém 1.2: miss; cache contém 1, 2. A menos recente é 1.1: hit; 1 passa a ser a mais recente. Agora a menos recente é 2.3: miss; seria necessária uma terceira entrada. O cache descarta 2 e mantém 1, 3.Logo, após a sequência: hits=1, misses=3, currsize=2. LRU significa menos recentemente usada, não simplesmente “a primeira que entrou”.
Dica
@lru_cache(maxsize=None) desativa o limite de quantidade de entradas. Cada nova chave pode permanecer armazenada enquanto o cache existir; se as chaves continuarem variando, a ocupação pode crescer continuamente. Isso não torna o cache mais rápido por si só.
Após as chamadas dobrar(1), dobrar(2) e dobrar(1), ordene as entradas do cache da menos para a mais recentemente usada.
Com maxsize=2, após as chamadas dobrar(1), dobrar(2), dobrar(1), dobrar(3), a chave descartada é ___.
Passo 4 de 9
Observe quais referências um cache conserva e meça por que um limite de entradas não equivale a um limite fixo de bytes.
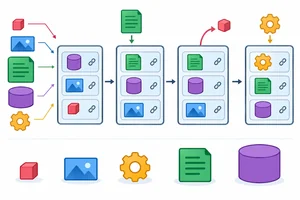
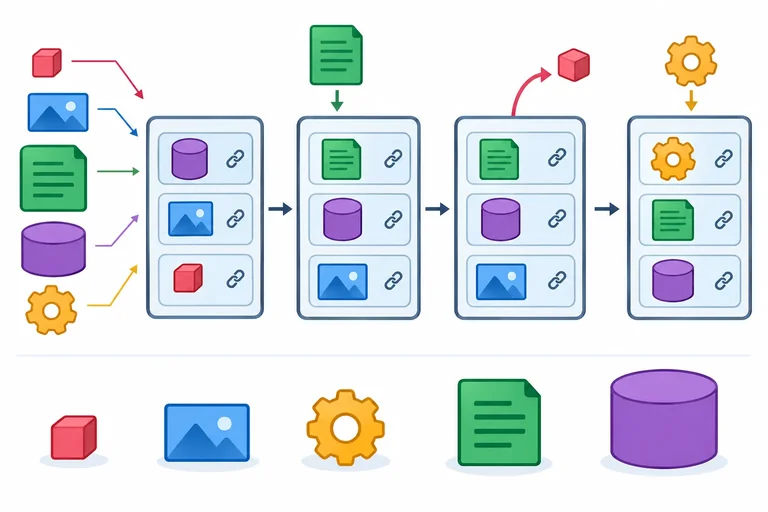
Enquanto uma entrada permanece no lru_cache, o cache conserva referências aos argumentos que formam sua chave e ao resultado associado. Se esses objetos alcançam outros objetos, essa retenção também pode ser indireta.
Por isso, currsize informa quantas entradas estão ocupadas, não quantos bytes elas usam. Duas entradas podem conter resultados minúsculos; outras duas podem manter estruturas muito maiores. Também existe a sobrecarga das chaves e da própria estrutura do cache.
O cache mantém os objetos alcançáveis pelas referências presentes na chave e no resultado.
Enquanto a entrada existir, os objetos alcançáveis por essas referências podem continuar vivos.
Atenção
maxsize=100 limita o número de resultados armazenados em 100, mas não define um teto de 100 MB, 10 MB ou qualquer quantidade de bytes. Para decidir uma capacidade, considere o tamanho e a distribuição reais de argumentos e resultados.
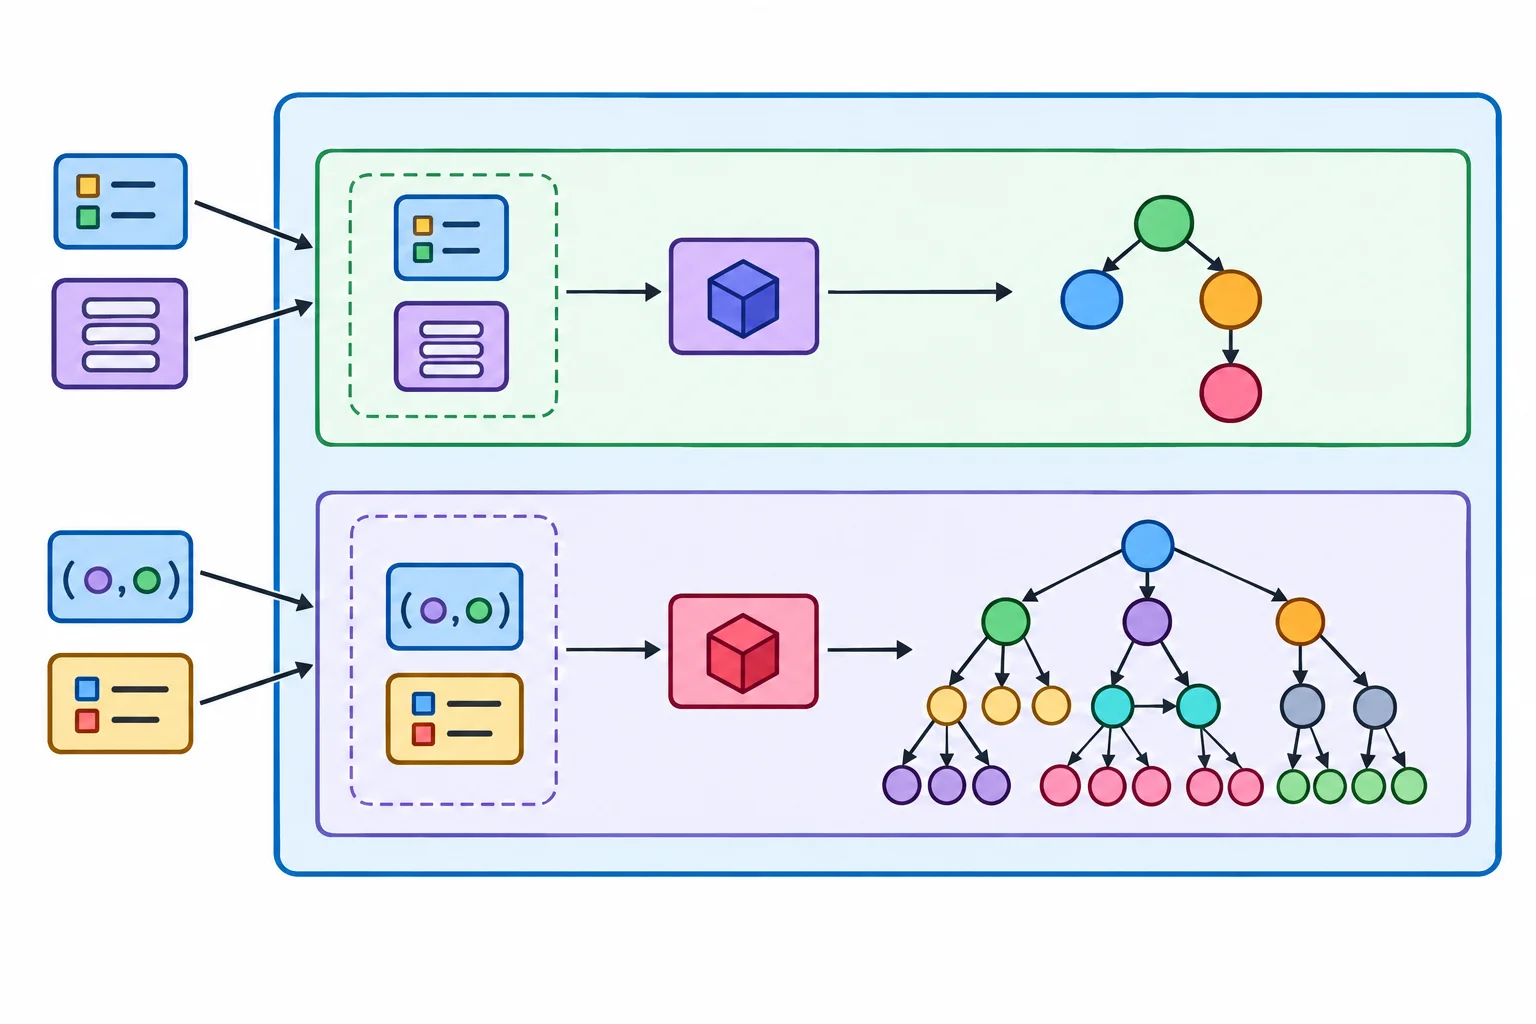
Quando lru_cache decora um método de instância, uma chamada como catalogo.resumo("python") usa self — isto é, a instância catalogo — como parte da chave, além dos demais argumentos.
O método decorado fica na classe e seu cache é compartilhado entre instâncias. Assim, uma entrada pode manter a instância viva por meio da referência a self. Como self participa da chave, ele precisa ser hashável. Uma classe comum costuma herdar hash por identidade; porém, uma classe que define igualdade e não define um hash compatível pode se tornar não hashável.
A chave de cada chamada identifica tanto a instância quanto os outros argumentos.
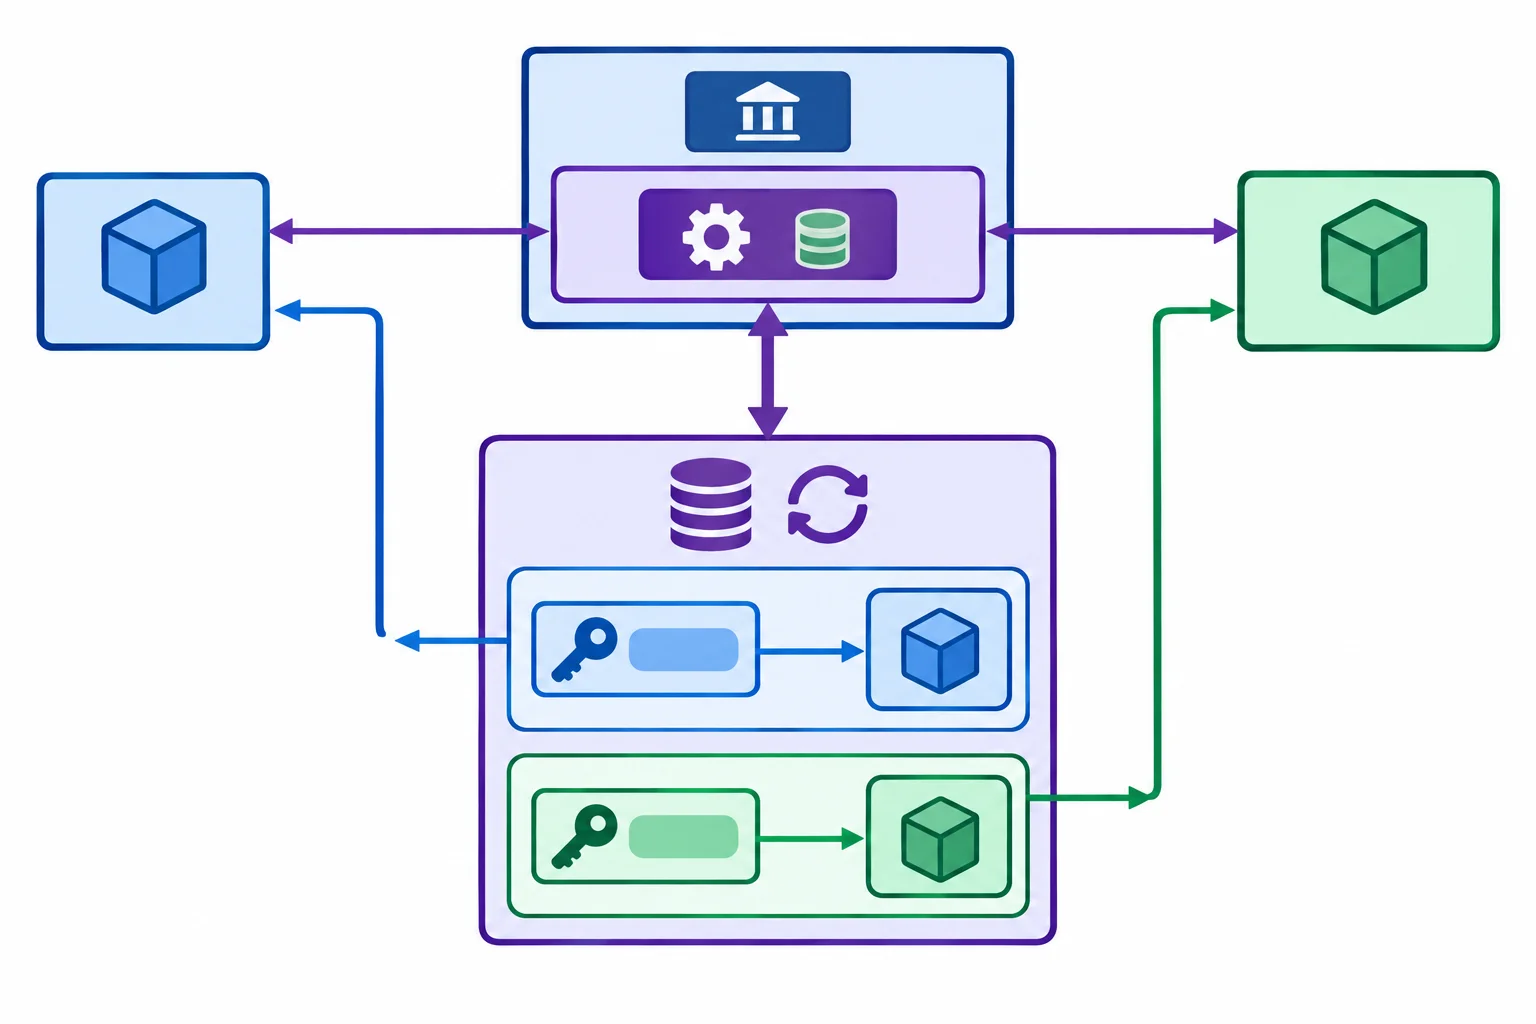
Mesmo após o restante do programa deixar de usar uma instância, uma entrada do método pode ainda referenciá-la.
Execute este script localmente. Ele cria resultados imutáveis de tamanhos controlados e não guarda os retornos em uma lista ou variável externa. A medição usa somente tracemalloc; uma comparação de tempo deve ser um experimento separado, sem essa instrumentação.
Salve como memoria_cache.py e execute com Python 3.
from functools import lru_cache
import tracemalloc


@lru_cache(maxsize=2)
def bloco(tamanho: int) -> bytes:
    # bytes é imutável; cada tamanho representa um resultado controlado.
    return bytes(tamanho)


def mostrar(etapa: str) -> None:
    atual, pico = tracemalloc.get_traced_memory()
    info = bloco.cache_info()
    print(
        f"{etapa:18} "
        f"currsize={info.currsize} "
        f"hits={info.hits} misses={info.misses} "
        f"atual={atual / 1_000_000:.2f} MB "
        f"pico={pico / 1_000_000:.2f} MB"
    )


tracemalloc.start()

bloco(300_000)
mostrar("após 300 KB")

bloco(900_000)
mostrar("após 900 KB")

# A terceira chave excede maxsize=2 e descarta a menos recentemente usada.
bloco(1_500_000)
mostrar("após 1,5 MB")

tracemalloc.stop()Após executar o script, explique por que currsize pode permanecer em 2 enquanto a memória atual rastreada aumenta ou diminui. Inclua o que o valor de pico acrescenta à observação.
Escreva pelo menos 120 caracteres (0/120).
Dica
Se um cache retém objetos grandes, inspecione primeiro quais chaves e resultados sobrevivem em entradas ocupadas. Não conclua o consumo de memória a partir de currsize isoladamente.
Passo 5 de 9
Defina uma política explícita de invalidação e teste localmente como cache_clear impede a reutilização de um valor desatualizado.
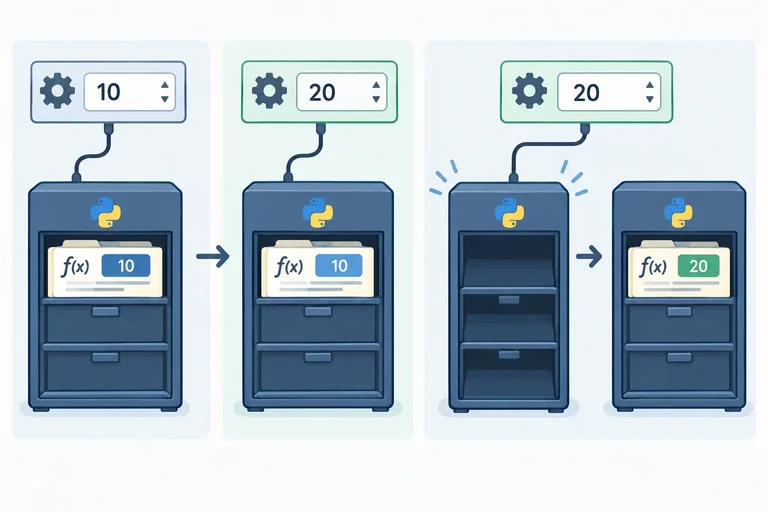
lru_cache não tem expiração por tempo e não observa automaticamente arquivos, configurações, bancos de dados, serviços externos nem atributos alteráveis de uma instância. Um acerto apenas informa que a chave já está armazenada; ele não confirma que a fonte ainda contém o mesmo dado.
Por isso, usar muito uma entrada pode mantê-la recente no cache, mas não a torna atual. Quando uma mudança relevante ocorre na fonte, sua aplicação precisa executar uma política explícita de invalidação antes das próximas consultas que exigem dados novos.
A mesma chamada continua encontrando a entrada já armazenada, mesmo depois de a fonte externa mudar.
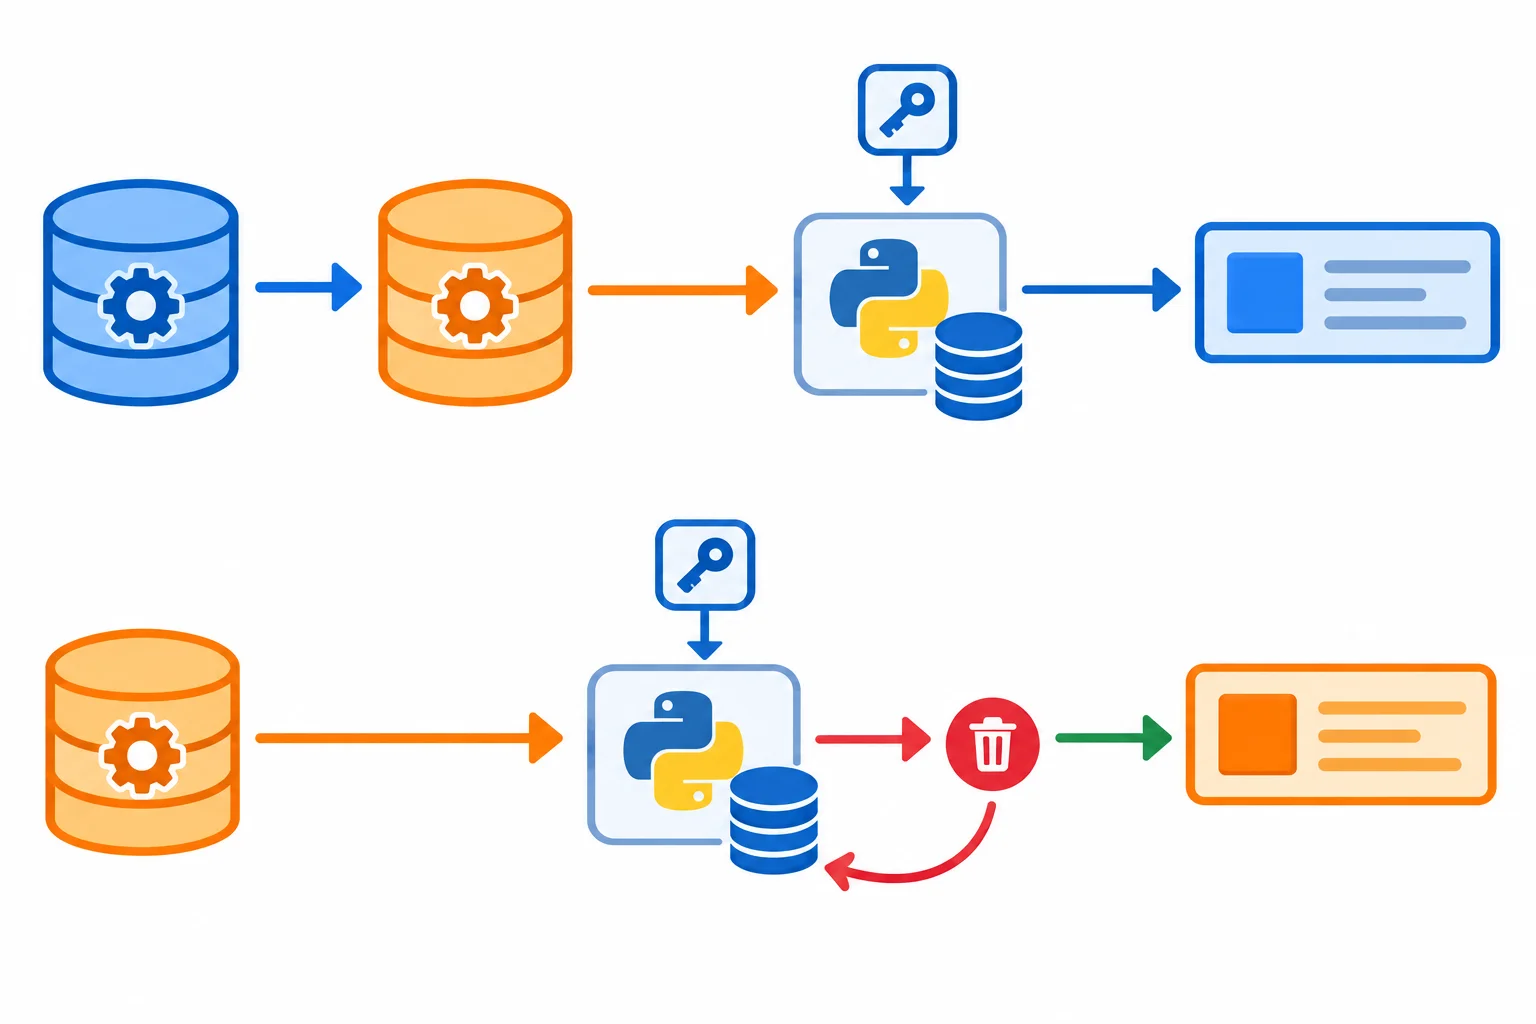
O cache conhece argumentos e resultados armazenados; ele não detecta sozinho uma alteração fora desses argumentos.
O dicionário representa uma fonte externa ao argumento de preco_com_desconto. A chave do cache é apenas produto; portanto, mudar a taxa não cria uma nova chave.
from functools import lru_cache

configuracao = {"desconto": 0.10}

@lru_cache(maxsize=4)
def preco_com_desconto(produto: str) -> float:
    preco_base = {"curso": 100.0}[produto]
    return preco_base * (1 - configuracao["desconto"])

print(preco_com_desconto("curso"))  # 90.0: miss, resultado armazenado
print(preco_com_desconto.cache_info())

configuracao["desconto"] = 0.25
print(preco_com_desconto("curso"))  # ainda 90.0: hit com resultado antigo
print(preco_com_desconto.cache_info())

preco_com_desconto.cache_clear()
print(preco_com_desconto.cache_info())  # hits=0, misses=0, currsize=0
print(preco_com_desconto("curso"))  # 75.0: nova execução com a fonte atual
print(preco_com_desconto.cache_info())
Dica
Associe cache_clear() ao evento que realmente altera a fonte: por exemplo, após recarregar uma configuração ou concluir uma atualização de dados. Não limpe a cada consulta sem necessidade, pois isso elimina a reutilização que justificava o cache.
preco_com_desconto.cache_clear() remove todas as entradas daquele cache e reinicia hits e misses. Assim, a próxima chamada não encontra a chave e executa o corpo da função novamente.
A limpeza remove as referências que o cache mantinha para seus argumentos e resultados. Isso não destrói objetos que ainda tenham outras referências no programa; apenas deixa de ser o cache quem os mantém vivos.
Coloque na ordem correta as ações para obter o novo preço após uma alteração da configuração.
No script, por que o valor permanece 90.0 após alterar a configuração? Explique o que muda após cache_clear() e indique qual evento do caso deve disparar essa limpeza.
Escreva pelo menos 120 caracteres (0/120).
Passo 6 de 9
Evite que um resultado mutável armazenado em cache seja alterado por um consumidor e reapareça modificado em chamadas futuras.
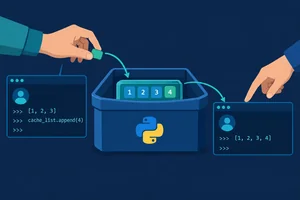
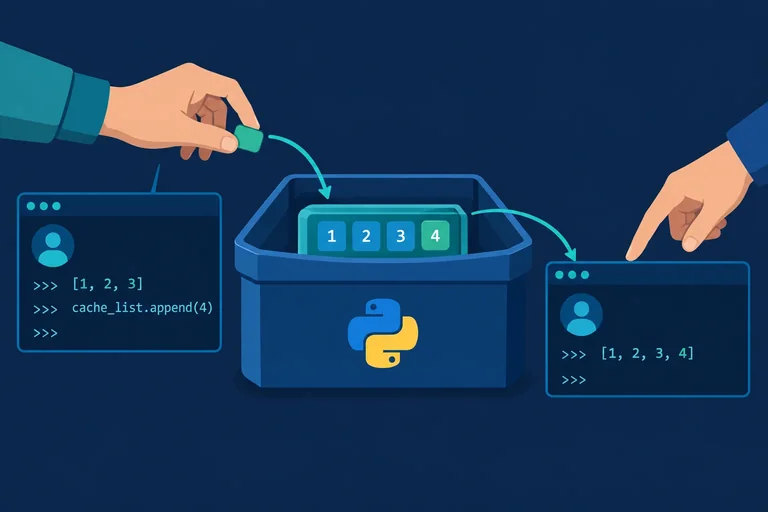
Em uma chamada com a mesma chave, lru_cache devolve o objeto que foi armazenado no primeiro cálculo. Se esse objeto for mutável, como uma lista ou dicionário, consumidores diferentes passam a compartilhar o mesmo estado.
O segundo retorno aponta para a mesma lista já guardada pelo cache.
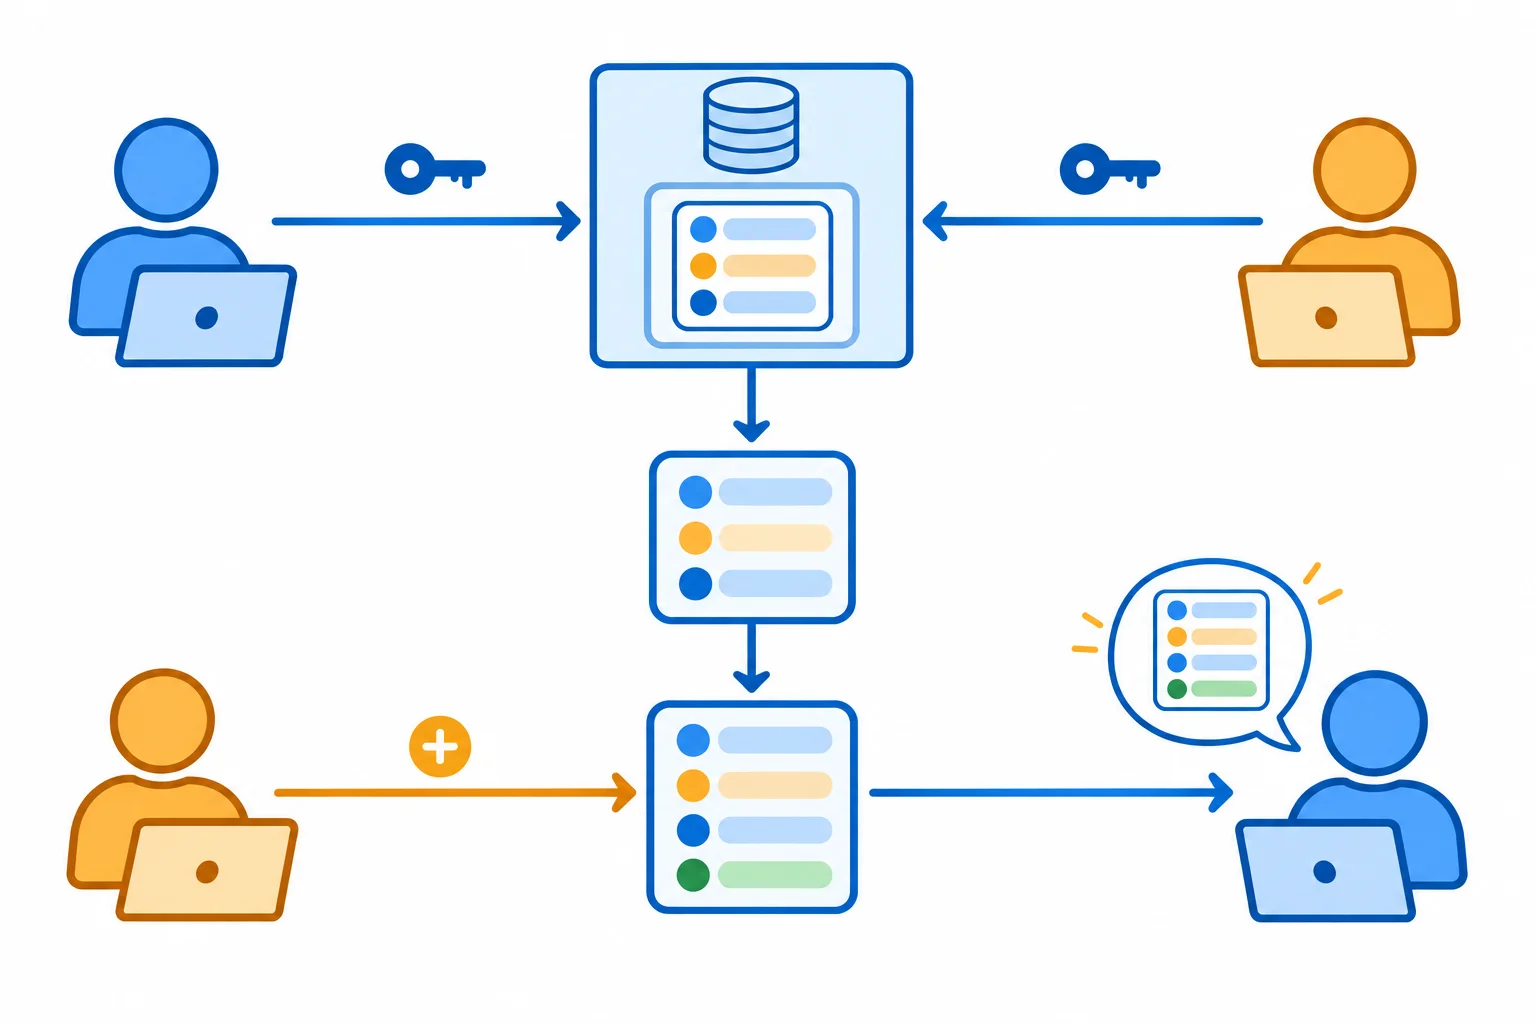
Um hit reutiliza a referência armazenada; ele não produz uma lista equivalente nova.
Atenção
Não use diretamente lru_cache para entregar objetos mutáveis quando o contrato promete que cada consumidor pode alterá-los de modo independente. Uma alteração local pode virar estado observável por chamadas futuras com a mesma chave.
Execute este script. A segunda chamada é um hit para a mesma chave.
from functools import lru_cache

@lru_cache(maxsize=8)
def etiquetas(categoria: str) -> list[str]:
    return [categoria, "novo"]

primeiro = etiquetas("livro")
primeiro.append("promoção")

segundo = etiquetas("livro")

print(primeiro)          # ['livro', 'novo', 'promoção']
print(segundo)           # ['livro', 'novo', 'promoção']
print(primeiro is segundo) # TrueDepois de executar o script, explique por que segundo contém "promoção".
Escreva pelo menos 40 caracteres (0/40).
Se os consumidores não precisam modificar o retorno, prefira armazenar e devolver uma estrutura efetivamente imutável, como uma tupla. Se cada consumidor precisa de uma estrutura mutável própria, mantenha o cache em uma função interna e faça a cópia em uma camada externa, depois do hit.
Aqui o cache guarda uma tupla imutável. A função pública cria uma lista nova em cada chamada.
from functools import lru_cache

@lru_cache(maxsize=8)
def _etiquetas_base(categoria: str) -> tuple[str, ...]:
    return (categoria, "novo")

def etiquetas_para_edicao(categoria: str) -> list[str]:
    return list(_etiquetas_base(categoria))

primeiro = etiquetas_para_edicao("livro")
primeiro.append("promoção")

segundo = etiquetas_para_edicao("livro")

print(primeiro)          # ['livro', 'novo', 'promoção']
print(segundo)           # ['livro', 'novo']
print(primeiro is segundo)  # False
Dica
list(...) basta quando os elementos não exigem isolamento adicional. Para estruturas aninhadas mutáveis, faça uma cópia compatível com o contrato — por exemplo, reconstruindo as partes mutáveis necessárias ou usando uma cópia profunda quando ela for realmente exigida.
Associe cada situação à estratégia mais adequada.
Toque em um item e depois no par correspondente.
Passo 7 de 9
Meça localmente três estados de execução e use tempos, contadores e distribuição de chaves para decidir se o cache compensa.
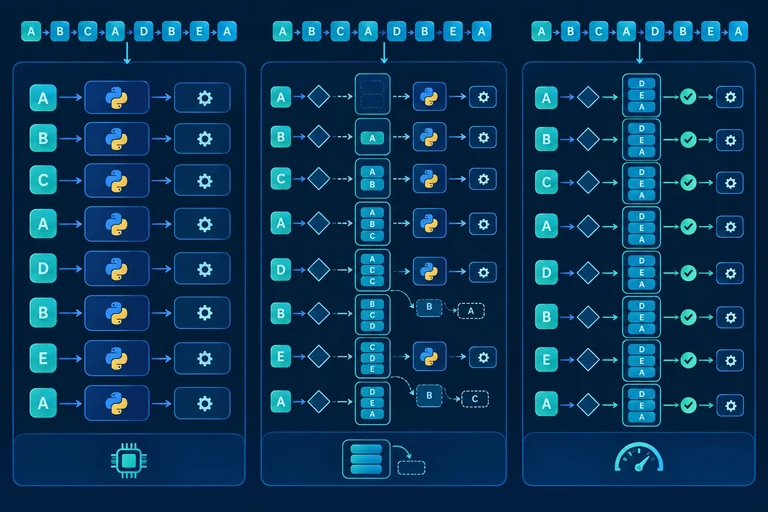
Um acerto evita o cálculo, mas uma chamada com cache ainda consulta a chave, calcula hashes, mantém a estrutura LRU e pode exigir cópias em uma camada externa quando o contrato pede objetos independentes.
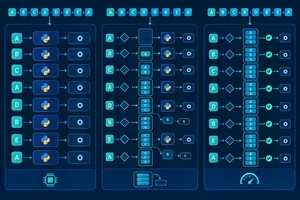
Compare a mesma sequência de argumentos em três cenários: sem cache, cache vazio e cache aquecido. O ganho depende de quanto custa o cálculo evitado, da repetição das chaves e da capacidade disponível.
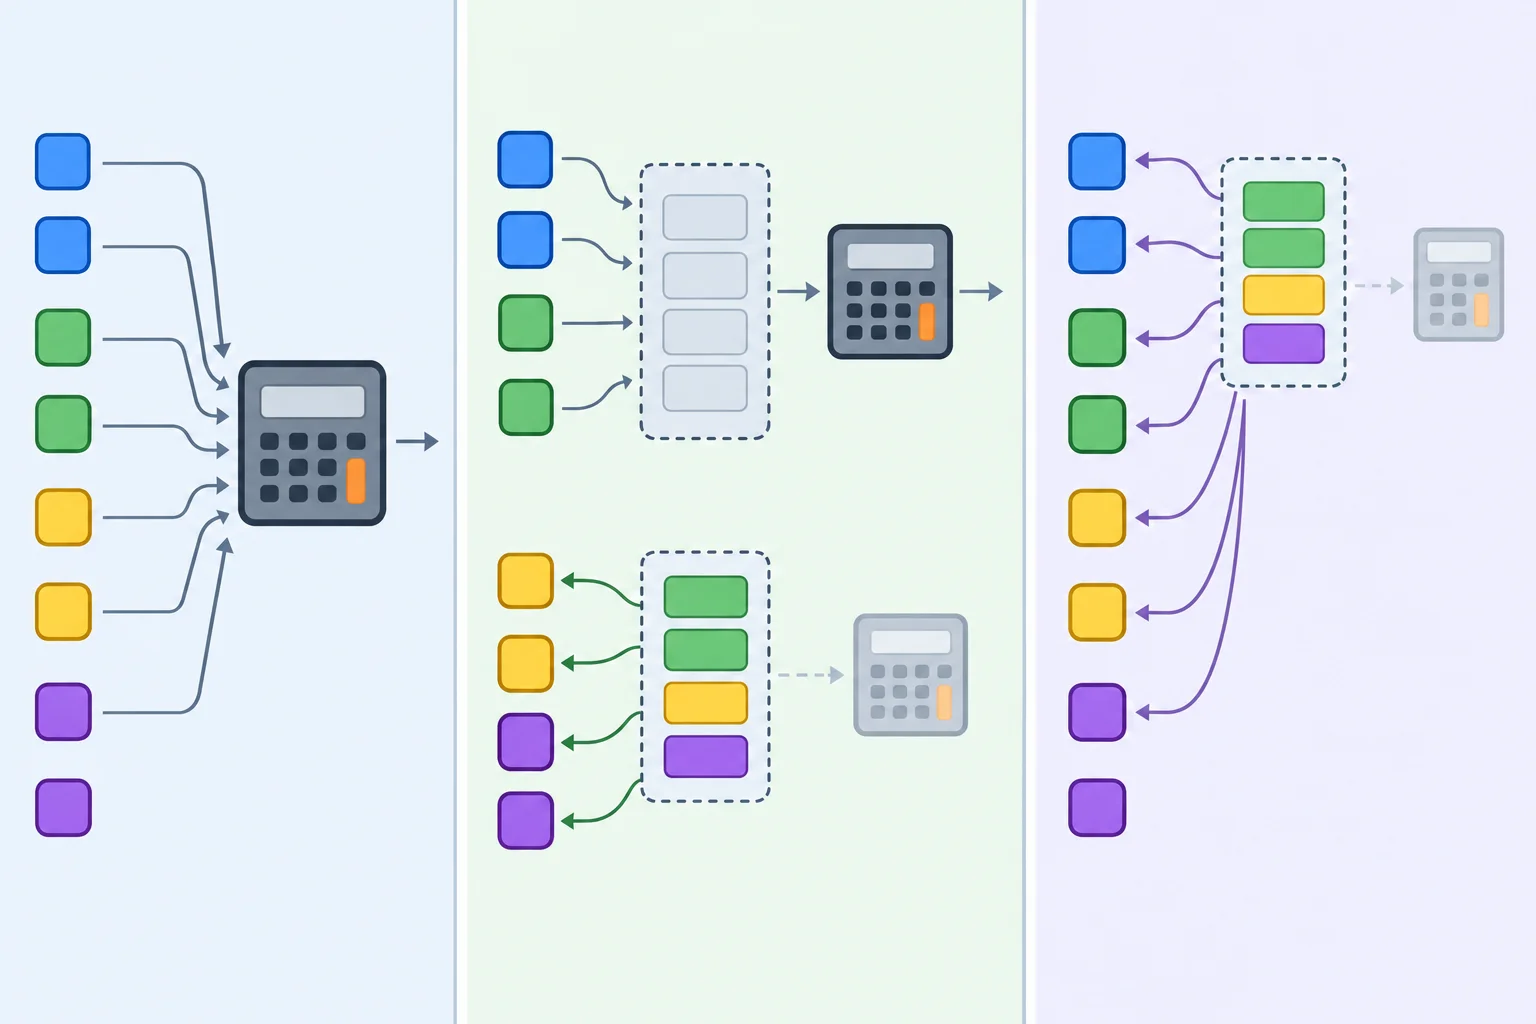
A sequência de argumentos é igual; o estado inicial do cache é o que muda entre os cenários.
Dica
Limpar ou aquecer o cache dentro do trecho cronometrado responde outra pergunta. Prepare o estado antes de cada amostra; cronometre apenas o lote de chamadas que representa a carga.
Copie o script inteiro para um arquivo, por exemplo comparar_cache.py, e execute com python comparar_cache.py. A função decorada não é recursiva; por isso, calcular.__wrapped__ fornece uma linha de base sem cache para o mesmo corpo da função.
from functools import lru_cache
from statistics import median
from timeit import Timer

AMOSTRAS = 7


@lru_cache(maxsize=16)
def calcular(n: int) -> int:
    # Trabalho determinístico propositalmente mais caro que uma soma simples.
    total = 0
    for i in range(1, 3_000):
        total = (total + n * i) % 1_000_003
    return total


sem_cache = calcular.__wrapped__


def executar(funcao, argumentos: list[int]) -> int:
    # O mesmo lote é usado nos três cenários.
    total = 0
    for n in argumentos:
        total += funcao(n)
    return total


def mostrar(nome: str, tempos: list[float], contadores: list[tuple[int, int]]) -> None:
    print(f"  {nome:13} mínimo={min(tempos):.6f}s  mediana={median(tempos):.6f}s")
    if contadores:
        print(f"  {'':13} Δhits/Δmisses por amostra: {contadores}")


def medir_sem_cache(argumentos: list[int], esperado: int) -> None:
    tempos = []
    for _ in range(AMOSTRAS):
        resultado = executar(sem_cache, argumentos)
        assert resultado == esperado
        # A linha acima confirma equivalência; a medição usa o mesmo lote.
        tempo = Timer(lambda: executar(sem_cache, argumentos)).timeit(number=1)
        tempos.append(tempo)
    mostrar("sem cache", tempos, [])


def medir_cache(argumentos: list[int], esperado: int, aquecido: bool) -> None:
    tempos = []
    contadores = []

    for _ in range(AMOSTRAS):
        calcular.cache_clear()  # Fora da cronometragem.

        if aquecido:
            # Preparação explícita. Se houver mais de 16 chaves, nem todas caberão.
            for n in argumentos:
                calcular(n)

        antes = calcular.cache_info()
        resultado = executar(calcular, argumentos)
        assert resultado == esperado

        # A amostra medida começa no mesmo estado que acabou de ser preparado.
        calcular.cache_clear()
        if aquecido:
            for n in argumentos:
                calcular(n)
        antes = calcular.cache_info()
        tempo = Timer(lambda: executar(calcular, argumentos)).timeit(number=1)
        depois = calcular.cache_info()

        tempos.append(tempo)
        contadores.append((depois.hits - antes.hits, depois.misses - antes.misses))

    nome = "cache aquecido" if aquecido else "cache vazio"
    mostrar(nome, tempos, contadores)


def comparar(nome: str, argumentos: list[int]) -> None:
    calcular.cache_clear()
    esperado = executar(sem_cache, argumentos)

    print(f"\n{nome}: {len(argumentos)} chamadas, "
          f"{len(set(argumentos))} chaves distintas, maxsize=16")
    medir_sem_cache(argumentos, esperado)
    medir_cache(argumentos, esperado, aquecido=False)
    medir_cache(argumentos, esperado, aquecido=True)


concentrado = [i % 8 for i in range(400)]
alta_cardinalidade = list(range(400))

comparar("Reutilização concentrada", concentrado)
comparar("Alta cardinalidade", alta_cardinalidade)No padrão concentrado, há somente 8 chaves para maxsize=16. No cache vazio, as primeiras ocorrências tendem a ser misses e as demais podem ser hits; no aquecido, o lote tende a começar com hits.
Na alta cardinalidade, há 400 chaves distintas. Preparar todas não faz todas caberem: o LRU mantém no máximo 16 entradas. Ao percorrer novamente a sequência em ordem, as entradas antigas podem ser descartadas antes de serem reutilizadas. Assim, o cache pode acrescentar custo sem evitar cálculo suficiente.
Dica
Para cada amostra, use apenas os deltas impressos: Δhits / (Δhits + Δmisses). Não inclua as chamadas usadas para aquecer o cache, pois elas pertencem à preparação, não à carga medida.
Use mínimo, mediana e variação entre amostras como evidências. Não existe uma porcentagem de acertos ou um ganho de tempo universal que obrigue o uso de cache.
Atenção
Um lote iniciado com cache vazio pode repetir uma chave e gerar acertos depois do primeiro miss. Por isso, não chame de cenário vazio uma repetição que reutiliza o cache deixado pela amostra anterior: limpe-o antes de cada amostra, fora do tempo medido.
Execute o script e relate: (1) os tempos de sem cache, cache vazio e cache aquecido em cada padrão; (2) os deltas de hits e misses; e (3) sua decisão sobre usar ou não o cache em cada caso. Explique a decisão pela relação entre número de chaves, repetição e maxsize=16.
Escreva pelo menos 180 caracteres (0/180).
Passo 8 de 9
Entenda por que um cache coerente entre threads ainda pode executar o mesmo cálculo mais de uma vez durante um miss simultâneo.
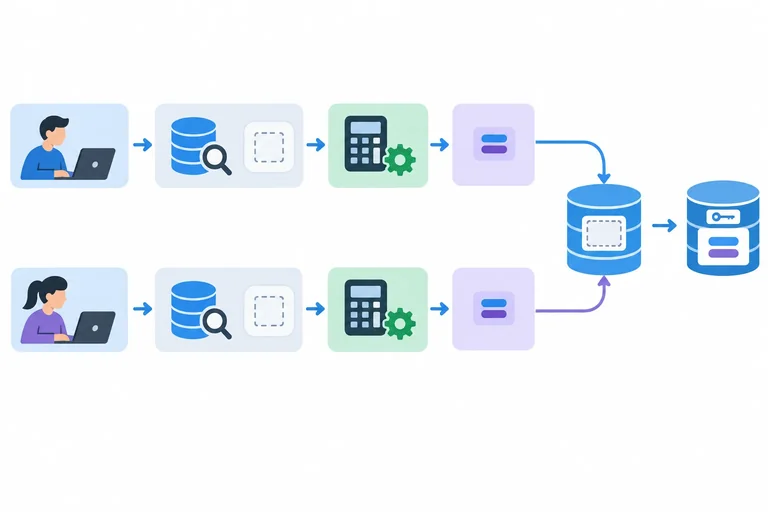
Quando várias threads usam uma função decorada com lru_cache, a estrutura interna do cache permanece coerente: acessos e atualizações não devem corromper suas entradas nem seus contadores.
Mas essa garantia não transforma um miss em trabalho exclusivo. O cache reutiliza resultados que já foram concluídos e armazenados; ele não reserva automaticamente uma chave ausente para uma única thread calcular.
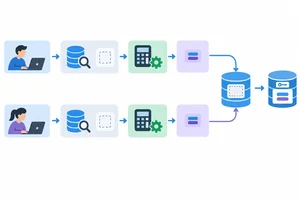
A janela importante ocorre entre a consulta que encontra a chave ausente e o armazenamento do resultado.
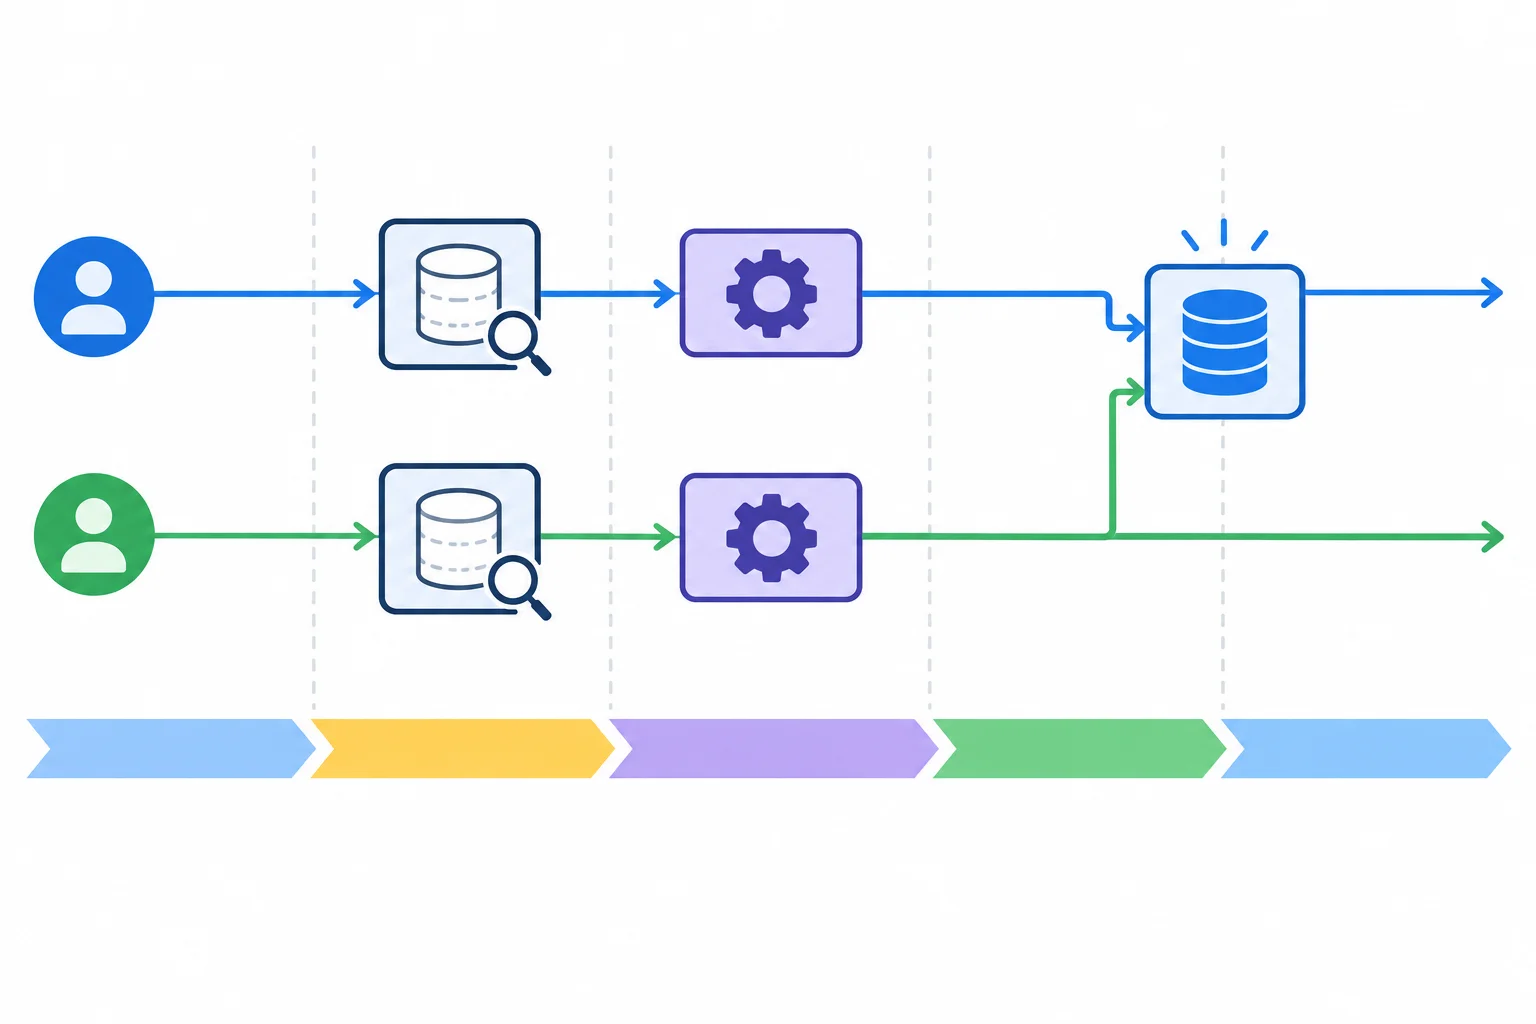
Se ambas consultarem antes de existir uma entrada, ambas podem executar o corpo da função.
Exemplo
Considere uma chamada para buscar_preco("A1"):
"A1": miss."A1": também miss.buscar_preco("A1").Não houve corrupção do cache. Ainda assim, o cálculo ocorreu duas vezes, pois nenhuma das threads encontrou um resultado já concluído.
Atenção
Se o corpo envia uma cobrança, grava um registro, dispara uma notificação ou produz outro efeito que precisa ocorrer exatamente uma vez, lru_cache não é o mecanismo adequado. Em um miss concorrente, o corpo pode rodar mais de uma vez.
Se lru_cache for usado por várias threads, duas chamadas simultâneas com os mesmos argumentos sempre executarão o corpo da função uma única vez.
Use lru_cache para reutilizar resultados concluídos de cálculos seguros de repetir. Trate a coordenação de trabalho em andamento como outro problema, especialmente quando duplicar a execução é caro ou altera o mundo externo.
Resumo
lru_cache permanece coerente com múltiplas threads.
Passo 9 de 9
Integre correção, tempo, memória e invalidação para recomendar um cache limitado ou rejeitá-lo.
Considere buscar_produto(codigo), que consulta um catálogo em memória. Para a mesma versão do catálogo e o mesmo código, a função deve devolver dados equivalentes e não tem efeito colateral. A carga real concentra consultas em 24 códigos populares, mas pode receber milhares de códigos diferentes ao longo do dia.
Medições locais com a mesma carga mostram:
lru_cache(maxsize=32) aquecido: 19 ms; 91% de acertos; currsize=32.lru_cache(maxsize=None) aquecido: 18 ms; 92% de acertos; currsize=18.400 após um período maior.Cada entrada retém os argumentos e o resultado. O orçamento do processo permite um cache pequeno, mas não crescimento contínuo.
Compare o pequeno ganho adicional sem limite com o crescimento de entradas retidas.
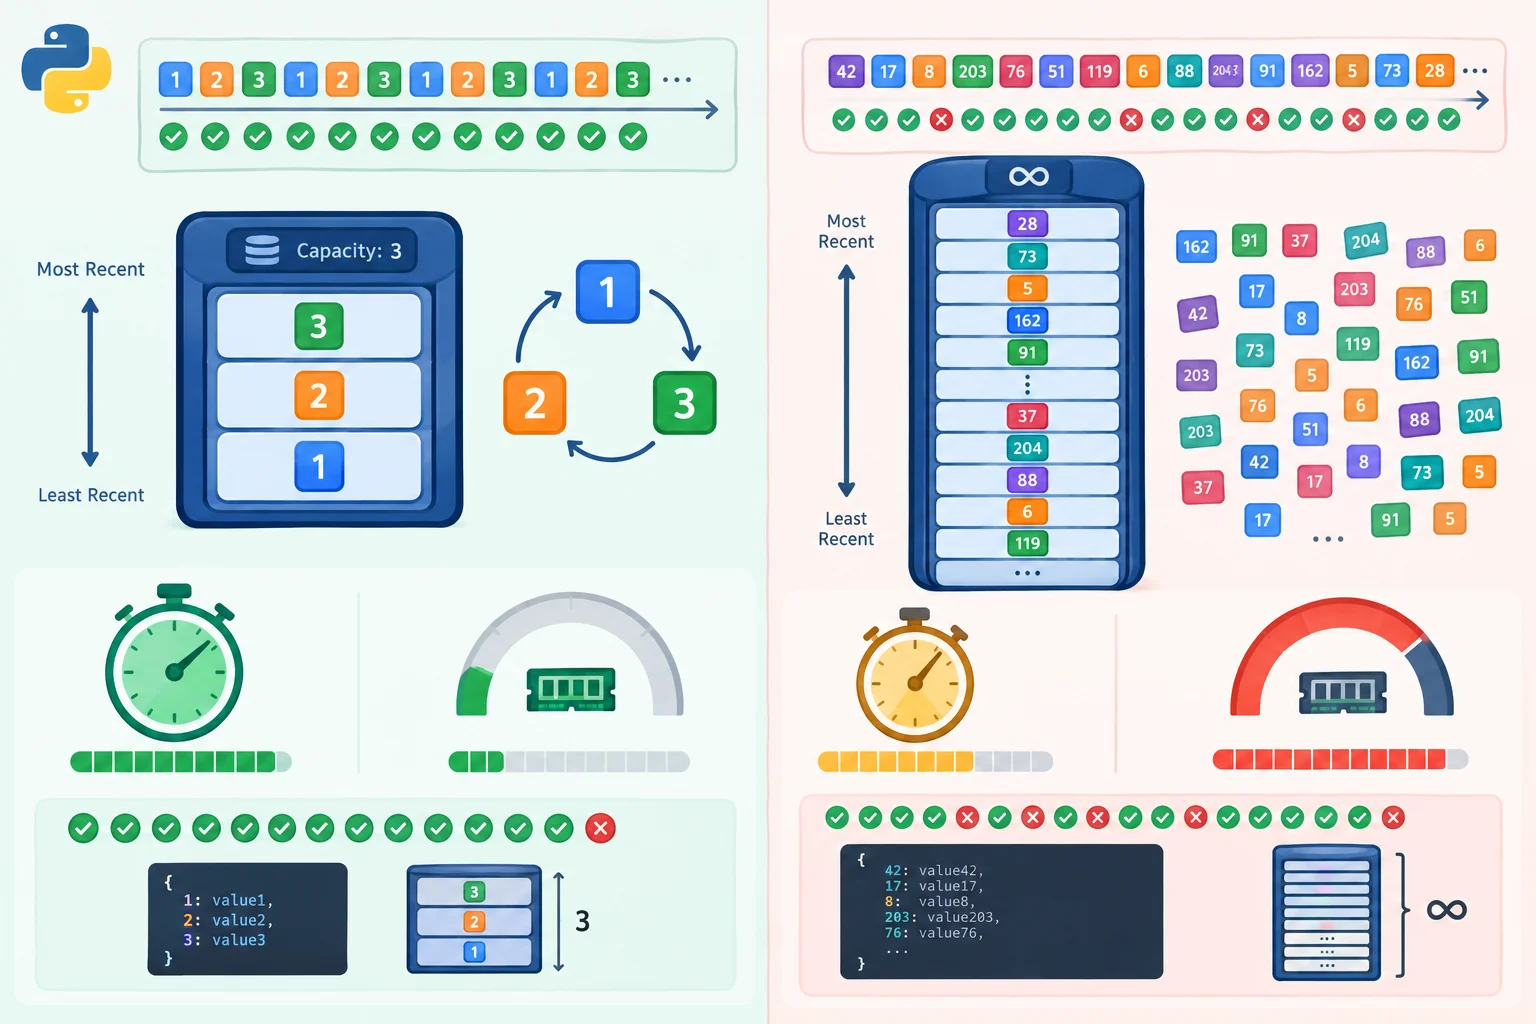
A decisão não depende só do menor tempo: a capacidade precisa caber no orçamento de memória.
Exemplo
Use @lru_cache(maxsize=32). A reutilização concentrada reduz bastante o tempo do lote, enquanto 32 entradas dão um teto para a quantidade de referências mantidas. maxsize=None melhora apenas 1 ms neste cenário, mas permite que chaves raras façam a ocupação crescer sem limite de entradas.
A limpeza deve ocorrer imediatamente após a troca, recarga ou alteração confirmada do catálogo: buscar_produto.cache_clear(), antes das próximas consultas que exigem dados atuais. Testes devem confirmar: resultado igual ao cálculo sem cache; resultado novo após alterar a fonte e limpar; e ausência de contaminação se consumidores puderem alterar o retorno.
Uma recomendação completa responde a estas perguntas:
currsize e o tamanho potencial de argumentos/resultados cabem no orçamento? Lembre-se: currsize não mede bytes.cache_clear() e quem é responsável por isso?Se o retorno for mutável e cada consumidor precisar de independência, a camada externa ao cache deve devolver uma cópia adequada — ou o contrato deve retornar uma estrutura imutável.
Atenção
Mesmo com coerência interna entre threads, duas threads podem encontrar a mesma chave ausente e executar o corpo simultaneamente antes de uma delas armazenar o resultado. Portanto, não use lru_cache para garantir uma única execução de uma operação com efeito colateral.
Qual decisão está mais bem justificada para buscar_produto?
Com base no dossiê, escreva uma recomendação para a equipe. Inclua: configuração ou rejeição do cache, uma evidência de tempo, uma evidência de memória, o evento de limpeza, testes de atualização e mutabilidade, e o limite entre threads.
Escreva pelo menos 280 caracteres (0/280).
Resumo
Use cache como uma decisão de contrato e de medição, não como um atalho automático de desempenho.
maxsize pelo padrão de reutilização e pelo orçamento de memória; quantidade de entradas não equivale a bytes.cache_clear() antes de consultas que precisem de dados atuais.Parabéns! Você concluiu: Controlar tempo e memória de caches com lru_cache
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks