Passo 1 de 9
Definir uma comparação válida
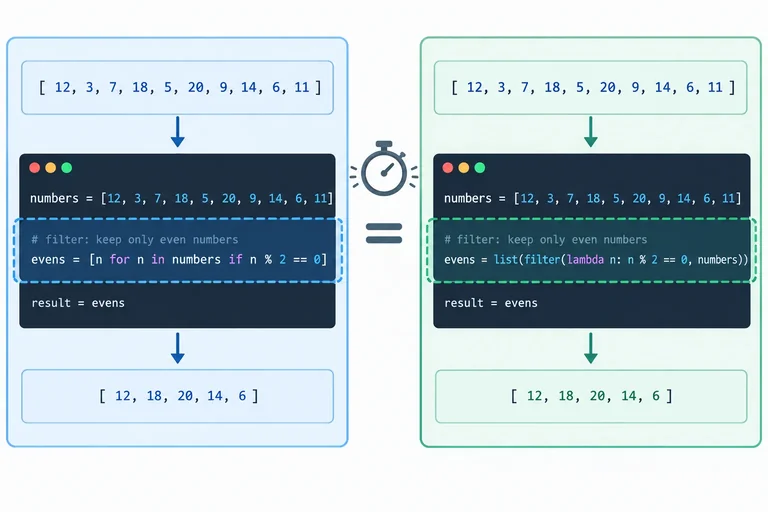
Antes de cronometrar, defina exatamente o que será comparado, confirme que as alternativas cumprem o mesmo contrato e escolha entradas representativas.
Trilha de aprendizado · Nível 14 · Tutorial 2
Construa medições repetíveis de pequenas operações e compare implementações equivalentes sem confundir preparação, execução e variação do ambiente.
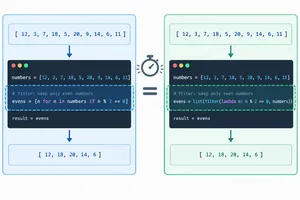 Definir uma comparação válida
Antes de cronometrar, defina exatamente o que será comparado, confirme que as alternativas cumprem o mesmo contrato e escolha entradas representativas. 2 min
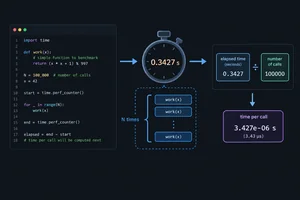 Medir e calcular o tempo por execução
Meça um lote com timeit.Timer e transforme a duração total em um tempo comparável por chamada. 3 min
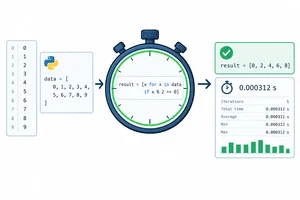 Separar preparação e trabalho medido
Defina a fronteira do microbenchmark para medir exatamente o custo que responde à sua pergunta. 2 min
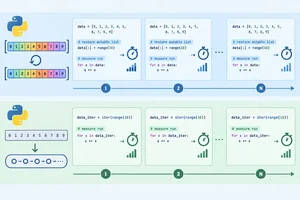 Repetir sem mudar a quantidade de trabalho
Mantenha o estado de cada execução equivalente para que um lote do timeit meça a mesma operação repetidamente. 3 min
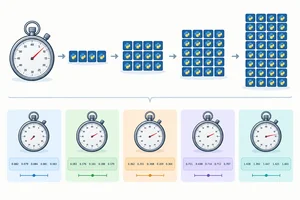 Calibrar o lote e repetir as medições
Calibre a quantidade de execuções e colete vários tempos comparáveis para a mesma operação. 3 min
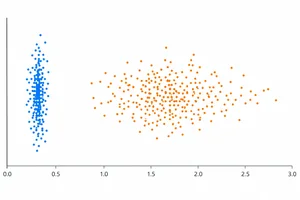 Interpretar os resultados sem inventar certeza
Compare séries normalizadas, resuma mínimo, mediana e dispersão e formule conclusões restritas ao que foi medido. 3 min
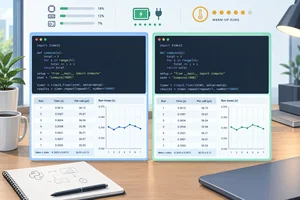 Controlar o ambiente da comparação
Reduza interferências externas, aplique um protocolo igual às alternativas e registre o contexto da medição. 2 min
 Decidir como tratar a coleta cíclica
Entenda a política do timeit para a coleta cíclica e escolha uma configuração coerente para comparar alternativas. 2 min
 Aplicação final: comparar e justificar
Execute um experimento completo no seu computador e formule uma conclusão limitada às condições que você mediu. 3 min
Passo 1 de 9
Antes de cronometrar, defina exatamente o que será comparado, confirme que as alternativas cumprem o mesmo contrato e escolha entradas representativas.
Um microbenchmark mede um trecho delimitado de código sob condições escolhidas. Ele complementa a análise por notação O grande: duas soluções com a mesma ordem de crescimento ainda podem ter tempos concretos diferentes para uma entrada específica.
Neste tutorial, a pergunta será: para a mesma lista de números já disponível, qual implementação filtra os valores não negativos mais rapidamente? Isso não responde, por si só, qual delas torna a aplicação inteira mais rápida.
A preparação da lista e a apresentação do resultado ficam fora da pergunta inicial; apenas a filtragem será comparada.
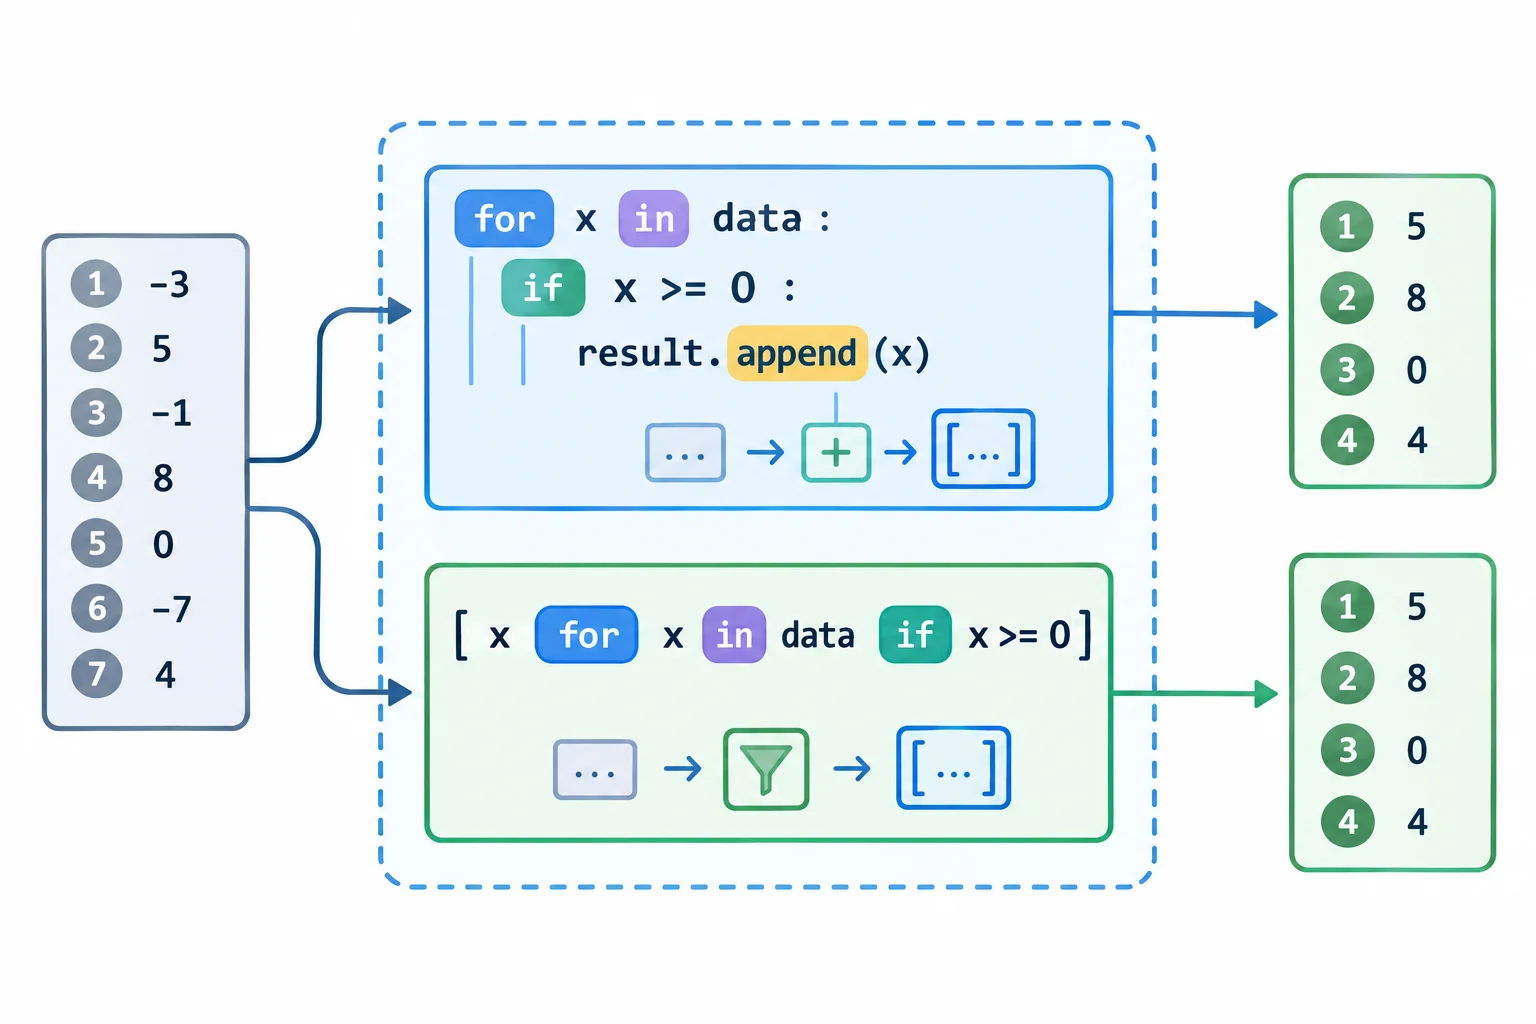
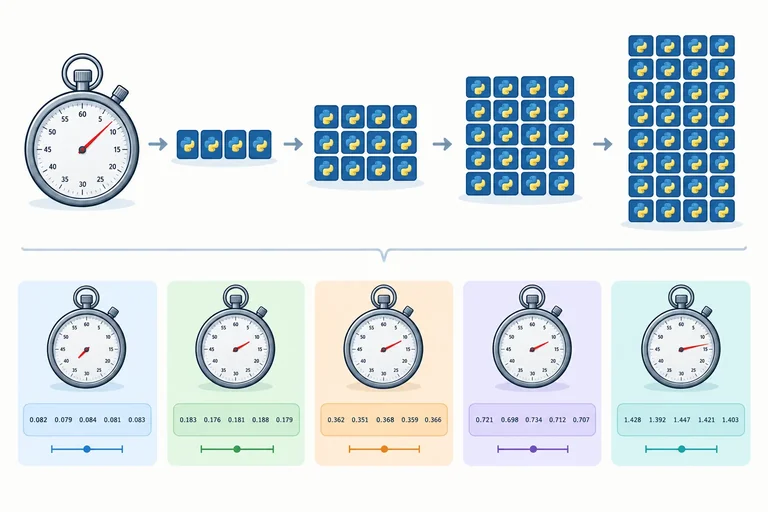
Uma medição útil começa ao separar entrada, operação observada e resultado.
Escolha uma linha de base: uma implementação de referência, clara e correta. Depois compare uma alternativa que produza o mesmo resultado sob o mesmo contrato.
Aqui, filtrar_com_laco é a linha de base; filtrar_com_compreensao é a alternativa. Antes de qualquer medição, verifique o resultado, a ordem dos itens, a multiplicidade e se a entrada foi preservada quando isso fizer parte do contrato.
Execute este código em um arquivo Python no seu computador para confirmar a equivalência.
def filtrar_com_laco(numeros):
    resultado = []
    for numero in numeros:
        if numero >= 0:
            resultado.append(numero)
    return resultado


def filtrar_com_compreensao(numeros):
    return [numero for numero in numeros if numero >= 0]


numeros = [-3, 0, 2, -1, 2, 5]
original = numeros.copy()

resultado_base = filtrar_com_laco(numeros)
resultado_alternativa = filtrar_com_compreensao(numeros)

assert resultado_base == resultado_alternativa
assert numeros == original

print(resultado_base)  # [0, 2, 2, 5]
Exemplo
A igualdade das listas confirma valores, ordem e repetições: os dois 2 continuam presentes. A cópia original permite confirmar que nenhuma função modificou numeros. Se o contrato aceitasse outra ordem ou eliminasse duplicatas, o teste de equivalência precisaria refletir essa regra.
Use entradas determinísticas: ao executar de novo, você deve conseguir usar os mesmos dados. Varie características relevantes da pergunta, como tamanho e distribuição dos valores.
Para este filtro, inclua ao menos: lista vazia, lista sem valores selecionados, lista com todos os valores selecionados e uma lista mista. Assim você verifica a correção antes de medir cenários maiores.
Estes casos verificam o contrato em situações distintas.
casos = [
    [],
    [-4, -1, -9],
    [0, 3, 8],
    [-2, 0, 5, -1, 5],
]

for numeros in casos:
    original = numeros.copy()
    esperado = filtrar_com_laco(numeros)
    obtido = filtrar_com_compreensao(numeros)

    assert obtido == esperado
    assert numeros == original

print("Alternativas equivalentes nos casos definidos.")
Dica
Não altere a entrada depois de ver qual alternativa parece melhor. Registre o tamanho e a distribuição escolhidos; uma conclusão honesta sempre vale apenas para os cenários que foram comparados.
Qual desenho é adequado para comparar as duas funções de filtragem?
Passo 2 de 9
Meça um lote com timeit.Timer e transforme a duração total em um tempo comparável por chamada.
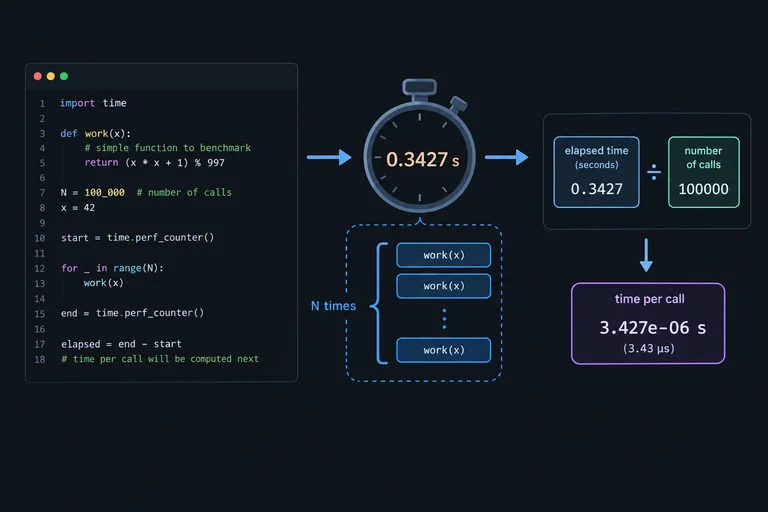
No seu computador, o módulo padrão timeit mede uma operação repetida. Crie um Timer com uma função sem argumentos: ela deve executar exatamente o trecho que você decidiu comparar.
Timer.timeit(number=...) executa essa função number vezes e devolve a duração total do lote, em segundos. O retorno não é o resultado da função e também não é, ainda, o tempo de uma execução.
A duração retornada abrange todas as execuções solicitadas.
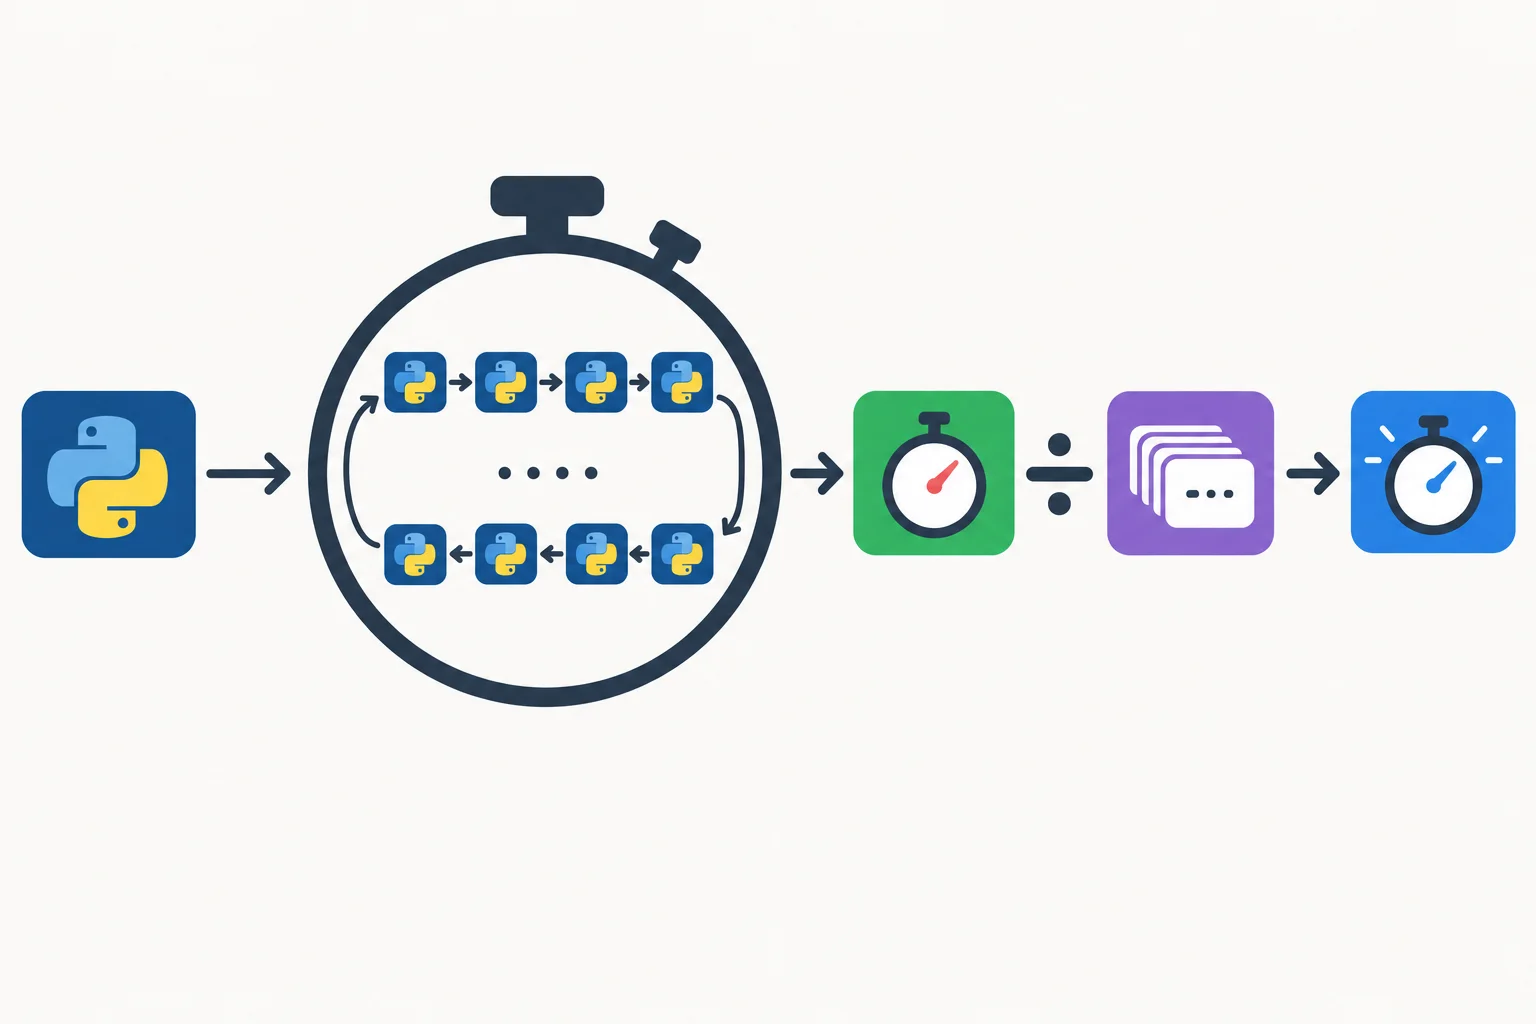
Tempo por execução = tempo total do lote ÷ número de execuções.
Salve e execute este script com Python no seu computador.
import timeit


def filtrar_com_laco(numeros):
    resultado = []
    for numero in numeros:
        if numero >= 0:
            resultado.append(numero)
    return resultado


def filtrar_com_compreensao(numeros):
    return [numero for numero in numeros if numero >= 0]


numeros = list(range(-500, 500))

# A equivalência foi definida e verificada antes da medição.
assert filtrar_com_laco(numeros) == filtrar_com_compreensao(numeros)

number = 10_000

timer_laco = timeit.Timer(lambda: filtrar_com_laco(numeros))
total_laco = timer_laco.timeit(number=number)

# A forma de chamada é equivalente: uma função sem argumentos por alternativa.
timer_compreensao = timeit.Timer(lambda: filtrar_com_compreensao(numeros))
total_compreensao = timer_compreensao.timeit(number=number)

por_chamada_laco = total_laco / number
por_chamada_compreensao = total_compreensao / number

print(f"Laço: {por_chamada_laco * 1_000_000:.2f} µs por execução")
print(f"Compreensão: {por_chamada_compreensao * 1_000_000:.2f} µs por execução")
Dica
A chamada da função faz parte do trecho medido nos dois casos. Não meça uma alternativa chamando a função e a outra executando um trecho diferente: a sobrecarga precisa ser comparável.
Divida sempre o total retornado por number:
tempo_por_execucao = tempo_total / number
A unidade inicial é segundo por execução. Para exibir o resultado:
1_000;1_000_000.Escolha uma única unidade para as alternativas da mesma comparação.
Um lote de number = 20_000 execuções levou 0,080 segundo. Complete a expressão para obter segundos por execução:
por_execucao = 0.080 / ____
Também existe a conveniência timeit.timeit(lambda: operacao(), number=number), que retorna o mesmo tipo de total. Neste tutorial, mantenha Timer como interface principal: ela deixa explícito qual operação está sendo cronometrada e será reutilizada nas próximas etapas.
Execute o script. Informe o number usado, a unidade escolhida e os dois tempos por execução que apareceram. Seus valores não precisam coincidir com os de outras máquinas.
Escreva pelo menos 40 caracteres (0/40).
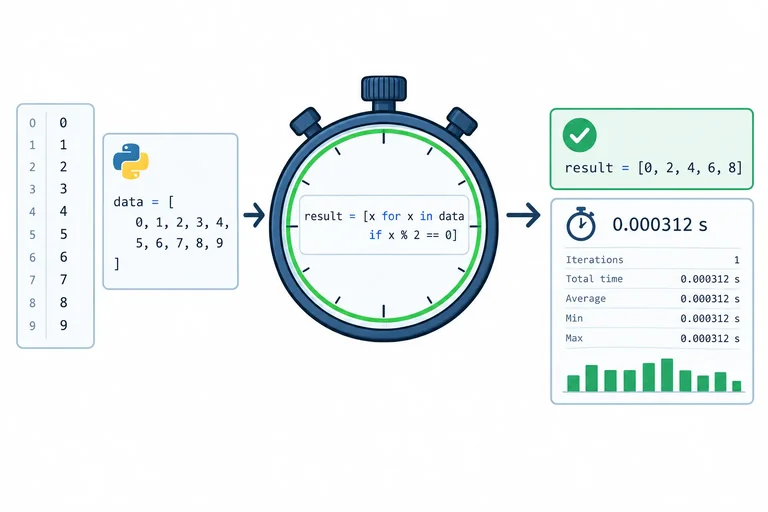
Passo 3 de 9
Defina a fronteira do microbenchmark para medir exatamente o custo que responde à sua pergunta.
Um microbenchmark mede apenas o trecho escolhido. Se a pergunta for “quanto custa filtrar dados que já estão disponíveis?”, crie os dados antes e cronometre somente a chamada da função.
Deixe testes de equivalência, assert e print fora do trecho: eles verificam ou apresentam o resultado, mas não fazem parte da operação comparada.
A fronteira do cronômetro envolve apenas a operação escolhida.
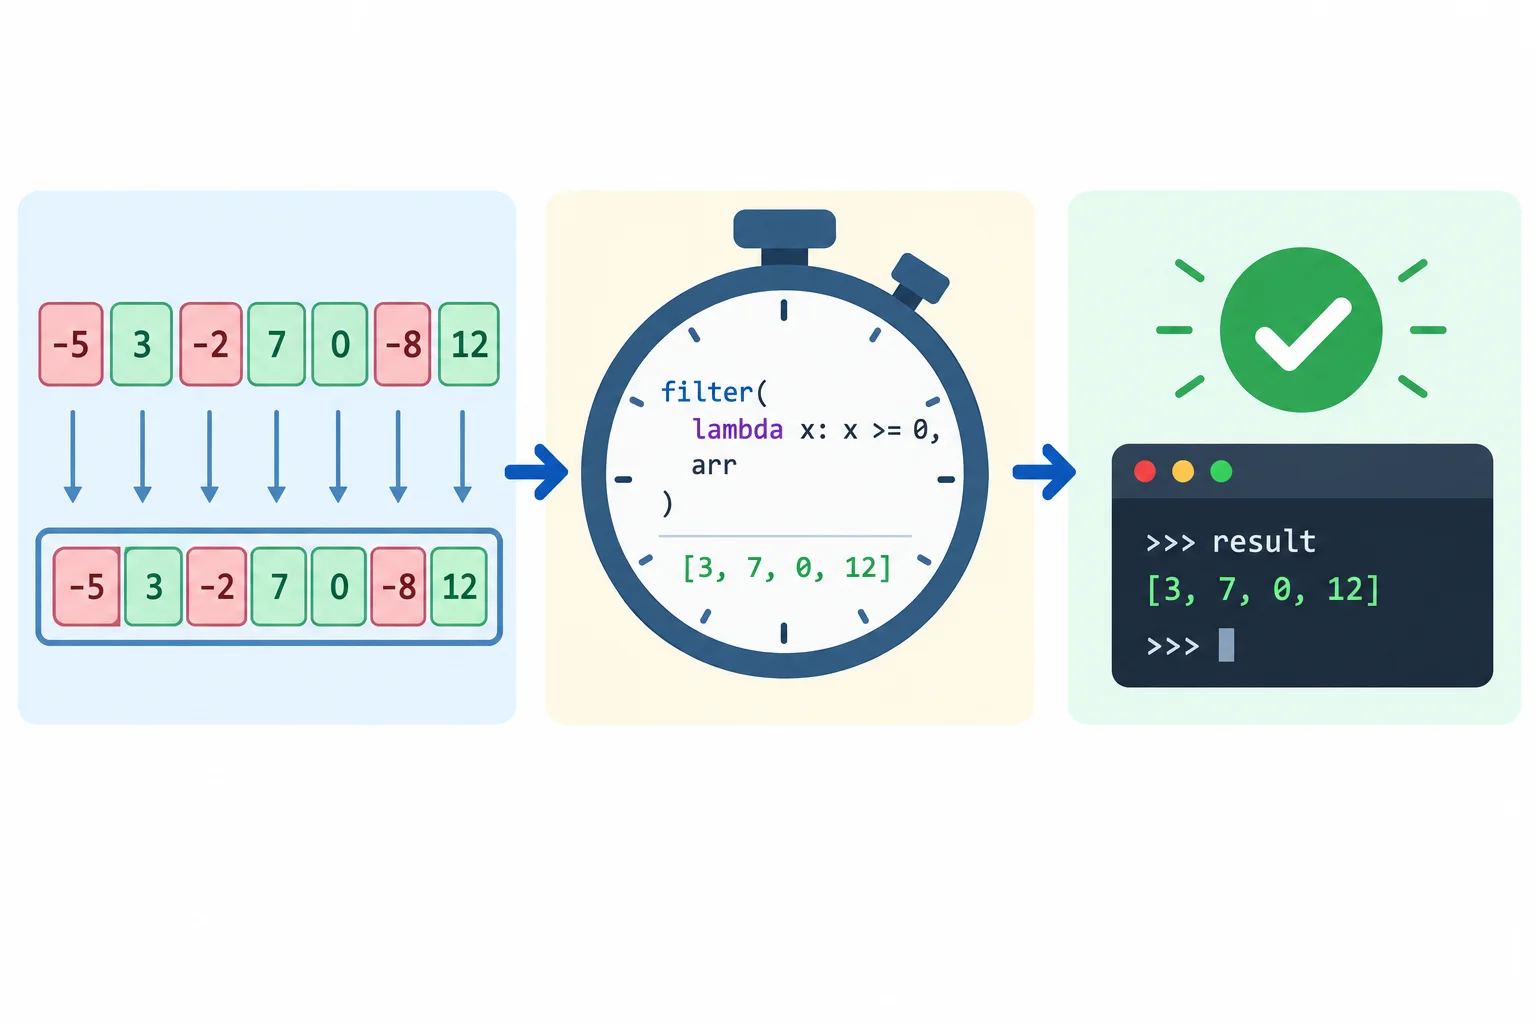
Preparação e validação ficam fora quando a pergunta mede somente a operação sobre uma entrada já disponível.
Dica
Se o cenário real exige construir ou transformar a entrada a cada chamada, essa construção pertence ao trecho medido. Registre essa escolha: dois benchmarks só respondem à mesma pergunta quando têm a mesma fronteira.
Com Timer, você pode fornecer stmt e setup como textos. O setup é executado uma vez no início de cada medição de lote, antes do intervalo cronometrado — não uma vez para cada execução interna definida por number.
O dicionário globals torna funções e outros nomes do script disponíveis explicitamente para o código textual.
Salve como um script Python e execute no seu computador.
from timeit import Timer


def filtrar_laco(valores):
    resultado = []
    for valor in valores:
        if valor >= 0:
            resultado.append(valor)
    return resultado


def filtrar_compreensao(valores):
    return [valor for valor in valores if valor >= 0]

# Validação: fora da medição.
caso_teste = [-2, 0, 4, -1, 4]
assert filtrar_laco(caso_teste) == filtrar_compreensao(caso_teste)

# setup cria a entrada uma vez para este lote.
timer = Timer(
    stmt="filtrar_laco(valores)",
    setup="valores = list(range(-500, 500))",
    globals={"filtrar_laco": filtrar_laco},
)

number = 10_000
total = timer.timeit(number=number)
print(f"{total / number * 1_000_000:.2f} µs por execução")
Exemplo
Se a pergunta for “quanto custa receber valores em texto, convertê-los e filtrá-los?”, a conversão deve estar em stmt, pois ocorre em cada execução:
stmt="filtrar_laco([int(x) for x in texto.split(',')])"
Nesse caso, disponibilize texto em globals ou crie-o no setup. Não compare esse total diretamente com uma medição que recebe uma lista já pronta: são perguntas diferentes.
Associe cada ação à sua função e frequência nesse cenário: “Quanto custa filtrar uma lista que já está disponível?”
Toque em um item e depois no par correspondente.
Passo 4 de 9
Mantenha o estado de cada execução equivalente para que um lote do timeit meça a mesma operação repetidamente.
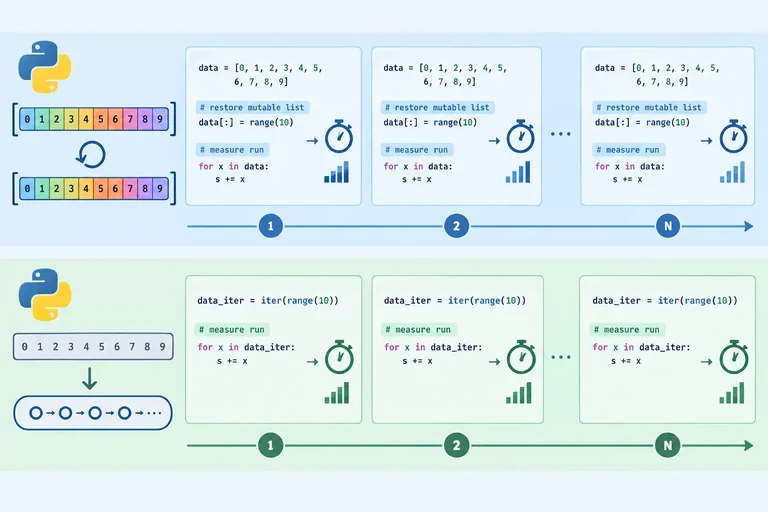
Em um microbenchmark, não basta chamar a mesma expressão várias vezes: cada chamada precisa receber um estado comparável. Se a operação modifica uma lista ou consome um iterador, as execuções seguintes podem fazer menos trabalho — ou trabalho diferente — da primeira.
Isso produz tempos que parecem bons, mas não respondem à pergunta original.
Listas mutáveis podem ser transformadas; iteradores avançam até se esgotar.
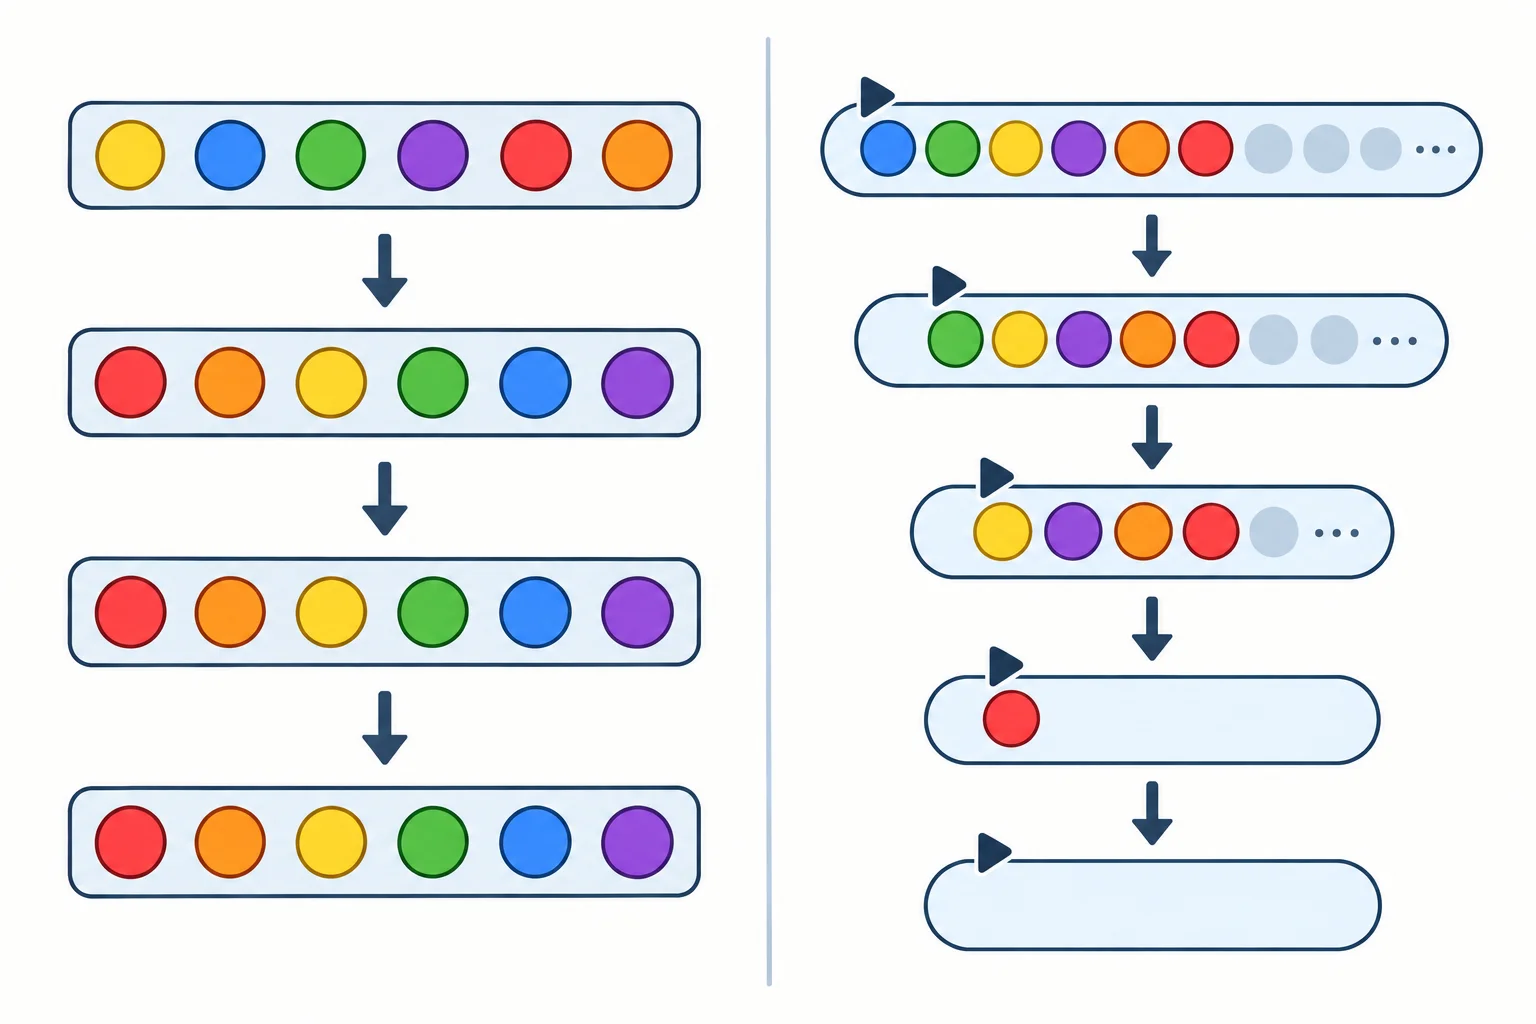
A entrada deve representar o mesmo cenário em cada execução interna do lote.
Atenção
O setup do timeit é executado uma vez antes do lote cronometrado, não antes de cada uma das execuções internas. Portanto, criar uma lista no setup não resolve uma operação que a modifica repetidamente dentro do mesmo lote.
No exemplo inválido abaixo, a primeira chamada altera dados. As chamadas posteriores recebem uma lista que já está ordenada. Como ordenar uma lista já ordenada pode ter comportamento diferente, o lote não mede repetições equivalentes.
A lista é criada uma única vez e depois alterada pelo próprio trecho medido.
from timeit import Timer

dados = [7, 2, 9, 1, 5]

# Inválido para representar a ordenação da mesma entrada original.
tempo_total = Timer("dados.sort()", globals={"dados": dados}).timeit(number=10_000)
print(tempo_total)Cada chamada começa com uma cópia da mesma lista-base. A cópia faz parte do tempo, pois é necessária para cumprir esse cenário.
from timeit import Timer

base = [7, 2, 9, 1, 5]

def ordenar_copia():
    dados = base.copy()
    dados.sort()

numero = 10_000
tempo_total = Timer(ordenar_copia).timeit(number=numero)
print(f"{tempo_total / numero:.9f} s por execução")
Dica
Este código mede “copiar a entrada e ordená-la”, não apenas list.sort(). Se o cenário real já entrega uma lista descartável para ordenar, use uma operação que recrie esse estado de forma compatível e registre essa fronteira.
Uma fonte obtida com iter(...), um gerador ou uma expressão geradora avança quando é percorrida. Depois de consumida, não contém mais os mesmos itens. Além disso, criar um resultado preguiçoso não é o mesmo que processar seus valores.
Se a pergunta é sobre o processamento, consuma o resultado e crie uma fonte nova dentro da função medida.
sum força o consumo dos valores produzidos. Como range cria uma fonte nova a cada chamada, cada execução processa os mesmos 1.000 valores.
from timeit import Timer

def somar_quadrados():
    fonte = iter(range(1_000))
    return sum(valor * valor for valor in fonte)

numero = 10_000
tempo_total = Timer(somar_quadrados).timeit(number=numero)
print(f"{tempo_total / numero:.9f} s por execução")
Atenção
Cronometrar apenas iter(range(1_000)) ou uma expressão geradora mede principalmente a criação do iterador. Para investigar o custo de processar os dados, inclua um consumidor, como sum, list ou um laço que realize o trabalho definido pelo cenário.
Considere este trecho:
fonte = iter(range(1_000))
Timer("sum(x * x for x in fonte)", globals={"fonte": fonte}).timeit(number=10_000)
Por que ele não mede 10.000 processamentos equivalentes? Descreva uma correção e diga se o custo de recriar a fonte entra ou não na medição.
Escreva pelo menos 120 caracteres (0/120).
Passo 5 de 9
Calibre a quantidade de execuções e colete vários tempos comparáveis para a mesma operação.
Timer.autorange() tenta valores crescentes de number até que um lote dure aproximadamente 0,2 segundo ou mais. Ele retorna uma tupla: number escolhido e a duração total daquele lote em segundos.
A calibração executa de verdade a operação. Portanto, a função cronometrada continua precisando criar um estado renovado quando trabalha com dados mutáveis ou fontes consumíveis. Para dados imutáveis, como a tupla do exemplo, reutilizar a entrada é seguro.
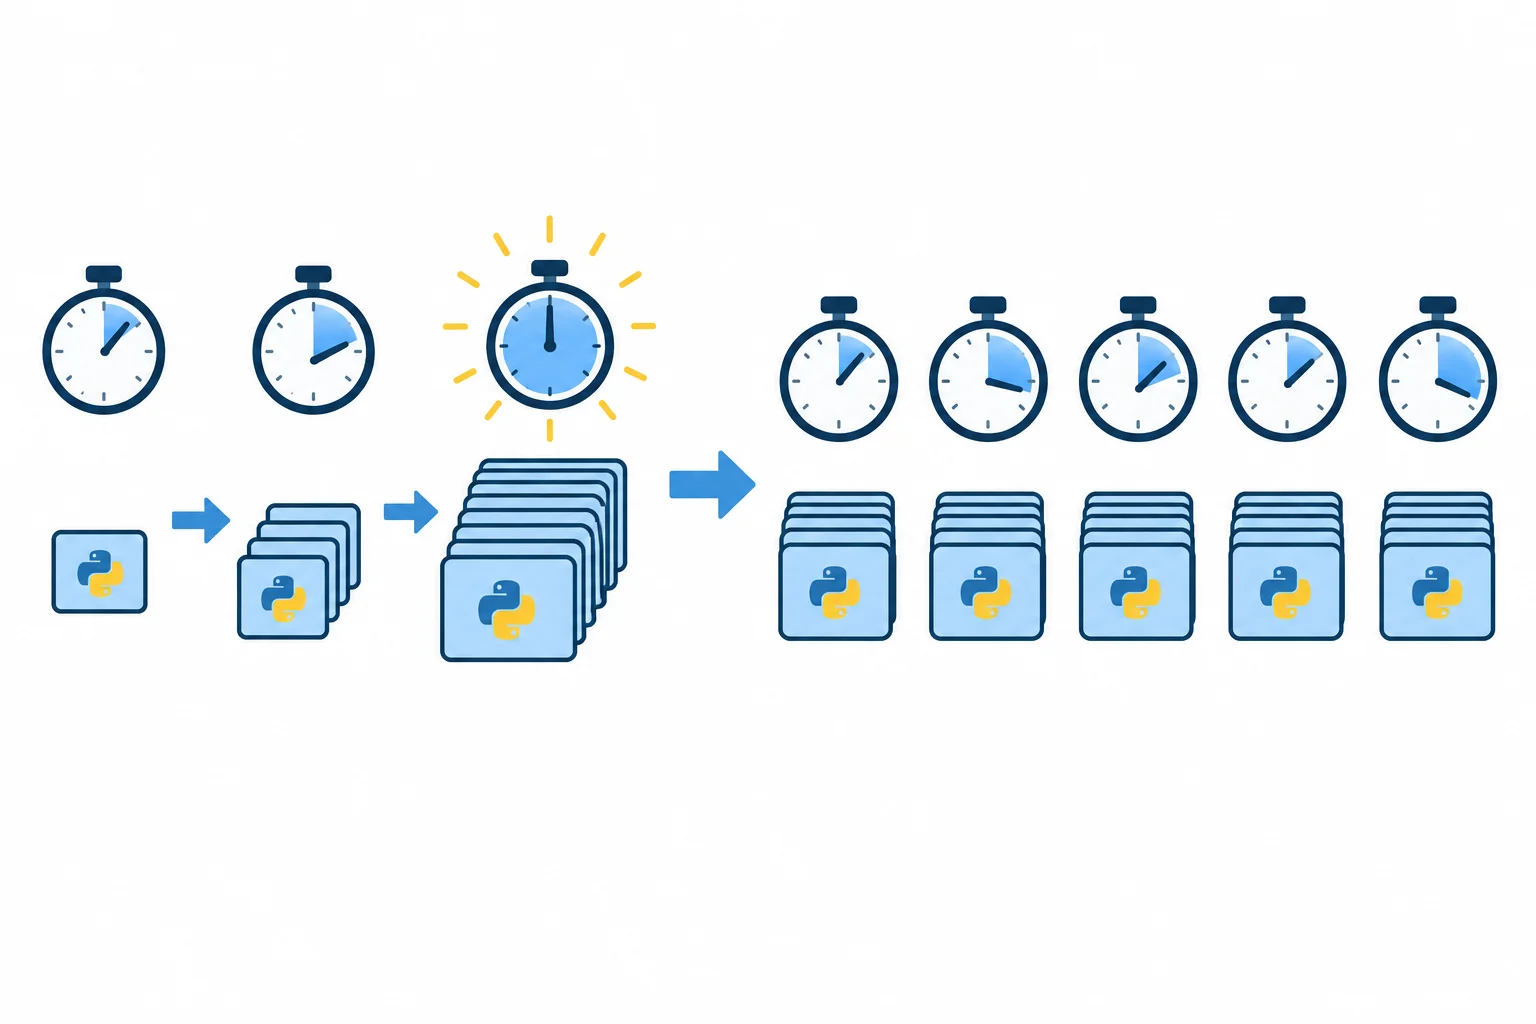
autorange() define o número de execuções; depois, repeat() coleta vários totais usando esse mesmo número.
Em timer.repeat(repeat=5, number=number), number é a quantidade de execuções dentro de cada medição. Já repeat é a quantidade de medições separadas coletadas.
As medições ocorrem no mesmo processo: repeat() não reinicia o Python e não transforma os resultados em observações estatisticamente independentes. Por enquanto, trate a lista como várias leituras da mesma configuração.
from timeit import Timer


def filtrar_laco(valores):
    resultado = []
    for valor in valores:
        if valor >= 0:
            resultado.append(valor)
    return resultado


# Entrada determinística e imutável: cada chamada recebe os mesmos valores.
dados = tuple(range(-500, 500))
timer = Timer(lambda: filtrar_laco(dados))

number, total_calibracao = timer.autorange()
totais = timer.repeat(repeat=5, number=number)
tempos_por_execucao = [total / number for total in totais]

print(f"Calibração: {number} execuções em {total_calibracao:.6f} s")
print("Totais dos lotes:", totais)
print("Segundos por execução:", tempos_por_execucao)
Dica
timeit.repeat(stmt, setup, repeat, number, globals) oferece a forma de conveniência. Quando você precisa calibrar com autorange() e repetir usando a mesma configuração, manter um objeto Timer torna o fluxo mais direto.
Cada elemento devolvido por repeat() é o tempo total de um lote com number execuções — não o tempo de uma chamada. Normalize cada leitura: total / number.
Se duas alternativas receberam valores de number diferentes na calibração, seus totais brutos não são comparáveis. Compare os respectivos tempos por execução, na mesma unidade.
Exemplo
Alternativa A: number = 1_000_000, total = 0,80 s → 0,80 / 1_000_000 = 0,8 µs por execução.
Alternativa B: number = 500_000, total = 0,50 s → 0,50 / 500_000 = 1,0 µs por execução.
Embora o total de B seja menor, A teve menor tempo por execução. A conclusão ainda depende de resultados repetidos, que serão interpretados no próximo step.
Coloque as etapas na ordem adequada para coletar tempos por execução.
Em timer.repeat(repeat=5, number=200_000), o parâmetro que define quantas medições separadas serão coletadas é ___.
Passo 6 de 9
Compare séries normalizadas, resuma mínimo, mediana e dispersão e formule conclusões restritas ao que foi medido.
Após normalizar cada total pelo mesmo number, compare os tempos por execução das alternativas na mesma unidade e escala — por exemplo, microssegundos por chamada.
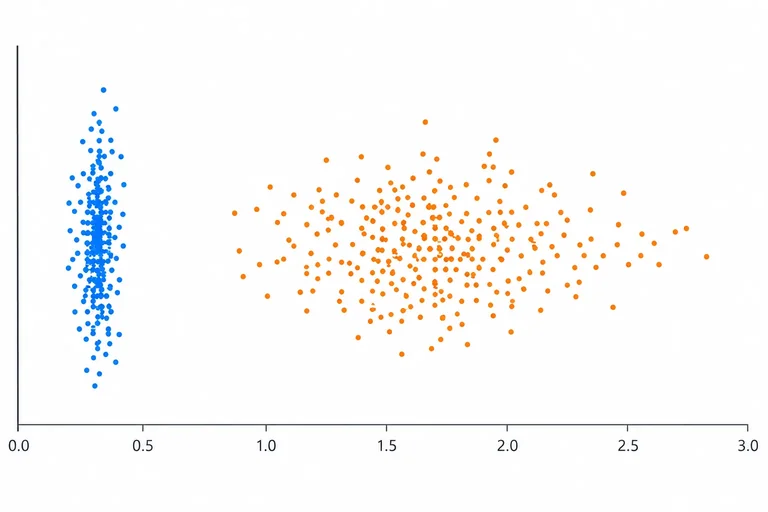
Uma lista de medições mostra mais do que um único resumo: revela se os pontos de uma alternativa ficam consistentemente abaixo dos da outra ou se se misturam. Essa leitura só vale se as funções produziram resultados equivalentes e realizaram a mesma quantidade de trabalho.
Cada ponto representa uma medição normalizada. À esquerda há uma separação consistente; à direita, as faixas se sobrepõem.
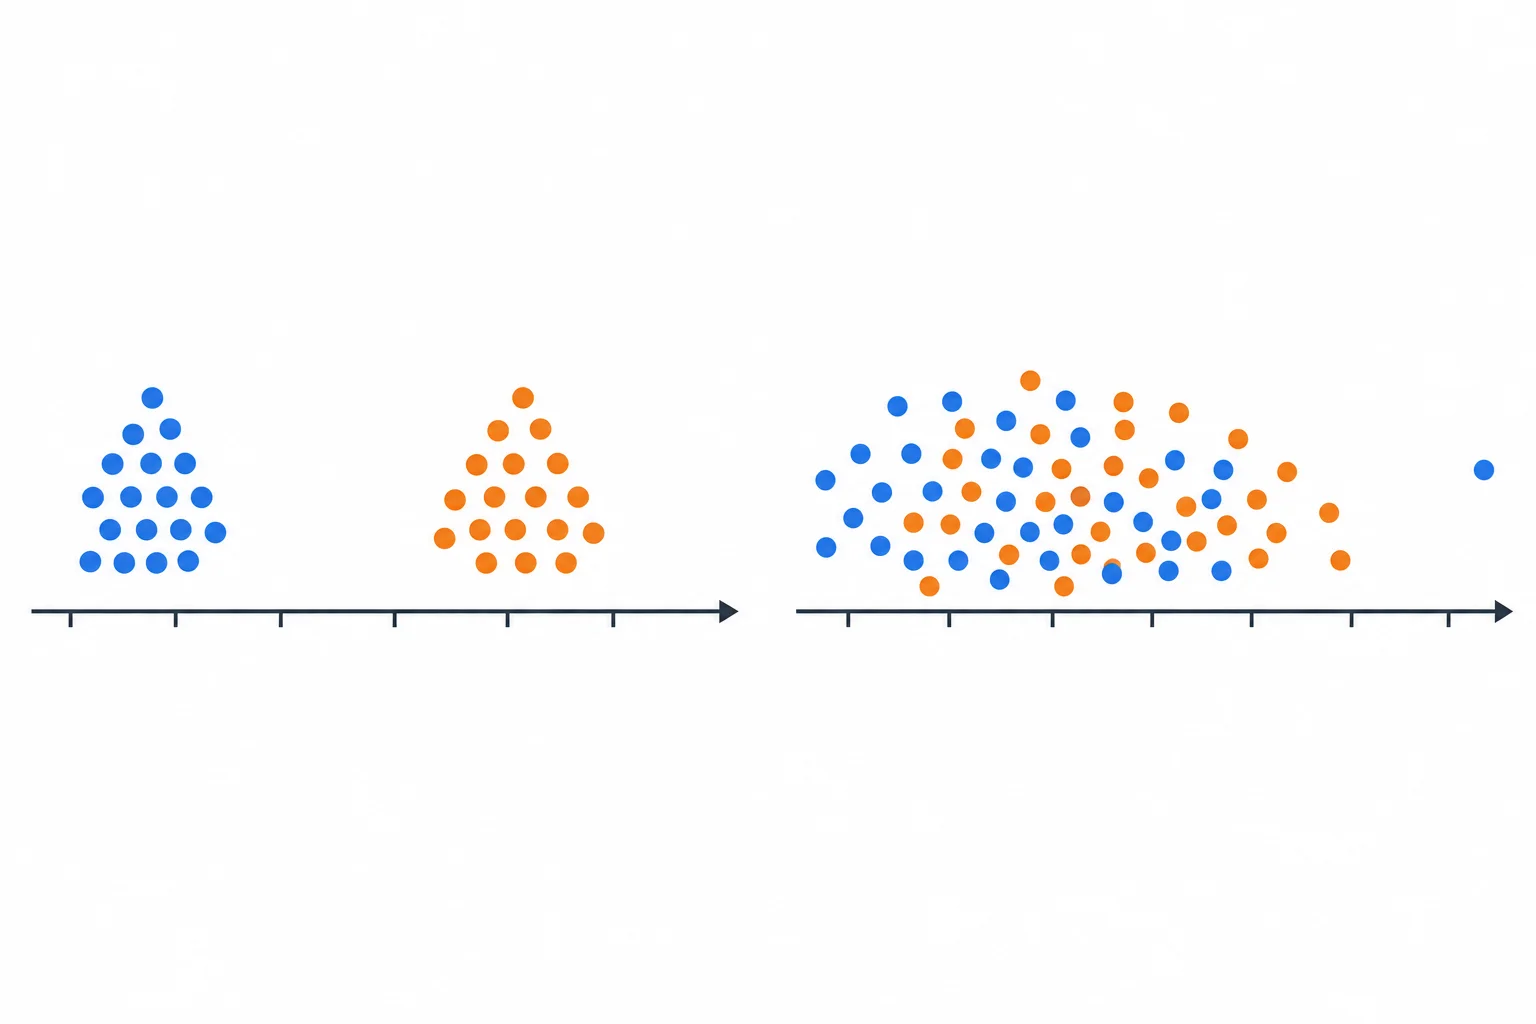
Separação consistente é evidência mais útil do que uma diferença isolada; sobreposição e espalhamento pedem cautela.
O mínimo é uma estimativa da execução menos afetada por interferências ocasionais, mas não prova uma velocidade garantida. Ele só é útil quando o trabalho medido é válido e equivalente.
A mediana descreve o centro da série: metade dos tempos fica abaixo dela e metade acima. A amplitude (máximo - mínimo) torna visível a dispersão. Leia os três juntos: mínimo e mediana resumem posições; a amplitude revela quanto as medições variaram.
Os valores abaixo já são tempos por execução, em microssegundos.
from statistics import median

laco_us = [8.1, 8.0, 8.2, 8.1, 8.0]
compreensao_us = [7.5, 7.6, 7.5, 7.7, 7.6]

def resumir(nome, tempos):
    minimo = min(tempos)
    centro = median(tempos)
    amplitude = max(tempos) - min(tempos)
    print(
        f"{nome}: mínimo={minimo:.1f} µs, "
        f"mediana={centro:.1f} µs, "
        f"amplitude={amplitude:.1f} µs"
    )

resumir("laço", laco_us)
resumir("compreensão", compreensao_us)
Exemplo
A compreensão tem mínimo de 7,5 µs, mediana de 7,6 µs e amplitude de 0,2 µs. O laço tem mínimo de 8,0 µs, mediana de 8,1 µs e amplitude de 0,2 µs. Neste conjunto de entradas e condições, a compreensão foi mais rápida de forma consistente nas medições exibidas.
Considere A = [7,4, 10,2, 7,6, 10,0, 7,5] µs e B = [7,8, 7,9, 8,0, 7,9, 8,0] µs. A tem mínimo menor, mas também grande dispersão; sua mediana é 7,6 µs, enquanto a de B é 7,9 µs.
A diferença dos centros é pequena diante da instabilidade de A. Uma conclusão defensável é: nestas rodadas, a evidência é insuficiente para afirmar uma vantagem consistente. Isso não demonstra que A e B sejam iguais, nem estabelece significância estatística.
Mesmo uma vantagem consistente fica limitada às entradas, à versão do código e às condições que você mediu. Não é uma promessa sobre toda a aplicação.
Dica
Prefira: “Para estas entradas medidas, a alternativa X apresentou menor mediana e menor mínimo.” Evite: “X sempre é mais rápida.”
Duas implementações equivalentes foram medidas nas mesmas entradas, em µs por execução:
[7,4, 10,2, 7,6, 10,0, 7,5][7,8, 7,9, 8,0, 7,9, 8,0]Qual conclusão é mais defensável?
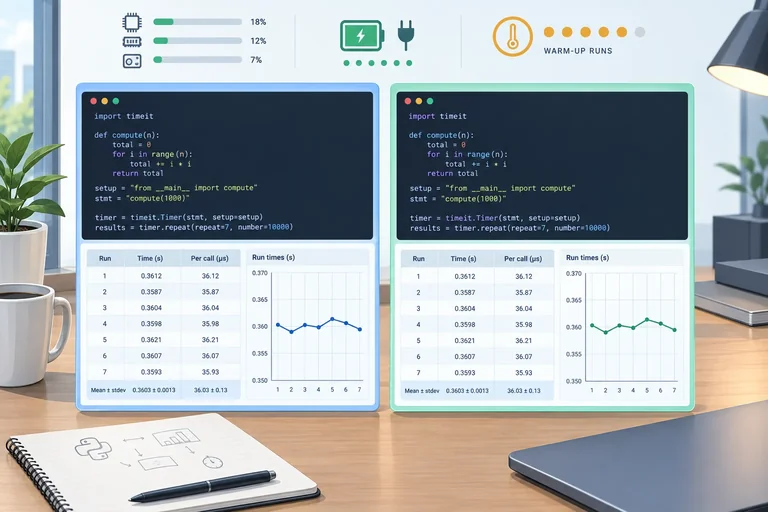
Passo 7 de 9
Reduza interferências externas, aplique um protocolo igual às alternativas e registre o contexto da medição.
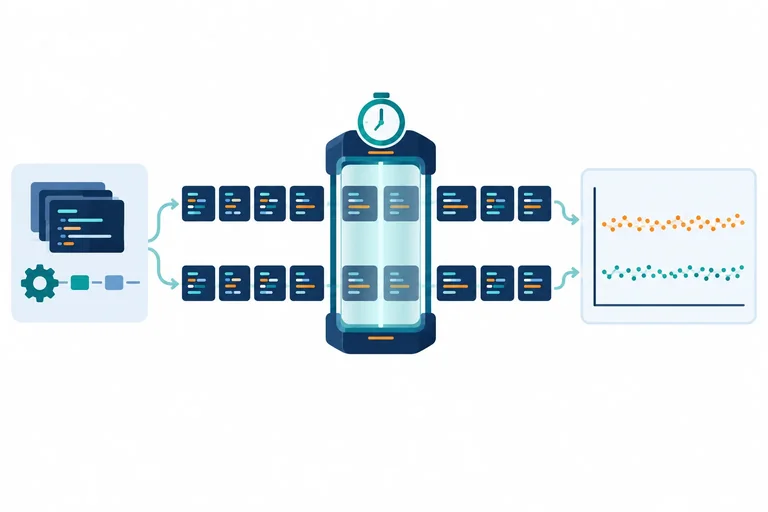
O tempo de um lote não depende só do código. Processos concorrentes, carga do sistema e condições de energia podem disputar recursos e alterar os valores observados.
Antes de comparar, feche tarefas pesadas que não fazem parte do experimento, evite rodar sob depurador ou perfilador e mantenha as alternativas sobre entradas equivalentes. Isso reduz interferências; não torna duas rodadas, nem duas máquinas, perfeitamente idênticas.
A ilustração relaciona o trecho medido a fatores externos que podem deslocar seus tempos.
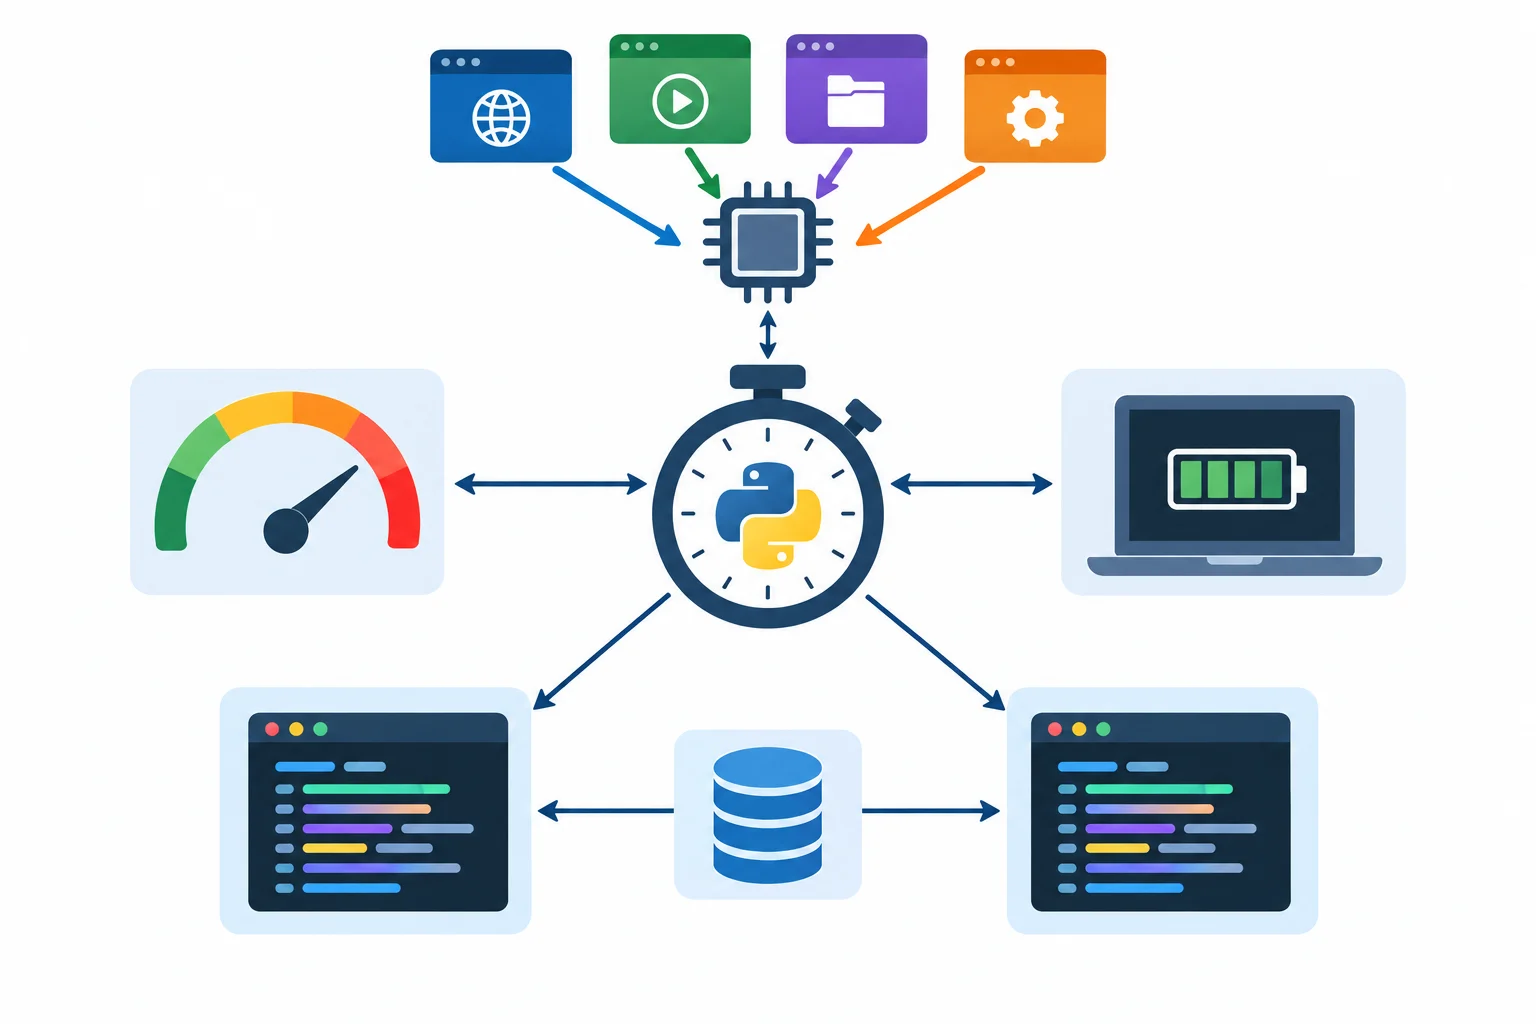
Controle o que for possível e registre o restante: a variação não desaparece por completo.
Dica
Se a comparação for importante, execute as alternativas na mesma máquina, na mesma sessão e sem outras tarefas intencionalmente pesadas. Anote qualquer condição incomum que não tenha sido possível controlar.
As primeiras execuções podem se comportar diferente das execuções posteriores; esse efeito é chamado aqui de aquecimento. A calibração com autorange() já executa o trecho e pode aquecê-lo, mas não garante condições idênticas.
Defina uma política: por exemplo, calibrar cada alternativa e então usar repeat(). Aplique a mesma política e as mesmas entradas às duas. Repita a comparação também invertendo a ordem: A depois B, e em outra rodada B depois A. Assim, você pode perceber um possível efeito de ordem.
Como autorange() executa o trecho, ele sozinho garante que duas alternativas terão exatamente as mesmas condições de medição.
Ao guardar seus resultados, registre: implementação e versão do Python; sistema operacional e máquina; tamanho e distribuição das entradas; fronteira medida; política de aquecimento; number e repeat; unidade dos tempos; e se a coleta cíclica seguiu a política padrão ou foi reativada.
Esse registro não prova que o resultado vale em qualquer contexto. Ele permite interpretar o escopo da conclusão e repetir o protocolo de modo próximo.
Você mediu a alternativa A cinco vezes e depois B cinco vezes enquanto havia tarefas pesadas abertas. Os tempos de B pareceram piores. Que ajustes faria antes de concluir que B é mais lenta? Cite também informações que registraria.
Escreva pelo menos 80 caracteres (0/80).
Passo 8 de 9
Entenda a política do timeit para a coleta cíclica e escolha uma configuração coerente para comparar alternativas.
Objetos podem formar um ciclo de referências: por exemplo, A referencia B e B referencia A. Quando esse grupo deixa de ser acessível pelo restante do programa, a coleta cíclica pode recuperar esses objetos.
Por padrão, o timeit desativa temporariamente essa coleta durante o trecho cronometrado. Isso reduz uma fonte de variação em microbenchmarks comuns.
A coleta cíclica trata grupos que continuam se referenciando, mas já não são alcançáveis pelo programa.
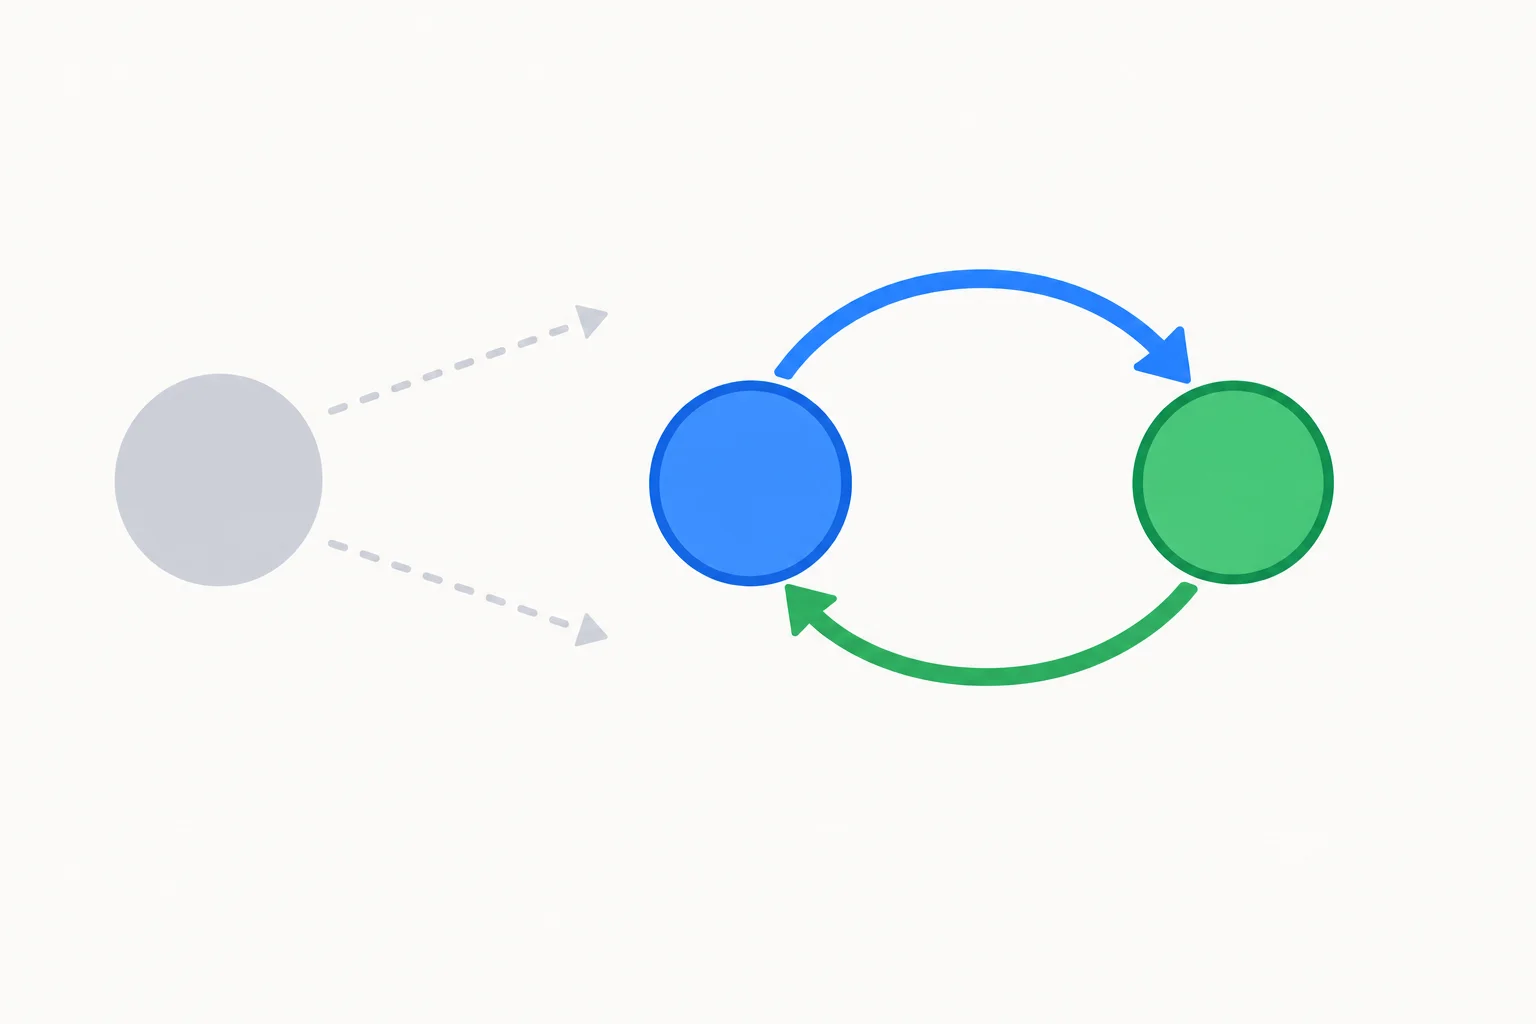
O ciclo permanece internamente conectado, embora o restante do programa não tenha mais como alcançá-lo.
Atenção
Desativar a coleta cíclica não significa que toda liberação de memória foi bloqueada. A decisão do timeit afeta especificamente esse mecanismo de recuperação de ciclos; outros comportamentos de gerenciamento de memória do interpretador não são automaticamente interrompidos.
Se o cenário que você quer representar inclui a atuação da coleta cíclica, reative-a no setup. O setup é executado fora do intervalo cronometrado, mas configura o mecanismo para o lote que será medido.
Aplique a mesma política às duas alternativas e registre essa escolha no relatório. Caso contrário, uma diferença observada pode refletir configurações diferentes, e não as implementações.
Neste exemplo, a coleta cíclica fica habilitada para a operação medida.
from timeit import Timer


def filtrar_laco(valores):
    return [valor for valor in valores if valor >= 0]


entrada = list(range(-500, 500))

timer = Timer(
    stmt="filtrar_laco(entrada)",
    setup="import gc\ngc.enable()",
    globals={
        "filtrar_laco": filtrar_laco,
        "entrada": entrada,
    },
)

total = timer.timeit(number=10_000)
print(f"{total / 10_000:.9f} s por execução")
Dica
gc.enable() apenas permite que a coleta cíclica volte a atuar. Isso não força uma coleta em cada execução — e ela pode nem ocorrer durante um lote curto. Continue interpretando os resultados como uma série sujeita a variação.
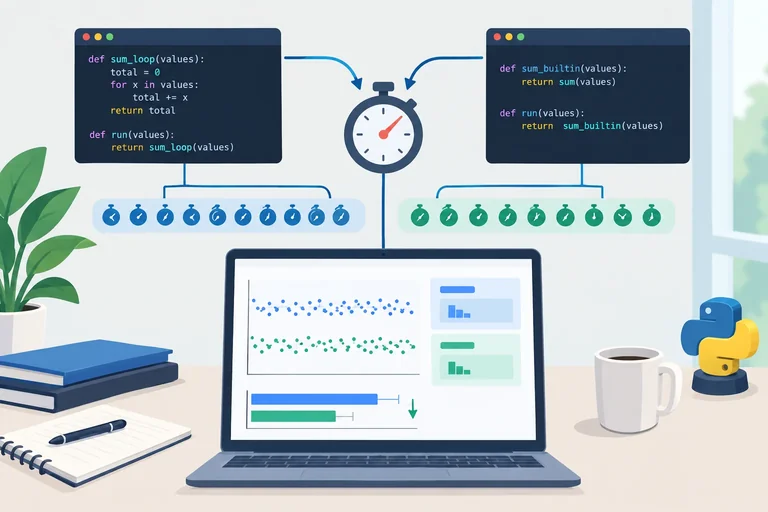
Você quer medir duas alternativas em um cenário no qual a coleta cíclica deve poder participar. Qual afirmação descreve corretamente o uso de gc.enable() no setup?
Passo 9 de 9
Execute um experimento completo no seu computador e formule uma conclusão limitada às condições que você mediu.
Crie um arquivo chamado comparar_filtros.py e execute-o com python comparar_filtros.py. O script compara duas formas equivalentes de filtrar números não negativos em quatro cenários: dois tamanhos e duas distribuições de valores.
A fronteira medida é somente a chamada da função de filtragem. As entradas são criadas antes; a verificação de equivalência, a calibração, os aquecimentos e a apresentação ficam fora do tempo de cada execução. Cada função recebe a mesma lista e apenas lê seus valores, portanto não há mutação acumulada entre execuções.
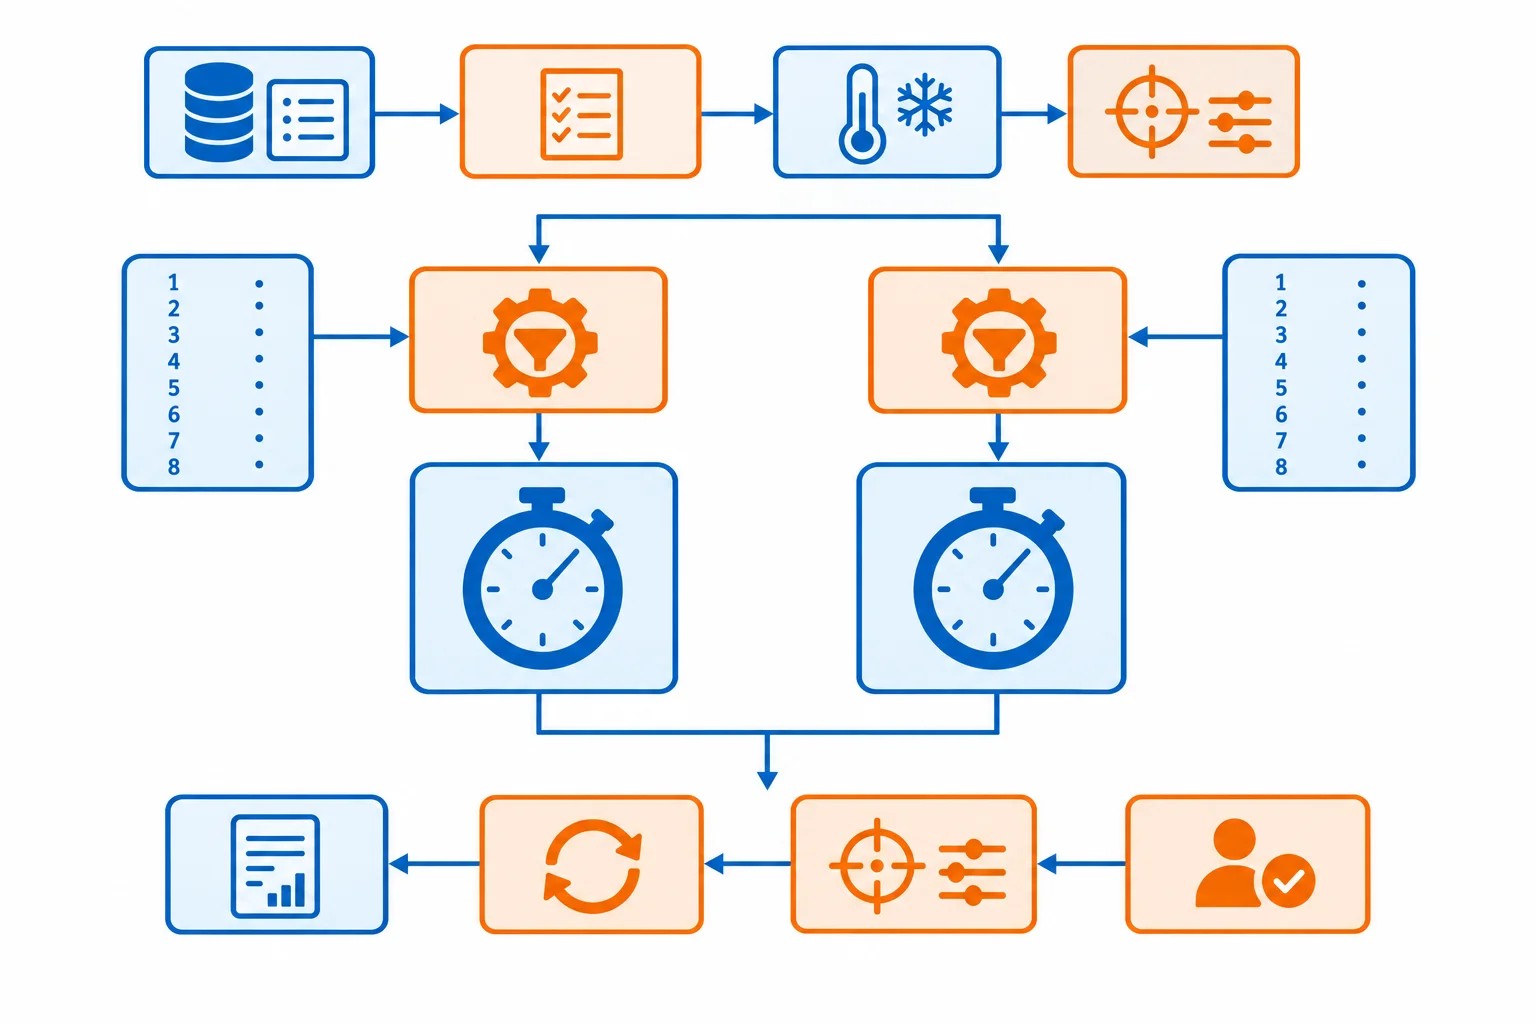
Meça a mesma operação nas duas alternativas: uma chamada de filtragem sobre dados já disponíveis.
Copie o script completo. Ele usa apenas a biblioteca padrão.
from __future__ import annotations

import gc
import platform
import statistics
import sys
import timeit


def filtrar_com_laco(numeros: list[int]) -> list[int]:
    resultado = []
    for numero in numeros:
        if numero >= 0:
            resultado.append(numero)
    return resultado


def filtrar_com_compreensao(numeros: list[int]) -> list[int]:
    return [numero for numero in numeros if numero >= 0]


def criar_entrada(tamanho: int, distribuicao: str) -> list[int]:
    if distribuicao == "alternada":
        return [indice if indice % 2 == 0 else -indice for indice in range(tamanho)]
    if distribuicao == "nenhum_selecionado":
        return [-indice - 1 for indice in range(tamanho)]
    raise ValueError(f"Distribuição desconhecida: {distribuicao}")


def medir_por_execucao(funcao, dados: list[int], aquecimentos: int = 3, repeticoes: int = 7):
    # A chamada abaixo é a fronteira medida. Dados já existem e não são alterados.
    operacao = lambda: funcao(dados)
    temporizador = timeit.Timer(operacao)

    # Mesma política de aquecimento para cada alternativa.
    for _ in range(aquecimentos):
        temporizador.timeit(number=1)

    # autorange também executa a operação; ela não pode mudar os dados reutilizados.
    number, _ = temporizador.autorange()
    totais = temporizador.repeat(repeat=repeticoes, number=number)
    tempos_us = [total / number * 1_000_000 for total in totais]
    return number, tempos_us


def resumir(tempos_us: list[float]) -> str:
    minimo = min(tempos_us)
    mediana = statistics.median(tempos_us)
    amplitude = max(tempos_us) - minimo
    return (
        f"mín={minimo:.2f} µs | mediana={mediana:.2f} µs | "
        f"amplitude={amplitude:.2f} µs"
    )


def main() -> None:
    alternativas = [
        ("laço", filtrar_com_laco),
        ("compreensão", filtrar_com_compreensao),
    ]
    cenarios = [
        (1_000, "alternada"),
        (1_000, "nenhum_selecionado"),
        (100_000, "alternada"),
        (100_000, "nenhum_selecionado"),
    ]
    repeticoes = 7

    print("Ambiente")
    print(f"Python: {sys.implementation.name} {sys.version.split()[0]}")
    print(f"Sistema: {platform.platform()}")
    print("Coleta cíclica: timeit a desativa durante cada medição")
    print("Fronteira: chamada de filtragem; criação, validação e relatório ficam fora")
    print(f"Aquecimentos por alternativa: 3 | medições por cenário: {repeticoes}\n")

    for tamanho, distribuicao in cenarios:
        dados = criar_entrada(tamanho, distribuicao)
        referencia = filtrar_com_laco(dados)
        assert filtrar_com_compreensao(dados) == referencia
        assert dados == criar_entrada(tamanho, distribuicao)

        print(f"Cenário: n={tamanho}, distribuição={distribuicao}")
        for nome, funcao in alternativas:
            number, tempos_us = medir_por_execucao(funcao, dados, repeticoes=repeticoes)
            print(f"  {nome:12} number={number:<8} {resumir(tempos_us)}")
        print()


if __name__ == "__main__":
    main()
Execute o arquivo sem depurador ou perfilador e, se possível, com pouca atividade concorrente no computador. Não compare os totais retornados por repeat: cada alternativa pode receber um number diferente após a calibração. Compare os valores já normalizados em microssegundos por execução.
O assert confirma, em cada cenário, que as saídas têm a mesma ordem e multiplicidade. A segunda verificação confirma que as funções não alteraram a entrada. Se um assert falhar, interrompa a comparação: não há base para concluir qual alternativa é mais rápida.
Dica
Uma diferença que se mantém entre mínimo e mediana, com amplitudes pequenas em relação à distância observada, é evidência local a favor de uma alternativa. Se as faixas se sobrepõem muito, se a ordem muda entre execuções ou se a diferença é pequena diante da variação, registre o resultado como inconclusivo. Isso não prova igualdade; apenas indica que este experimento não sustenta uma preferência.
Após executar o script, escreva um relatório curto sobre um dos cenários. Qual foi sua conclusão — vantagem local ou resultado inconclusivo — e quais evidências a sustentam?
Escreva pelo menos 180 caracteres (0/180).
Resumo
Use este roteiro sempre que cronometrar um trecho pequeno.
Parabéns! Você concluiu: Medir trechos de código com timeit
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks