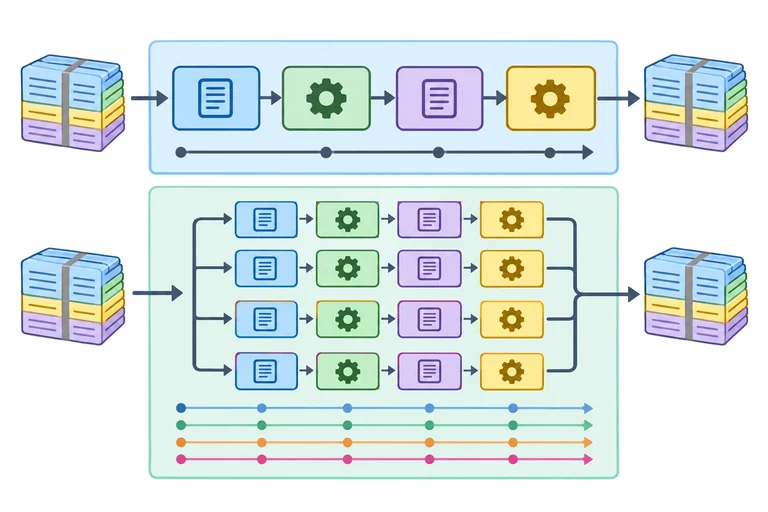
Passo 1 de 9
Definir uma comparação justa
Delimite uma carga comparável, confirme o contrato de saída e registre as condições que dão significado aos resultados.
Trilha de aprendizado · Nível 14 · Tutorial 11
Conduza uma comparação de ponta a ponta entre soluções sequenciais e concorrentes, confirmando ganhos em cargas representativas e preservando o contrato do programa.
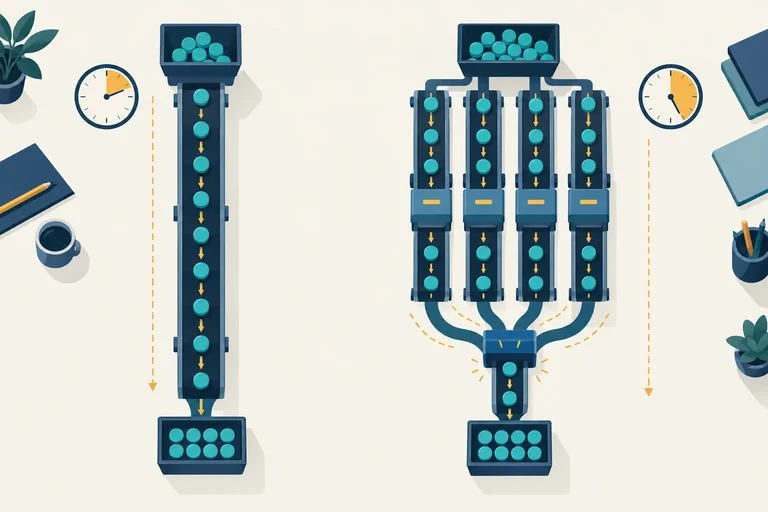
 Definir uma comparação justa
Delimite uma carga comparável, confirme o contrato de saída e registre as condições que dão significado aos resultados. 2 min
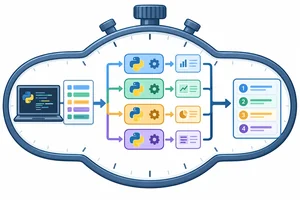 Cronometrar até o trabalho terminar
Meça uma execução completa com `time.perf_counter`, garantindo que todos os resultados tenham sido obtidos antes de parar o relógio. 3 min
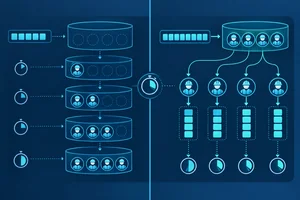 Separar inicialização de reutilização
Diferencie uma chamada concorrente isolada de um cenário com infraestrutura já ativa, declarando com precisão o que cada medição inclui. 3 min
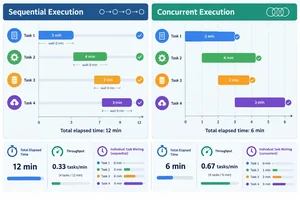 Interpretar duração, vazão e latência
Calcule métricas da carga completa e diferencie o desempenho agregado da espera percebida por cada tarefa. 2 min
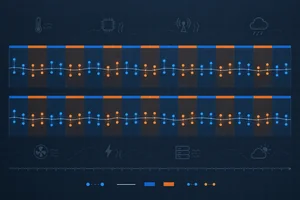 Distinguir ganho consistente de ruído
Repita comparações em condições equivalentes para decidir se uma diferença observada é evidência de ganho ou apenas variabilidade. 3 min
 Explorar volume, tarefas e lotes
Varie a granularidade da carga de forma controlada para identificar quando os custos da concorrência passam a valer a pena. 3 min
 Encontrar o limite dos trabalhadores
Varie a capacidade concorrente de forma controlada, leia curvas de duração e vazão e escolha uma configuração sustentada pelos dados. 3 min
 Validar o ganho sem perder correção ou memória
Combine testes de regressão, medições repetidas e evidências de memória antes de aceitar uma alternativa concorrente. 2 min
 Concluir a comparação e justificar a escolha
Transforme as medições e verificações em uma recomendação delimitada, verificável e útil para decidir entre a solução sequencial e a concorrente. 4 min
Passo 1 de 9
Delimite uma carga comparável, confirme o contrato de saída e registre as condições que dão significado aos resultados.
A pergunta útil não é “processos são mais rápidos?”, mas sim: para esta carga e neste ambiente, a alternativa concorrente reduz o custo sem mudar o resultado?
Defina o cenário antes de comparar:
Uma carga gerada localmente é ótima para explorar hipóteses com controle. Ela não prova, por si só, que o resultado se aplicará aos dados reais.
A comparação só é válida quando entrada e saída requerida são equivalentes.
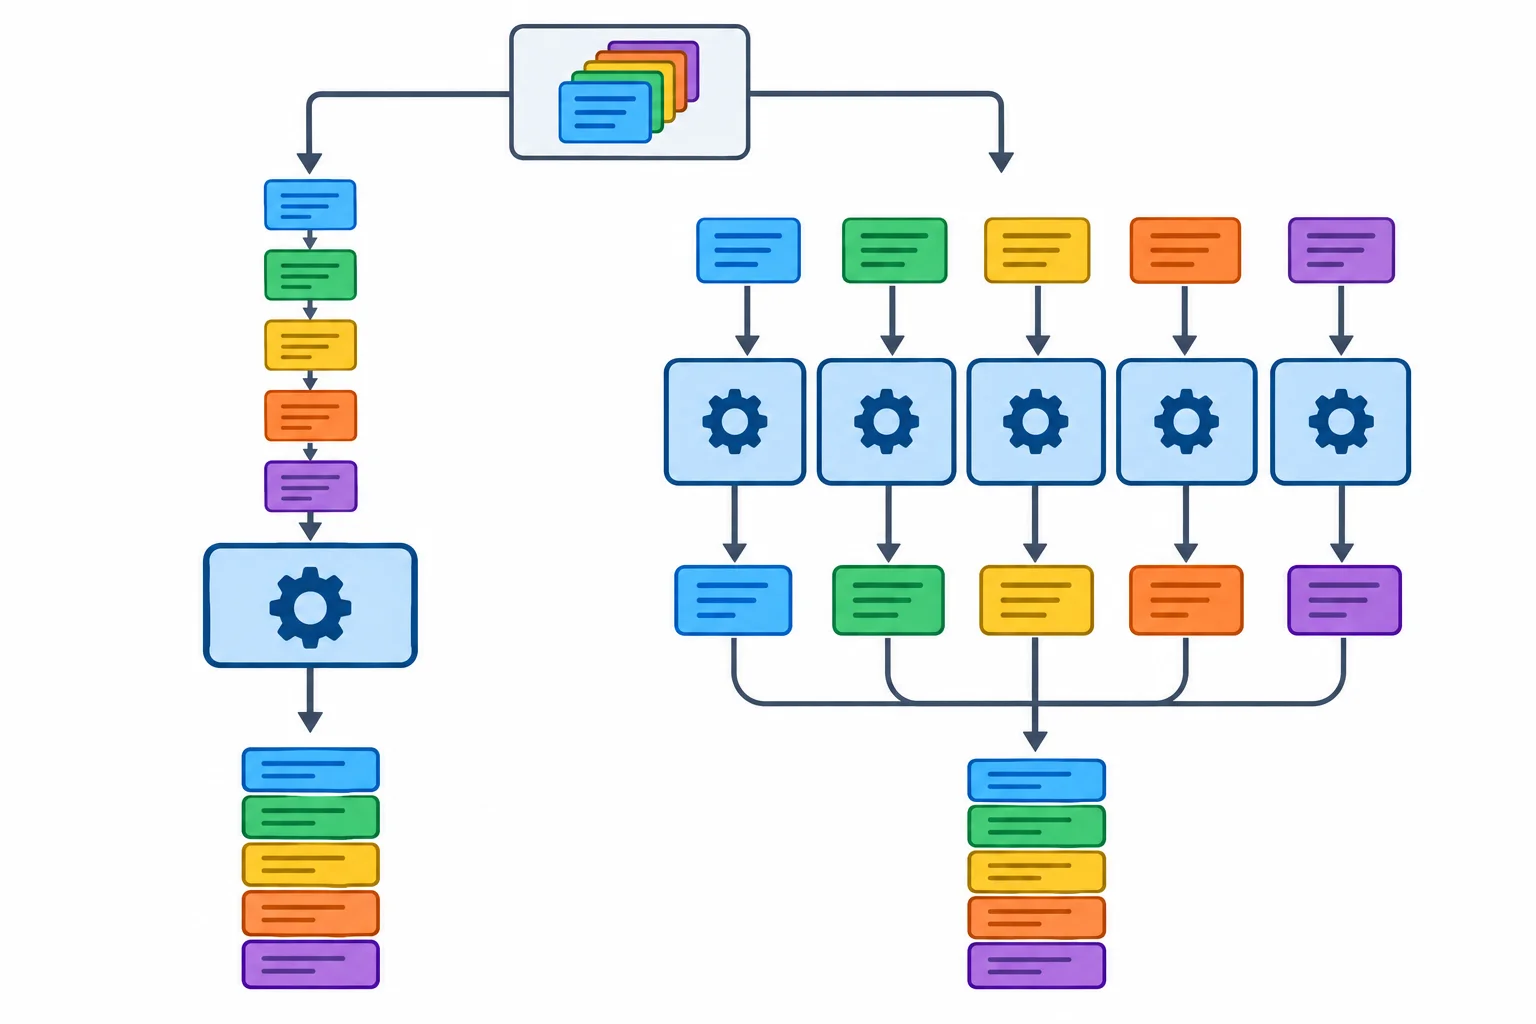
Mude a estratégia de execução; não mude o trabalho que precisa ser entregue.
Antes de qualquer comparação, estabeleça o contrato observável da transformação. Verifique nas duas alternativas:
Uma solução que parece rápida porque ignora itens, não observa falhas ou altera a ordem contratada não é uma otimização.
Exemplo
Hipótese: “Para 20.000 registros textuais locais, com tamanhos entre 80 e 160 caracteres, a versão com processos pode compensar o custo adicional quando esse lote é executado repetidamente.”
Contrato: para cada registro válido, retornar sua transformação; manter um resultado por entrada e a ordem original. Para um registro inválido, propagar ValueError em ambas as alternativas.
O experimento compara uma função de nível superior do módulo, aplicada em sequência e por ProcessPoolExecutor. As entradas são geradas pelo próprio script: não há arquivo, rede ou serviço externo interferindo na carga.
Dica
Use os testes de resultado e exceção como porta de entrada: só uma versão concorrente que passa no mesmo contrato merece ser comparada em desempenho.
Um número sem contexto não é evidência reutilizável. Anote junto da comparação:
Não suponha que “número de trabalhadores” equivale ao mesmo paralelismo útil em todo ambiente. Por enquanto, apenas declare o limite adotado; a variação desse limite será avaliada depois.
Atenção
Dados gerados localmente controlam o experimento, mas podem não refletir tamanhos, erros, distribuição ou frequência da aplicação real. Conclua somente sobre o cenário descrito e amplie a carga antes de generalizar.
Relacione a situação ao seu efeito sobre a validade do experimento.
Toque em um item e depois no par correspondente.
Passo 2 de 9
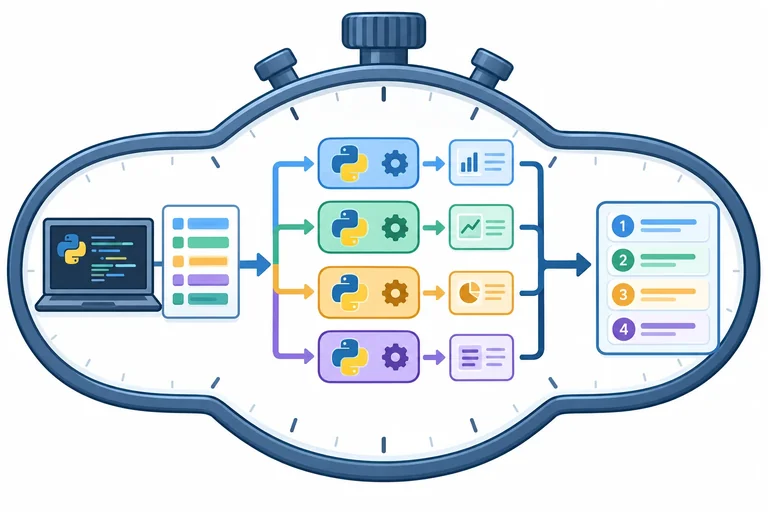
Meça uma execução completa com time.perf_counter, garantindo que todos os resultados tenham sido obtidos antes de parar o relógio.
Use time.perf_counter() para medir a duração decorrida: ele inclui processamento, espera e coordenação. Em uma alternativa concorrente, iniciar tarefas não significa que o trabalho terminou.
Para uma execução completa, inicie o relógio antes da submissão e pare-o somente depois de obter, consumir e consolidar todos os resultados exigidos pelo contrato. Se uma tarefa falhar, essa falha também precisa ser observada; consumir os resultados faz isso acontecer.
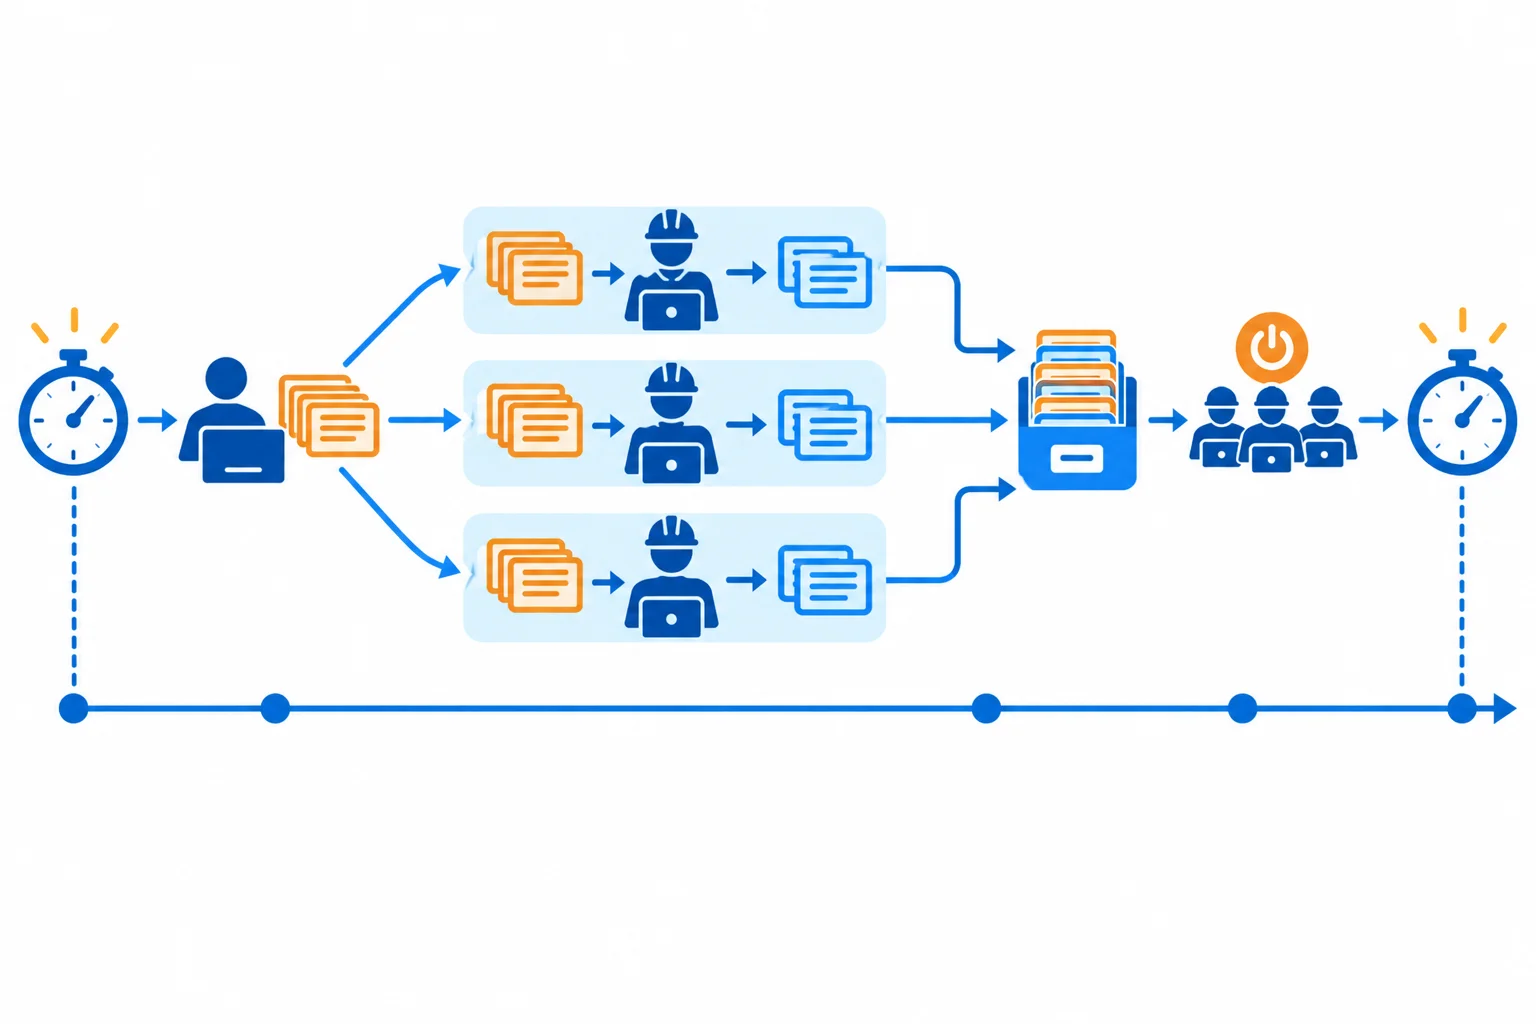
A duração cobre a execução inteira: submissão, processamento, espera, transporte dos resultados, consumo e consolidação.
Dica
Gere a entrada antes de iniciar o relógio se essa geração não fizer parte do cenário avaliado. Também faça a validação comparativa fora da região medida. Já a transformação necessária para produzir a saída contratada deve ficar dentro da medição.
Salve o código abaixo como comparar_execucao.py. Ele gera dados localmente, verifica antes a equivalência das alternativas e só então mede uma execução sequencial e uma concorrente. Durante a coleta, não deixe cProfile, tracemalloc ou outro perfilador ativo: a instrumentação alteraria a duração observada.
Nesta medição, a criação e o encerramento do executor estão dentro da execução concorrente declarada. A separação entre esse cenário e a reutilização de uma estrutura já iniciada virá no próximo step.
from __future__ import annotations

from concurrent.futures import ProcessPoolExecutor
from time import perf_counter


def processar_registro(registro: str) -> tuple[str, int]:
    """Normaliza um registro e executa trabalho de CPU determinístico."""
    if not isinstance(registro, str):
        raise TypeError("registro deve ser str")

    normalizado = " ".join(registro.lower().split())
    acumulado = 0
    for _ in range(1_500):
        for caractere in normalizado:
            acumulado = (acumulado * 33 + ord(caractere)) % 1_000_000_007
    return normalizado, acumulado


def gerar_registros(quantidade: int) -> list[str]:
    return [f"  Cliente {indice % 97}   pedido {indice}  " for indice in range(quantidade)]


def executar_sequencial(registros: list[str]) -> list[tuple[str, int]]:
    return [processar_registro(registro) for registro in registros]


def executar_concorrente(registros: list[str]) -> list[tuple[str, int]]:
    # list consome todos os resultados, preserva a ordem de entrada
    # e propaga exceções produzidas pelos trabalhadores.
    with ProcessPoolExecutor(max_workers=4) as executor:
        return list(executor.map(processar_registro, registros))


def medir(funcao, registros: list[str]) -> tuple[list[tuple[str, int]], float]:
    inicio = perf_counter()
    resultado = funcao(registros)
    fim = perf_counter()
    return resultado, fim - inicio


def testar_contrato() -> None:
    entrada = ["  Ana   Silva ", "BOB", "carla  souza"]
    esperado = executar_sequencial(entrada)
    obtido = executar_concorrente(entrada)

    assert obtido == esperado           # valores e ordem
    assert len(obtido) == len(entrada)  # quantidade

    try:
        processar_registro(None)  # type: ignore[arg-type]
    except TypeError:
        pass
    else:
        raise AssertionError("entrada inválida deveria falhar")


if __name__ == "__main__":
    testar_contrato()

    # Preparação fora da região medida: mesma entrada para ambas as alternativas.
    registros = gerar_registros(2_000)

    sequencial, segundos_sequencial = medir(executar_sequencial, registros)
    concorrente, segundos_concorrente = medir(executar_concorrente, registros)

    # Validação fora do cronômetro; nenhuma medição é aceita se falhar.
    assert concorrente == sequencial

    print(f"sequencial: {segundos_sequencial:.3f} s")
    print(f"concorrente: {segundos_concorrente:.3f} s")
Exemplo
No terminal, no diretório em que você salvou o arquivo, execute:
python comparar_execucao.py
O script só imprime as durações se os testes iniciais e a validação final passarem. Se houver uma exceção em um processo trabalhador, o consumo feito por list(...) a propaga em vez de deixar uma falha silenciosa.
Considere uma execução concorrente de uso único. Coloque as ações na ordem que representa uma medição completa.
Execute o script no seu computador. Relate o comando usado, se as validações passaram e qual foi o ponto exato em que a medição concorrente terminou. Não é necessário enviar o arquivo nem os valores de tempo.
Escreva pelo menos 80 caracteres (0/80).
Passo 3 de 9
Diferencie uma chamada concorrente isolada de um cenário com infraestrutura já ativa, declarando com precisão o que cada medição inclui.
Uma medição de concorrência só é interpretável se declarar o cenário.
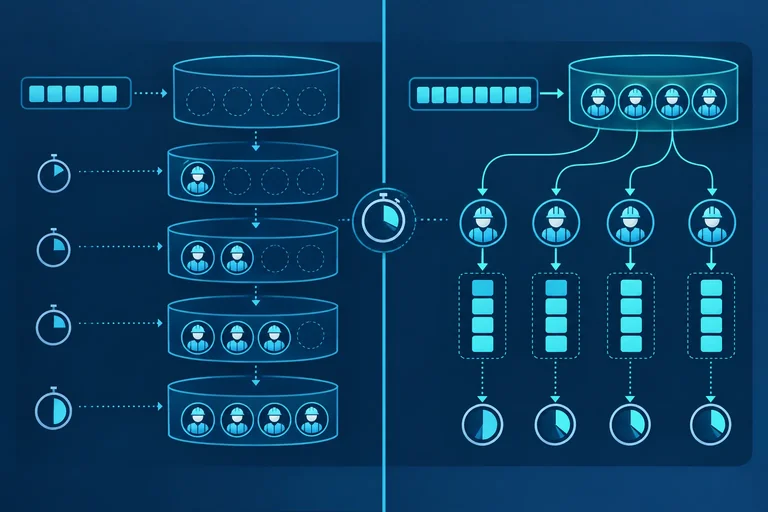
Uso único responde: “quanto custa atender esta carga quando a estrutura precisa nascer e ser encerrada agora?”. A fronteira inclui criação do executor, partida dos trabalhadores, submissão, processamento, entrega dos resultados e encerramento.
Reutilização responde: “quanto custa atender esta carga com a estrutura de atendimento já pronta?”. A criação do executor e o aquecimento ficam fora; a fronteira começa na submissão e termina após todos os resultados exigidos estarem disponíveis.
Os dois cenários são válidos, mas não são substitutos. A diferença entre eles não é exclusivamente o tempo de processamento das tarefas.
O mesmo trabalho útil aparece nos dois fluxos; o que muda é a posição do relógio.
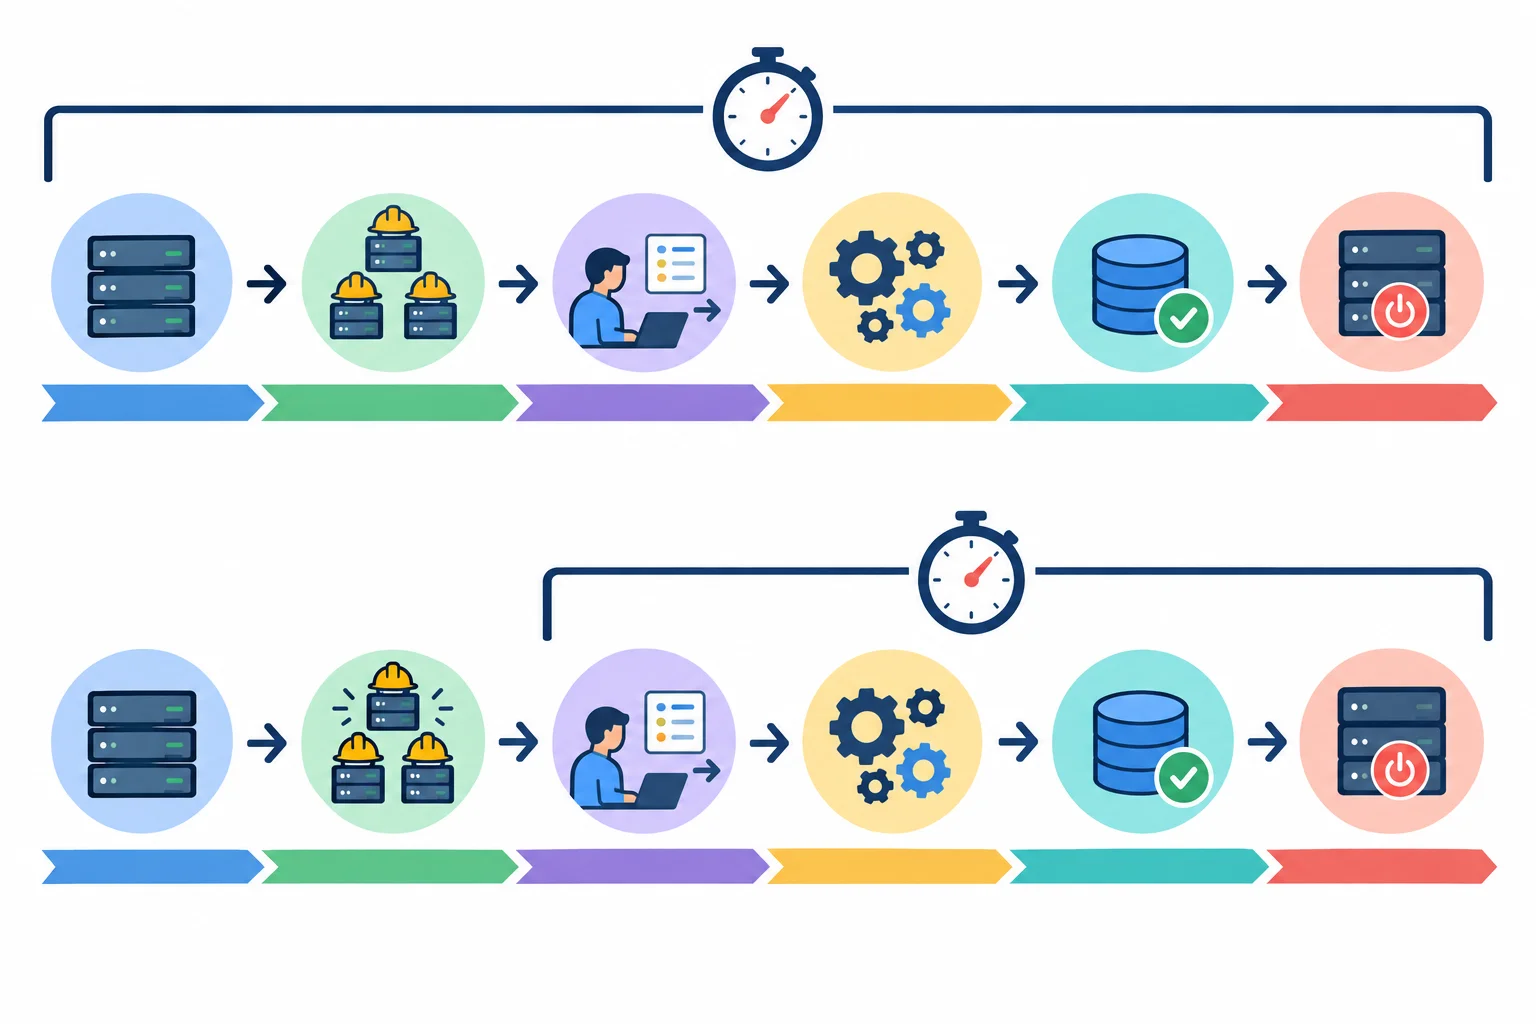
No uso único, o relógio cobre o ciclo de vida inteiro. Na reutilização, ele cobre o atendimento de uma carga por uma infraestrutura já ativa.
Dica
Se o relógio começa dentro do script, a partida do interpretador principal já ficou fora da medição. Registre isso. Também declare custos excluídos, como criação do executor, aquecimento ou encerramento, em vez de chamá-los implicitamente de “zero”.
ProcessPoolExecutor(...) pode iniciar trabalhadores sob demanda. Portanto, apenas construir o objeto executor não demonstra que a infraestrutura está pronta. No cenário reutilizado, envie trabalho de aquecimento e espere todos os resultados antes de iniciar o relógio.
O aquecimento abaixo ativa a infraestrutura; ele não deve alterar deliberadamente os dados da carga. Se sua função usa cache, mantenha o estado de cache equivalente e declarado entre as alternativas — aquecer processos e aquecer caches são fatos diferentes.
Salve como cenarios_pool.py e execute com python cenarios_pool.py. A função fica no nível do módulo para poder ser importada pelos processos trabalhadores.
from concurrent.futures import ProcessPoolExecutor
from time import perf_counter


def transformar(registro: str) -> str:
    # Trabalho determinístico e serializável para a comparação.
    acumulado = 0
    for caractere in registro:
        acumulado = (acumulado * 33 + ord(caractere)) % 1_000_003
    return f"{registro.upper()}:{acumulado}"


def ativar_trabalhadores(executor: ProcessPoolExecutor, workers: int) -> None:
    # Submete antes de esperar para solicitar a partida do pool.
    futuros = [executor.submit(transformar, f"aquecimento-{i}") for i in range(workers)]
    for futuro in futuros:
        futuro.result()  # Confirma conclusão e também observa falhas.


def medir_uso_unico(entradas: list[str], workers: int) -> tuple[list[str], float]:
    inicio = perf_counter()
    with ProcessPoolExecutor(max_workers=workers) as executor:
        saidas = list(executor.map(transformar, entradas))
    # A saída do with, que encerra o executor, ainda está dentro da medição.
    return saidas, perf_counter() - inicio


def medir_reutilizacao(entradas: list[str], workers: int) -> tuple[list[str], float]:
    with ProcessPoolExecutor(max_workers=workers) as executor:
        ativar_trabalhadores(executor, workers)  # Fora da fronteira declarada.

        inicio = perf_counter()
        saidas = list(executor.map(transformar, entradas))
        duracao = perf_counter() - inicio

    # O encerramento ocorre depois da medição neste cenário.
    return saidas, duracao


def main() -> None:
    workers = 2
    entradas = [f"registro-{i:05d}-abc" for i in range(20_000)]

    saidas_unico, tempo_unico = medir_uso_unico(entradas, workers)
    saidas_reuso, tempo_reuso = medir_reutilizacao(entradas, workers)

    assert saidas_unico == saidas_reuso
    print(f"uso único:    {tempo_unico:.6f} s")
    print(f"reutilização: {tempo_reuso:.6f} s")
    print("Resultados equivalentes: sim")


if __name__ == "__main__":
    main()
Atenção
Se a reutilização for mais rápida, parte da diferença pode vir da criação e da partida dos processos, não de uma mudança no processamento de transformar. Ainda não escolha uma alternativa com base em uma única execução: a repetição e a variabilidade serão tratadas depois.
O princípio também vale para asyncio:
asyncio.run(...) cria e encerra o laço; se esse for o cenário real, esses custos pertencem à fronteira.Não compare uma alternativa medida dentro de um laço persistente com outra que inclua asyncio.run(...) sem identificá-las como cenários diferentes.
Associe cada elemento ao cenário em que ele fica dentro da fronteira de medição descrita.
Toque em um item e depois no par correspondente.
Depois de executar o script, relate: (1) o que está incluído em cada uma das duas durações e (2) por que uma diferença entre elas não prova, sozinha, que o processamento das tarefas é mais rápido.
Escreva pelo menos 120 caracteres (0/120).
Passo 4 de 9
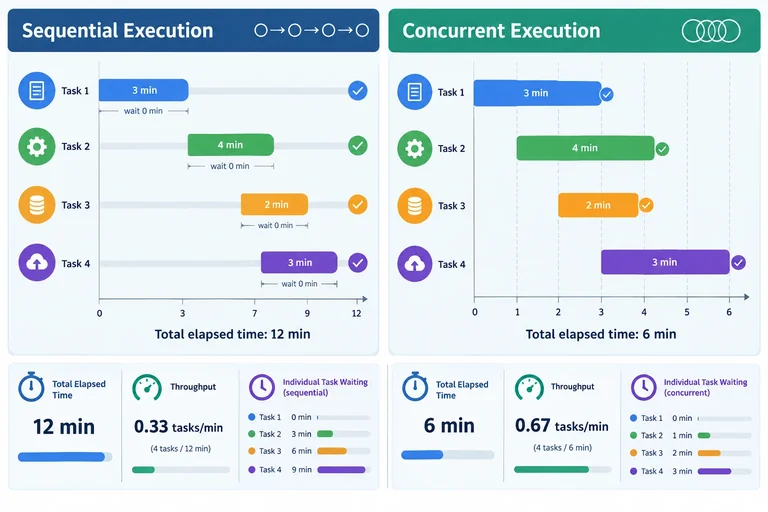
Calcule métricas da carga completa e diferencie o desempenho agregado da espera percebida por cada tarefa.
Para a mesma carga, cenário e unidade de tempo:
itens concluídos com sucesso / duração total.duração sequencial / duração concorrente.Aceleração maior que 1 indica que a alternativa concorrente terminou a carga mais rápido. Compare apenas execuções equivalentes: por exemplo, duas execuções de reutilização, com os mesmos itens e o mesmo contrato de saída.
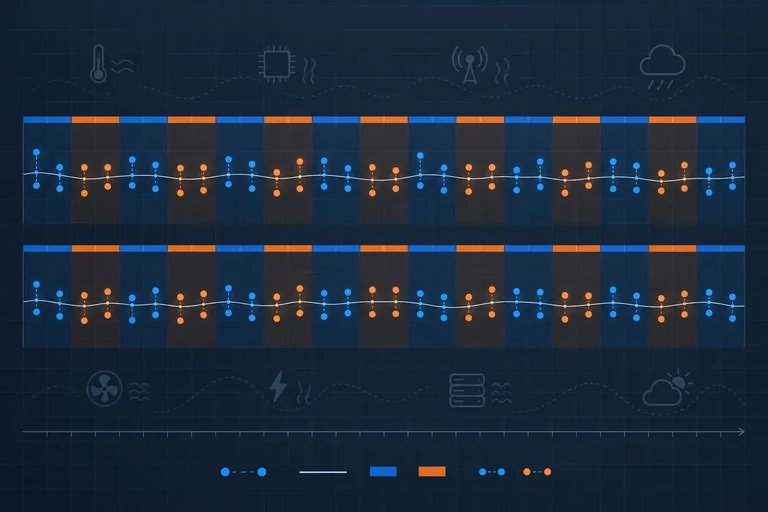
A duração total termina quando a carga inteira é entregue. Já a latência acompanha o caminho de uma tarefa específica.
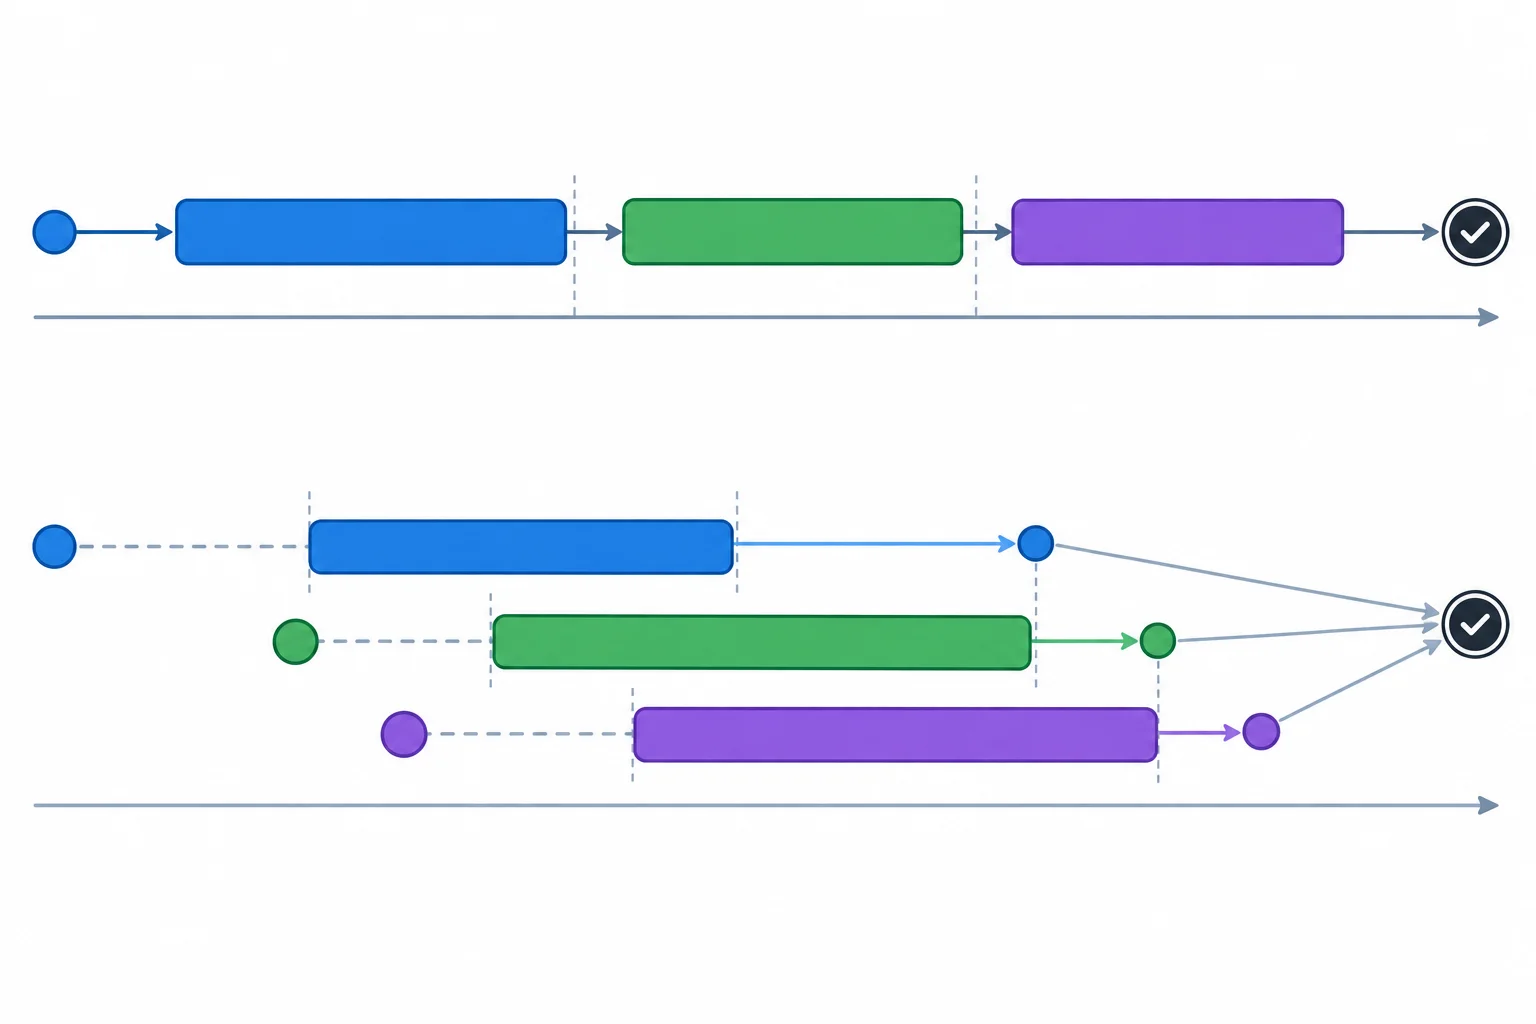
A sobreposição pode encurtar a duração da carga sem reduzir a espera de todas as tarefas.
Exemplo
Carga: 240 registros processados com sucesso; cenário: executor reutilizado.
| Alternativa | Duração total |
|---|---:|
| Sequencial | 1,20 s |
| Concorrente | 0,80 s |
Vazão sequencial: 240 / 1,20 = 200 itens/s.
Vazão concorrente: 240 / 0,80 = 300 itens/s.
Aceleração: 1,20 / 0,80 = 1,5.
A alternativa concorrente concluiu a carga com vazão de 300 itens/s e aceleração de 1,5×. Essas métricas não informam, por si só, quanto cada registro esperou.
Se 300 itens foram concluídos em 0,75 s, a vazão é de ____ itens/s.
Uma definição útil de latência por tarefa vai da submissão até o resultado ficar disponível ao chamador. Portanto, ela pode incluir espera na fila, processamento e transporte do resultado.
duração total / número de itens é o inverso da vazão média da carga. Em uma execução com tarefas sobrepostas, esse valor não estima automaticamente a latência de nenhuma tarefa individual.
Na execução concorrente, a última tarefa pode aguardar na fila antes de executar, mesmo quando o conjunto inteiro termina cedo.
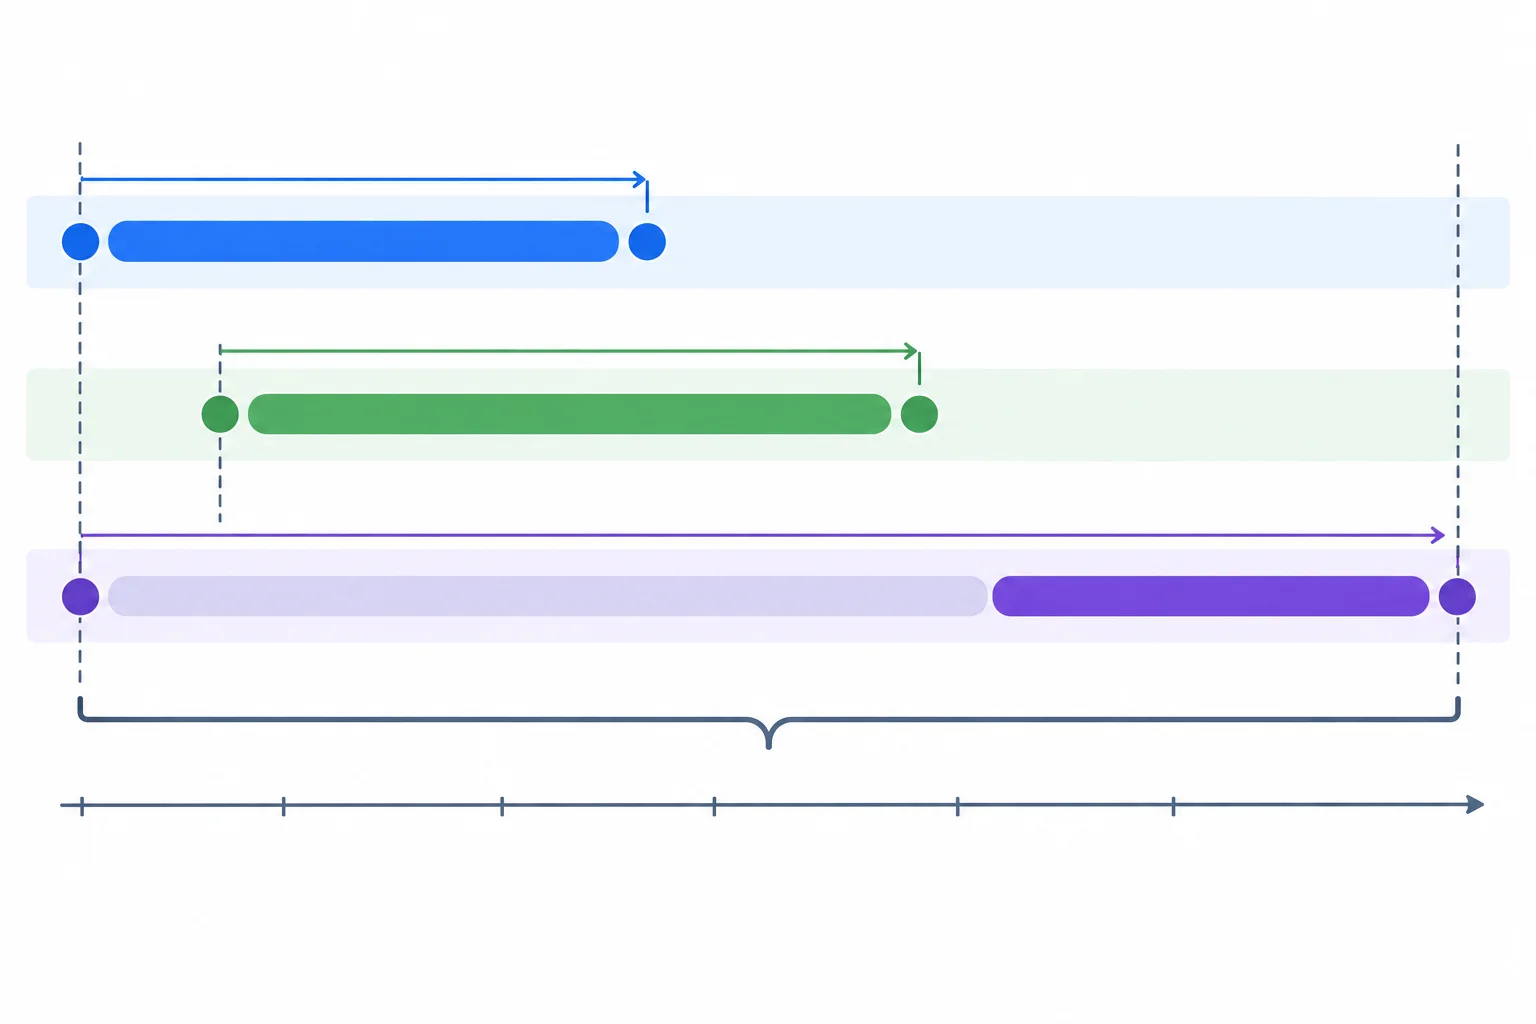
Maior vazão pode coexistir com latências individuais semelhantes ou maiores, especialmente para tarefas que aguardam capacidade.
Uma carga concorrente de 100 tarefas termina em 2 s. Qual conclusão é válida apenas com essa informação?
Registrar horários por tarefa adiciona chamadas de relógio, armazenamento de marcas e tratamento dos dados coletados. Se a pergunta principal é apenas duração total e vazão, mantenha essa instrumentação fora da comparação principal.
Quando a latência for requisito do cenário, declare a fronteira, aplique a mesma instrumentação às alternativas e informe que esse custo faz parte daquela medição.
Para a mesma carga e o mesmo cenário, a versão sequencial durou 0,90 s e a concorrente durou 0,60 s. Qual é a aceleração relativa?
Passo 5 de 9
Repita comparações em condições equivalentes para decidir se uma diferença observada é evidência de ganho ou apenas variabilidade.
Compare as alternativas em pares: mesma carga, mesmo cenário de inicialização e mesmo contrato de saída. Em cada par, execute as duas versões e registre ambas as durações.
Alterne a ordem entre os pares — por exemplo, sequencial → concorrente, depois concorrente → sequencial. Isso reduz o risco de atribuir à concorrência um efeito de aquecimento ou mudança gradual do ambiente.
Cada linha representa uma comparação sob as mesmas condições; apenas a ordem de execução muda entre os pares.
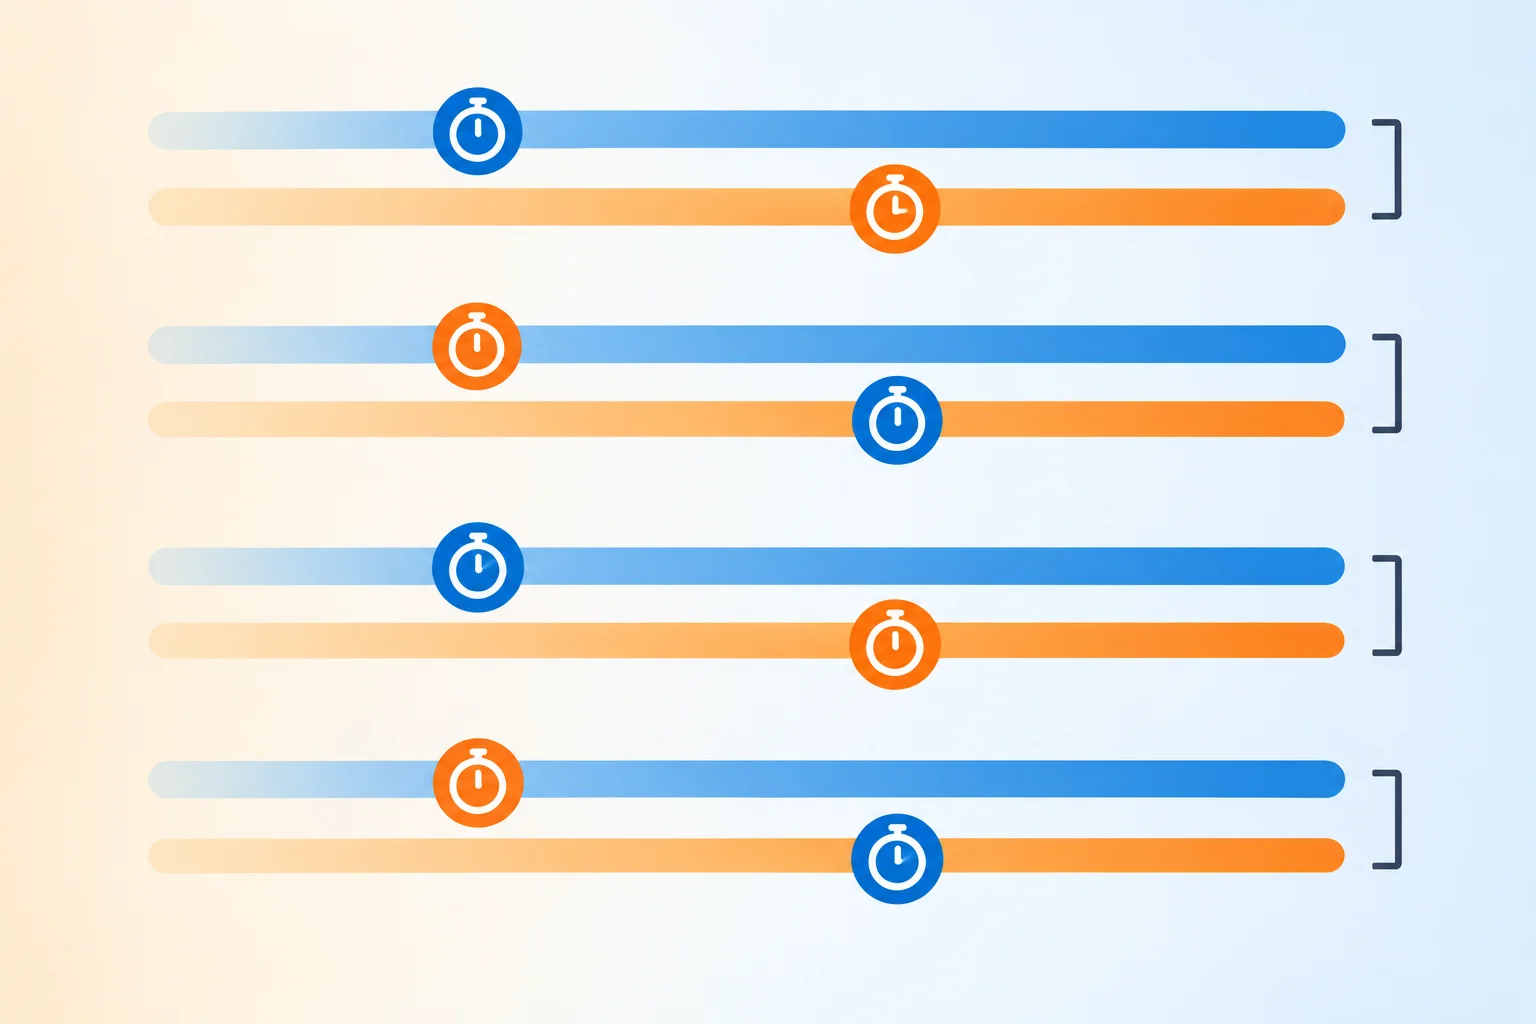
Compare dentro de cada par; não confronte execuções feitas em condições diferentes.
Dica
Para cada amostra, anote: carga, cenário (uso único ou reutilizado), ordem do par, duração de cada alternativa, estado de cache e interferências percebidas. Guarde todas as amostras, inclusive as desfavoráveis.
Use a mediana para representar o centro das amostras e observe a dispersão: quão espalhados estão os valores. Não escolha o menor tempo de cada alternativa como resultado, pois ele pode ser apenas uma execução excepcionalmente favorável.
Se a diferença entre as medianas é pequena em relação à oscilação das séries, a evidência é inconclusiva. Isso não prova que as soluções tenham o mesmo desempenho; mostra apenas que este protocolo não distinguiu um ganho consistente.
Exemplo de dados anotados após comparações pareadas.
# Durações em segundos; cada posição forma um par.
sequencial = [1.01, 0.99, 1.02, 1.00, 1.01]
concorrente = [0.98, 1.03, 0.97, 1.02, 0.99]

# Medianas: sequencial = 1.01 s; concorrente = 0.99 s
# A diferença de 0.02 s é menor que a oscilação observada.
# Conclusão: evidência inconclusiva neste cenário.Com base no registro ilustrativo, qual conclusão é mais adequada?
Declare se cada alternativa foi medida com cache vazio ou aquecido e aplique a mesma política às duas. Limpar um cache no processo principal não garante limpar caches existentes nos trabalhadores de um executor de processos.
Prefira fontes locais e controladas. Uma espera com sleep pode modelar uma pausa sintética, mas não reproduz automaticamente uma API, rede, disco ou serviço real. Registre aplicativos em segundo plano, alterações de energia/CPU e quaisquer condições que não possam ser reiniciadas com confiança.
Atenção
Não compare uma execução concorrente com trabalhadores e caches já aquecidos contra uma execução sequencial em estado diferente e chame isso de aceleração. São cenários distintos.
Você mediu a versão sequencial logo após abrir o script. Depois, executou várias vezes a versão concorrente com o mesmo executor ainda ativo e concluiu que ela venceu por 3%. Que condição torna essa conclusão frágil e o que você faria antes de aceitá-la?
Escreva pelo menos 80 caracteres (0/80).
Passo 6 de 9
Varie a granularidade da carga de forma controlada para identificar quando os custos da concorrência passam a valer a pena.
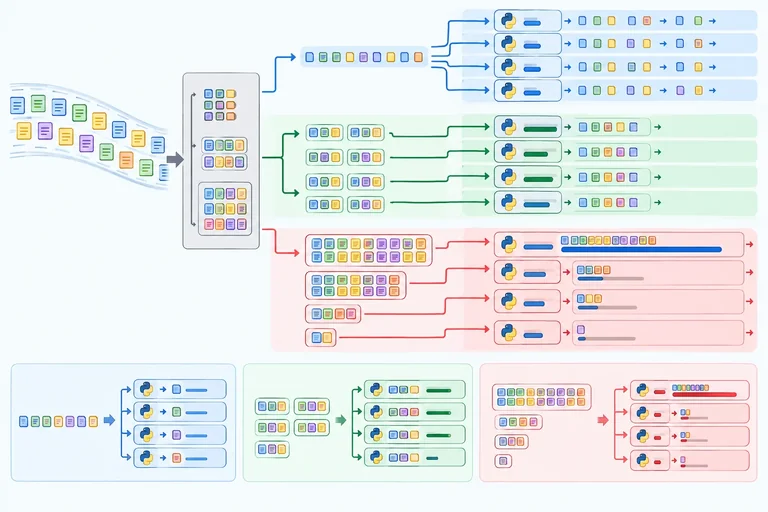
Não confunda estas três variáveis:
Você pode manter 20.000 registros e alterar apenas o lote: 1 registro por chamada gera 20.000 tarefas; 100 por chamada gera 200 tarefas. O trabalho útil final precisa continuar equivalente.
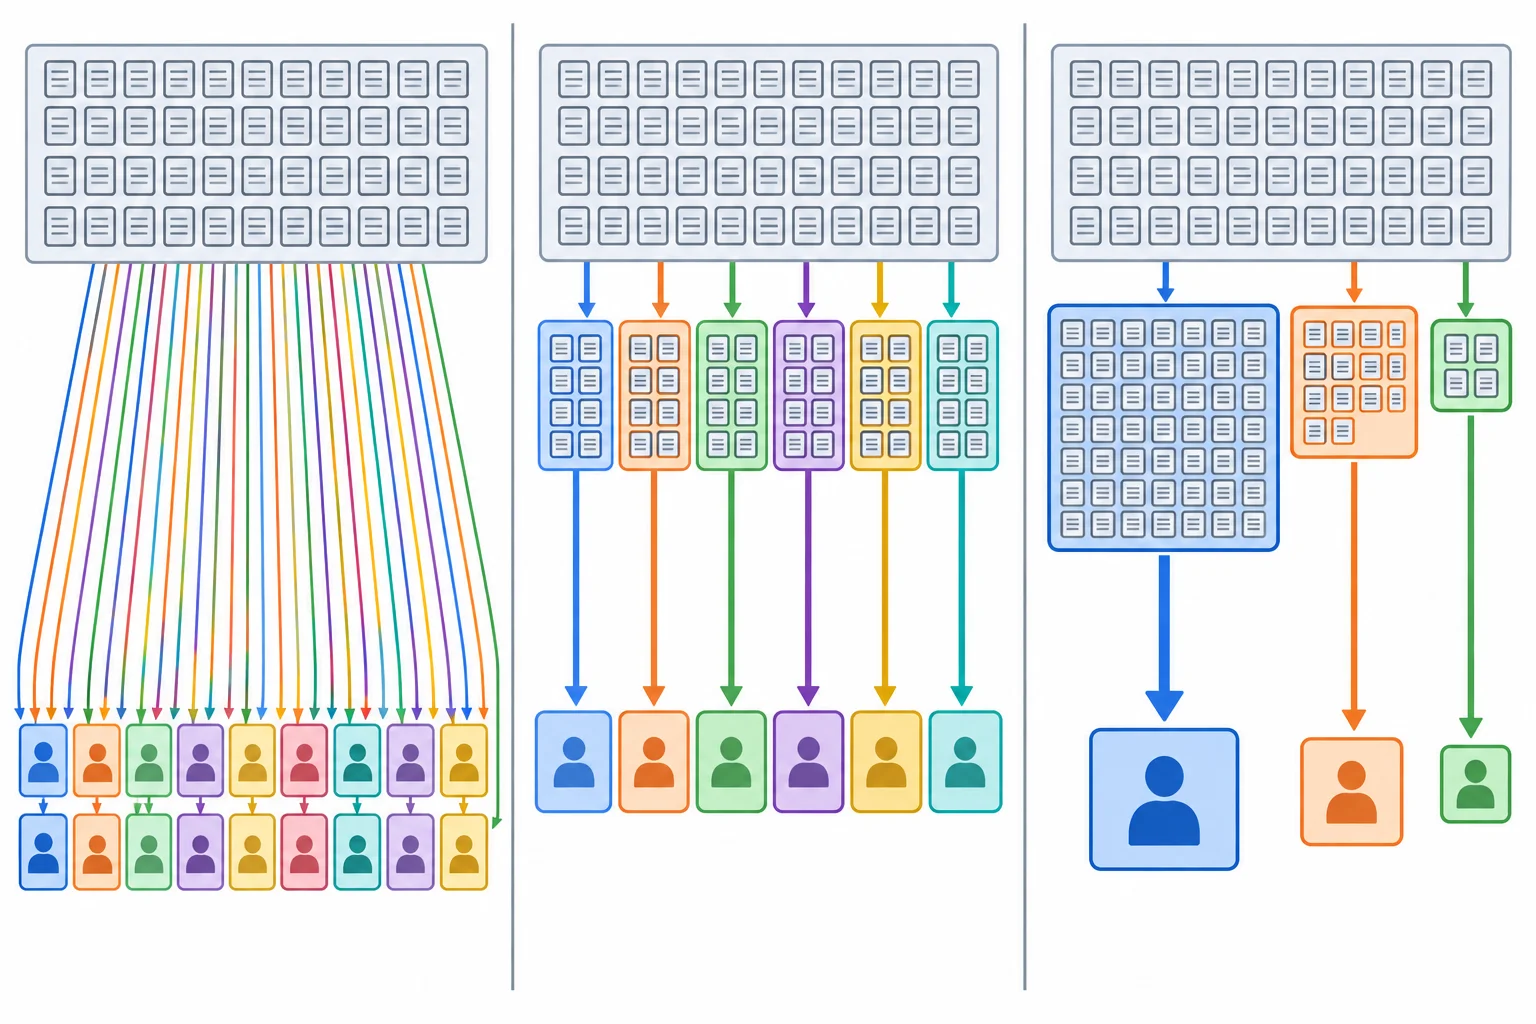
A carga total é a mesma; o que muda é o número de chamadas e a distribuição do trabalho entre elas.
Dica
Monte uma matriz pequena. Por exemplo, escolha dois volumes e três tamanhos de lote. Para cada linha, repita a comparação sequencial–concorrente com o mesmo protocolo já adotado. Altere uma variável por vez; não mude lote, volume e quantidade de trabalhadores juntos.
Cada tarefa concorrente pode exigir submissão, serialização dos argumentos, transporte, recebimento do resultado e coordenação. Se a transformação é muito curta, esses custos podem superar o trabalho útil.
Agrupar itens em lotes amortiza esses custos: menos chamadas transportam mais trabalho. Mas a medição deve incluir a montagem dos lotes e, quando o contrato exigir, a reconstrução da saída ordenada.
Use uma função no nível superior do arquivo. Ela preserva cada registro dentro de um lote; a alternativa concorrente ainda deve reconstruir a saída no formato contratado.
from collections.abc import Iterable


def agrupar(registros: list[str], tamanho_lote: int) -> list[list[str]]:
    if tamanho_lote <= 0:
        raise ValueError("tamanho_lote deve ser positivo")
    return [
        registros[inicio : inicio + tamanho_lote]
        for inicio in range(0, len(registros), tamanho_lote)
    ]


def processar_lote(lote: list[str]) -> list[str]:
    return [processar_registro(registro) for registro in lote]


def achatar(lotes_processados: Iterable[list[str]]) -> list[str]:
    return [resultado for lote in lotes_processados for resultado in lote]
Associe cada situação à consequência mais direta.
Toque em um item e depois no par correspondente.
Comece com volumes conservadores que seu computador execute confortavelmente. Fixe o conjunto de entradas, a função, o cenário de inicialização, a quantidade de trabalhadores e a política de cache. Então varie só tamanho_lote.
Após cada alteração, execute primeiro os testes de equivalência. Só cronometre se a saída tiver os mesmos valores, quantidade, multiplicidade e ordem exigida.
Exemplo
Origem: dados sintéticos locais; 24.000 registros; mesma função e mesma ordem de saída; executor reutilizado; condições de cache declaradas.
| lote | tarefas | mediana sequencial | mediana concorrente |
| 1 | 24.000 | 1,82 s | 3,10 s |
| 50 | 480 | 1,82 s | 1,36 s |
| 500 | 48 | 1,82 s | 1,41 s |
Nesse cenário, o lote 50 sugere um ponto de compensação: reduziu a sobrecarga sem concentrar tanto trabalho quanto o lote 500. Isso não prova que 50 é ideal para outra máquina, volume ou transformação.
Atenção
Não atribua uma diferença ao lote se também mudou o estado do cache, a entrada, a inicialização do executor ou o número de trabalhadores. E não omita a montagem dos lotes ou a reconstrução da saída quando elas fariam parte do uso real.
Com base na tabela anterior, explique se há evidência de ponto de compensação. Cite por que você não pode declarar um tamanho de lote universalmente vencedor.
Escreva pelo menos 100 caracteres (0/100).
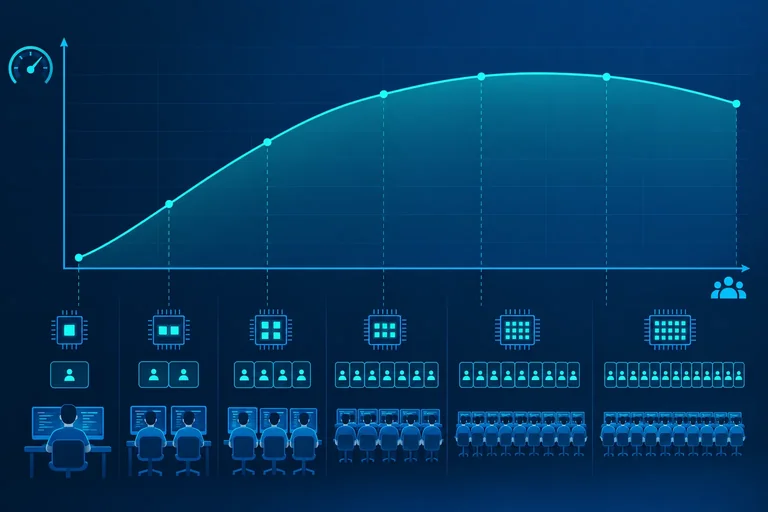
Passo 7 de 9
Varie a capacidade concorrente de forma controlada, leia curvas de duração e vazão e escolha uma configuração sustentada pelos dados.
Para encontrar um limite útil, altere somente a quantidade de trabalhadores. Mantenha fixos a mesma carga, os mesmos lotes, o mesmo cenário de inicialização e o mesmo protocolo de repetições.
Compare, por exemplo, 1, 2, 4 e 8 trabalhadores. Para cada valor, registre a mediana da duração e da vazão. Assim, uma mudança na curva pode ser atribuída à capacidade configurada — não a uma carga diferente ou a custos de partida misturados.
Use o mesmo runner de medição construído nos steps anteriores. Ele deve devolver a duração de uma execução completa.
from statistics import median

WORKERS = (1, 2, 4, 8)
REPETICOES = 7
TOTAL_ITENS = 20_000

for max_workers in WORKERS:
    duracoes = [
        medir_concorrente(
            registros,
            max_workers=max_workers,
            tamanho_lote=TAMANHO_LOTE,
        )
        for _ in range(REPETICOES)
    ]
    duracao_mediana = median(duracoes)
    vazao = TOTAL_ITENS / duracao_mediana
    print(
        f"workers={max_workers:>2} "
        f"mediana={duracao_mediana:.3f}s "
        f"vazao={vazao:.0f} itens/s"
)A forma da curva é evidência do comportamento observado, não um diagnóstico automático da causa.
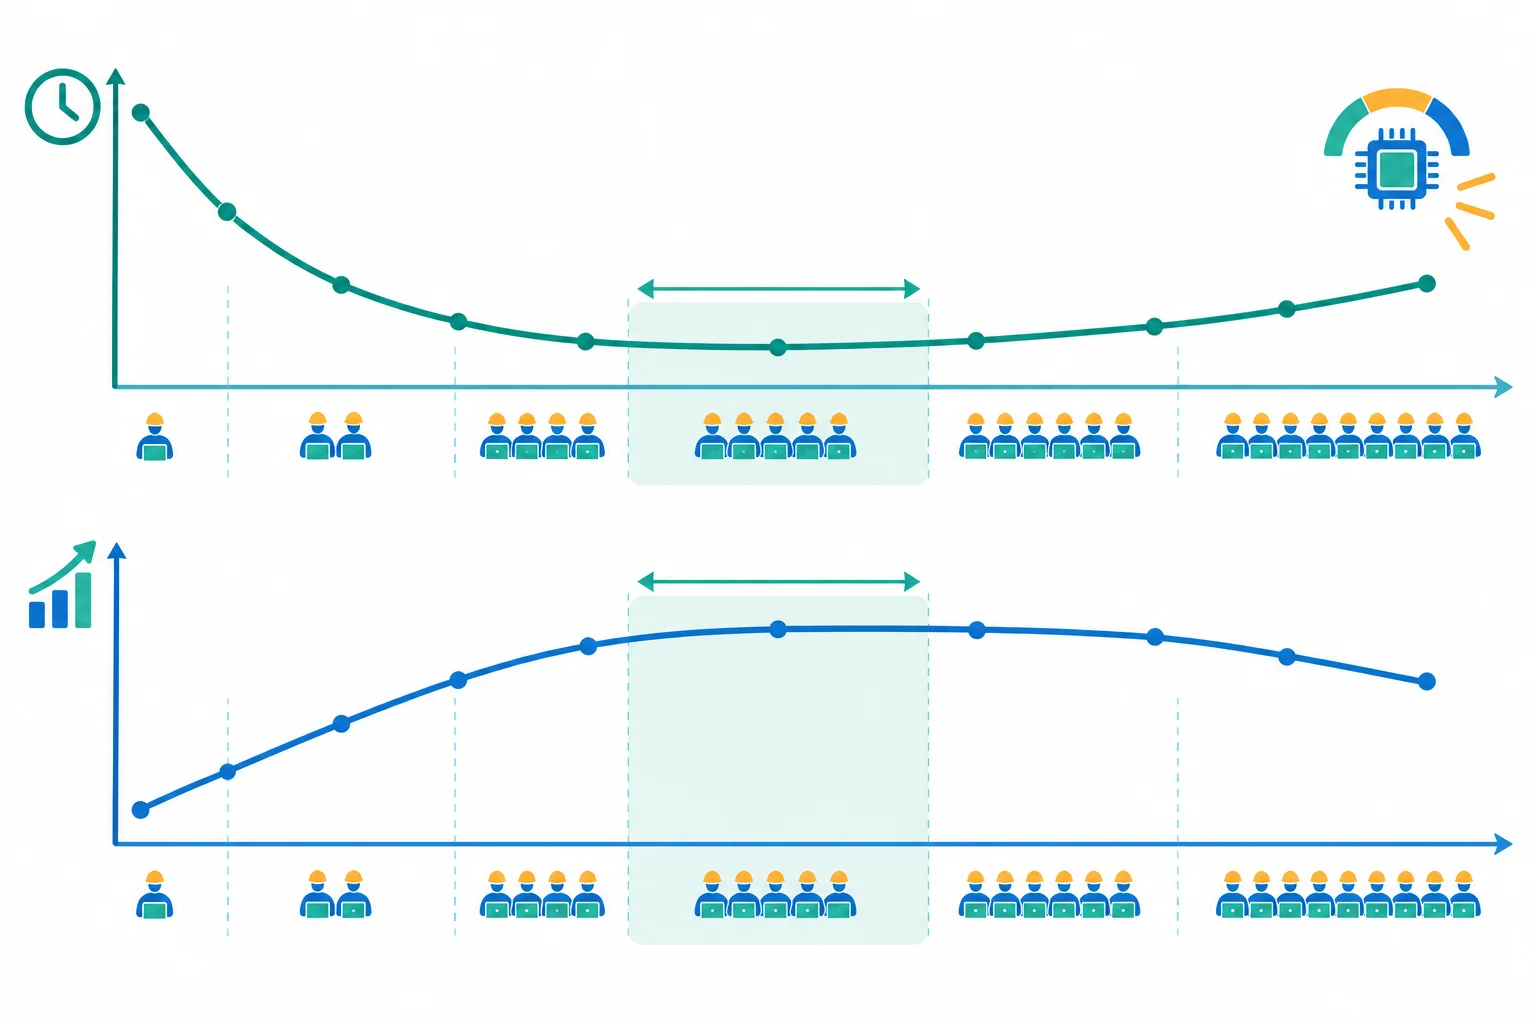
Depois do platô, mais trabalhadores podem aumentar custo sem elevar o trabalho útil.
Exemplo
Carga fixa, processos reutilizados, lotes fixos, 7 repetições por configuração:
| Trabalhadores | Duração mediana | Vazão |
|---:|---:|---:|
| 1 | 8,0 s | 2.500 itens/s |
| 2 | 4,4 s | 4.545 itens/s |
| 4 | 2,7 s | 7.407 itens/s |
| 8 | 2,8 s | 7.143 itens/s |
A configuração com 4 trabalhadores é a melhor observada neste conjunto. O resultado não prova, sozinho, que 8 falhou por uma causa específica: saturação de CPU, contenção, transporte e coordenação são hipóteses a investigar no contexto do ambiente.
O tempo observado combina trabalho útil com efeitos como serialização, transporte entre processos, coordenação e contenção por recursos. Esses efeitos podem se sobrepor; não são parcelas diretamente medidas nem necessariamente uma soma fixa.
Além disso, uma parte da carga permanece sequencial. Se a fração paralelizável ideal fosse p, a lei de Amdahl estima o teto de aceleração como 1 / ((1 − p) + p / n), para n trabalhadores. A estimativa pressupõe paralelismo efetivo e não elimina custos reais de coordenação.
Dica
Em CPU Python com GIL habilitado, mais threads não significam mais execução simultânea de bytecode Python. Processos podem usar núcleos distintos, mas pagam comunicação. Em operações de entrada e saída, threads ou asyncio podem melhorar a sobreposição de esperas, porém o recurso externo pode saturar. No asyncio, o limite do Semaphore controla operações simultâneas; ele é comparável como parâmetro de capacidade, não como contagem de trabalhadores de CPU.
Em uma carga fixa de CPU, processos com 4 e 8 trabalhadores apresentam medianas próximas; 8 tem dispersão maior e não melhora a vazão. Qual decisão é mais bem sustentada?
Usando seus próprios resultados ou os dados ilustrativos, qual configuração de capacidade você escolheria para o cenário medido? Justifique pela duração, vazão e variabilidade. Cite pelo menos uma hipótese plausível para um platô ou piora, sem tratá-la como fato comprovado.
Escreva pelo menos 120 caracteres (0/120).
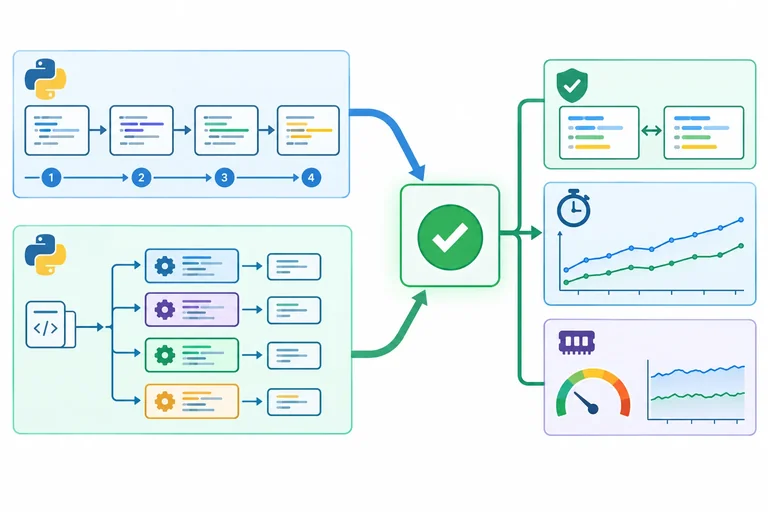
Passo 8 de 9
Combine testes de regressão, medições repetidas e evidências de memória antes de aceitar uma alternativa concorrente.
Não aceite uma alteração só porque uma execução foi mais rápida. Faça uma mudança por vez e siga o ciclo: testes de regressão → novas medições repetidas → verificação de memória → aceitar ou reverter.
A alternativa concorrente só é aceitável no cenário declarado quando preserva o contrato, mostra ganho consistente diante da variabilidade e respeita o orçamento de memória.
As três condições são cumulativas.
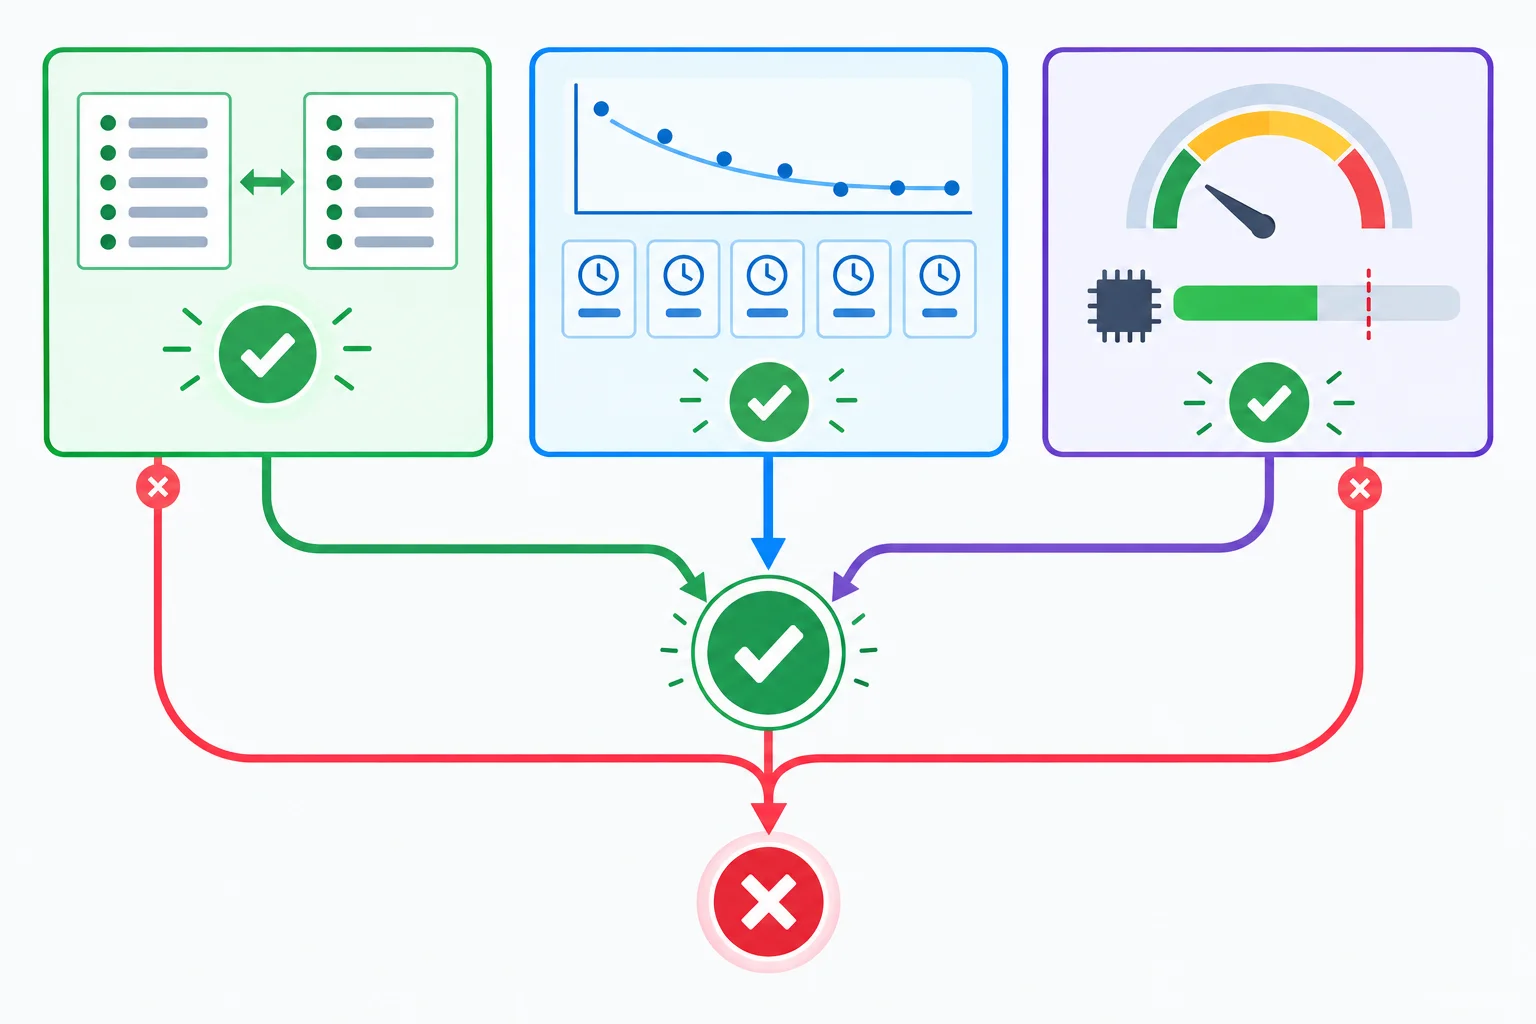
Uma medição rápida não atravessa a porta de aceitação sem testes e evidência de memória.
Atenção
Rejeite resultados que descartem itens, alterem a ordem contratual, ocultem exceções ou mudem o tratamento de entradas inválidas. Também não conclua que o orçamento total foi atendido se você observou apenas uma parte da memória do cenário.
Mantenha os testes fora da coleta de duração: eles validam o comportamento; a medição compara alternativas já validadas. O exemplo abaixo testa valores, quantidade, ordem e uma entrada inválida para duas implementações que recebem a mesma função de transformação.
import pytest

# Ajuste estes imports aos nomes do seu script.
from comparar import processar_concorrente, processar_sequencial


def esperado(registros: list[str]) -> list[str]:
    return [registro.strip().upper() for registro in registros]


@pytest.mark.parametrize(
    "registros",
    [
        [],
        [" ana "],
        [" bia ", "caio", " bia "],  # inclui repetição e exige ordem
    ],
)
def test_alternativas_preservam_resultado_quantidade_e_ordem(registros):
    referencia = esperado(registros)

    for processar in (processar_sequencial, processar_concorrente):
        resultado = processar(registros)
        assert resultado == referencia
        assert len(resultado) == len(registros)


def test_entrada_invalida_mantem_o_contrato():
    for processar in (processar_sequencial, processar_concorrente):
        with pytest.raises(TypeError):
            processar(["ana", None])
Limitar trabalhadores ou operações simultâneas limita o trabalho em execução, mas não limita automaticamente quantas tarefas, argumentos, futuros e resultados podem ficar pendentes. Com lotes, a memória simultaneamente viva depende, entre outros fatores, de trabalhadores × tamanho dos lotes, da fila pendente e de resultados ainda retidos pelo chamador.
Faça o diagnóstico de memória separado da cronometragem. Em um ProcessPoolExecutor, o tracemalloc do processo principal observa suas próprias alocações rastreadas; ele não mede automaticamente a memória dos processos trabalhadores.
Exemplo
Dados ilustrativos — cenário com 4 trabalhadores e lotes de 500 registros:
Não some 18 + 11 como se fossem o pico total, nem multiplique 11 por 4 sem saber se os picos ocorreram juntos e se a observação cobre todos os processos e memória relevante. A evidência é insuficiente para afirmar que o total ficou abaixo de 80 MiB. Registre o escopo observado e colete evidência adicional ou mantenha a conclusão como inconclusiva.
Coloque as ações na ordem adequada após alterar tamanho de lote ou quantidade de trabalhadores.
Uma versão com ProcessPoolExecutor passou nos testes e teve mediana 12% menor, mas as amostras se sobrepõem bastante. O tracemalloc do processo principal mostrou pico de 20 MiB; não houve observação dos trabalhadores. O orçamento total é 100 MiB. Qual conclusão é justificável?
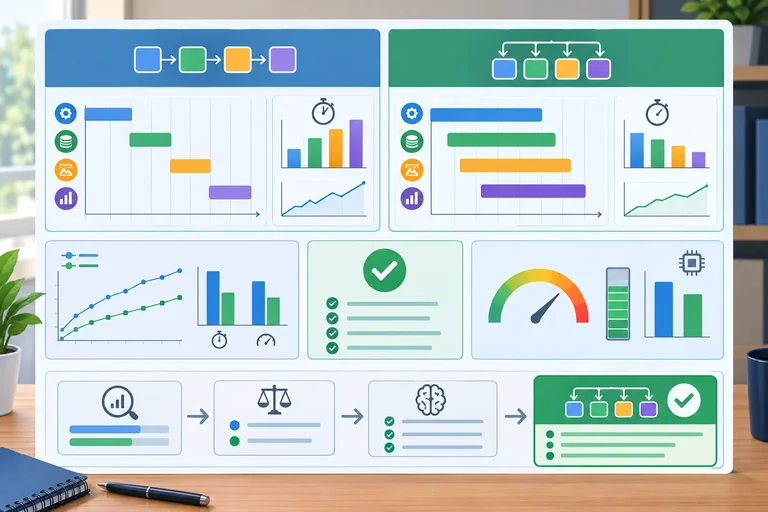
Passo 9 de 9
Transforme as medições e verificações em uma recomendação delimitada, verificável e útil para decidir entre a solução sequencial e a concorrente.
Uma duração isolada não decide nada. Registre a conclusão como uma síntese do experimento: carga e distribuição dos registros, contrato preservado, ambiente, fronteira de medição, cenário de inicialização, quantidade de trabalhadores e lotes, política de cache e protocolo de repetição.
Compare apenas linhas do mesmo cenário. Por exemplo, uma execução única — que inclui criar e encerrar processos — não deve ser misturada com uma medição de executor já aquecido e reutilizado.
A decisão conecta condições, números e verificações; ela não é apenas a menor duração observada.
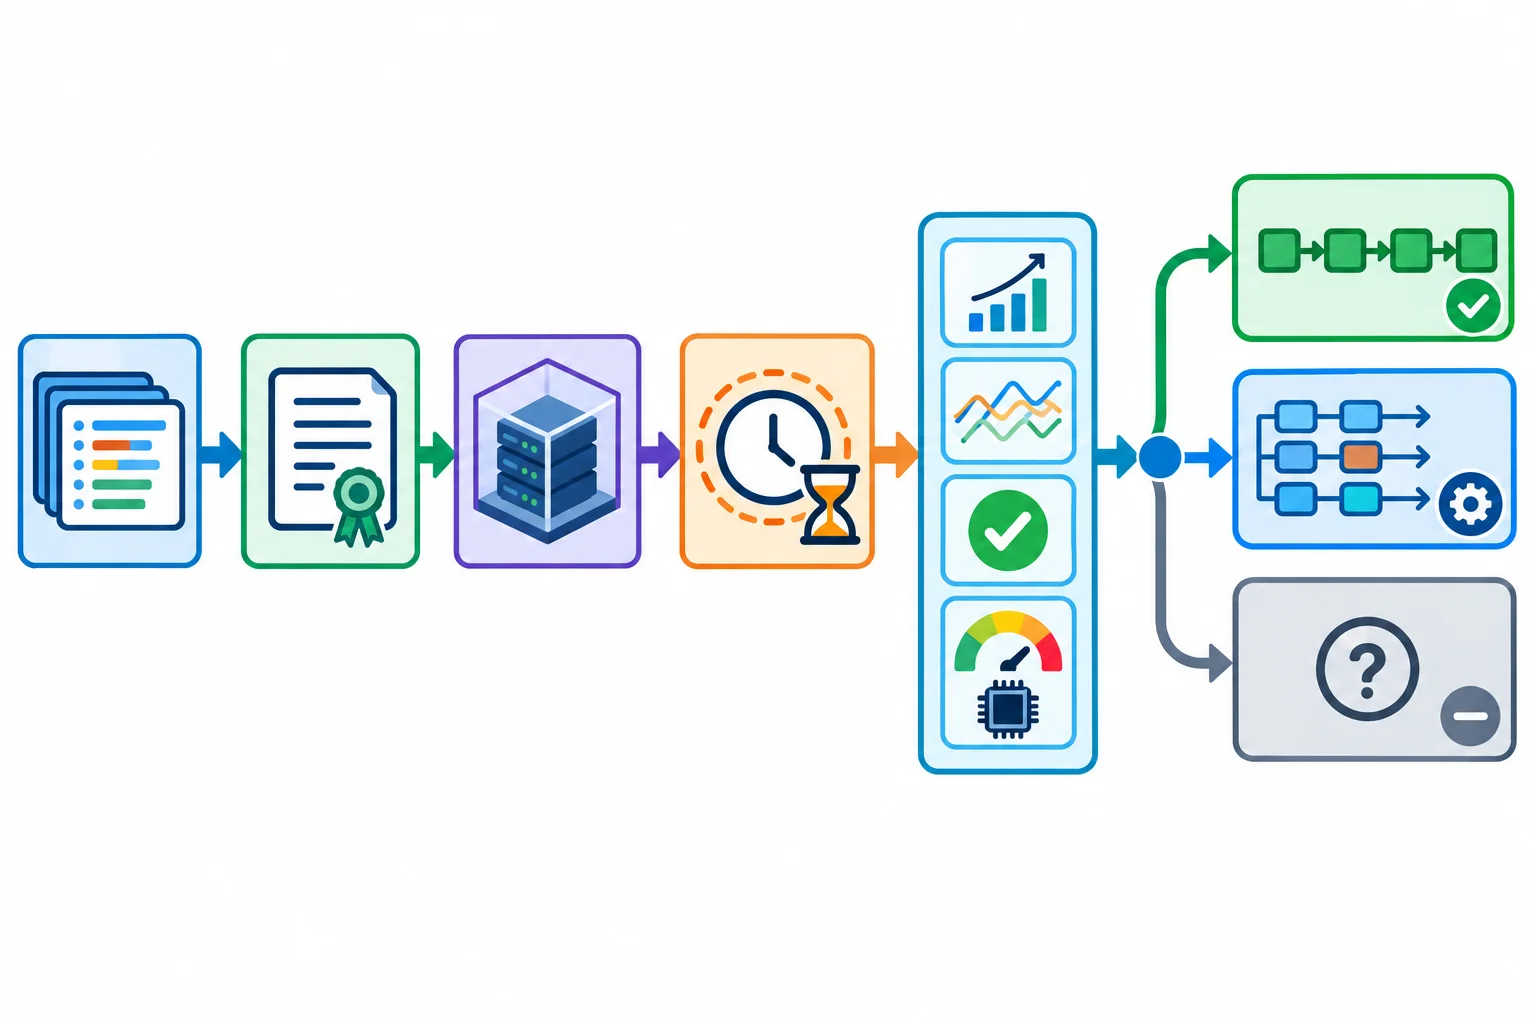
Toda recomendação deve permitir que outra pessoa identifique o cenário comparado e confira suas evidências.
Dica
Identifique se os números foram coletados no seu computador ou se são ilustrativos. Dados ilustrativos treinam a interpretação; não comprovam o desempenho da sua máquina nem da sua aplicação real.
Exemplo
Carga: 20.000 registros textuais gerados localmente; mesma saída ordenada exigida. Ambiente: CPython 3.12, 8 CPUs lógicas. Cenário: executor reutilizado, aquecido fora da medição; cache desativado nas duas alternativas; 7 pares de execuções alternadas.
| Alternativa | Mediana da duração | Dispersão observada | Vazão mediana | Aceleração | Testes | Evidência de memória |
|---|---:|---:|---:|---:|---|---|
| Sequencial | 1,84 s | 0,05 s | 10.870 itens/s | 1,00× | passaram | pico principal: 18 MiB |
| ProcessPool, 4 trabalhadores, lotes de 200 | 1,79 s | 0,11 s | 11.173 itens/s | 1,03× | passaram | pico principal: 24 MiB; processos trabalhadores não cobertos por essa medida |
Os testes passaram, mas o ganho de 0,05 s é menor que a variação observada. Além disso, a evidência de memória não cobre o total dos processos. A conclusão responsável é: evidência inconclusiva para adotar concorrência nesse cenário — e manter a versão sequencial por enquanto.
Manter o sequencial é uma decisão técnica válida quando a concorrência não traz ganho consistente, aumenta custos operacionais ou não possui evidência suficiente de memória. Isso não afirma que processos nunca ajudarão: afirma somente que eles não se justificaram nas condições medidas.
Uma conclusão condicional poderia dizer: “Reavaliar se o volume crescer, se a frequência de execução mudar, se o trabalho por tarefa aumentar ou se o ambiente de execução for diferente.”
Com base na tabela ilustrativa, redija uma recomendação curta. Declare se manteria o sequencial, adotaria a concorrência sob condições delimitadas ou consideraria a evidência inconclusiva. Justifique usando duração/aceleração, dispersão, testes, memória e uma condição para nova medição.
Escreva pelo menos 280 caracteres (0/280).
Resumo
Use a evidência do experimento para escolher a solução adequada ao cenário — não para fazer uma afirmação universal.
Parabéns! Você concluiu: Comparar desempenho sequencial e concorrente
Você concluiu este nível!
Agora você vai iniciar: Arquitetura e distribuição de aplicações
 Definir requisitos verificáveis para uma aplicação de linha de comandoDelimitar uma aplicação de linha de comando para consultar e atualizar um catálogo local em JSON, definindo comportamentos e critérios de aceitação que orientarão sua implementação e entrega.
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks