Passo 1 de 8
Entender a estrutura de um CSV
Reconheça como cabeçalhos, registros, delimitadores, aspas e quebras de linha representam uma tabela em texto.
Trilha de aprendizado · Nível 6 · Tutorial 7
Importar e exportar registros tabulares com o módulo csv, respeitando delimitadores, cabeçalhos e conversões de campos e identificando registros inválidos.
 Entender a estrutura de um CSV
Reconheça como cabeçalhos, registros, delimitadores, aspas e quebras de linha representam uma tabela em texto. 2 min
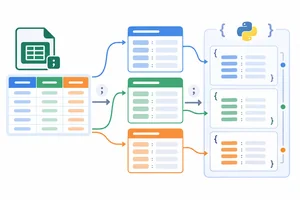 Abrir o arquivo e ler com DictReader
Configure a abertura de um arquivo CSV separado por ponto e vírgula e leia cada registro como um dicionário associado ao cabeçalho. 3 min
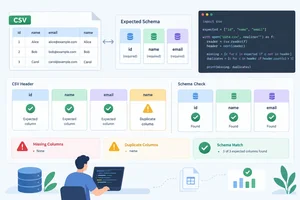 Validar o cabeçalho antes dos registros
Verifique as colunas declaradas pelo arquivo antes de percorrer e processar seus registros. 3 min
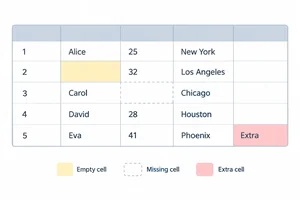 Detectar registros incompletos ou excedentes
Identifique campos vazios, ausentes e excedentes nos dicionários produzidos por DictReader e diferencie o número do registro da linha física consumida. 3 min
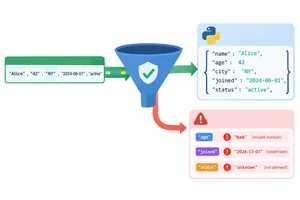 Converter campos e validar os valores
Converta os textos lidos do CSV para os valores esperados pela aplicação e rejeite registros inválidos com diagnósticos específicos. 3 min
 Exportar com colunas explícitas
Use DictWriter para definir a ordem das colunas, gravar registros validados e conferir os dados por meio de uma nova leitura. 3 min
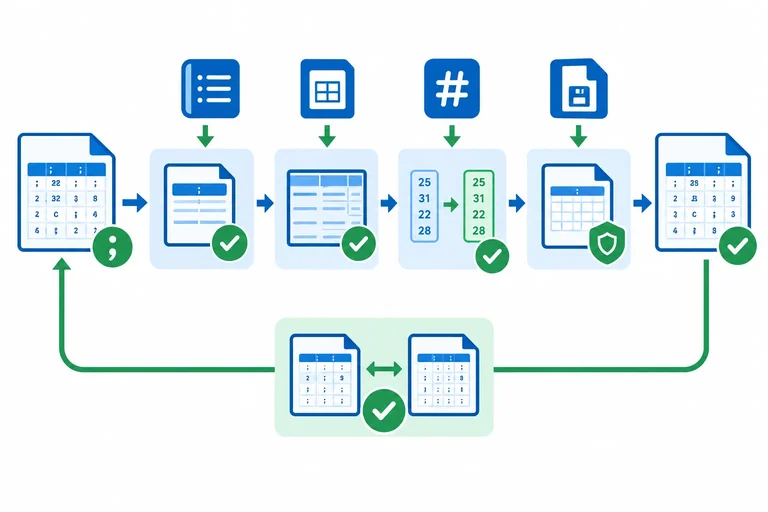
 Distinguir as causas de falha
Classifique falhas de formato, conteúdo, codificação e acesso para interromper o fluxo no estágio correto. 3 min
 Aplicar o fluxo completo e conferir o resultado
Execute o fluxo completo de importação, validação, exportação e releitura; depois provoque uma falha de conteúdo e confirme que a saída não é criada. 4 min
Passo 1 de 8
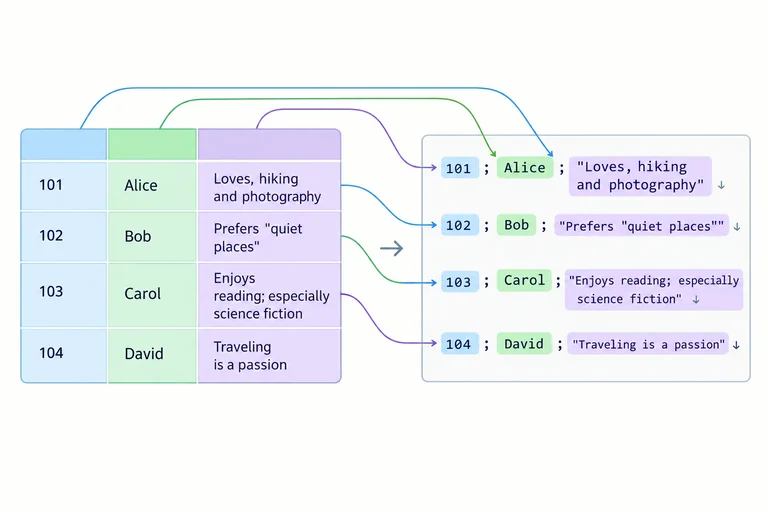
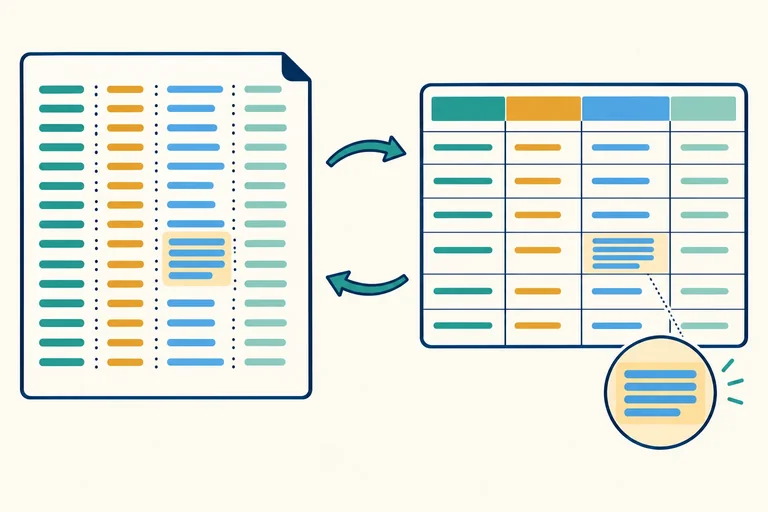
Reconheça como cabeçalhos, registros, delimitadores, aspas e quebras de linha representam uma tabela em texto.
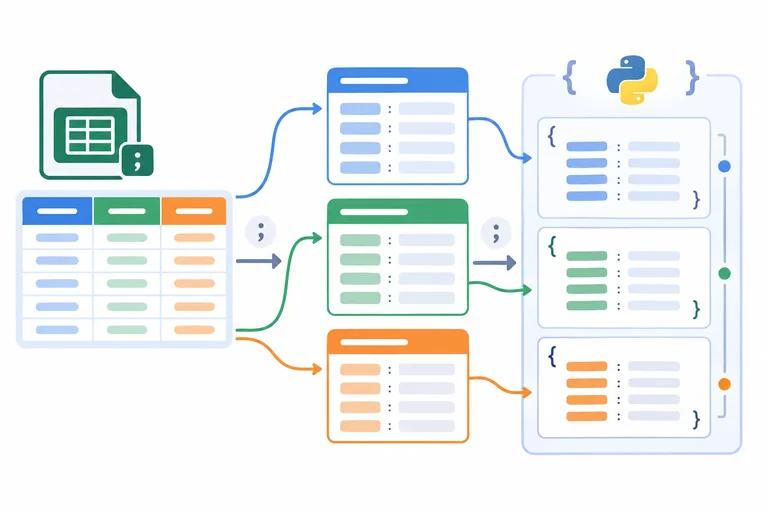
CSV é um formato textual para representar dados tabulares. O primeiro registro costuma ser o cabeçalho, e os seguintes representam os dados. Cada registro contém campos separados por um delimitador.
O próprio CSV não define tipos: valores como 2 e 15 são texto no arquivo, mesmo que a aplicação decida convertê-los em números depois.
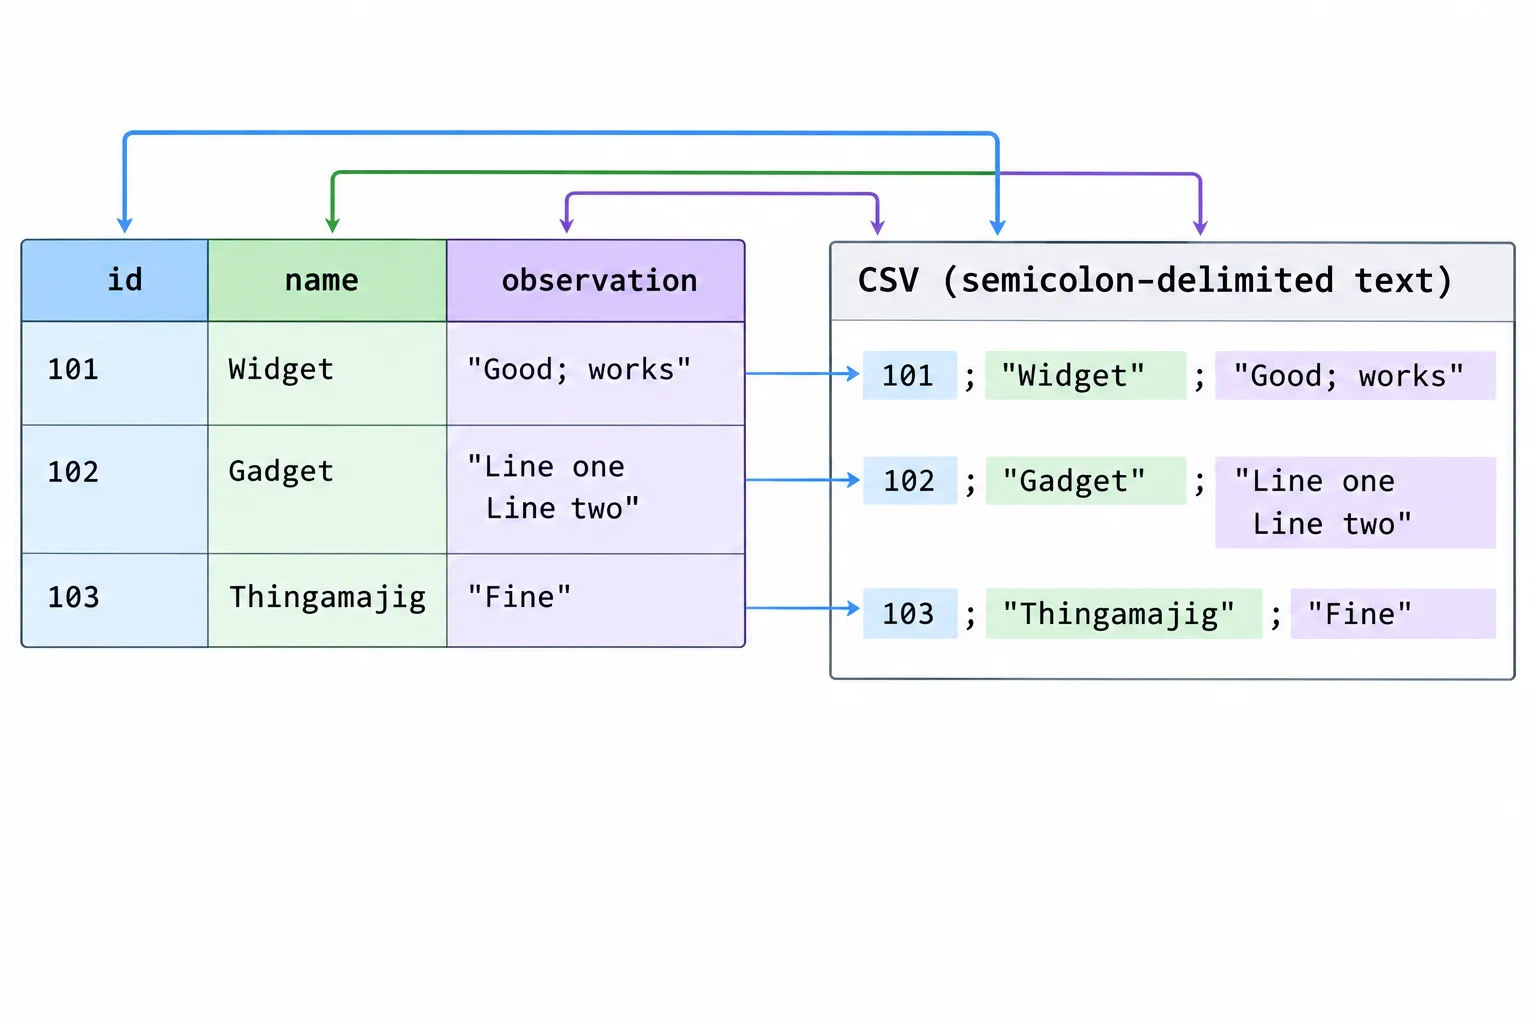
Cada célula corresponde a um campo; cada registro lógico corresponde a uma linha da tabela.
O delimitador é uma convenção escolhida para aquele arquivo. Alguns CSVs usam vírgula; outros, ponto e vírgula. A extensão .csv não revela qual separador foi adotado.
Exemplo
produto;quantidade;observacao
Caneca;2;Azul
Caderno;1;Sem pauta
Aqui há três campos em cada registro. Trocar mentalmente o ponto e vírgula por uma vírgula mudaria a interpretação da estrutura.
Exemplo
produto;quantidade;observacao
Caneca;2;"Modelo grande; azul"
Caderno;1;"Ela escreveu ""urgente"" na capa"
Cartaz;1;"Primeira linha
segunda linha"
As aspas delimitam um campo que contém o próprio separador ou uma quebra de linha. Na convenção padrão, uma aspa interna é representada por duas aspas ("").
Por isso, o registro de Cartaz ocupa duas linhas físicas do texto, mas continua sendo um único registro lógico com três campos. Usar split(";") separaria incorretamente o ponto e vírgula de "Modelo grande; azul"; dividir por linhas também quebraria o registro de Cartaz. O módulo csv é responsável por interpretar essas regras.
Considere o registro Caneca;2;"Modelo grande; azul". Qual interpretação está correta?
Passo 2 de 8
Configure a abertura de um arquivo CSV separado por ponto e vírgula e leia cada registro como um dicionário associado ao cabeçalho.
O módulo csv faz parte da biblioteca padrão do Python, portanto não exige instalação. Para acompanhar o exemplo, crie no seu computador um arquivo chamado cadastro.csv com o conteúdo abaixo. O delimitador deste arquivo é o ponto e vírgula (;).
Salve exatamente este conteúdo em UTF-8. As aspas permitem que o ponto e vírgula da primeira observação pertença ao próprio campo.
produto;quantidade;observacao
Caderno;2;"Capa azul; 96 folhas"
Caneta;5;Ponta fina
Mochila;1;Uso diário
Dica
Um arquivo com extensão .csv pode usar vírgula, ponto e vírgula ou outra convenção. Configure delimiter de acordo com o arquivo recebido.
Abra o arquivo com o encoding correspondente à sua origem. Neste exemplo, ele foi salvo em UTF-8. O argumento newline="" deixa o tratamento das quebras de linha do CSV sob responsabilidade do módulo csv, inclusive quando elas aparecem dentro de campos entre aspas.
O for permanece dentro do bloco with, enquanto o arquivo está aberto.
from pathlib import Path
import csv

caminho = Path("cadastro.csv")

with caminho.open(
    mode="r",
    encoding="utf-8",
    newline="",
) as arquivo:
    reader = csv.DictReader(arquivo, delimiter=";")

    for registro in reader:
        print(registro["produto"])
        print(registro["quantidade"])
        print(registro["observacao"])
Dica
UTF-8 é a escolha deste exemplo, não uma propriedade automática de todo CSV. Ao receber outro arquivo, descubra qual codificação foi usada e informe-a explicitamente.
Como fieldnames não foi informado, o DictReader usa o primeiro registro como cabeçalho. Assim, produto, quantidade e observacao tornam-se as chaves dos dicionários produzidos. Nesta etapa, todos os valores lidos são textos — inclusive "2".
No primeiro registro de dados, cada nome do cabeçalho é associado ao campo que ocupa a mesma coluna.
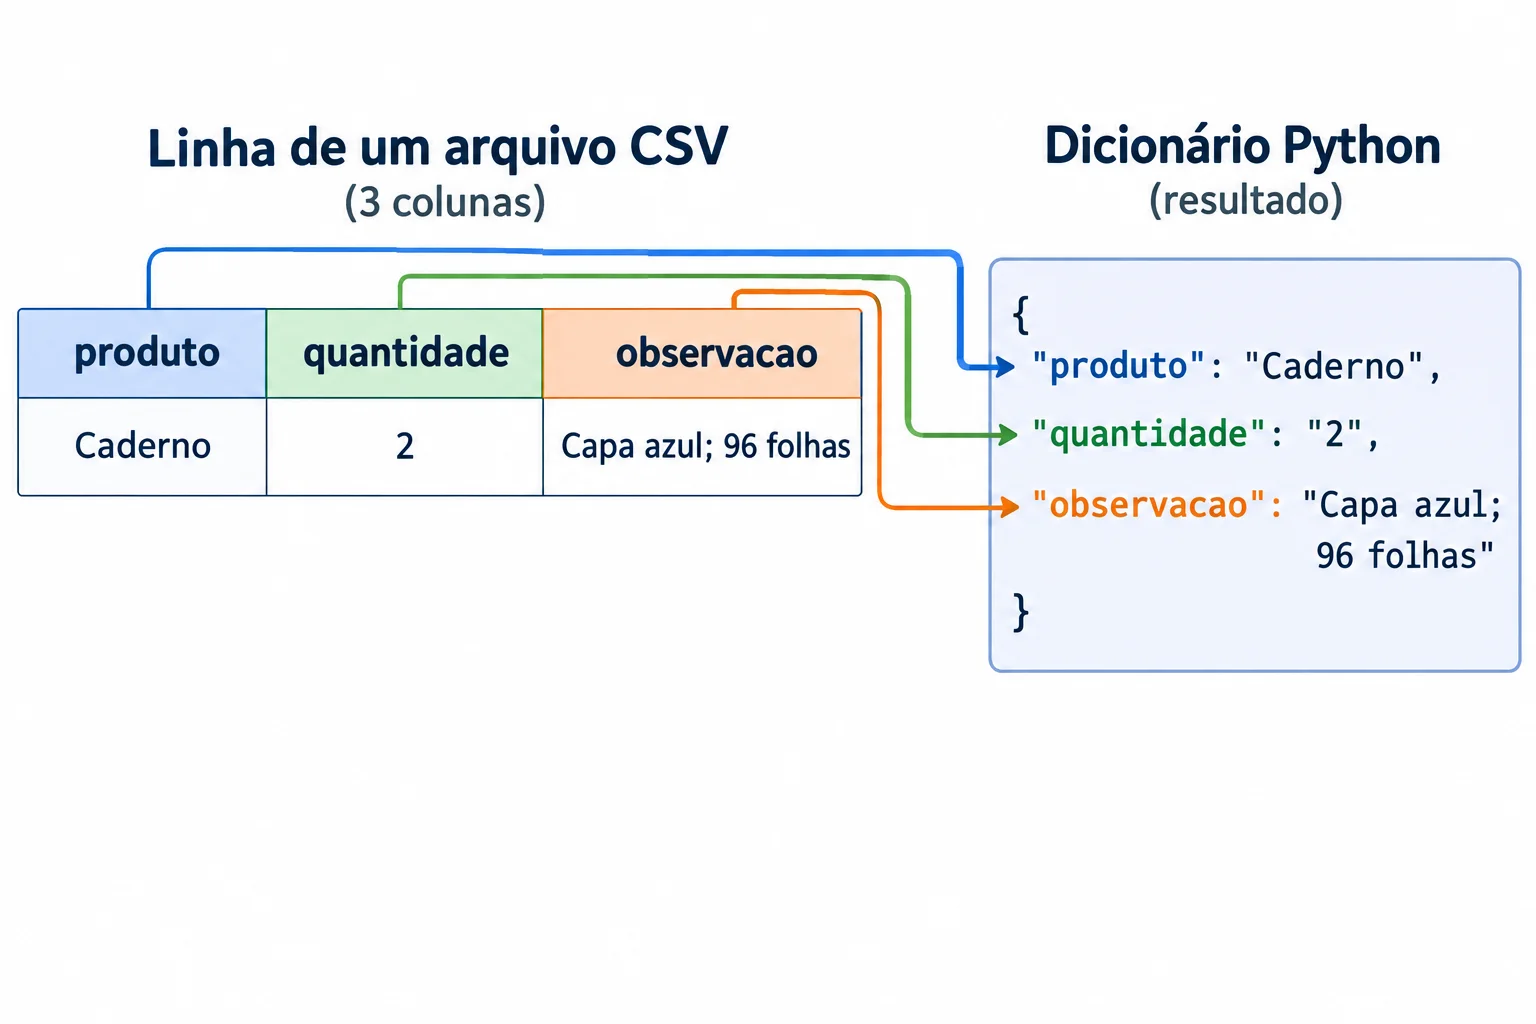
O primeiro registro de dados resulta em um dicionário com produto igual a Caderno, quantidade igual ao texto 2 e observacao igual a Capa azul; 96 folhas.
Exemplo
Para o primeiro registro de dados, o resultado corresponde a:
{'produto': 'Caderno', 'quantidade': '2', 'observacao': 'Capa azul; 96 folhas'}
O ponto e vírgula dentro da observação é preservado como parte do campo.
Para abrir o arquivo UTF-8 corretamente para o módulo csv, complete o argumento:
with caminho.open(mode="r", encoding="utf-8", newline=____) as arquivo:
Qual dicionário o DictReader produz para a linha Caneta;5;Ponta fina?
Passo 3 de 8
Verifique as colunas declaradas pelo arquivo antes de percorrer e processar seus registros.
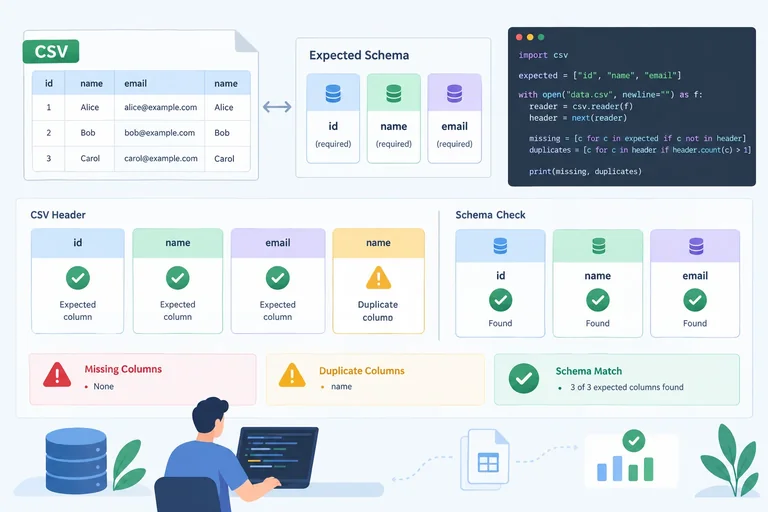
Ao criar um DictReader sem fornecer fieldnames, o primeiro registro do CSV é usado como cabeçalho. Consulte reader.fieldnames antes do for e compare os nomes recebidos com as colunas exigidas pela aplicação: produto, quantidade e observacao.
A ordem pode variar, pois cada valor será acessado pela chave correspondente. Assim, observacao;produto;quantidade é válido. Já nomes ausentes, inesperados, vazios ou repetidos devem interromper a importação antes do processamento dos registros.
Se o arquivo estiver vazio, fieldnames será None. Se a primeira linha contiver dados em vez de um cabeçalho, o DictReader a interpretará como cabeçalho; a comparação com as colunas esperadas normalmente revelará a incompatibilidade.
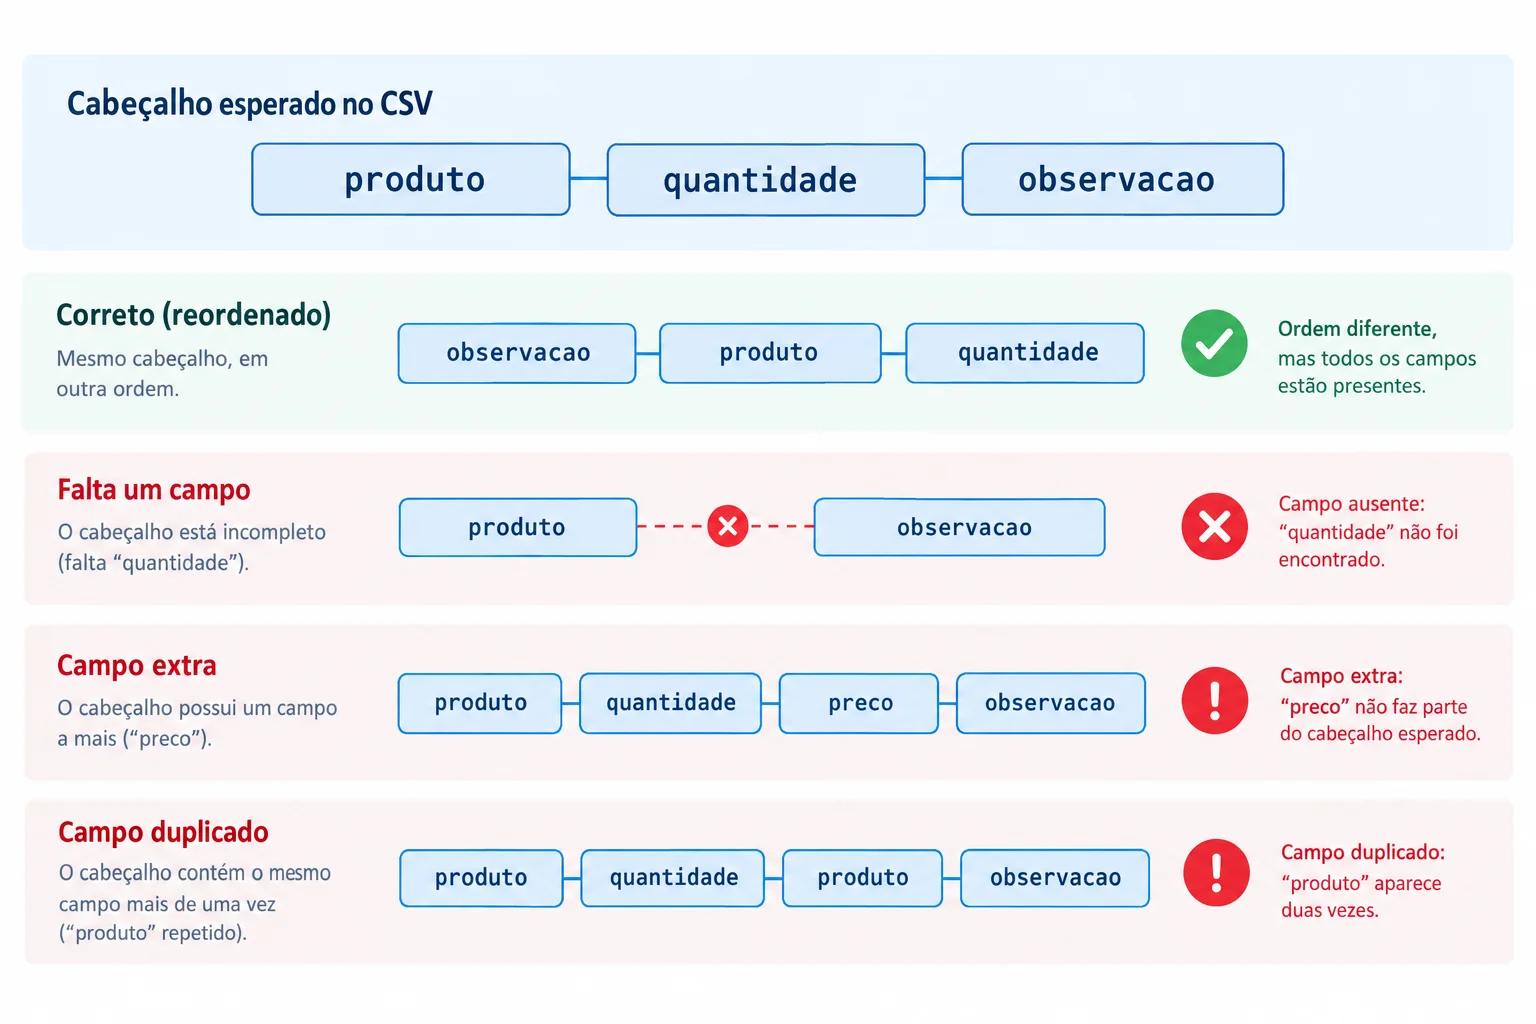
A ordem diferente é aceita; ausência, excesso, vazio ou repetição de nomes tornam o cabeçalho inválido.
Detecte nomes vazios e repetidos antes de converter o cabeçalho em conjunto. Um conjunto eliminaria as repetições e poderia esconder justamente o defeito que precisa ser informado.
import csv

COLUNAS_ESPERADAS = {"produto", "quantidade", "observacao"}


def validar_cabecalho(reader):
    cabecalho = reader.fieldnames

    if cabecalho is None:
        raise ValueError("arquivo vazio: cabeçalho ausente")

    posicoes_vazias = [
        indice
        for indice, nome in enumerate(cabecalho, start=1)
        if nome.strip() == ""
    ]
    if posicoes_vazias:
        raise ValueError(
            f"cabeçalho com nome vazio nas posições {posicoes_vazias}"
        )

    repetidos = sorted({
        nome for nome in cabecalho if cabecalho.count(nome) > 1
    })
    if repetidos:
        raise ValueError(
            f"cabeçalho com nomes repetidos: {repetidos}"
        )

    recebidas = set(cabecalho)
    ausentes = sorted(COLUNAS_ESPERADAS - recebidas)
    inesperadas = sorted(recebidas - COLUNAS_ESPERADAS)

    if ausentes or inesperadas:
        detalhes = []
        if ausentes:
            detalhes.append(f"colunas ausentes: {ausentes}")
        if inesperadas:
            detalhes.append(f"colunas inesperadas: {inesperadas}")
        raise ValueError("cabeçalho incompatível: " + "; ".join(detalhes))


with open("cadastro.csv", encoding="utf-8", newline="") as arquivo:
    reader = csv.DictReader(arquivo, delimiter=";")
    validar_cabecalho(reader)

    for registro in reader:
        print(registro)
Atenção
Em um cabeçalho como produto;produto;observacao, as duas primeiras colunas produzem a mesma chave. Ao montar o dicionário, um valor pode substituir o outro. Por isso, procure nomes repetidos antes de comparar apenas os conjuntos de colunas e antes de acessar qualquer registro.
Considere que o delimitador já foi configurado como ponto e vírgula. Associe cada cabeçalho ao diagnóstico correto.
Toque em um item e depois no par correspondente.
Passo 4 de 8
Identifique campos vazios, ausentes e excedentes nos dicionários produzidos por DictReader e diferencie o número do registro da linha física consumida.
Depois de validar o cabeçalho, verifique a estrutura de cada registro antes de acessar ou converter seus valores.
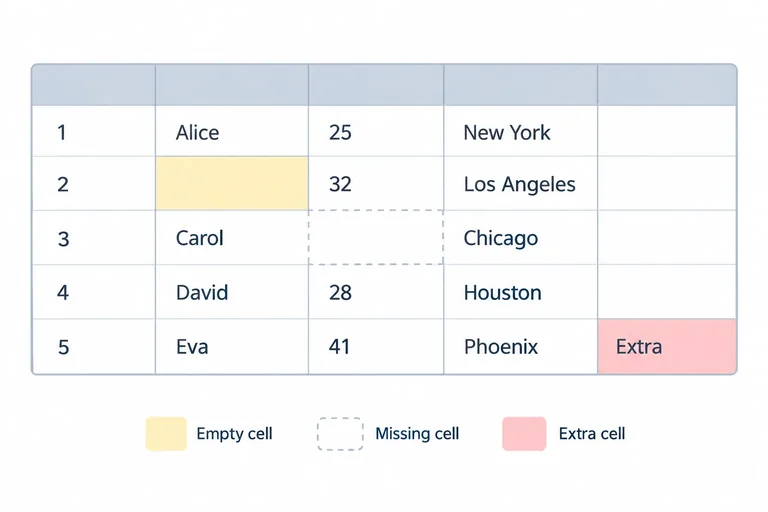
Com as colunas produto, quantidade e observacao, o DictReader representa situações diferentes assim:
"".None na coluna sem correspondência.None associada a uma lista com os valores que sobraram.A chave None indica excesso de campos; um valor None em uma coluna esperada indica falta de campo.
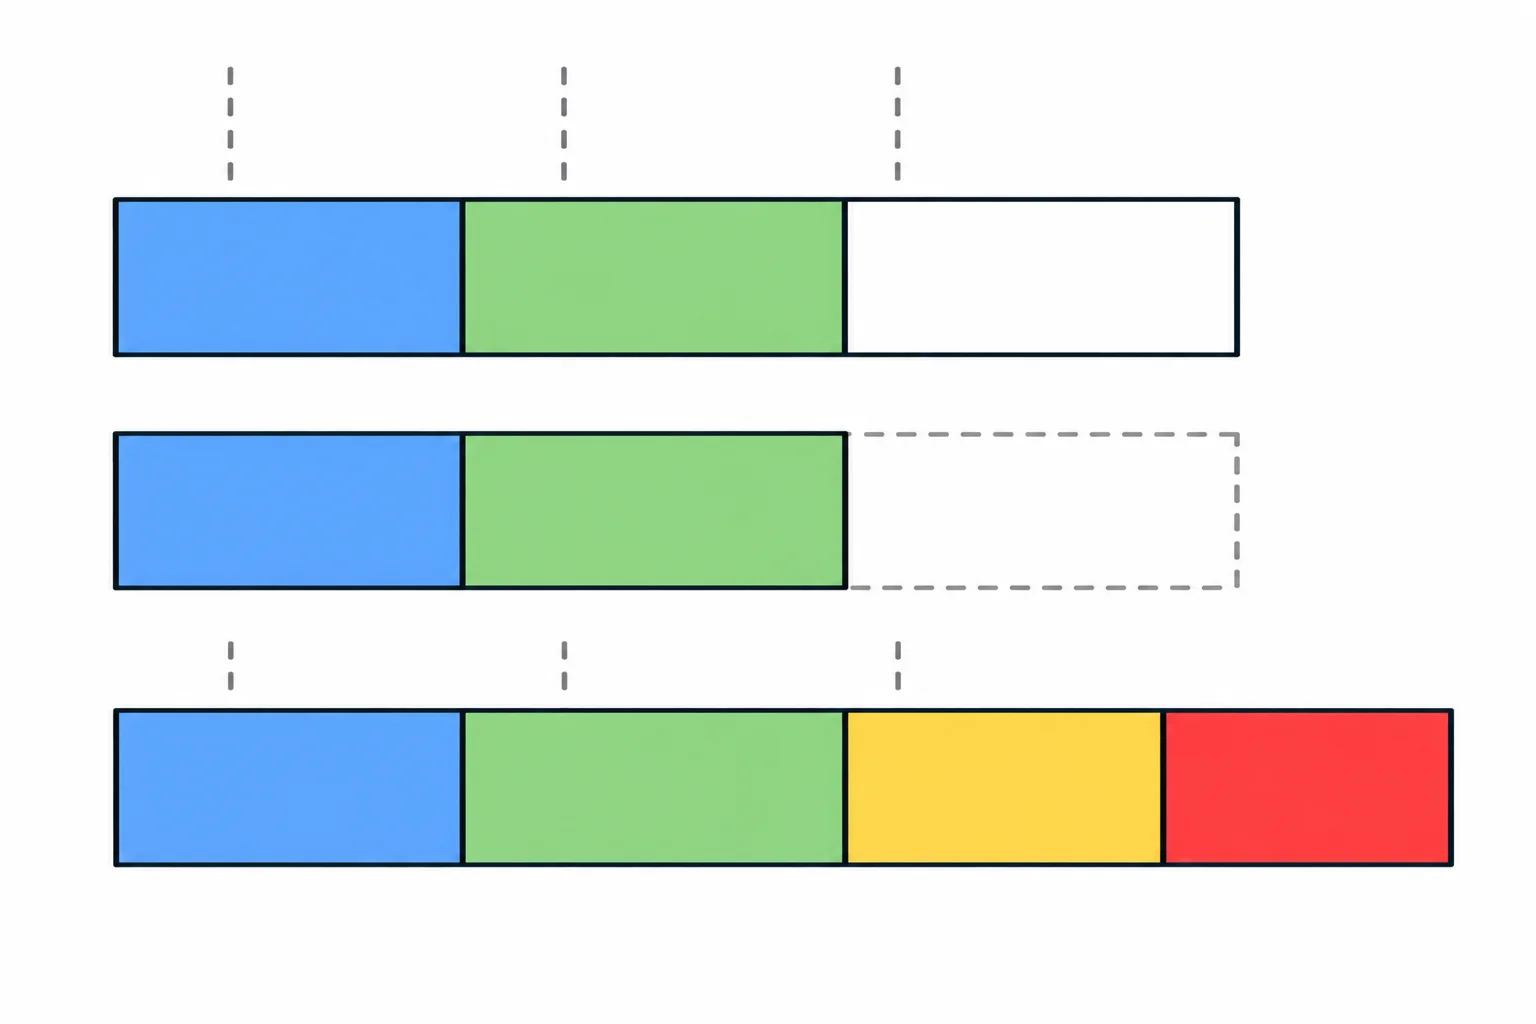
A célula vazia ainda ocupa sua coluna; a ausente não foi fornecida; a excedente ultrapassa a estrutura esperada.
Considere que o cabeçalho válido contém três colunas. Estes são os resultados conceituais produzidos para cada registro:
# produto;quantidade;observacao

# Caderno;5;
{
    "produto": "Caderno",
    "quantidade": "5",
    "observacao": "",
}

# Lápis;10
{
    "produto": "Lápis",
    "quantidade": "10",
    "observacao": None,
}

# Borracha;3;Branca;Escolar
{
    "produto": "Borracha",
    "quantidade": "3",
    "observacao": "Branca",
    None: ["Escolar"],
}
Dica
Primeiro procure campos excedentes e ausentes. Somente depois acesse os conteúdos para aplicar conversões ou regras de valor. Uma string vazia pode ser permitida pela aplicação; None indica que o campo nem sequer estava presente no registro.
Use enumerate(reader, start=1) para numerar os registros de dados sem contar o cabeçalho. Um registro continua recebendo um único número mesmo quando um campo entre aspas ocupa várias linhas físicas.
Depois que o DictReader entrega um registro com sucesso, reader.line_num indica a última linha física consumida naquele momento. Esse valor oferece contexto, mas não substitui o número do registro lógico.
Este trecho pressupõe que reader já foi configurado e que seu cabeçalho já foi validado:
colunas = ["produto", "quantidade", "observacao"]

for numero_registro, registro in enumerate(reader, start=1):
    linha_fisica_final = reader.line_num

    if None in registro:
        excedentes = registro[None]
        raise ValueError(
            f"Registro {numero_registro} tem campos excedentes: "
            f"{excedentes!r}. Última linha física consumida: "
            f"{linha_fisica_final}."
        )

    ausentes = [
        coluna
        for coluna in colunas
        if registro[coluna] is None
    ]

    if ausentes:
        raise ValueError(
            f"Registro {numero_registro} não contém os campos: "
            f"{ausentes!r}. Última linha física consumida: "
            f"{linha_fisica_final}."
        )

    # Somente agora é seguro acessar e validar os conteúdos.
Atenção
reader.line_num indica até qual linha física a leitura avançou. Se um registro ocupar várias linhas, ele normalmente será diferente do número obtido por enumerate. Não descreva esse valor como se fosse sempre a linha exata onde o problema começou.
Relacione a representação produzida pelo DictReader com a situação do registro.
Toque em um item e depois no par correspondente.
Considere este conteúdo:
produto;quantidade;observacaoCaneca;2;AzulAgenda;1;"Capa duracom elástico"
Ao entregar o registro da Agenda, quais valores correspondem a numero_registro e reader.line_num?
Passo 5 de 8
Converta os textos lidos do CSV para os valores esperados pela aplicação e rejeite registros inválidos com diagnósticos específicos.
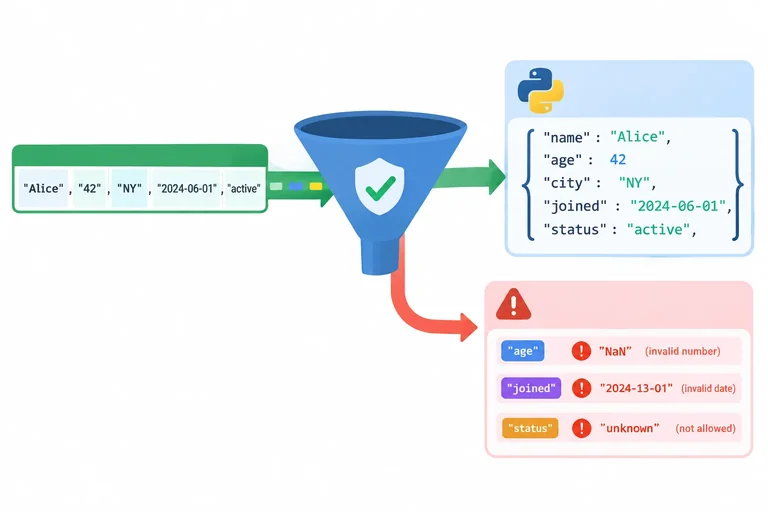
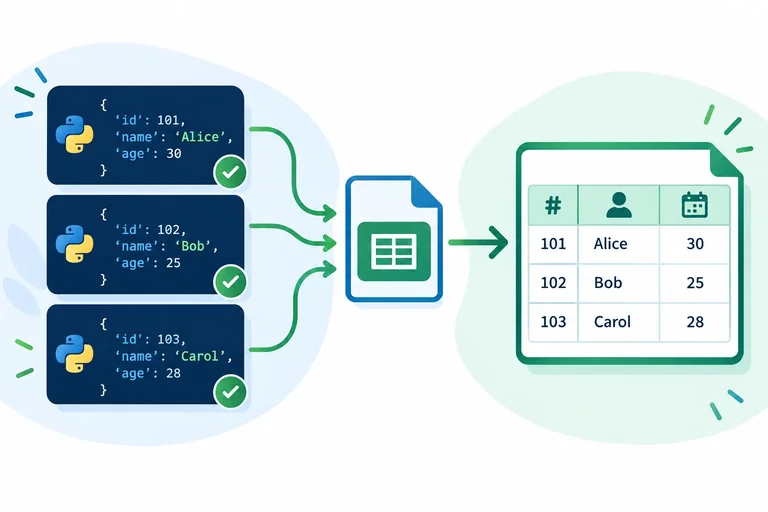
Na configuração adotada, os campos presentes chegam pelo DictReader como strings. Assim, "12" não é o inteiro 12: a aplicação precisa fazer a conversão explicitamente.
Para o cadastro deste tutorial:
produto permanece texto e não pode estar vazio nem conter apenas espaços;quantidade deve ser convertida com int e resultar em um inteiro maior ou igual a zero;observacao permanece texto e pode ser "".Essa validação ocorre depois de confirmar o cabeçalho e a quantidade de campos do registro.
A aplicação converte apenas quantidade. produto e observacao continuam sendo textos.
Esta função pressupõe que o cabeçalho e a estrutura do registro já foram validados. Ela cria um novo dicionário, em vez de misturar os textos de entrada com os valores aprovados.
def converter_registro(registro, numero_registro):
    produto = registro["produto"]
    quantidade_texto = registro["quantidade"]
    observacao = registro["observacao"]

    if not produto.strip():
        raise ValueError(
            f"Registro {numero_registro}, campo produto: "
            "deve conter algum caractere diferente de espaço"
        )

    try:
        quantidade = int(quantidade_texto)
    except ValueError:
        raise ValueError(
            f"Registro {numero_registro}, campo quantidade: "
            f"{quantidade_texto!r} não representa um número inteiro"
        ) from None

    if quantidade < 0:
        raise ValueError(
            f"Registro {numero_registro}, campo quantidade: "
            "deve ser maior ou igual a zero"
        )

    return {
        "produto": produto,
        "quantidade": quantidade,
        "observacao": observacao,
    }
Dica
Se int(quantidade_texto) falhar, o texto não representa um inteiro. Se a conversão funcionar, mas o resultado for negativo, houve uma violação da regra da aplicação. Separar os casos produz diagnósticos mais úteis.
Exemplo
Os três valores de observacao abaixo são válidos e devem ser preservados exatamente como foram interpretados pelo módulo csv:
"" — observação vazia;Frágil; manter na vertical — contém o delimitador do arquivo;Cliente disse "entregar amanhã" — contém aspas;Primeira linha\nSegunda linha — contém uma quebra de linha interna.Não aplique strip, split nem substituições indiscriminadas à observação. Esses procedimentos poderiam apagar espaços, aspas ou quebras de linha que fazem parte do conteúdo.
Converta os registros em ordem e acumule apenas os novos dicionários validados. Neste fluxo, a política é interromper a importação no primeiro registro inválido. A exportação só deve começar depois que todos os registros de entrada forem aprovados; assim, uma falha de validação não inicia a criação da saída.
Analise estes registros como se a estrutura de todos já tivesse sido aprovada:
{"produto": "Caderno", "quantidade": "4", "observacao": "Capa azul"}{"produto": "Caneta", "quantidade": "duas", "observacao": ""}{"produto": "Borracha", "quantidade": "-1", "observacao": "Estoque ajustado"}{"produto": " ", "quantidade": "3", "observacao": ""}Indique quais seriam válidos se analisados isoladamente, classifique o motivo de cada rejeição e informe o tipo de quantidade após uma conversão bem-sucedida. Depois, considerando a política de parar na primeira falha, diga onde a importação seria interrompida e se a exportação poderia começar.
Escreva pelo menos 80 caracteres (0/80).
Passo 6 de 8
Use DictWriter para definir a ordem das colunas, gravar registros validados e conferir os dados por meio de uma nova leitura.
Na exportação, fieldnames define quais colunas serão gravadas e em que ordem. Essa ordem não depende da disposição das chaves em cada dicionário.
Abra um caminho de saída diferente da entrada, em modo texto, com o encoding escolhido e newline="". O delimitador também deve ser explícito e compatível com o arquivo que você deseja produzir.
O DictWriter consulta cada valor pela chave e o posiciona na coluna indicada por fieldnames.
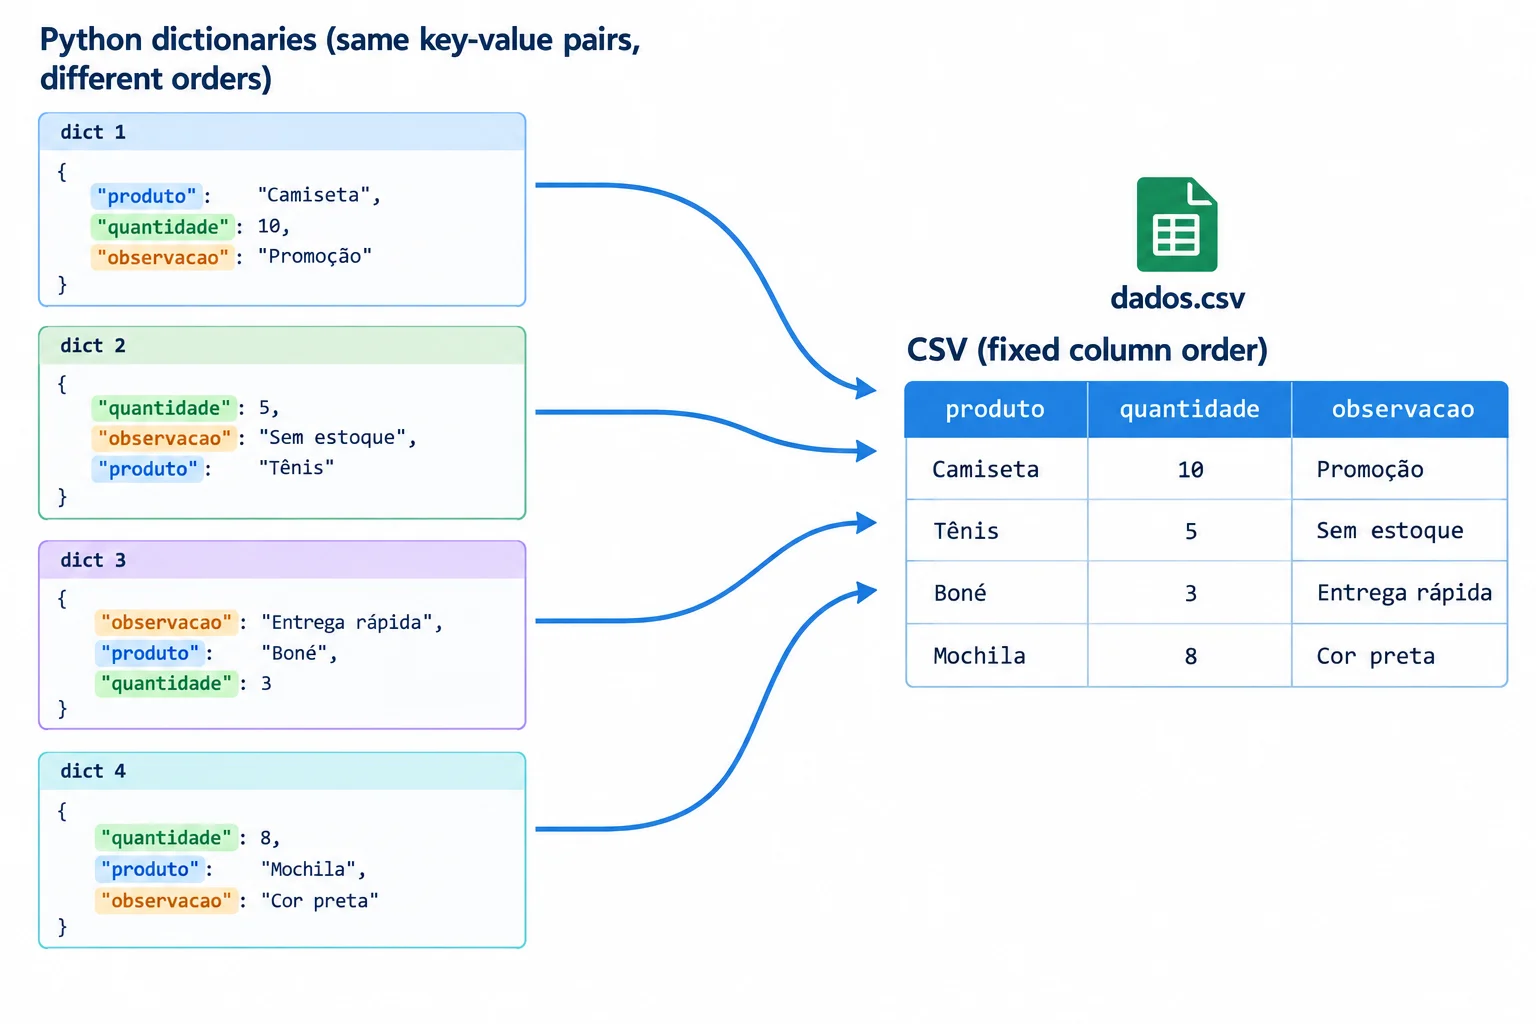
Mesmo que as chaves apareçam em ordens diferentes, a saída segue a sequência definida em fieldnames.
Este exemplo usa registros que já passaram pelas validações de estrutura e valores.
import csv
from pathlib import Path

colunas = ["produto", "quantidade", "observacao"]

registros = [
    {
        "observacao": "pacote; 500 g",
        "quantidade": 12,
        "produto": "Café",
    },
    {
        "produto": "Caneca",
        "observacao": 'Ela disse "frágil".',
        "quantidade": 3,
    },
    {
        "quantidade": 5,
        "observacao": "capa\nazul",
        "produto": "Caderno",
    },
]

caminho_saida = Path("cadastro_exportado.csv")

with caminho_saida.open(
    "w", encoding="utf-8", newline=""
) as arquivo:
    writer = csv.DictWriter(
        arquivo,
        fieldnames=colunas,
        delimiter=";",
    )
    writer.writeheader()
    writer.writerows(registros)

print(f"Arquivo gravado: {caminho_saida}")writeheader() grava o cabeçalho na ordem de fieldnames. Depois, writerows() grava todos os registros validados.
O escritor acrescenta as aspas necessárias para preservar o ponto e vírgula, as aspas internas e a quebra de linha dentro de observacao. Não monte as linhas com join nem tente escapar esses caracteres manualmente.
Exemplo
O conteúdo será equivalente a:
produto;quantidade;observacao
Café;12;"pacote; 500 g"
Caneca;3;"Ela disse ""frágil""."
Caderno;5;"capa
azul"
O último registro ocupa duas linhas físicas porque a quebra de linha faz parte do campo observacao.
Atenção
O modo "w" pode truncar um arquivo existente assim que ele é aberto. Use um caminho de saída diferente do caminho de entrada. A escrita deve começar somente depois que todos os registros tiverem sido validados.
CSV armazena representações textuais. Por isso, ao reler a saída com DictReader, quantidade volta como texto. Reaplique int antes de comparar o registro relido com o dicionário validado.
A verificação deve comparar os conteúdos dos campos, não os bytes dos arquivos: detalhes como terminadores de linha podem variar sem alterar os dados tabulares.
Execute este trecho depois do código de exportação.
registros_relidos = []

with caminho_saida.open(
    "r", encoding="utf-8", newline=""
) as arquivo:
    reader = csv.DictReader(arquivo, delimiter=";")

    for registro in reader:
        registros_relidos.append(
            {
                "produto": registro["produto"],
                "quantidade": int(registro["quantidade"]),
                "observacao": registro["observacao"],
            }
        )

print(registros_relidos == registros)
# Resultado esperado: TrueAntes de aplicar int, como o primeiro registro é entregue pelo DictReader?
Ordene as etapas para exportar os registros já validados.
Passo 7 de 8
Classifique falhas de formato, conteúdo, codificação e acesso para interromper o fluxo no estágio correto.
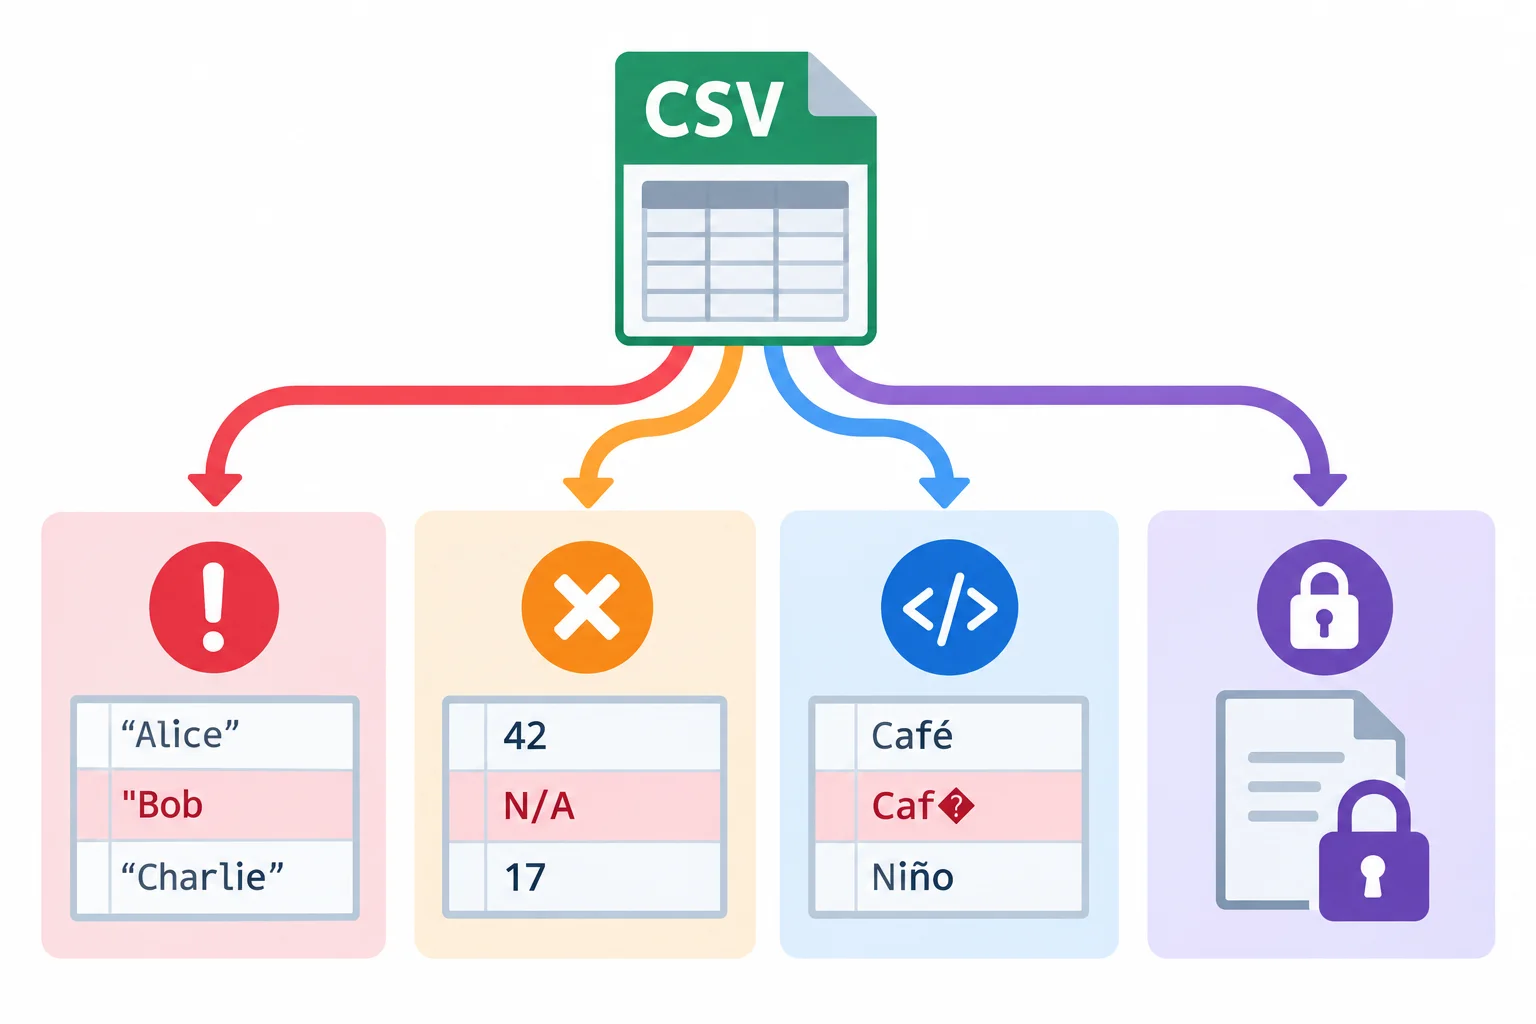
Ao criar um DictReader, use strict=True para tornar mais rigorosa a interpretação do formato. Um campo entre aspas que chega ao fim do arquivo sem fechar as aspas, por exemplo, pode provocar csv.Error durante o percurso dos registros.
Isso não torna o arquivo válido para sua aplicação. Cabeçalho incorreto ou repetido, campos a mais ou a menos e valores como quantidade="dez" ainda exigem as validações explícitas dos passos anteriores.
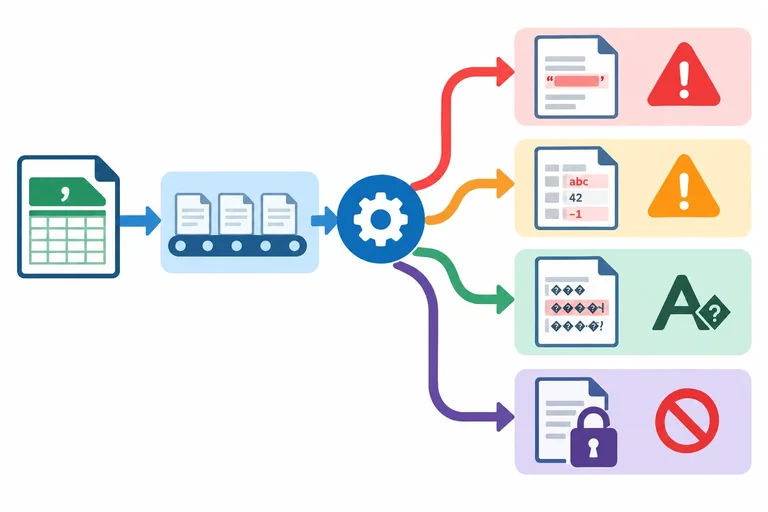
A etapa em que a falha ocorre ajuda a classificá-la: interpretação do CSV, validação dos dados, conversão de caracteres ou acesso ao arquivo.
Não trate todas as falhas como se fossem um único “erro de CSV”.
Criar o DictReader não consome todos os registros. Por isso, o try precisa envolver também o for: uma falha de formato ou codificação pode aparecer somente quando o trecho problemático for lido.
No fluxo abaixo, a exportação começa apenas no else, depois que a importação inteira termina com sucesso.
O exemplo mantém tratamentos específicos e não inicia a escrita quando a entrada falha.
import csv

COLUNAS = ["produto", "quantidade", "observacao"]


def importar(caminho):
    registros = []

    with open(caminho, "r", encoding="utf-8", newline="") as arquivo:
        reader = csv.DictReader(
            arquivo,
            delimiter=";",
            strict=True,
        )

        cabecalho = reader.fieldnames
        if cabecalho is None:
            raise ValueError("cabeçalho ausente")
        if "" in cabecalho:
            raise ValueError("nome de coluna vazio")
        if len(cabecalho) != len(set(cabecalho)):
            raise ValueError("nome de coluna repetido")
        if set(cabecalho) != set(COLUNAS):
            raise ValueError("colunas incompatíveis")

        for numero, registro in enumerate(reader, start=1):
            if None in registro:
                raise ValueError(f"registro {numero}: campos excedentes")
            if any(valor is None for valor in registro.values()):
                raise ValueError(f"registro {numero}: campos ausentes")

            try:
                quantidade = int(registro["quantidade"])
            except ValueError as erro:
                raise ValueError(
                    f"registro {numero}, campo quantidade: inteiro inválido"
                ) from erro

            if quantidade < 0:
                raise ValueError(
                    f"registro {numero}, campo quantidade: valor negativo"
                )

            registros.append({
                "produto": registro["produto"],
                "quantidade": quantidade,
                "observacao": registro["observacao"],
            })

    return registros


def exportar(caminho, registros):
    with open(caminho, "w", encoding="utf-8", newline="") as arquivo:
        writer = csv.DictWriter(
            arquivo,
            fieldnames=COLUNAS,
            delimiter=";",
        )
        writer.writeheader()
        writer.writerows(registros)


entrada = "cadastro.csv"
saida = "cadastro_validado.csv"

try:
    dados = importar(entrada)
except csv.Error as erro:
    print(f"Formato CSV inválido em {entrada}: {erro}")
except UnicodeDecodeError as erro:
    print(f"Não foi possível decodificar {entrada}: {erro}")
except OSError as erro:
    print(f"Falha de acesso a {entrada}: {erro}")
except ValueError as erro:
    print(f"Conteúdo inválido em {entrada}: {erro}")
else:
    try:
        exportar(saida, dados)
    except UnicodeEncodeError as erro:
        print(f"Não foi possível codificar {saida}: {erro}")
    except OSError as erro:
        print(f"Falha ao gravar {saida}: {erro}")
    else:
print(f"Dados exportados para {saida}")Um diagnóstico útil identifica o caminho, a categoria e, quando conhecido, o registro ou campo afetado. reader.line_num pode indicar a última linha física consumida após um registro lido com sucesso, mas não deve ser apresentado como a posição exata de todo csv.Error.
As categorias principais são: csv.Error para certas falhas de interpretação; ValueError para conversões e regras da aplicação; UnicodeDecodeError ou UnicodeEncodeError para codificação; e OSError para acesso e gravação.
Atenção
Se a importação falhar, não inicie a exportação. Se a escrita já começou e depois ocorrer uma falha, o arquivo de saída pode ter sido criado, truncado ou parcialmente preenchido. Fechar o arquivo com with libera o recurso, mas não desfaz bytes ou caracteres já gravados.
Associe cada cenário à categoria ou ação adequada.
Toque em um item e depois no par correspondente.
Passo 8 de 8
Execute o fluxo completo de importação, validação, exportação e releitura; depois provoque uma falha de conteúdo e confirme que a saída não é criada.
Você reunirá todo o processo em um script local. Primeiro, ele importa e valida todos os registros. Somente se essa fase terminar sem falhas, o programa inicia a exportação. Por fim, ele relê a saída e compara os valores convertidos.
Crie uma pasta para a prática. Dentro dela, crie os arquivos cadastro_entrada.csv e processar_csv.py com os conteúdos apresentados a seguir.
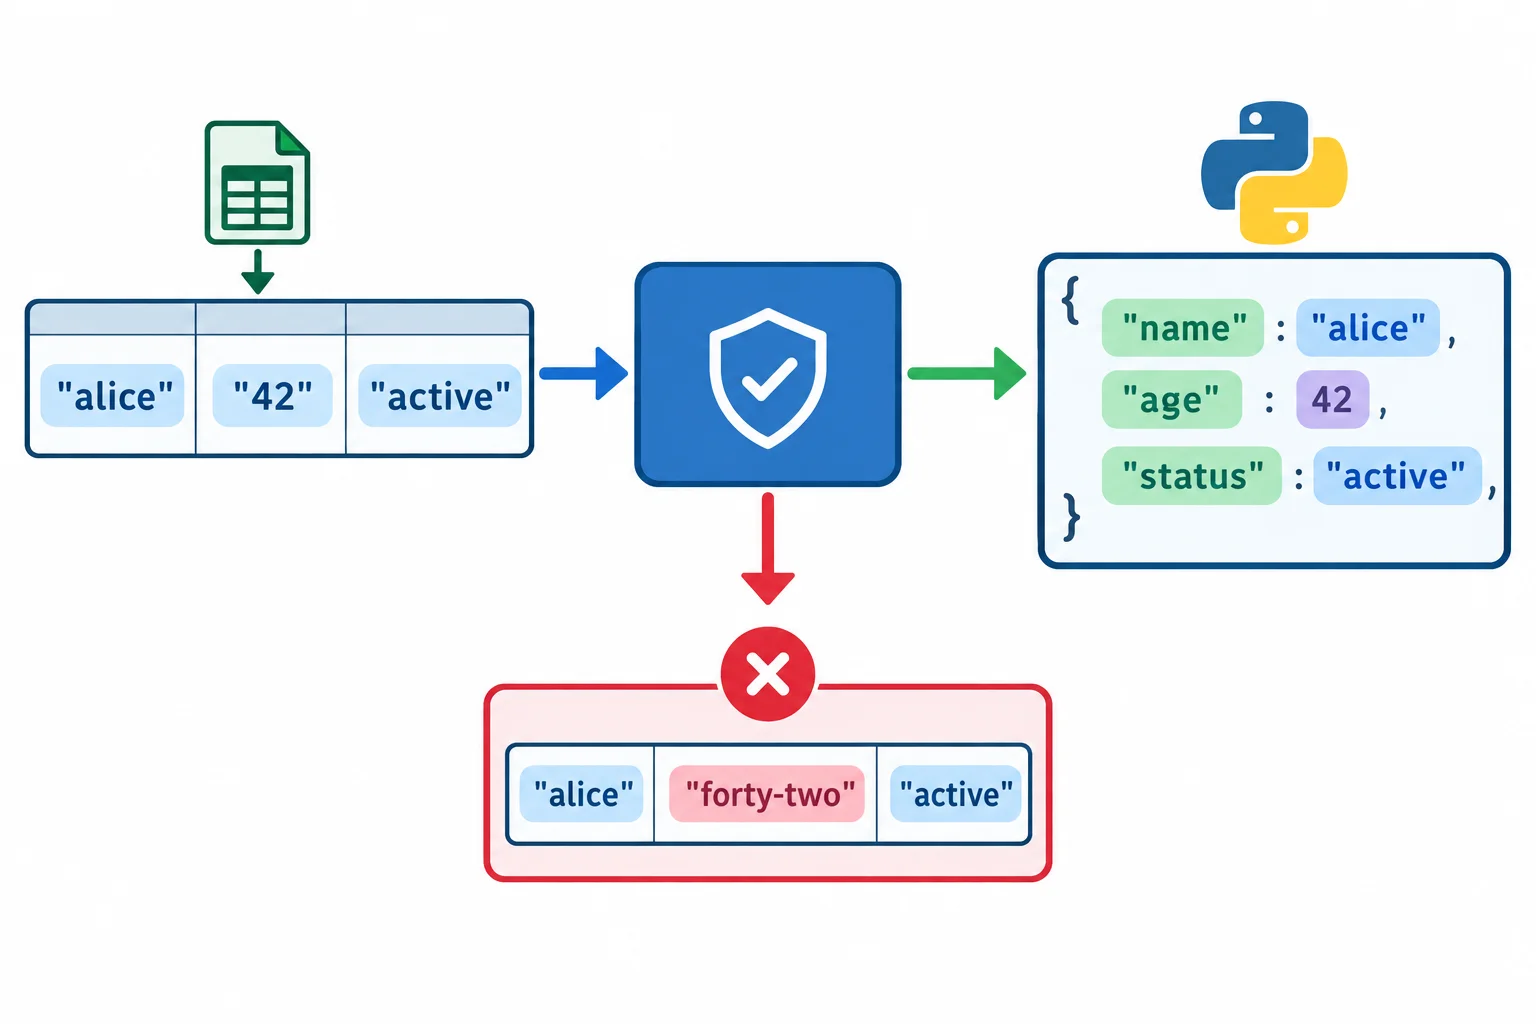
A sequência protege a exportação: configuração da leitura → validação do cabeçalho → validação estrutural → conversão e regras → escrita → releitura e comparação.
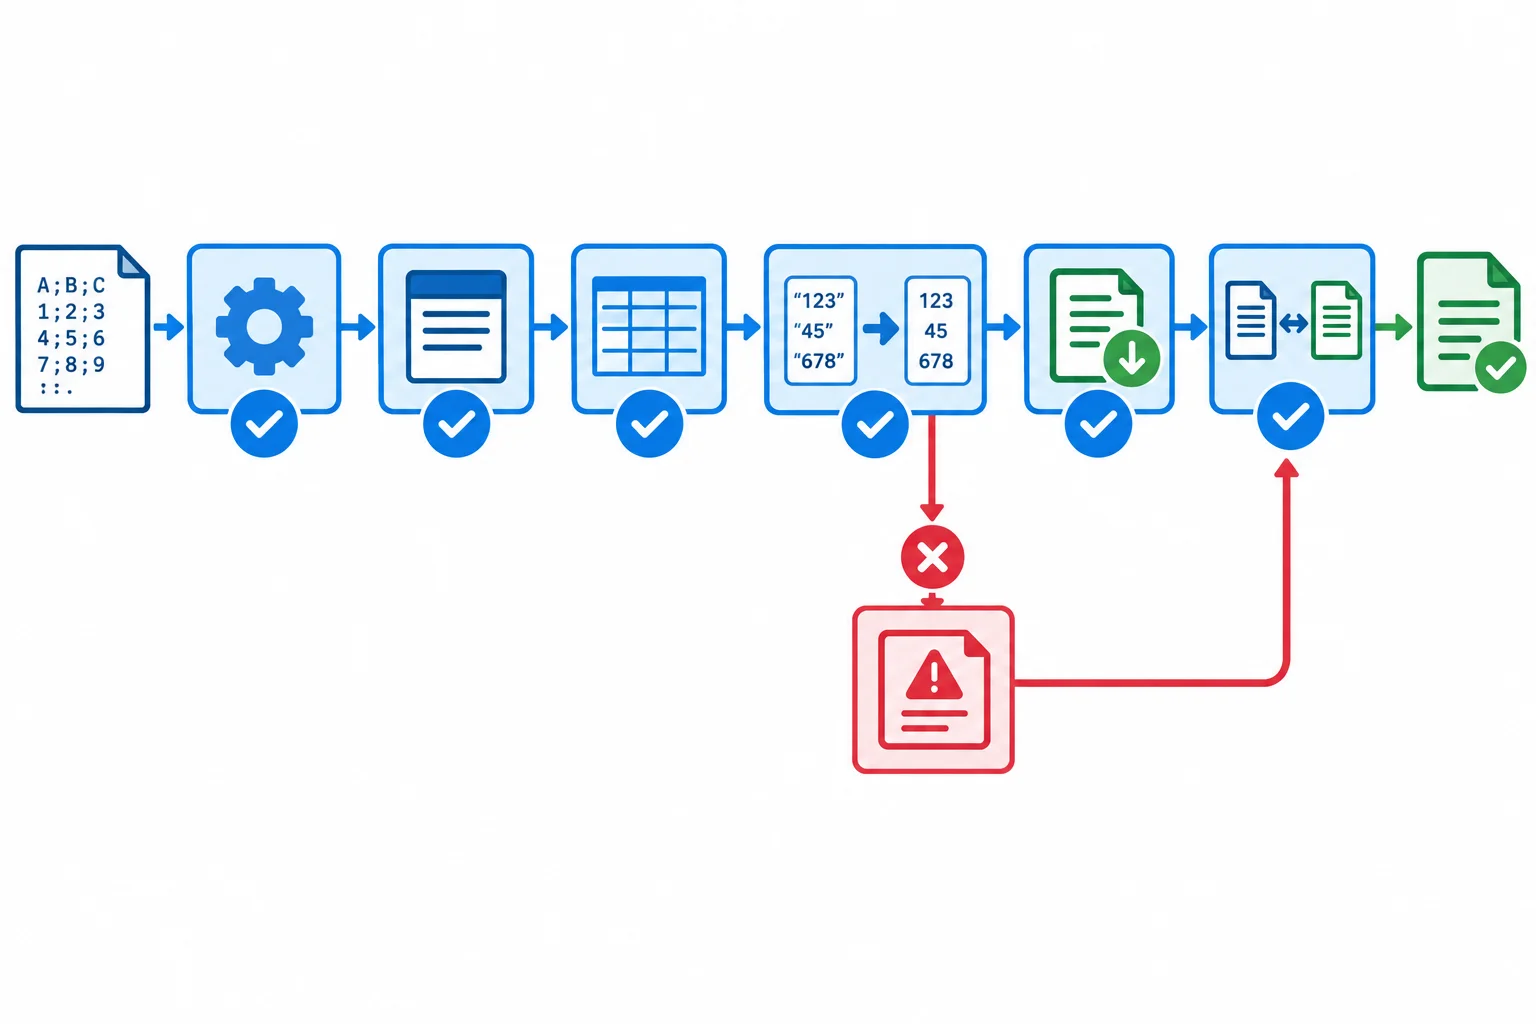
A saída só entra no fluxo depois que todos os registros da entrada passam pelas validações.
Salve exatamente este conteúdo em UTF-8. As aspas protegem o ponto e vírgula, as aspas internas e a quebra de linha que pertencem aos campos.
produto;quantidade;observacao
Caderno;12;"Capa azul; 96 folhas"
Caneta;3;"Modelo ""premium"""
Agenda;1;"Entrega em duas
etapas"
O script mantém as responsabilidades separadas: csv interpreta e escreve o formato; as funções da aplicação verificam colunas, estrutura, tipos e regras. A chamada de exportar_csv está no bloco else da importação, portanto não ocorre quando a entrada falha.
Salve o código na mesma pasta do CSV de entrada e execute python processar_csv.py no terminal dessa pasta.
import csv

COLUNAS = ["produto", "quantidade", "observacao"]
ENTRADA = "cadastro_entrada.csv"
SAIDA = "cadastro_saida.csv"


def validar_cabecalho(nomes):
    if nomes is None:
        raise ValueError("arquivo vazio ou cabeçalho ausente")

    if any(nome == "" for nome in nomes):
        raise ValueError("o cabeçalho contém um nome vazio")

    repetidos = []
    for nome in nomes:
        if nomes.count(nome) > 1 and nome not in repetidos:
            repetidos.append(nome)

    if repetidos:
        raise ValueError(
            f"colunas repetidas no cabeçalho: {repetidos}"
        )

    esperadas = set(COLUNAS)
    recebidas = set(nomes)
    faltantes = sorted(esperadas - recebidas)
    inesperadas = sorted(recebidas - esperadas)

    if faltantes:
        raise ValueError(f"colunas obrigatórias ausentes: {faltantes}")
    if inesperadas:
        raise ValueError(f"colunas inesperadas: {inesperadas}")


def validar_e_converter(linha, numero_registro, linha_fisica):
    extras = linha.get(None)
    if extras is not None:
        raise ValueError(
            f"registro {numero_registro}: campos excedentes {extras}; "
            f"última linha física consumida: {linha_fisica}"
        )

    ausentes = [
        coluna for coluna in COLUNAS if linha[coluna] is None
    ]
    if ausentes:
        raise ValueError(
            f"registro {numero_registro}: campos ausentes {ausentes}; "
            f"última linha física consumida: {linha_fisica}"
        )

    produto = linha["produto"]
    observacao = linha["observacao"]

    if produto.strip() == "":
        raise ValueError(
            f"registro {numero_registro}, campo produto: valor obrigatório"
        )

    try:
        quantidade = int(linha["quantidade"])
    except ValueError:
        raise ValueError(
            f"registro {numero_registro}, campo quantidade: "
            f"{linha['quantidade']!r} não é um inteiro"
        )

    if quantidade < 0:
        raise ValueError(
            f"registro {numero_registro}, campo quantidade: "
            "deve ser maior ou igual a zero"
        )

    return {
        "produto": produto,
        "quantidade": quantidade,
        "observacao": observacao,
    }


def importar_csv(caminho):
    registros = []

    with open(caminho, "r", encoding="utf-8", newline="") as arquivo:
        leitor = csv.DictReader(
            arquivo,
            delimiter=";",
            strict=True,
        )
        validar_cabecalho(leitor.fieldnames)

        for numero, linha in enumerate(leitor, start=1):
            registro = validar_e_converter(
                linha,
                numero_registro=numero,
                linha_fisica=leitor.line_num,
            )
            registros.append(registro)

    return registros


def exportar_csv(caminho, registros):
    with open(caminho, "w", encoding="utf-8", newline="") as arquivo:
        escritor = csv.DictWriter(
            arquivo,
            fieldnames=COLUNAS,
            delimiter=";",
        )
        escritor.writeheader()
        escritor.writerows(registros)


def main():
    try:
        registros = importar_csv(ENTRADA)
    except csv.Error as erro:
        print(f"Falha de formato CSV na importação: {erro}")
    except ValueError as erro:
        print(f"Falha de conteúdo na importação: {erro}")
    except UnicodeDecodeError as erro:
        print(f"Falha de codificação na importação: {erro}")
    except OSError as erro:
        print(f"Falha de acesso à entrada {ENTRADA!r}: {erro}")
    else:
        print(f"Importados: {registros}")

        try:
            exportar_csv(SAIDA, registros)
            relidos = importar_csv(SAIDA)

            if relidos != registros:
                raise ValueError("a releitura produziu valores diferentes")
        except csv.Error as erro:
            print(f"Falha de formato na exportação ou releitura: {erro}")
        except (UnicodeDecodeError, UnicodeEncodeError) as erro:
            print(f"Falha de codificação na exportação ou releitura: {erro}")
        except ValueError as erro:
            print(f"Falha na verificação da saída: {erro}")
        except OSError as erro:
            print(f"Falha de acesso à saída {SAIDA!r}: {erro}")
        else:
            print(f"Exportação concluída: {SAIDA}")
            print(f"Relidos: {relidos}")
            print(f"Ida e volta preservada: {relidos == registros}")


if __name__ == "__main__":
    main()
Dica
O escritor pode escolher uma representação textual válida sem reproduzir cada byte da entrada. A verificação relevante é reler o arquivo, reaplicar as conversões e comparar os conteúdos dos campos.
A execução deve criar cadastro_saida.csv e terminar com Ida e volta preservada: True. Nos valores exibidos, confirme três detalhes:
quantidade aparece como inteiro porque importar_csv aplicou int tanto na entrada quanto na releitura;Capa azul; 96 folhas continua dentro da observação;Modelo "premium" e a quebra de linha de Entrega em duas\netapas foram preservadas.Abra também cadastro_saida.csv em um editor de texto. A coluna quantidade estará novamente representada como texto no arquivo; CSV não registra o tipo Python.
A representação exata do caminho ou de eventuais mensagens do sistema pode variar, mas o caso válido deve terminar assim:
Exportação concluída: cadastro_saida.csv
Relidos: [{'produto': 'Caderno', 'quantidade': 12, 'observacao': 'Capa azul; 96 folhas'}, {'produto': 'Caneta', 'quantidade': 3, 'observacao': 'Modelo "premium"'}, {'produto': 'Agenda', 'quantidade': 1, 'observacao': 'Entrega em duas\netapas'}]
Ida e volta preservada: True
O que você observou na execução válida? Informe se a saída foi criada, como os campos especiais ficaram após a releitura e quando quantidade voltou a ser um inteiro.
Escreva pelo menos 80 caracteres (0/80).
Primeiro, renomeie cadastro_saida.csv para cadastro_saida_valida.csv. Depois, substitua o conteúdo de cadastro_entrada.csv pelo caso abaixo e execute novamente. O segundo registro tem uma quantidade que não pode ser convertida. O resultado esperado é uma falha de conteúdo no registro 2; um novo cadastro_saida.csv não deve ser criado.
produto;quantidade;observacao
Caderno;12;"Capa azul; 96 folhas"
Caneta;x;"Modelo ""premium"""
Agenda;1;"Entrega em duas
etapas"
Relate o resultado real da segunda execução. Qual registro e campo falharam? A falha pertence ao formato CSV, ao conteúdo, à codificação ou ao acesso? Por que a exportação não começou e o que aconteceu com a entrada?
Escreva pelo menos 100 caracteres (0/100).
Resumo
Você integrou leitura, validação, conversão, escrita e verificação sem interpretar linhas com split nem montá-las com join.
csv reconhece registros, delimitadores, aspas e quebras de linha internas e produz uma representação CSV válida.int precisam ser aplicadas novamente para reconstruir os valores usados pela aplicação.Parabéns! Você concluiu: Ler e gravar dados tabulares em CSV
Você concluiu este nível!
Agora você vai iniciar: Modelagem orientada a objetos
 Criar objetos com classes e métodos de instânciaDefinir uma classe simples, inicializar seus objetos e implementar métodos que consultam ou alteram o estado de cada instância.
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks