Passo 1 de 8
Delimitar o rastreamento
Inicie o tracemalloc antes da fase que deseja investigar e encerre-o com segurança ao terminar.
Trilha de aprendizado · Nível 14 · Tutorial 8
Meça o pico de memória rastreada e localize trechos associados ao crescimento de alocações, reconhecendo o que tracemalloc consegue observar.
 Delimitar o rastreamento
Inicie o tracemalloc antes da fase que deseja investigar e encerre-o com segurança ao terminar. 2 min
 Distinguir memória atual e pico
Leia os valores de memória rastreada durante e depois de uma fase temporária. 3 min
 Observar o pico de uma nova fase
Separe a observação de pico de uma fase sem interromper o rastreamento nem perder os blocos que continuam vivos. 2 min
 Localizar blocos vivos em um snapshot
Capture um retrato das alocações ainda vivas e use seus agrupamentos para localizar linhas e arquivos que concentram memória rastreada. 3 min
 Medir crescimento líquido entre snapshots
Compare dois estados de memória rastreada para encontrar locais associados a crescimento ou redução líquidos. 3 min
 Recuperar o contexto da alocação
Use tracebacks de alocação para separar caminhos de chamada que chegam à mesma linha de código, sem confundir origem da alocação com retenção de objetos. 3 min
 Reconhecer os limites da medição
Entenda o que os números do tracemalloc representam — e o que eles não permitem concluir sobre a memória total do processo. 2 min
 Aplicação final: registrar um diagnóstico
Execute uma investigação local completa e transforme as medições em um diagnóstico prudente, com evidências e limites explícitos. 3 min
Passo 1 de 8
Inicie o tracemalloc antes da fase que deseja investigar e encerre-o com segurança ao terminar.
tracemalloc é um módulo da biblioteca padrão que registra blocos de memória alocados por mecanismos rastreados do Python. Para investigar uma operação, chame tracemalloc.start() antes das alocações que fazem parte da pergunta.
O rastreamento não é retroativo: blocos que já existiam quando start() foi chamado não entram nos rastros. Portanto, delimite conscientemente a janela: inclua a preparação se quiser medir seu custo; deixe-a fora se a pergunta for apenas sobre o processamento posterior.
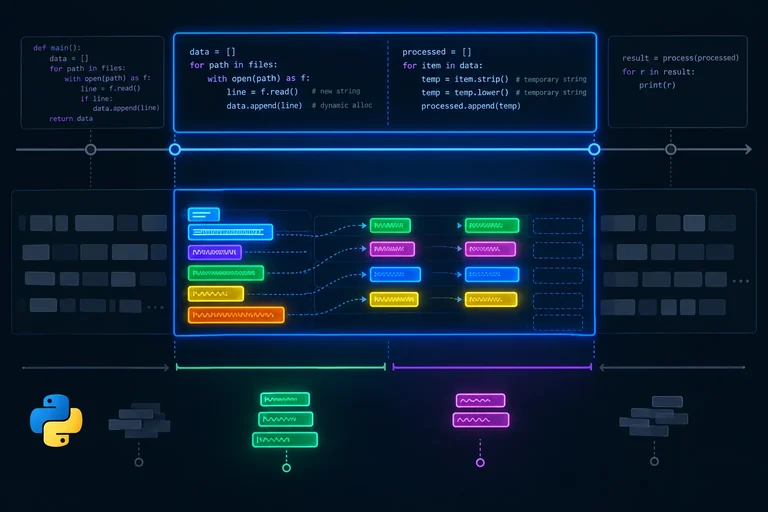
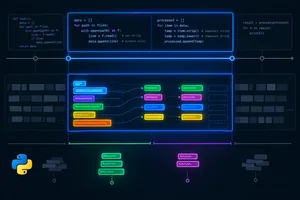
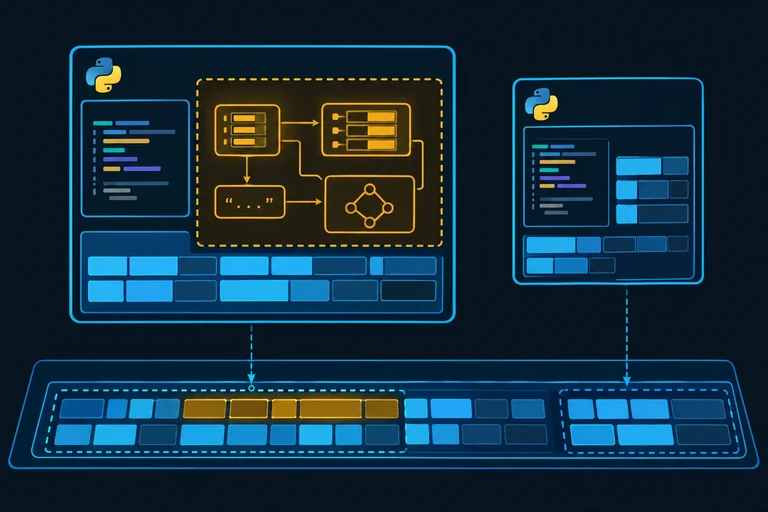
A posição de start() define quais alocações podem ser observadas.
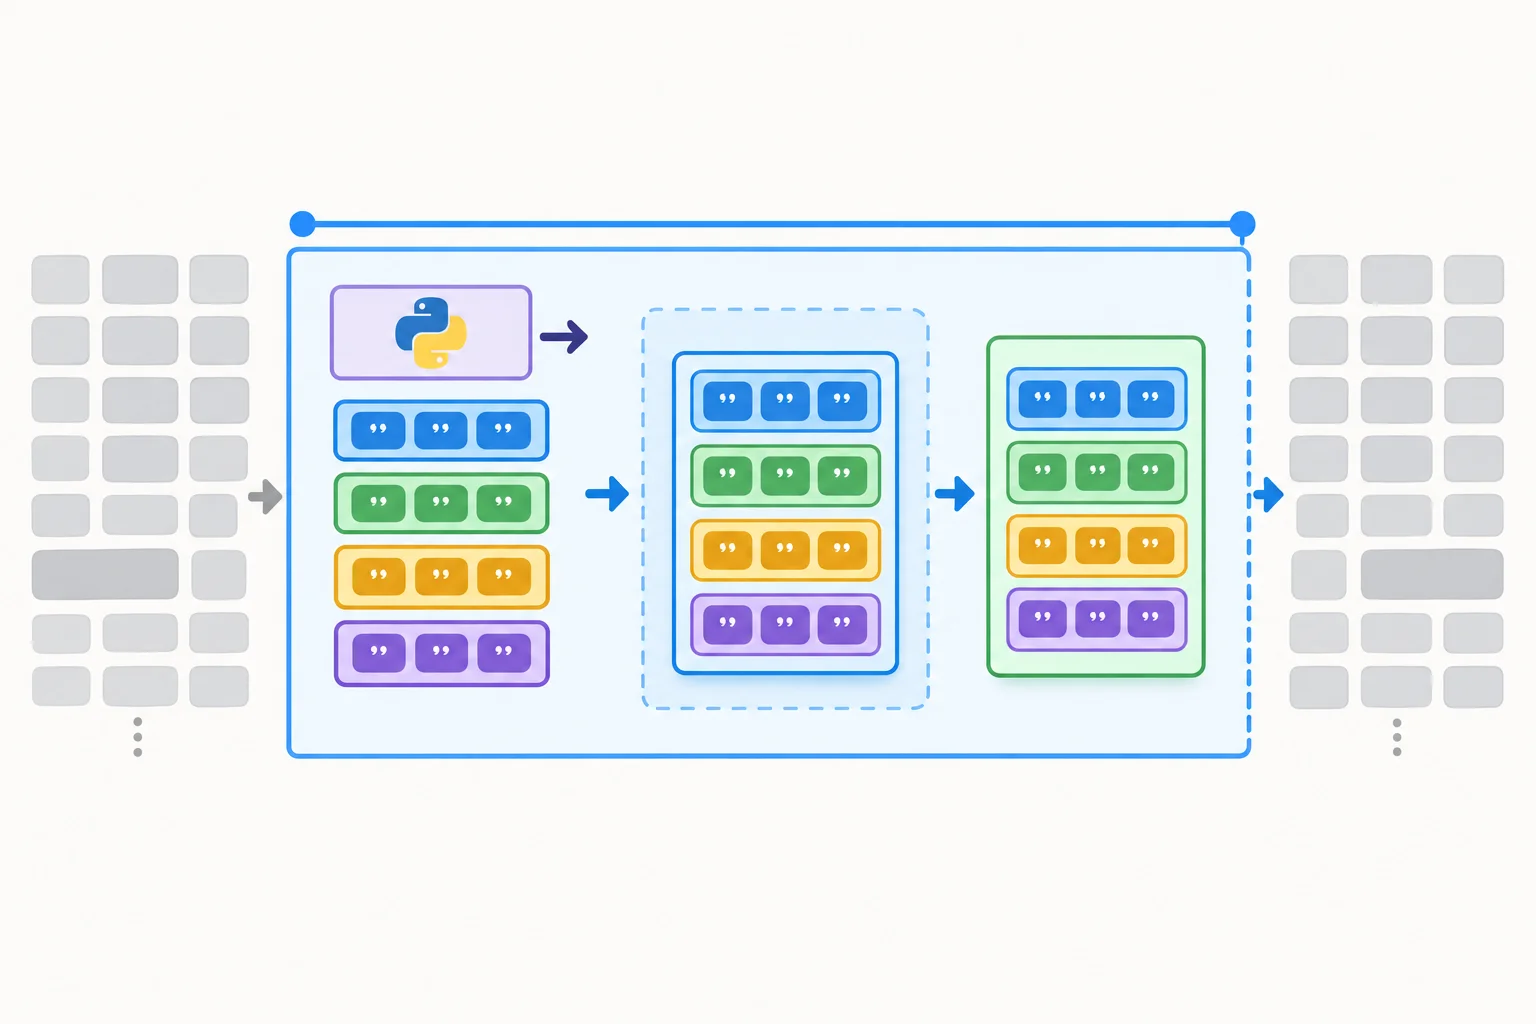
Somente alocações realizadas depois de start() e antes de stop() pertencem a esta sessão de rastreamento.
Neste caso, a preparação ocorre antes do rastreamento. A função cria strings distintas dinamicamente, mantém um resultado retornado e também cria uma lista temporária. Ainda não vamos consultar números: o objetivo agora é estabelecer uma fronteira confiável para as observações dos próximos passos.
import tracemalloc


def preparar_entradas(quantidade: int) -> list[int]:
    return list(range(quantidade))


def processar(valores: list[int]) -> list[str]:
    resultado = [f"registro-{valor}-{'x' * 40}" for valor in valores]
    temporarios = [texto.upper() for texto in resultado]
    del temporarios
    return resultado


entradas = preparar_entradas(5_000)  # fica fora da investigação

tracemalloc.start()
try:
    resultado_mantido = processar(entradas)
    print(f"Resultado mantido: {len(resultado_mantido)} registros")
finally:
    tracemalloc.stop()
Dica
Mantenha stop() em finally. Assim, o rastreamento é interrompido mesmo se a operação investigada gerar uma exceção. stop() também descarta os rastros correntes; uma nova investigação precisa começar outra sessão com start().
Exemplo
Quer investigar também a criação de entradas? Mova tracemalloc.start() para antes de preparar_entradas(5_000). Quer investigar apenas processar? Deixe-o exatamente onde está.
Execute o script no seu computador com python delimitar.py. O resultado retornado continua referenciado por resultado_mantido até o fim do bloco; a lista temporarios é uma fase separada e curta. Nos próximos passos, você medirá o que ocorreu nessa janela.
Organize as ações para investigar somente a função processar.
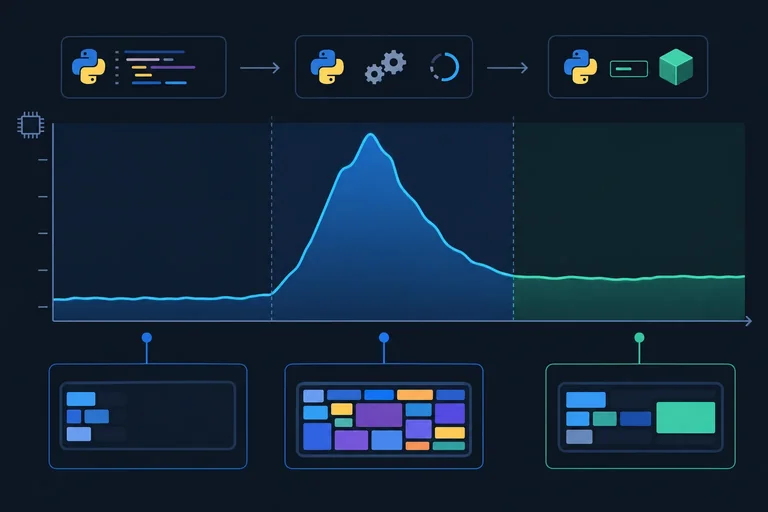
Passo 2 de 8
Leia os valores de memória rastreada durante e depois de uma fase temporária.
Com o rastreamento já ativo, tracemalloc.get_traced_memory() retorna uma tupla em bytes:
atual, pico = tracemalloc.get_traced_memory()atual: tamanho dos blocos rastreados que ainda estão alocados no instante da consulta.pico: maior tamanho de blocos rastreados que coexistiu desde o início do rastreamento.O pico não soma todas as alocações feitas ao longo do programa. Ele registra o maior ponto simultâneo observado.
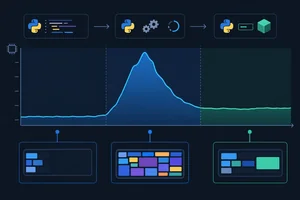
Uma estrutura temporária pode aumentar o pico e depois desaparecer; o resultado mantido ainda contribui para a memória atual.
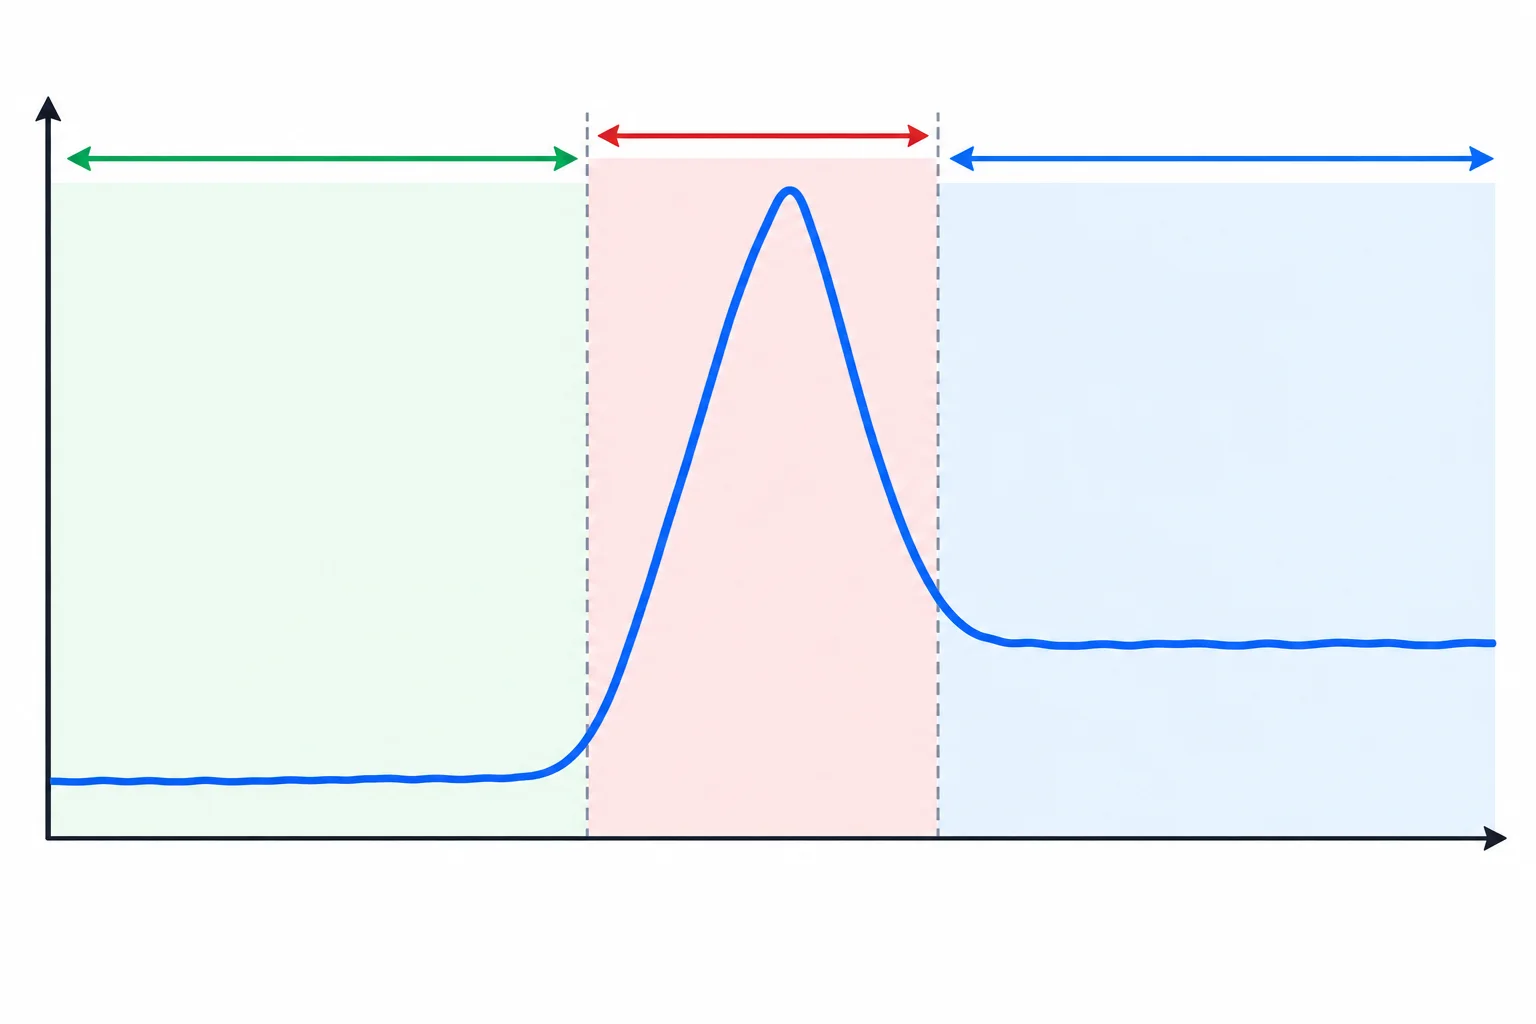
No fim, atual e pico podem ser bem diferentes.
Crie um arquivo, por exemplo medir_pico.py, e execute-o no seu computador com python medir_pico.py. O rastreamento começa antes das alocações que queremos observar e é encerrado mesmo se houver falha.
As strings incluem o índice para que cada elemento seja criado dinamicamente. A lista temporarios deixa de ter referência depois do del, enquanto resultado continua vivo até o fim da medição.
import tracemalloc


def mostrar_memoria(momento: str) -> None:
    atual, pico = tracemalloc.get_traced_memory()
    print(f"{momento:>18}: atual={atual / 1024:.1f} KiB | pico={pico / 1024:.1f} KiB")


def processar() -> list[str]:
    temporarios = [f"registro-temporario-{indice:05d}" for indice in range(40_000)]
    mostrar_memoria("com temporarios")

    resultado = [item.upper() for item in temporarios[:2_000]]
    del temporarios
    return resultado


tracemalloc.start()
try:
    mostrar_memoria("inicio")
    resultado_final = processar()
    mostrar_memoria("apos processar")
    print(f"itens mantidos: {len(resultado_final)}")
finally:
    tracemalloc.stop()
Exemplo
Os números variam conforme versão do Python, sistema e ambiente. Uma execução poderia mostrar:
            inicio: atual=0.2 KiB | pico=0.2 KiB
   com temporarios: atual=3_100.0 KiB | pico=3_100.3 KiB
    apos processar: atual=150.0 KiB | pico=3_250.0 KiB
itens mantidos: 2000
Após processar, a lista temporária não está mais referenciada. Por isso, o valor atual pode cair. O pico preserva o maior nível simultâneo que ocorreu durante a observação.
Depois que uma estrutura temporária é liberada, a memória _ pode diminuir, mas a memória _ continua registrando o maior valor simultâneo observado.
Passo 3 de 8
Separe a observação de pico de uma fase sem interromper o rastreamento nem perder os blocos que continuam vivos.
O valor de pico é o maior tamanho rastreado desde o início do rastreamento — ou desde o último reinício. Se uma fase inicial já atingiu um valor alto, uma fase posterior pode aumentar a memória sem ultrapassar esse máximo; nesse caso, o pico global não revela o comportamento da nova fase.
Use tracemalloc.reset_peak() imediatamente antes da fase que você quer observar.
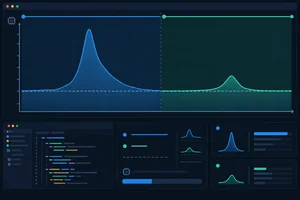
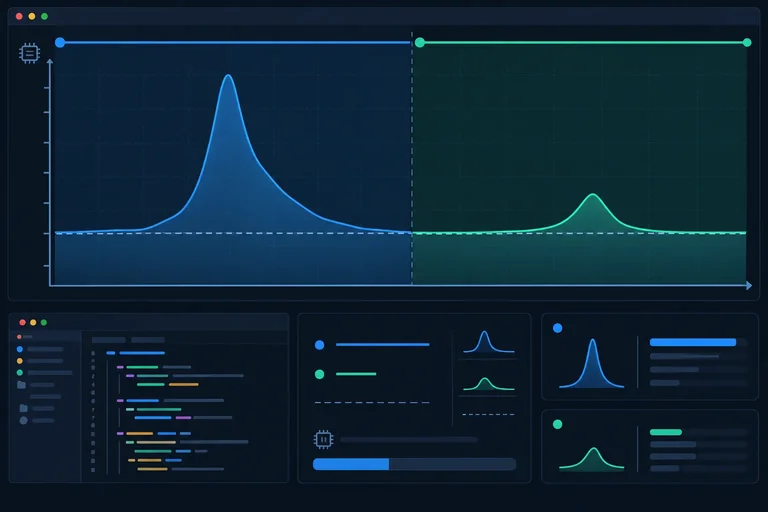
A segunda fase começa com memória ainda viva. Após reset_peak(), o novo pico parte desse nível atual, não de zero.
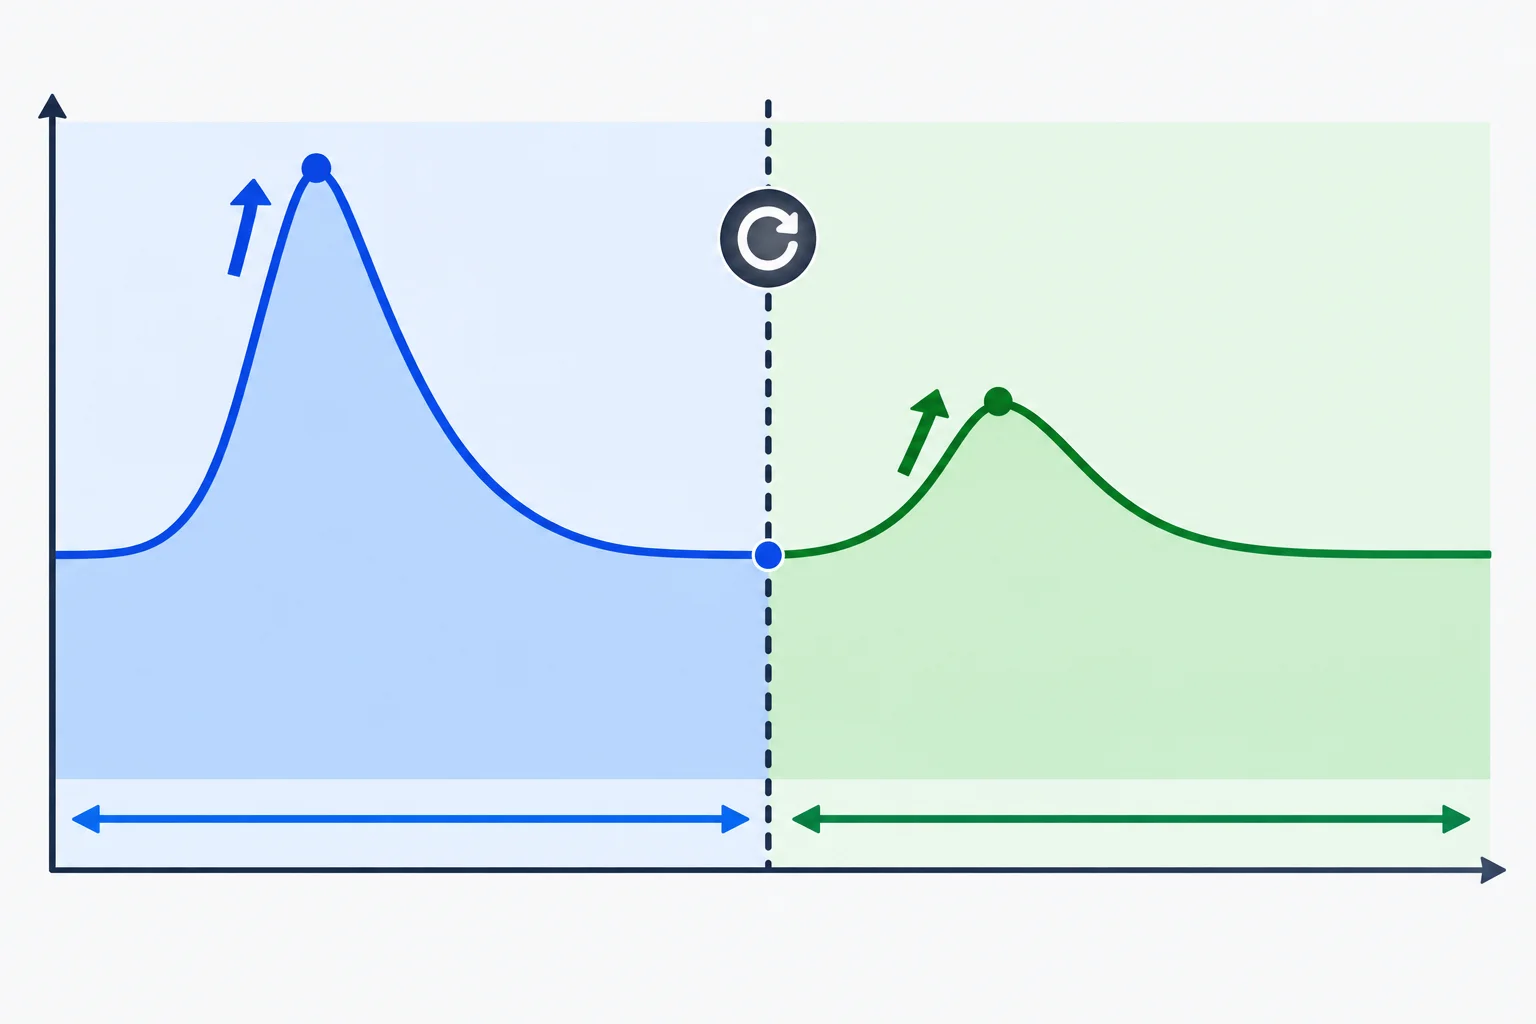
Reiniciar o pico separa a observação da fase 2, mas preserva a memória rastreada que veio da fase 1.
reset_peak() imediatamente antes da fase investigada.reset_peak() redefine o pico para o tamanho atual rastreado. Ele não libera objetos, não chama coleta de lixo e não descarta os rastros dos blocos que permanecem alocados.
Execute este script localmente. Os valores variam conforme versão do Python e ambiente.
import tracemalloc


def criar_strings(quantidade, tamanho):
    return [f"item-{i:06d}-" + "x" * tamanho for i in range(quantidade)]


def em_kib(bytes_usados):
    return bytes_usados / 1024


tracemalloc.start()
try:
    dados_da_fase_1 = criar_strings(8_000, 80)
    atual_1, pico_1 = tracemalloc.get_traced_memory()
    print(f"Fase 1 — atual: {em_kib(atual_1):.1f} KiB; pico: {em_kib(pico_1):.1f} KiB")

    referencia, _ = tracemalloc.get_traced_memory()
    tracemalloc.reset_peak()

    temporarios = criar_strings(3_000, 120)
    atual_2, pico_2 = tracemalloc.get_traced_memory()
    elevacao_do_pico = pico_2 - referencia
    print(f"Fase 2 — atual: {em_kib(atual_2):.1f} KiB; pico: {em_kib(pico_2):.1f} KiB")
    print(f"Elevação máxima acima da referência: {em_kib(elevacao_do_pico):.1f} KiB")

    del temporarios
finally:
tracemalloc.stop()Atenção
pico_2 - referencia mostra quanto o maior valor rastreado da fase ficou acima da referência. Isso não é necessariamente o total de bytes alocados pela função: uma função pode alocar e liberar diversos blocos durante sua execução, e os valores também incluem blocos que já estavam vivos na referência.
Depois de reset_peak(), a memória atual necessariamente passa a zero.
Você criou dados persistentes e quer observar o pico de uma etapa temporária executada em seguida. Quando deve chamar tracemalloc.reset_peak()?
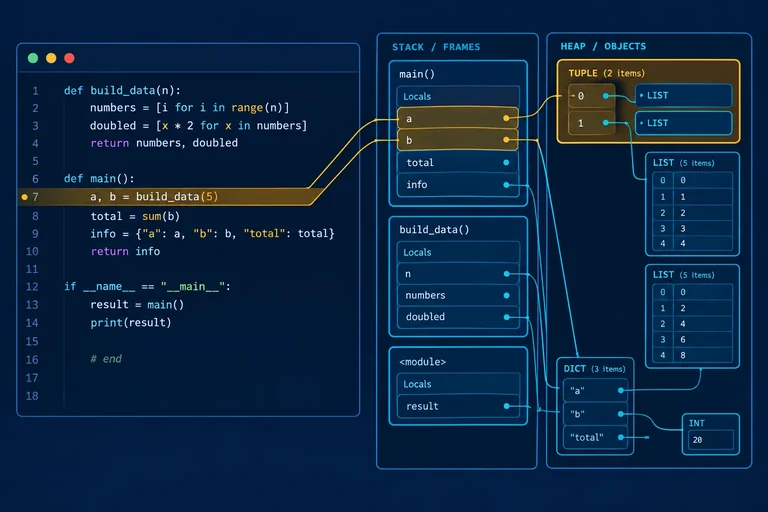
Passo 4 de 8
Capture um retrato das alocações ainda vivas e use seus agrupamentos para localizar linhas e arquivos que concentram memória rastreada.
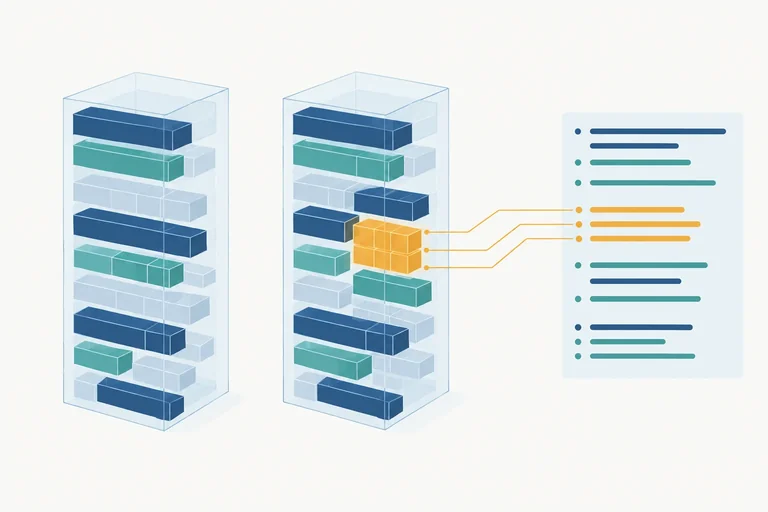
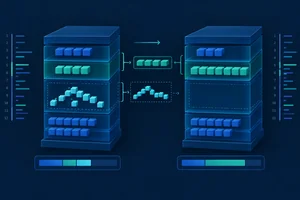
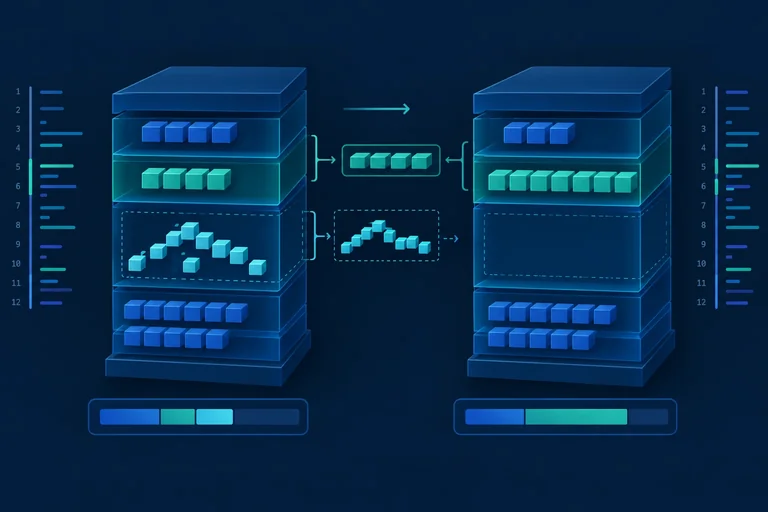
tracemalloc.take_snapshot() captura os rastros dos blocos que ainda estão alocados no instante da chamada. Portanto, uma estrutura temporária criada e liberada antes do snapshot não aparece nele, mesmo que tenha contribuído para o pico observado anteriormente.
Use o snapshot para perguntar: onde se concentra a memória rastreada que permanece viva agora?
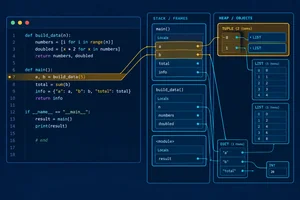
A área destacada representa os blocos ainda vivos no momento da captura; os blocos temporários que já desapareceram ficam fora do retrato.
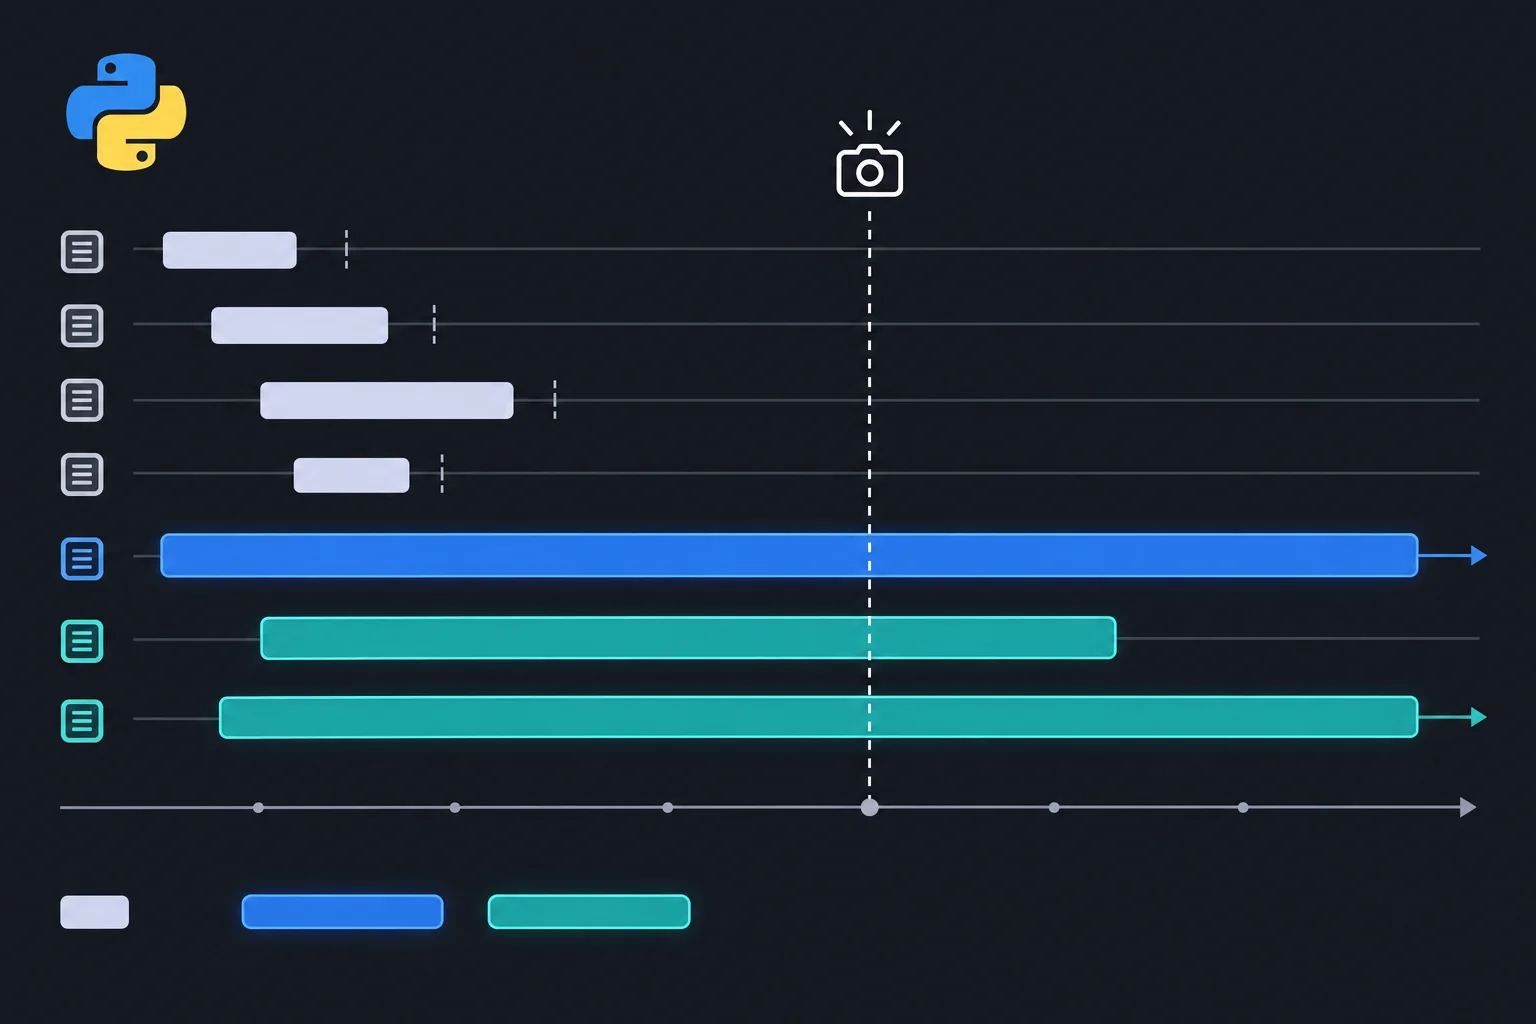
O snapshot descreve o estado atual das alocações rastreadas, não todas as alocações que ocorreram.
Execute este script localmente. Os valores, caminhos e números de linha variam conforme o ambiente.
import tracemalloc


def criar_relatorio():
    registros = [f"registro-{indice:05d}-" + "x" * 80 for indice in range(4_000)]
    totais = {registro: len(registro) for registro in registros}
    return registros, totais


tracemalloc.start()
try:
    registros, totais = criar_relatorio()

    snapshot = tracemalloc.take_snapshot()
    por_linha = snapshot.statistics("lineno")
    por_arquivo = snapshot.statistics("filename")

    print("Maiores grupos por linha:")
    for estatistica in por_linha[:5]:
        print(estatistica)

    print("\nMaiores grupos por arquivo:")
    for estatistica in por_arquivo[:5]:
        print(estatistica)
finally:
    tracemalloc.stop()
Exemplo
Uma saída semelhante a esta pode aparecer:
/caminho/relatorio.py:5: size=580 KiB, count=4000, average=148 B
relatorio.py:5 é o arquivo e a linha associados ao grupo.size=580 KiB é o tamanho total rastreado naquele grupo.count=4000 é a quantidade de blocos rastreados agrupados ali.count não é, necessariamente, a quantidade de objetos Python da sua lista: um objeto pode envolver mais de um bloco, e detalhes internos podem variar entre versões e execuções.
Dica
statistics("lineno") separa os grupos por arquivo e linha, sendo útil para voltar ao ponto do código. statistics("filename") soma os grupos de cada arquivo, dando uma visão mais ampla. As maiores entradas indicam concentração de blocos vivos — não demonstram, sozinhas, que houve crescimento recente.
No agrupamento por linha, duas linhas do mesmo arquivo permanecem separadas. No agrupamento por arquivo, seus tamanhos são reunidos.
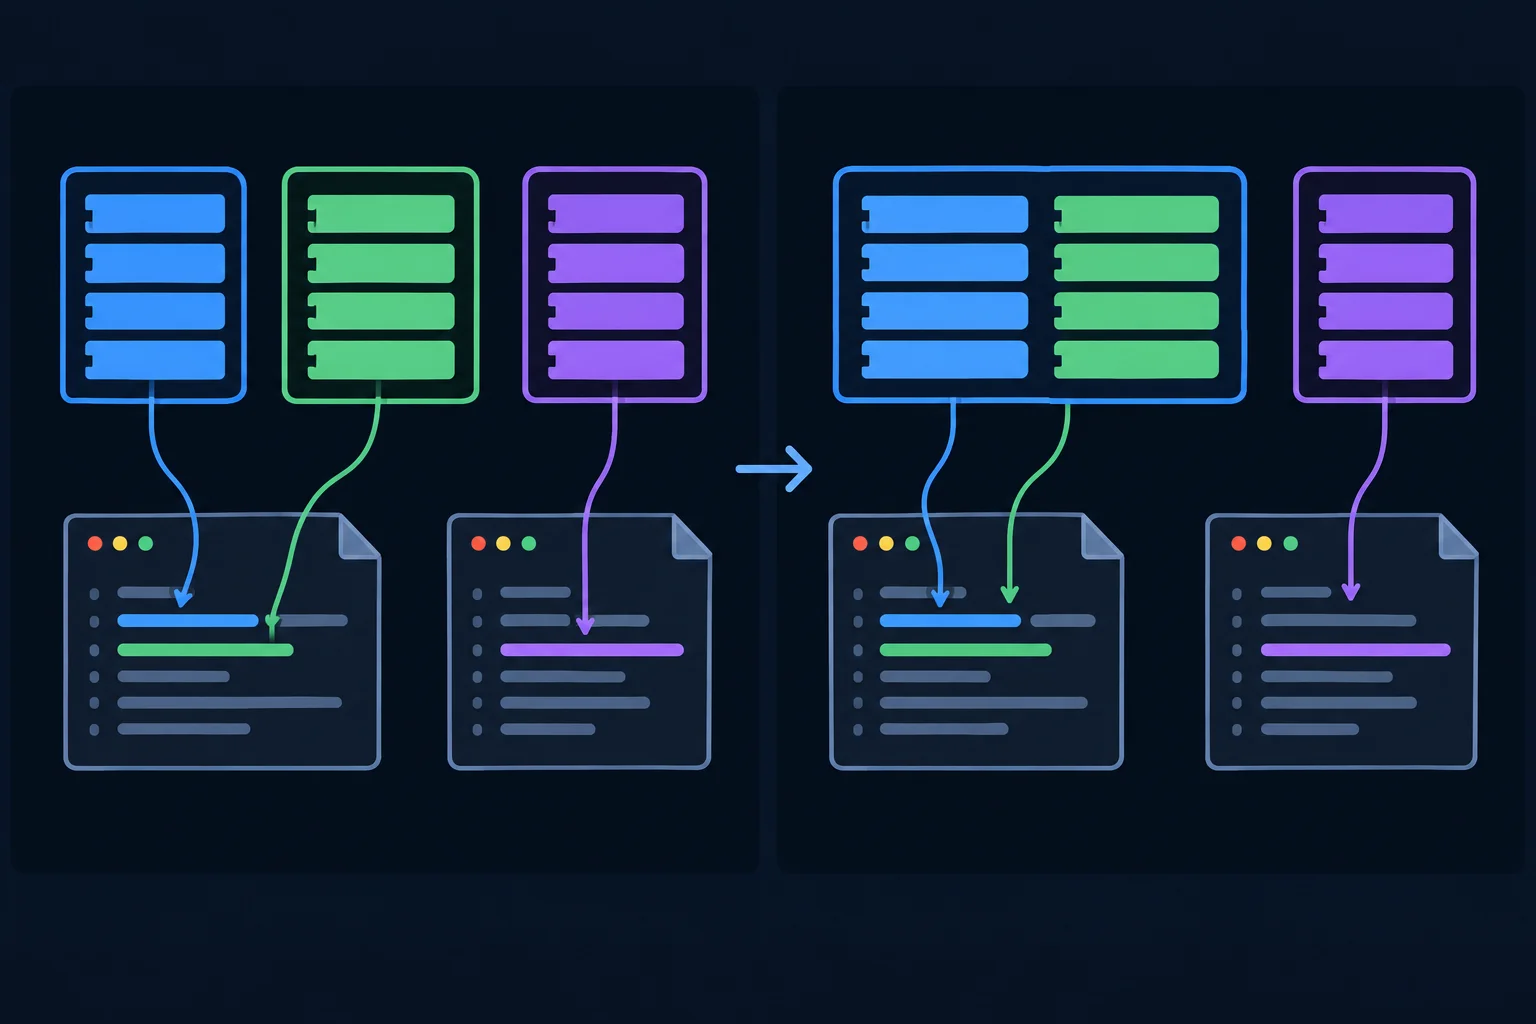
Escolha lineno para localizar uma instrução; escolha filename para enxergar a concentração por arquivo.
Faça as associações corretas.
Toque em um item e depois no par correspondente.
No script, uma entrada atribuída à linha da compreensão que cria registros aponta para blocos ainda vivos associados àquela instrução. Isso é uma evidência de origem de alocação: confira o arquivo e a linha mostrados e relacione-os ao seu código local.
Caminhos, números de linha e tamanhos não são universais. Mudanças no arquivo, na versão do Python e no ambiente alteram a saída. Além disso, uma entrada grande mostra memória viva concentrada naquele local; ela não prova quando os blocos foram criados nem por que continuam vivos.
Suponha que o relatório mostre size=580 KiB, count=4000 na linha que cria registros. O que essa entrada permite concluir e o que ela não permite concluir?
Escreva pelo menos 60 caracteres (0/60).
Passo 5 de 8
Compare dois estados de memória rastreada para encontrar locais associados a crescimento ou redução líquidos.
Capture um snapshot antes e outro depois da operação, sem interromper o rastreamento. Então use:
depois.compare_to(antes, "lineno")
Cada entrada compara o estado posterior com o anterior para uma linha de alocação. Assim, ela responde: o que ficou a mais ou a menos vivo ao final? Não responde tudo o que foi alocado durante o caminho.
A estrutura persistente aparece como crescimento líquido. A estrutura temporária pode aumentar o pico, mas, se já foi liberada antes do segundo snapshot, não aparecerá como crescimento na comparação.
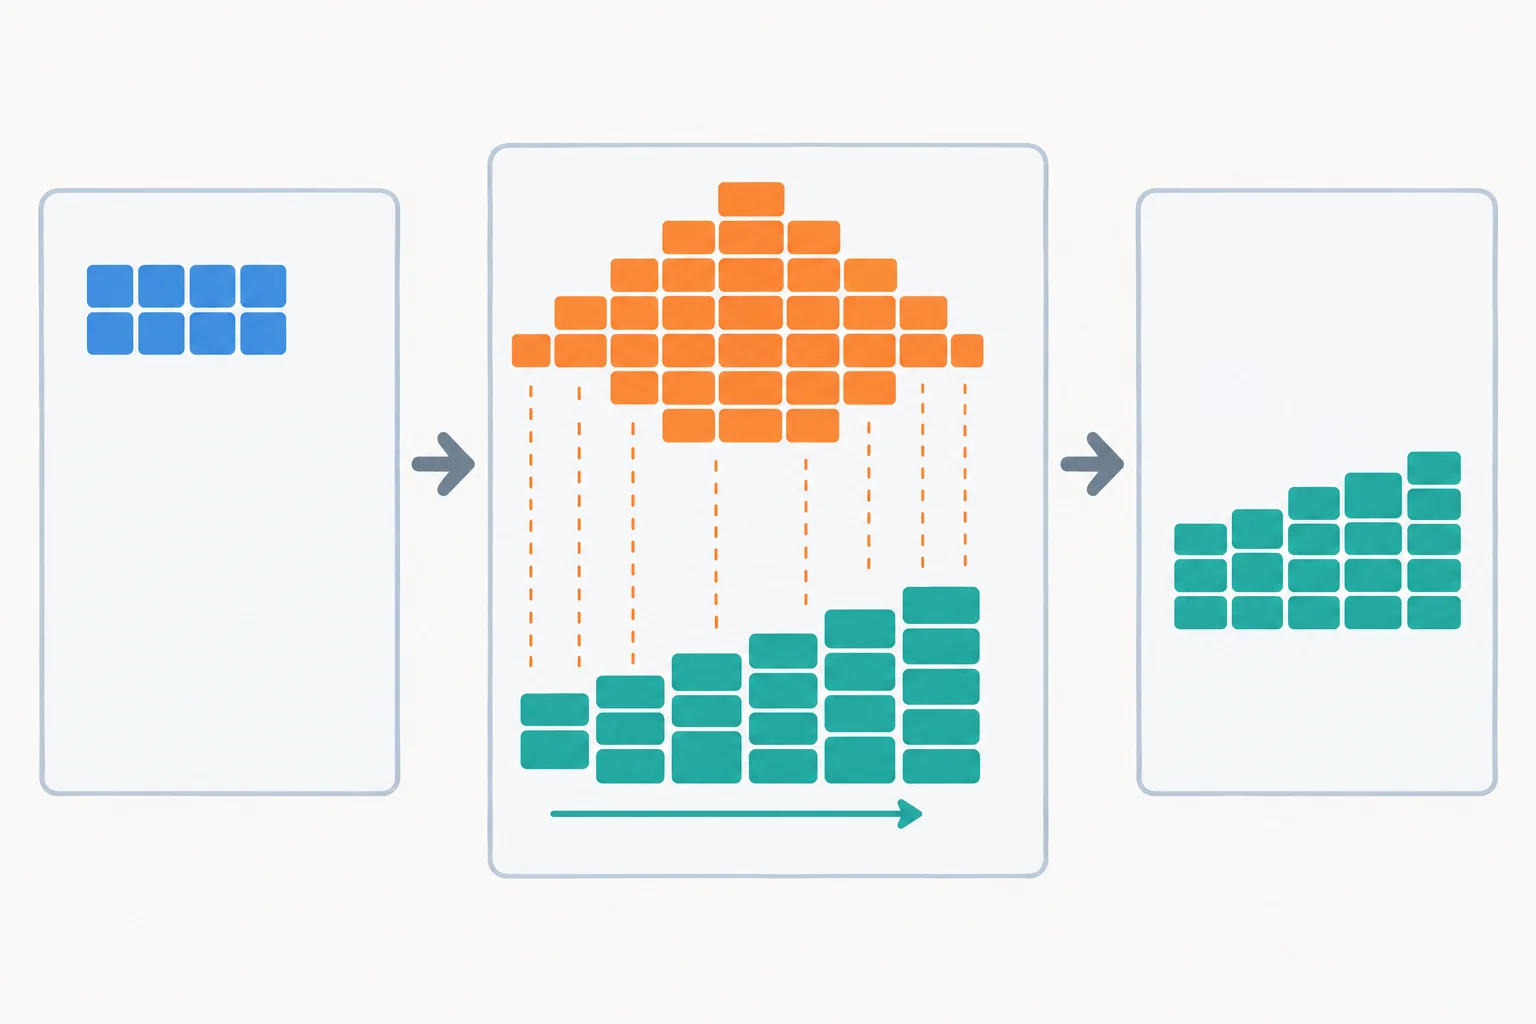
Compare snapshots para o estado líquido; consulte o pico para enxergar o máximo simultâneo.
Dica
Se a pergunta é sobre a operação, tire o primeiro snapshot depois da preparação e antes da operação. Mantenha também o mesmo rastreamento ativo nos dois pontos.
Em cada StatisticDiff, size e count descrevem o estado posterior daquele grupo. Já size_diff e count_diff são calculados como depois − antes.
A lista é ordenada pela magnitude absoluta de size_diff. Portanto, uma grande redução pode aparecer entre as primeiras entradas.
Execute em um arquivo .py. Os tamanhos, caminhos e números de linha variam conforme o ambiente.
import tracemalloc


def produzir_dados():
    mantidos = [f"registro-{i:05d}" for i in range(3_000)]
    temporarios = [f"buffer-{i:05d}" for i in range(8_000)]
    return mantidos


tracemalloc.start()
try:
    antes = tracemalloc.take_snapshot()

    dados = produzir_dados()  # mantém o resultado vivo até o segundo snapshot

    atual, pico = tracemalloc.get_traced_memory()
    depois = tracemalloc.take_snapshot()

    diferencas = depois.compare_to(antes, "lineno")

    print(f"Atual antes do snapshot final: {atual / 1024:.1f} KiB")
    print(f"Pico da operação: {pico / 1024:.1f} KiB")
    print("\nDiferenças líquidas por linha:")
    for stat in diferencas[:5]:
        quadro = stat.traceback[0]
        print(
            f"{quadro.filename}:{quadro.lineno} | "
            f"size={stat.size / 1024:.1f} KiB, "
            f"size_diff={stat.size_diff / 1024:+.1f} KiB, "
            f"count={stat.count}, count_diff={stat.count_diff:+d}"
        )
finally:
    tracemalloc.stop()
Exemplo
Uma entrada como script.py:5 | size=210.0 KiB, size_diff=+210.0 KiB, count=3001, count_diff=+3001 aponta crescimento líquido associado à linha 5. Já uma entrada com size_diff=-80.0 KiB indica que, naquele local agrupado, havia menos memória rastreada no segundo snapshot.
O pico pode ser maior que a memória atual porque temporarios coexistiu com mantidos durante a função, mas deixou de existir antes do snapshot final.
Considere este resumo após uma operação:
atual = 410 KiB; pico = 900 KiBdados.py:18 | size_diff=+320 KiB | count_diff=+4.000dados.py:24 | size_diff=-140 KiB | count_diff=-1.800Explique qual linha está associada ao crescimento líquido e por que a comparação não permite reconstruir, sozinha, o pico de 900 KiB.
Escreva pelo menos 120 caracteres (0/120).
Resumo
depois.compare_to(antes, "lineno").size_diff e count_diff mostram saldo posterior menos anterior; size e count pertencem ao estado posterior.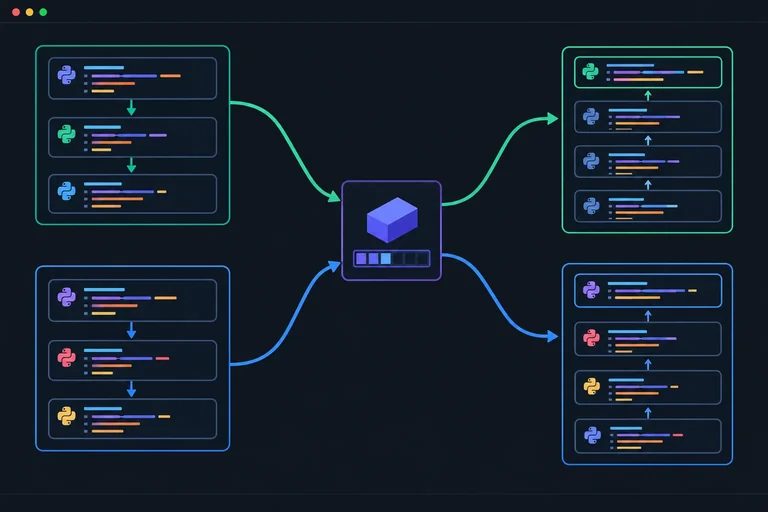
Passo 6 de 8
Use tracebacks de alocação para separar caminhos de chamada que chegam à mesma linha de código, sem confundir origem da alocação com retenção de objetos.
O agrupamento por 'lineno' mostra onde ocorreu a alocação, mas não diferencia dois caminhos que chegam à mesma linha. Para isso, registre mais quadros ao iniciar o rastreamento: tracemalloc.start(10) guarda até 10 quadros do traceback de cada alocação.
Sem argumento, start() registra somente um quadro: o local imediato da alocação. A profundidade vale apenas para alocações futuras; quadros que não foram registrados não podem ser recuperados de um snapshot já capturado.
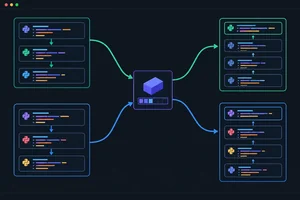
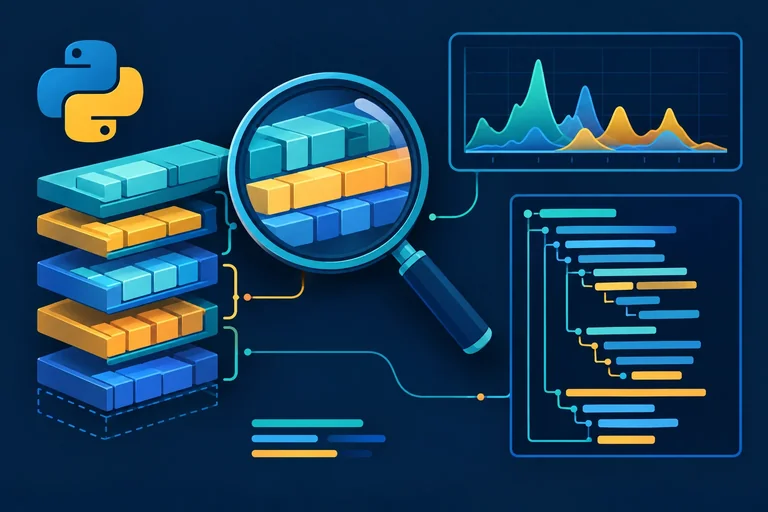
Os dois chamadores alcançam a mesma expressão que cria a lista. Por linha, eles se misturam; por traceback, permanecem separados.
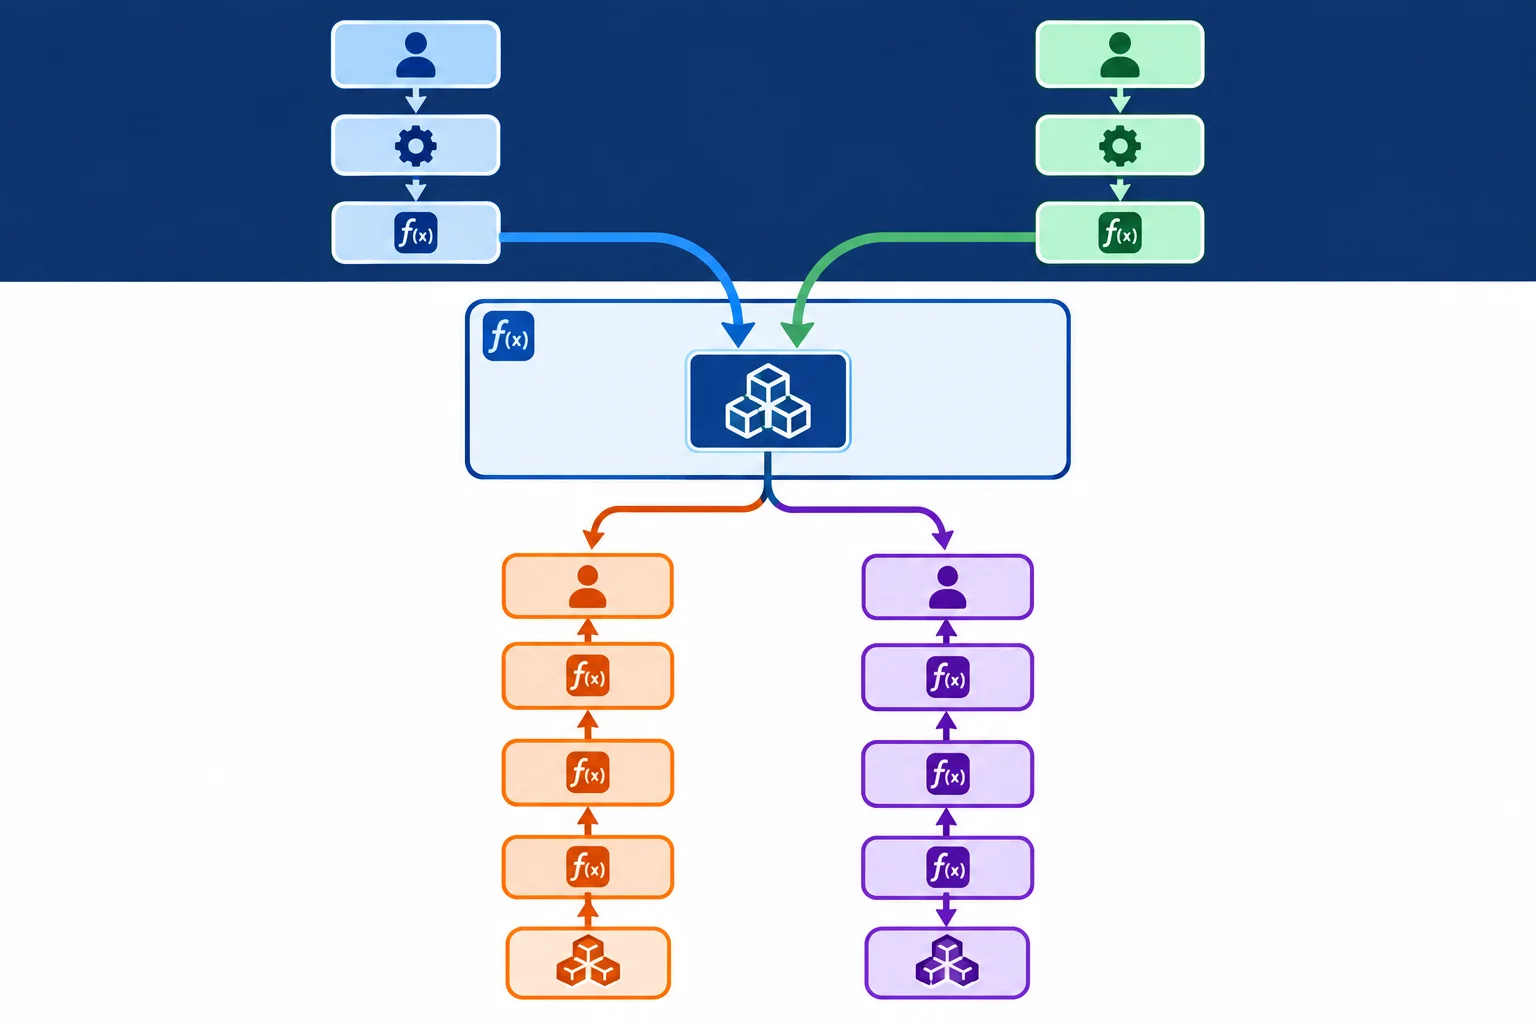
Agrupar por traceback diferencia a origem da chamada mesmo quando a linha alocadora é a mesma.
Crie um arquivo, por exemplo contexto_alocacao.py, e execute-o no seu computador. As duas funções chamadoras usam a mesma função alocadora. O primeiro snapshot é a referência; o segundo registra os blocos que permanecem vivos após as duas chamadas.
import tracemalloc


def criar_lotes(prefixo: str, quantidade: int) -> list[str]:
    return [f"{prefixo}-{numero}-" + "x" * 80 for numero in range(quantidade)]


def importar_dados() -> list[str]:
    return criar_lotes("importado", 3_000)


def aquecer_indice() -> list[str]:
    return criar_lotes("indice", 2_000)


tracemalloc.start(10)
try:
    antes = tracemalloc.take_snapshot()

    dados_importados = importar_dados()
    dados_do_indice = aquecer_indice()

    depois = tracemalloc.take_snapshot()

    diferencas = depois.compare_to(antes, "traceback")
    for estatistica in diferencas[:5]:
        if estatistica.size_diff <= 0:
            continue
        print(
            f"{estatistica.size_diff / 1024:.1f} KiB "
            f"em {estatistica.count_diff:+d} blocos"
        )
        for quadro in estatistica.traceback.format():
            print(quadro)
        print()
finally:
tracemalloc.stop()Use depois.statistics('traceback') para ver blocos vivos agrupados pelo caminho completo de alocação. Para identificar crescimento líquido desde uma referência, use depois.compare_to(antes, 'traceback').
Cada estatistica.traceback pode ser percorrido com format(). No exemplo, você deve encontrar caminhos que passam por importar_dados e por aquecer_indice, embora ambos terminem na linha da compreensão em criar_lotes. Caminhos, números de linha, tamanhos e quantidades variam conforme a execução.
Atenção
O traceback mostra o caminho que levou à alocação. Ele não é um grafo de referências: não prova qual variável, coleção ou objeto ainda mantém aquele bloco vivo. Neste exemplo, as variáveis dados_importados e dados_do_indice continuam referenciadas, mas essa conclusão vem da leitura do código, não do traceback.
No script, importar_dados() e aquecer_indice() chamam a mesma linha em criar_lotes(). Qual agrupamento permite distinguir o crescimento associado a cada caminho?
Passo 7 de 8
Entenda o que os números do tracemalloc representam — e o que eles não permitem concluir sobre a memória total do processo.
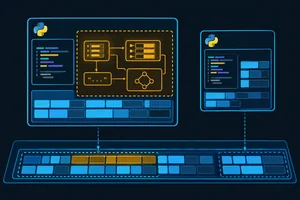
Os valores de tracemalloc descrevem blocos de memória que ele está rastreando no Python. Eles não representam automaticamente toda a memória residente do processo.
RSS (resident set size) é a memória do processo que está residente na RAM, conforme informada pelo sistema operacional. Portanto, um pico rastreado e o RSS podem ter valores bem diferentes sem que um deles esteja necessariamente errado.
Compare o escopo de cada medida.
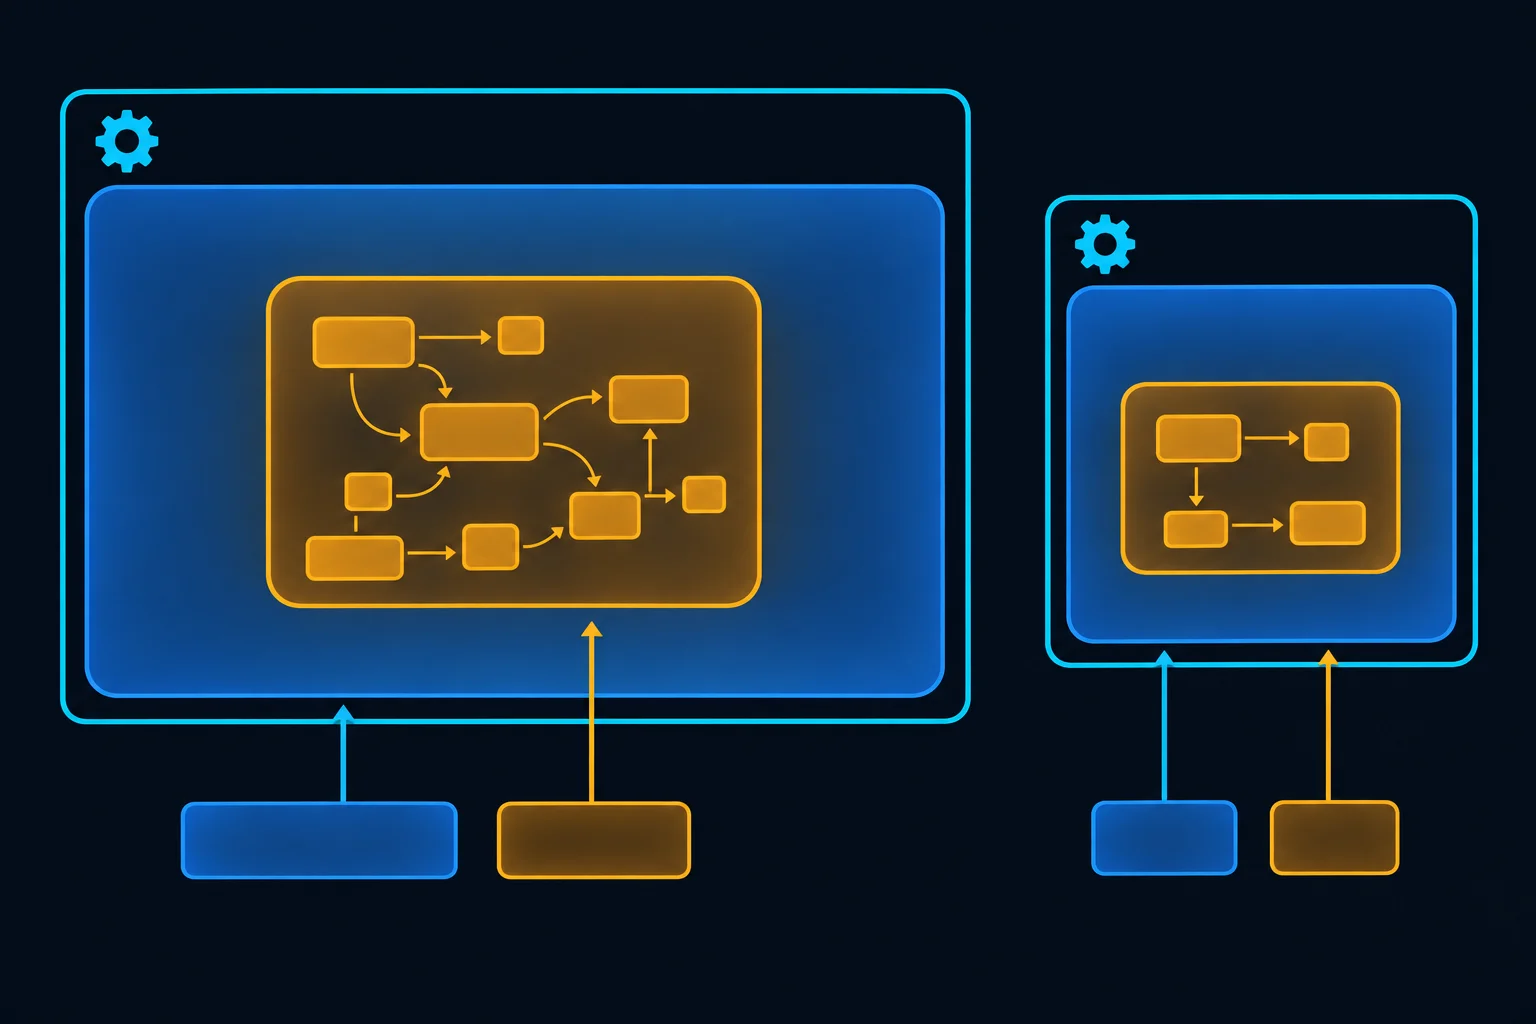
tracemalloc observa uma parte rastreada dentro do processo; RSS é uma medida mais ampla informada pelo sistema operacional.
Uma alocação nativa pode aparecer no relatório quando usa mecanismos rastreados pelo Python, mas memória nativa não rastreada fica fora dos resultados. Além disso, tracemalloc não agrega automaticamente a memória de outros processos.
A própria investigação tem custo: manter rastros, pedir mais quadros com start(n) e capturar snapshots consomem tempo e memória. Meça uma carga representativa e trate o resultado como evidência de diagnóstico, não como uma contabilidade exata.
Atenção
Um crescimento em compare_to() aponta para blocos rastreados que cresceram liquidamente entre dois estados. Sozinho, ele não prova um vazamento, nem informa toda a memória usada pelo processo. A carga executada, o estado inicial e o ambiente influenciam a observação.
Se tracemalloc.get_traced_memory() informar 20 MiB, então o RSS do processo também será exatamente 20 MiB.
Ao investigar um processo Python, tracemalloc não soma automaticamente as alocações feitas por outros processos.
A profundidade dos tracebacks e a captura de snapshots podem acrescentar sobrecarga à medição.
Passo 8 de 8
Execute uma investigação local completa e transforme as medições em um diagnóstico prudente, com evidências e limites explícitos.
Nesta aplicação, você vai manter a entrada fora da comparação, medir uma fase que cria dados temporários e preservar o resultado retornado. O roteiro é:
reset_peak() imediatamente antes da fase investigada.Os valores variam entre máquinas e execuções. O objetivo é interpretar relações entre as medidas, não obter um número específico.
A entrada já existe antes do snapshot inicial; por isso, a comparação destaca a mudança líquida provocada por processar. O pico da fase, por outro lado, pode incluir a estrutura temporária que deixou de existir antes do snapshot final.
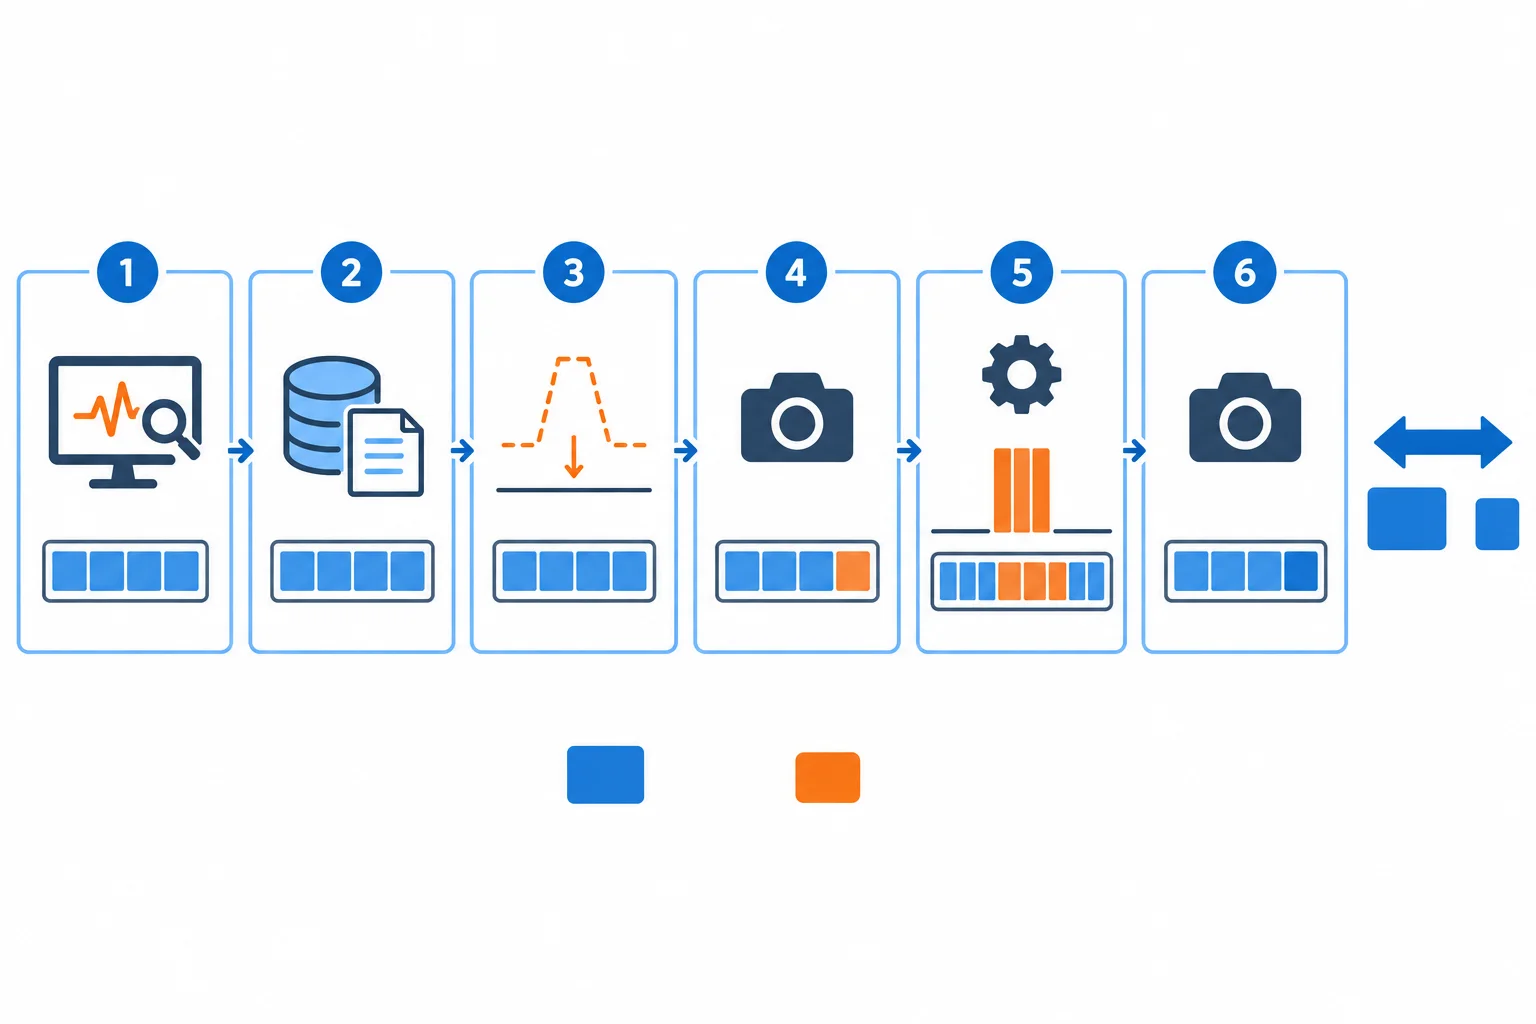
Pico observa o máximo simultâneo; snapshots comparam blocos vivos nos dois instantes.
Crie um arquivo chamado diagnostico_memoria.py, copie o código completo abaixo e execute python diagnostico_memoria.py no seu computador. A rotina não altera sua estratégia de processamento: ela apenas cria uma coleção temporária e devolve uma coleção que continua referenciada por resultado.
O relatório mostra a memória rastreada, as maiores diferenças por linha e uma origem agrupada por traceback.
import tracemalloc


def processar(entradas: list[str]) -> list[str]:
    temporarios = [f"{texto}|{'x' * 80}" for texto in entradas]
    resultado = [texto.upper() for texto in temporarios[::4]]
    return resultado


def kib(valor: int) -> str:
    return f"{valor / 1024:.1f} KiB"


tracemalloc.start(10)
try:
    # Preparação deliberadamente fora da comparação entre snapshots.
    entradas = [f"registro-{indice}" for indice in range(20_000)]

    referencia_atual, _ = tracemalloc.get_traced_memory()
    tracemalloc.reset_peak()
    antes = tracemalloc.take_snapshot()

    # Fase investigada: temporarios deixa de existir ao retornar;
    # resultado continua referenciado pelo chamador.
    resultado = processar(entradas)

    atual, pico_da_fase = tracemalloc.get_traced_memory()
    depois = tracemalloc.take_snapshot()

    diferencas = depois.compare_to(antes, "lineno")
    por_traceback = depois.compare_to(antes, "traceback")

    print(f"Referência antes da fase: {kib(referencia_atual)}")
    print(f"Atual após a fase:       {kib(atual)}")
    print(f"Pico da fase:             {kib(pico_da_fase)}")
    print(f"Elevação do pico:         {kib(pico_da_fase - referencia_atual)}")
    print(f"Itens mantidos:           {len(resultado)}")

    print("\nMaiores diferenças por linha:")
    for estatistica in diferencas[:5]:
        print(estatistica)

    print("\nMaior diferença por traceback:")
    if por_traceback:
        print(por_traceback[0])
        for quadro in por_traceback[0].traceback.format():
            print(quadro)
finally:
tracemalloc.stop()No relatório, identifique uma entrada com size_diff positivo ligada à linha de resultado ou à criação de dados. Registre também seu count_diff. Se pico_da_fase for maior que atual, houve mais memória rastreada simultaneamente durante a fase do que permaneceu viva no final.
A maior entrada ordenada pode ter sinal negativo, pois compare_to ordena pela magnitude absoluta da diferença. Para investigar crescimento, confira explicitamente o sinal positivo de size_diff.
O traceback aponta o caminho que levou à alocação. Ele não informa, por si só, qual referência está mantendo um objeto vivo nem prova a existência de vazamento.
Após executar o script, escreva um diagnóstico curto (ao menos 280 caracteres). Inclua:
size_diff e, se possível, count_diff;tracemalloc que impeça uma conclusão excessiva.Escreva pelo menos 280 caracteres (0/280).
Resumo
Use esta sequência quando precisar examinar alocações em uma rotina local.
size_diff.Parabéns! Você concluiu: Localizar alocações de memória com tracemalloc
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks