Passo 1 de 8
Entender o caminho de uma chamada entre processos
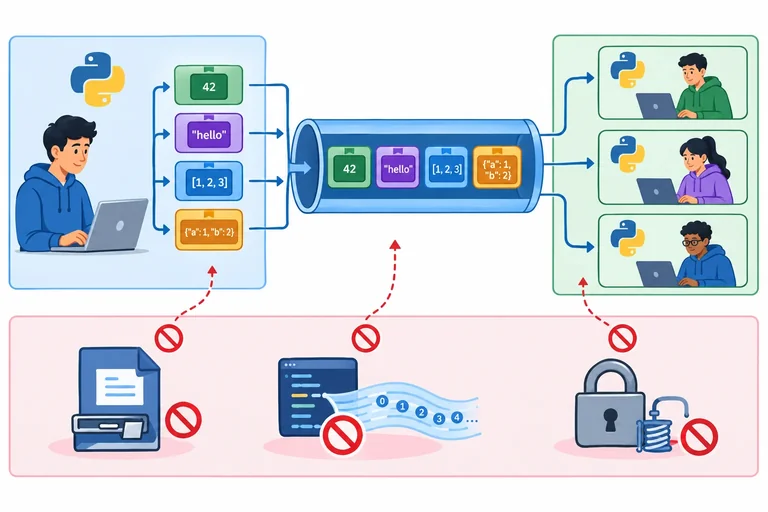
Veja como uma chamada percorre processos separados: dados saem do processo principal, chegam a um trabalhador e retornam como um novo resultado.
Trilha de aprendizado · Nível 13 · Tutorial 5
Ao concluir, você será capaz de distribuir funções entre processos com entradas e saídas serializáveis, organizando o programa para funcionar sem depender de memória global herdada.
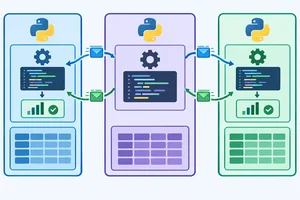 Entender o caminho de uma chamada entre processos
Veja como uma chamada percorre processos separados: dados saem do processo principal, chegam a um trabalhador e retornam como um novo resultado. 2 min
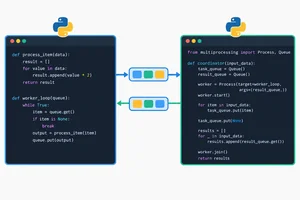 Definir funções que os trabalhadores conseguem importar
Organize a função trabalhadora em um módulo importável e separe-a do código que coordena o executor. 2 min
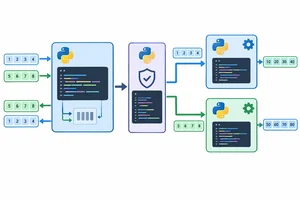 Inicializar o executor com spawn de forma segura
Monte e execute localmente um programa com dois módulos, contexto spawn explícito e ponto de entrada protegido. 3 min
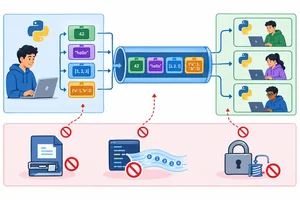 Projetar argumentos e retornos transportáveis
Escolha dados que possam cruzar a fronteira entre o processo principal e os trabalhadores sem levar recursos vivos junto. 3 min
 Substituir dependências globais por comunicação explícita
Corrija uma tarefa que espera compartilhar mutações entre processos e passe a comunicar configuração e resultados de forma explícita. 3 min
 Distinguir falha da função e falha de serialização
Compare falhas controladas para descobrir em que etapa uma chamada entre processos deixou de produzir um resultado. 3 min
 Reconhecer quando o pool deixou de funcionar
Diferencie uma falha isolada de tarefa de um pool inutilizável e escolha uma resposta segura para cada situação. 2 min
 Aplicar o contrato completo de execução em processos
Monte e valide uma aplicação local completa com ProcessPoolExecutor, contexto spawn, dados transportáveis e consolidação no processo principal. 4 min
Passo 1 de 8
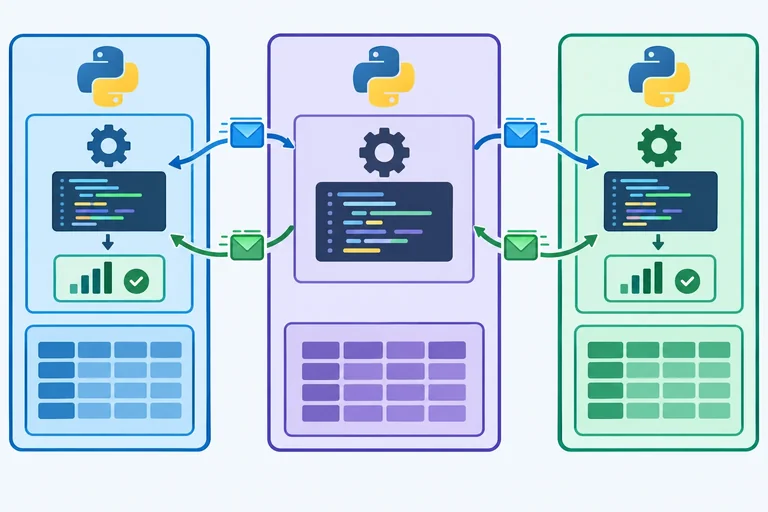
Veja como uma chamada percorre processos separados: dados saem do processo principal, chegam a um trabalhador e retornam como um novo resultado.
ProcessPoolExecutor mantém o modelo de executor: o processo principal submete uma função com argumentos e depois obtém o resultado pelo Future. A diferença é onde a função roda: cada trabalhador é um processo separado, com seu próprio espaço de memória.
Assim, o processo principal coordena as chamadas; ele não entrega ao trabalhador acesso direto aos objetos que já existem na sua memória.
Observe que os valores atravessam uma fronteira de comunicação. O trabalhador calcula sobre os dados que recebeu e devolve um resultado ao principal.
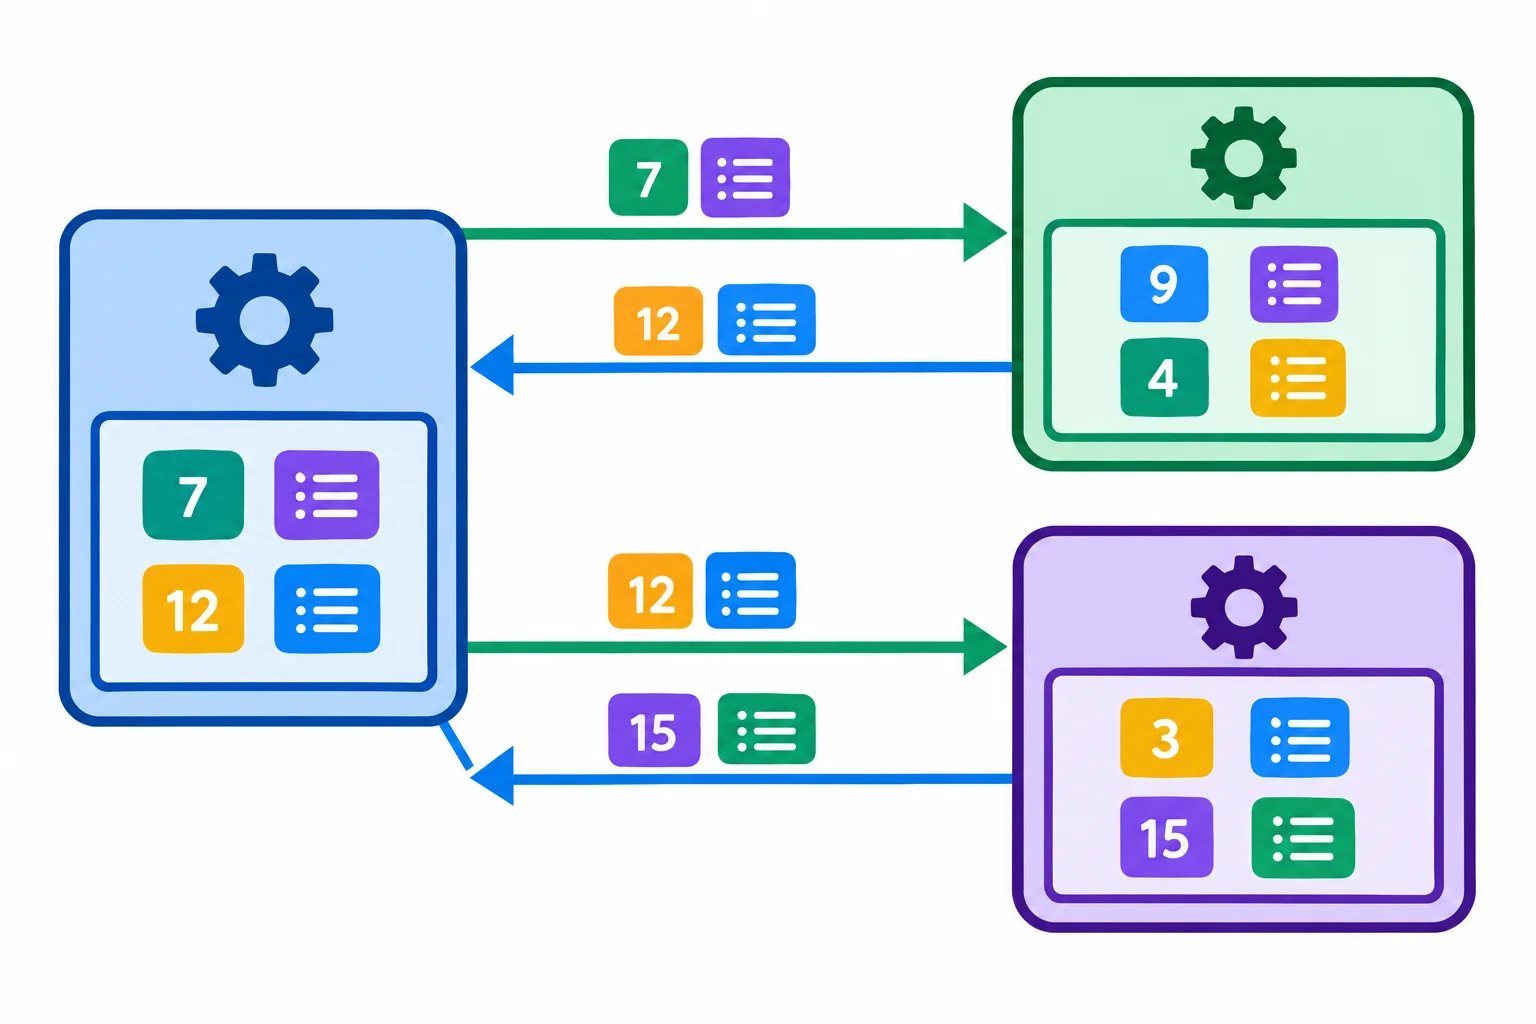
Argumentos vão ao trabalhador; resultados retornam ao processo principal. As memórias permanecem separadas.
Ao submeter uma chamada, o executor usa pickle automaticamente para transportar a chamada e seus argumentos até um trabalhador. Quando a função termina, o valor retornado também é transportado de volta.
Você não precisa chamar pickle manualmente a cada submit. Porém, a chamada cruza uma fronteira: o trabalhador recebe uma representação reconstruída dos dados, e o principal recebe um resultado reconstruído.
Exemplo
Ao executar conceitualmente executor.submit(calcular, 7), o percurso é:
calcular e 7.calcular(7) na memória dele.future.result() disponibiliza esse valor no processo principal.Não interprete isso como o trabalhador alterando ou consultando diretamente os objetos originais do principal.
Dica
Uma variável, lista ou dicionário existente no processo principal não vira automaticamente um objeto compartilhado só porque foi passado para uma tarefa. Comunicação por argumentos e retornos é diferente de compartilhar a mesma referência em memória.
Coloque o percurso conceitual de uma tarefa no ProcessPoolExecutor na ordem correta.
Criar processos e transportar dados custa tempo e recursos. Para tarefas muito pequenas, esse custo pode superar o benefício de distribuí-las. Além disso, o resultado depende da carga, do tamanho dos dados e do ambiente de execução.
Por enquanto, use este contrato mental: o principal envia dados, trabalhadores calculam isoladamente e o principal recebe resultados. Nos próximos passos, você organizará funções e programas para esse caminho funcionar de forma confiável.
Qual afirmação descreve corretamente uma tarefa em um ProcessPoolExecutor?
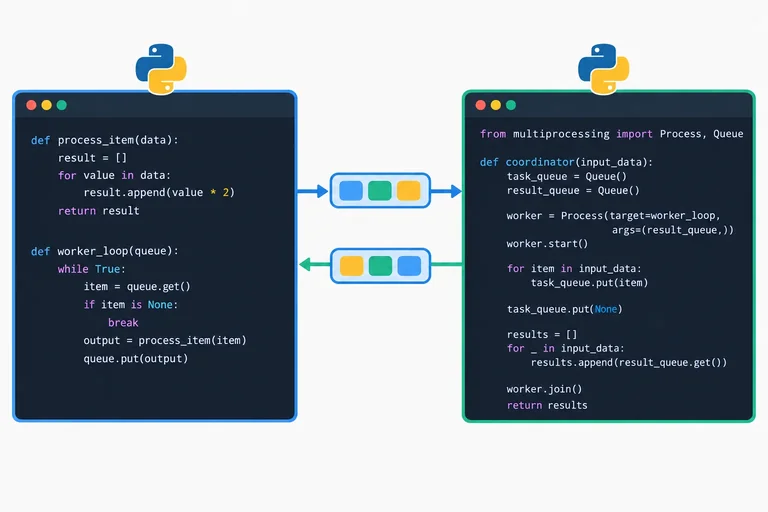
Passo 2 de 8
Organize a função trabalhadora em um módulo importável e separe-a do código que coordena o executor.
Ao submeter uma chamada a um ProcessPoolExecutor, o mecanismo padrão normalmente identifica a função pelo módulo e pelo nome. No outro processo, Python precisa conseguir importar esse módulo e localizar a função novamente.
Por isso, uma função trabalhadora deve ser definida no nível superior de um arquivo importável. O processo filho não recebe automaticamente o código da função junto com todas as variáveis e o contexto que existiam onde ela foi criada.
A separação deixa explícito o que cada processo precisa fazer.
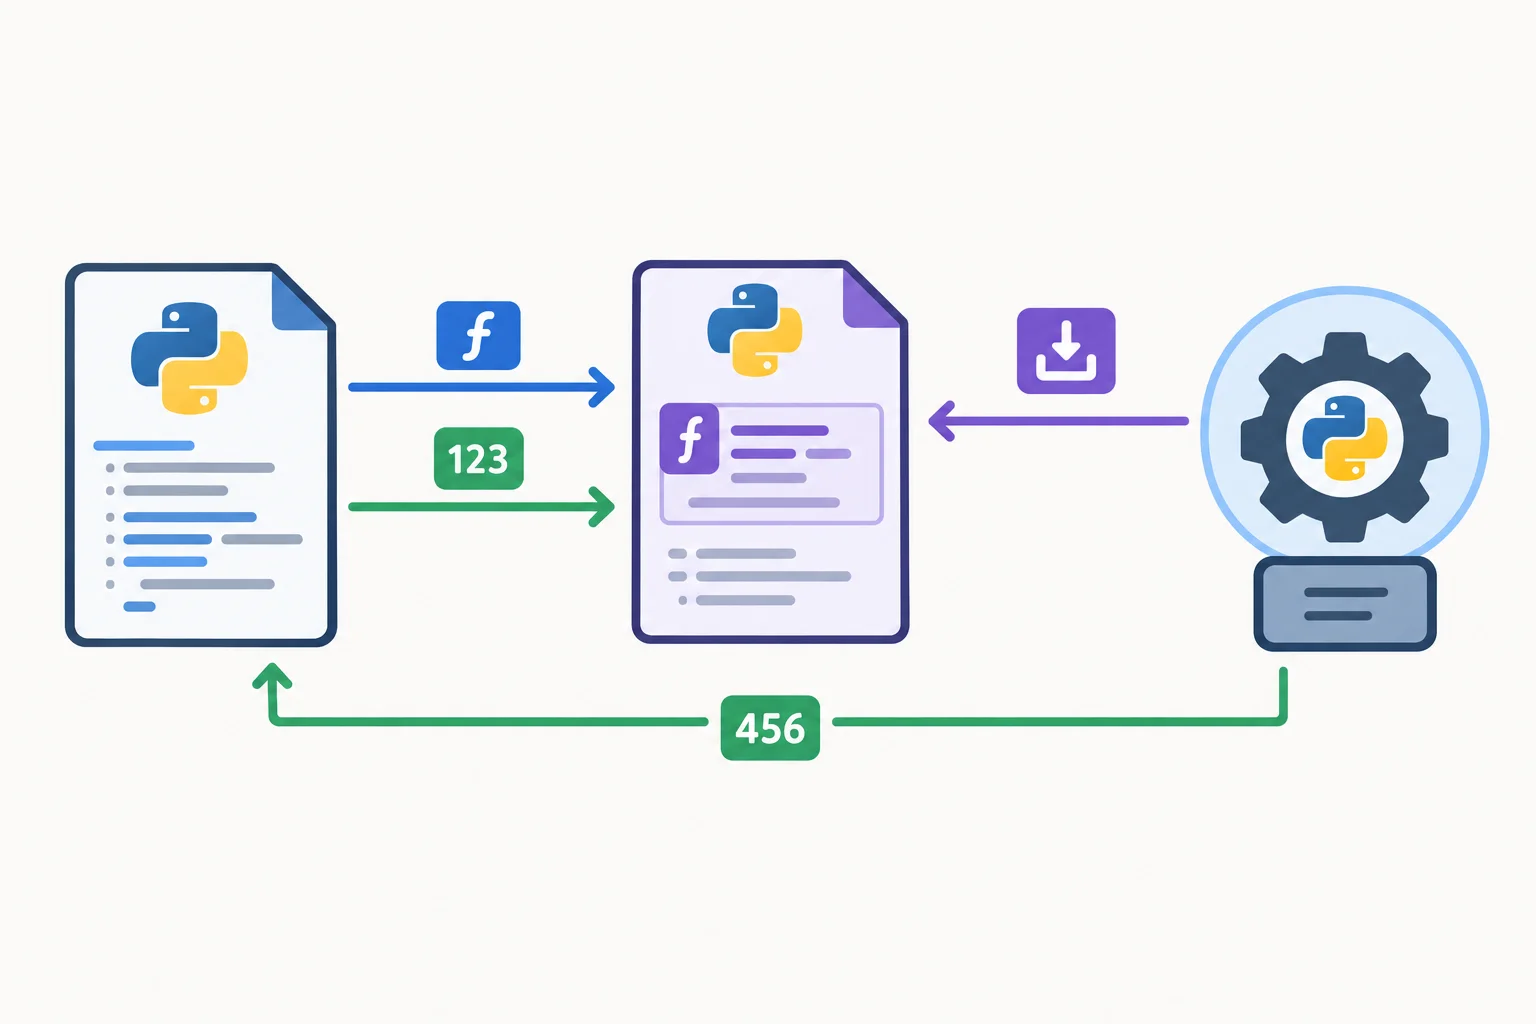
O principal envia uma chamada identificada por módulo e nome; o trabalhador importa o módulo para encontrar a função.
Coloque em tarefas.py apenas a função que executa o cálculo. Em main.py ficará a coordenação: importar a função, criar o executor e submeter chamadas.
Nesta etapa, observe a organização. O ponto de entrada protegido e a configuração de inicialização serão detalhados no próximo passo.
Função definida no nível superior do módulo.
def soma_quadrados(numeros: list[int]) -> int:
return sum(numero * numero for numero in numeros)A importação usa a função pelo módulo que os trabalhadores também poderão importar.
from concurrent.futures import ProcessPoolExecutor

from tarefas import soma_quadrados


def coordenar() -> None:
    lotes = [[1, 2, 3], [4, 5]]

    with ProcessPoolExecutor(max_workers=2) as executor:
        futuros = [executor.submit(soma_quadrados, lote) for lote in lotes]
        resultados = [futuro.result() for futuro in futuros]

    print(resultados)


# A chamada protegida para coordenar será organizada no próximo passo.
Dica
Importar tarefas.py deve apenas definir funções, classes e constantes necessárias. Não crie executores nem faça submissões como efeito da importação.
Uma lambda, uma função definida dentro de outra função e uma closure dependem de um contexto de definição que o trabalhador não consegue localizar de forma portável pelo módulo e nome. Mesmo que algum cenário pareça funcionar, não use essas formas como função submetida ao ProcessPoolExecutor padrão.
Transforme a lógica em uma função nomeada no nível superior de um módulo importável e passe os dados necessários como argumentos.
Qual opção é a mais adequada para submeter cálculos a um ProcessPoolExecutor?
Passo 3 de 8
Monte e execute localmente um programa com dois módulos, contexto spawn explícito e ponto de entrada protegido.
Use multiprocessing.get_context("spawn") para selecionar explicitamente o contexto de criação dos processos. Com spawn, cada trabalhador inicia um novo interpretador Python e importa os módulos de que precisa; ele não deve depender de como o processo principal já estava executando.
Por isso, a função trabalhadora continua no nível superior de um módulo importável, enquanto a criação do executor e as submissões ficam em main().
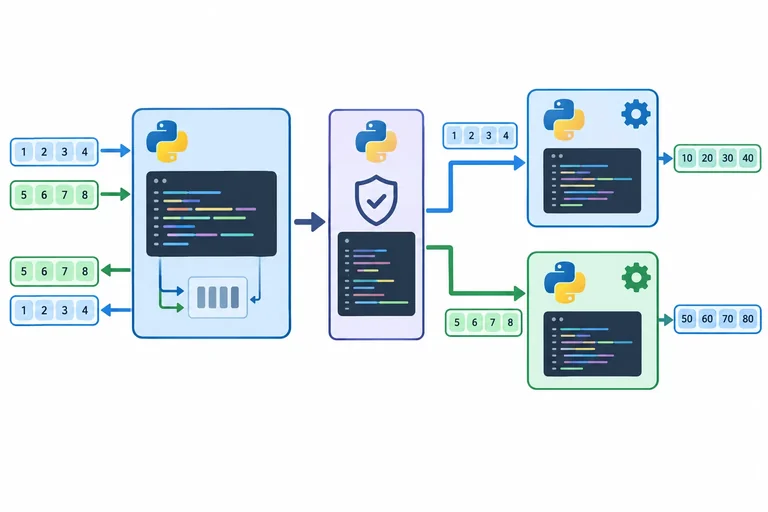
O processo principal executa o ponto de entrada. Cada trabalhador inicia Python, importa tarefas e então recebe uma chamada para a função disponível nesse módulo.
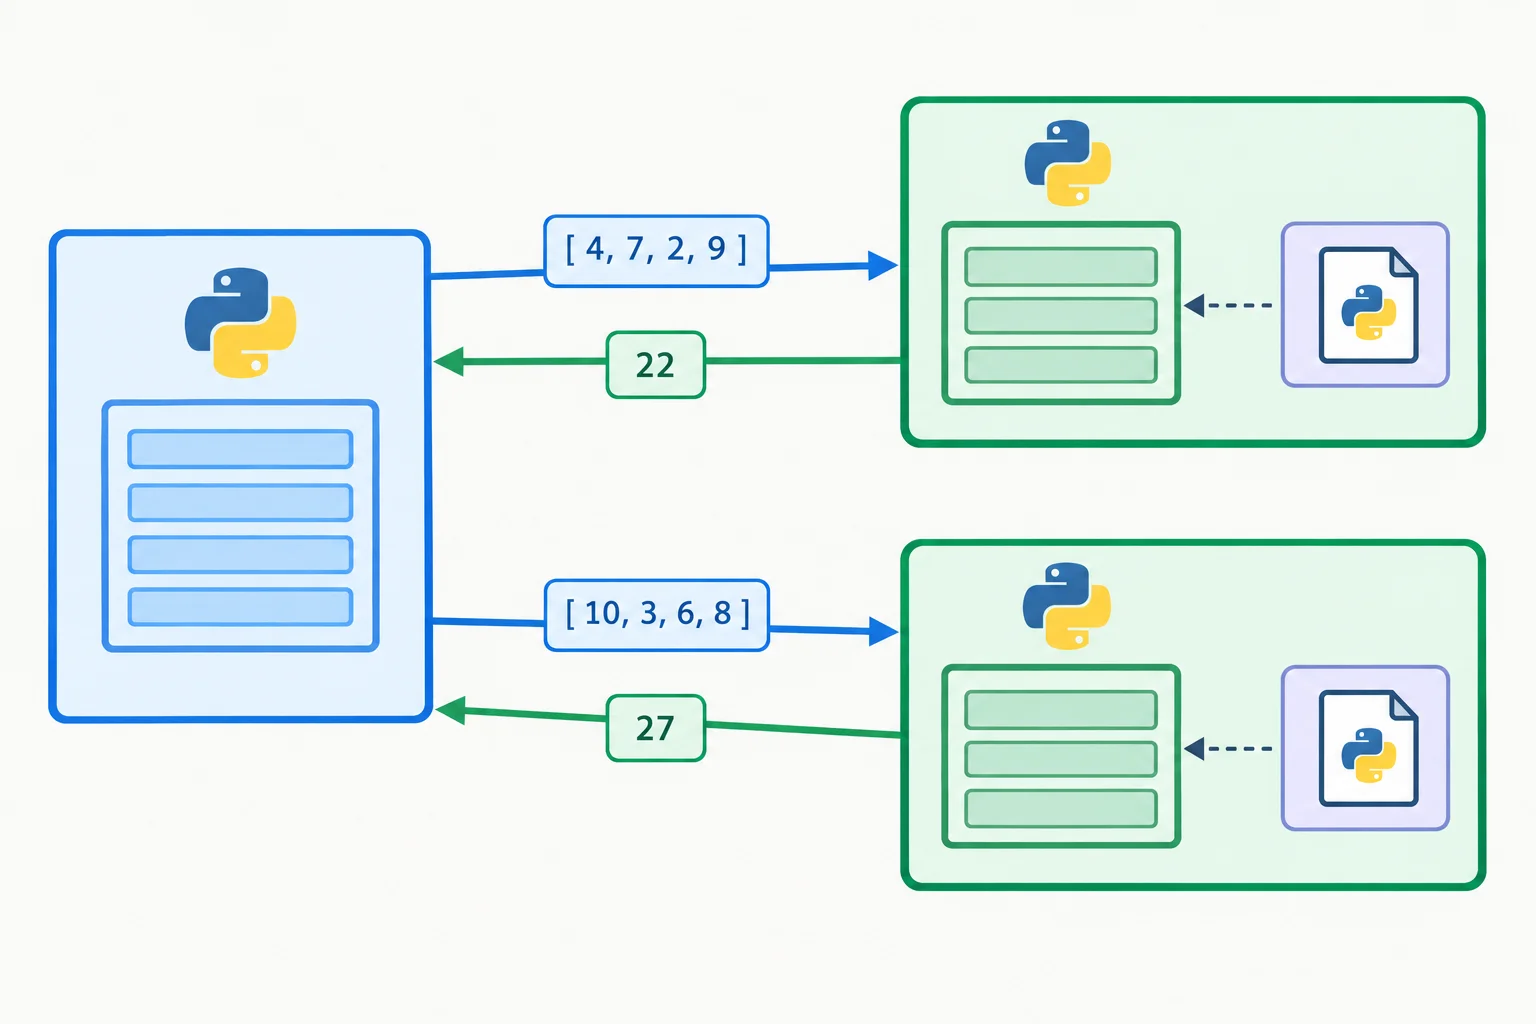
Com spawn, os trabalhadores começam em interpretadores novos e importam os módulos necessários.
Em uma mesma pasta no seu computador, crie o arquivo tarefas.py. Ele contém somente a função que os trabalhadores importarão.
def soma_quadrados(numeros: list[int]) -> int:
    """Retorna a soma dos quadrados dos números recebidos."""
return sum(numero * numero for numero in numeros)Agora crie main.py na mesma pasta. Repare em três pontos: o contexto spawn, o argumento mp_context=contexto e a chamada de main() protegida por if __name__ == "__main__".
import multiprocessing
from concurrent.futures import ProcessPoolExecutor

from tarefas import soma_quadrados


def main() -> None:
    lotes = [[1, 2, 3], [4, 5]]
    contexto = multiprocessing.get_context("spawn")

    with ProcessPoolExecutor(
        max_workers=2,
        mp_context=contexto,
    ) as executor:
        resultados = list(executor.map(soma_quadrados, lotes))

    print(resultados)


if __name__ == "__main__":
main()Ao iniciar um trabalhador com spawn, Python importa módulos para prepará-lo. Se a criação do executor estivesse no nível superior de main.py, essa importação poderia tentar criar outro pool.
Deixe as definições importáveis, como soma_quadrados, no nível superior de seus módulos. Deixe a execução do programa — main(), o executor e as submissões — sob a proteção do ponto de entrada.
contexto = multiprocessing.get_context("_")
Abra um terminal na pasta que contém tarefas.py e main.py e execute:
python main.py
O resultado esperado é [14, 41]: o primeiro lote calcula 1² + 2² + 3², e o segundo calcula 4² + 5². Há dois trabalhadores disponíveis, mas não dependa de uma ordem de início ou de mensagens produzidas por eles.
Execute como arquivo de script. Não use uma função definida apenas no REPL ou em uma célula de notebook como tarefa deste exemplo.
Depois de executar python main.py, qual saída apareceu? Relacione cada valor ao lote correspondente.
Escreva pelo menos 20 caracteres (0/20).
Passo 4 de 8
Escolha dados que possam cruzar a fronteira entre o processo principal e os trabalhadores sem levar recursos vivos junto.
Em um ProcessPoolExecutor, tanto os argumentos enviados à função quanto o valor que ela retorna precisam ser serializáveis por pickle. Isso vale também para cada elemento dentro de listas, tuplas e dicionários aninhados.
Como contrato de comunicação, prefira valores simples: números, textos, None, booleanos e coleções formadas apenas por outros valores compatíveis. O trabalhador recebe uma representação reconstruída desses dados e devolve outra representação ao processo principal.
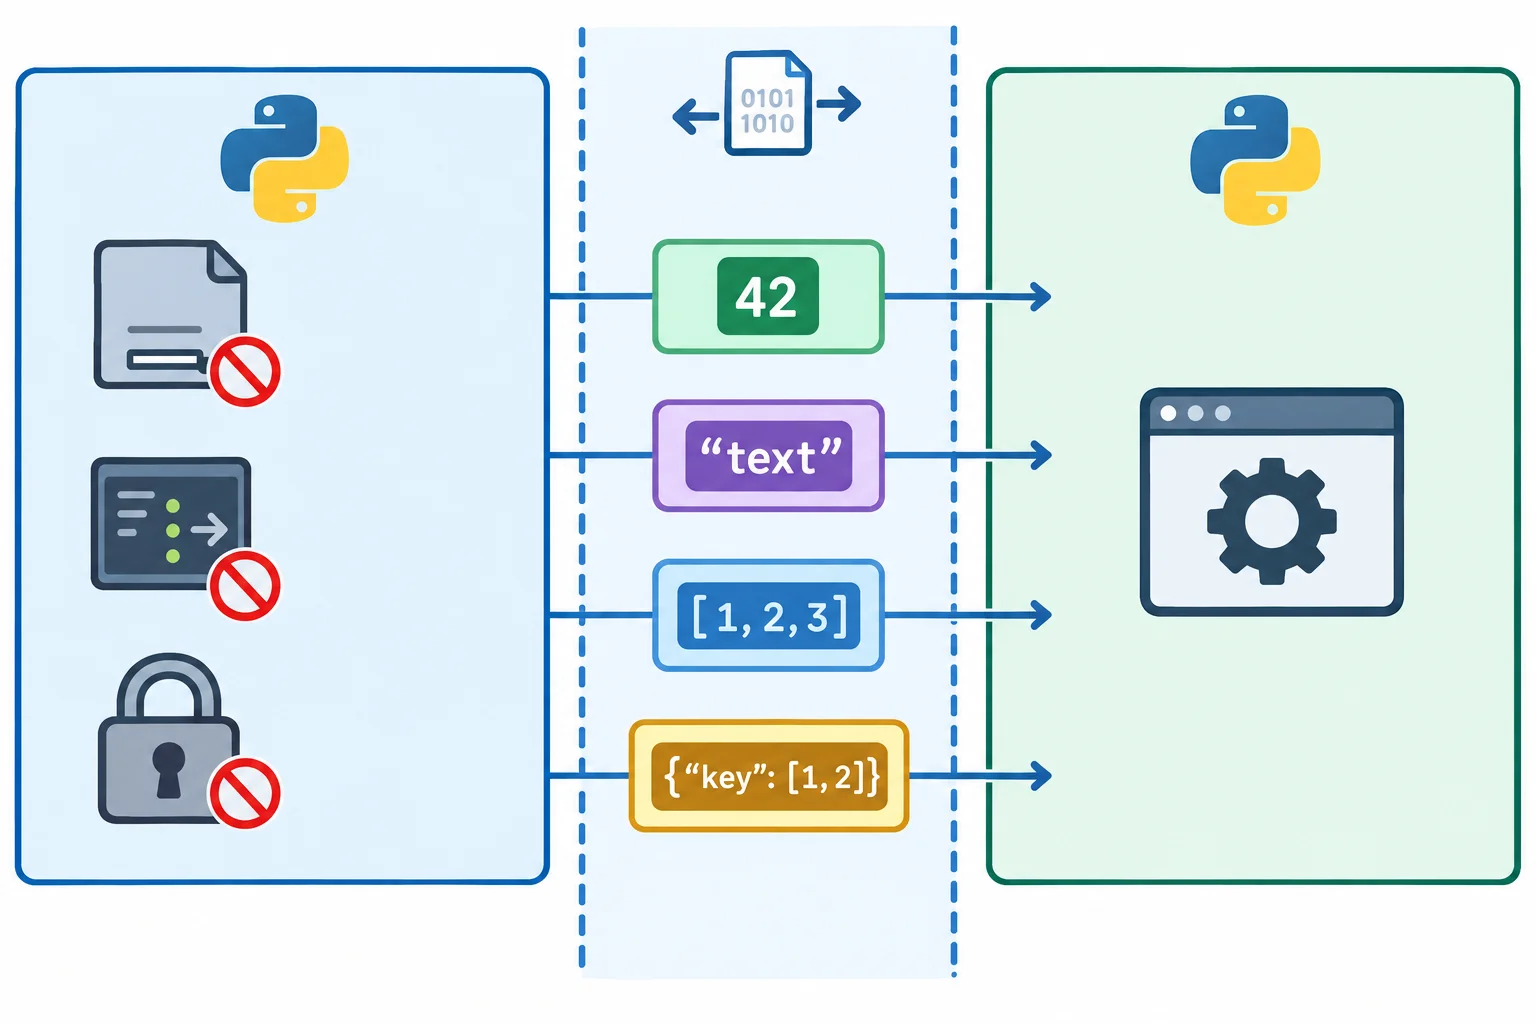
A compatibilidade deve ser verificada recursivamente: uma coleção só é transportável se seus conteúdos também forem.
Exemplo
Evite enviar um arquivo já aberto:
# Evite: arquivo é um recurso vivo
with open("entrada.txt", encoding="utf-8") as arquivo:
    futuro = executor.submit(contar_linhas, arquivo)
Envie uma descrição serializável, como o caminho. A própria função trabalhadora abre e fecha o recurso:
from pathlib import Path


def contar_linhas(caminho: str) -> int:
    with Path(caminho).open(encoding="utf-8") as arquivo:
        return sum(1 for _ in arquivo)


futuro = executor.submit(contar_linhas, "entrada.txt")
O mesmo princípio vale para configurações: envie dados concretos, como textos, números ou dicionários compatíveis, e não objetos que dependem de um processo específico.
Um gerador também é um objeto vivo de consumo progressivo e não é uma escolha portável para enviar ao trabalhador. Se a fonte produz valores sob demanda, materialize somente o próximo lote finito antes da submissão.
Por exemplo, use lote = list(...) para formar uma lista limitada de itens e envie essa lista. Não tente transportar o próprio gerador.
Associe cada item à classificação ou à substituição mais adequada para usá-lo em uma chamada de processo.
Toque em um item e depois no par correspondente.
Atenção
A desserialização com pickle pode executar código. Não carregue conteúdo serializado de origem não confiável e não trate um processo separado como uma barreira para executar código hostil.
Use o executor para executar funções e transportar dados que seu próprio programa controla e nos quais você confia.
Uma tarefa precisa contar linhas de um arquivo. Qual assinatura representa o melhor contrato para uma função submetida ao pool?
Passo 5 de 8
Corrija uma tarefa que espera compartilhar mutações entre processos e passe a comunicar configuração e resultados de forma explícita.
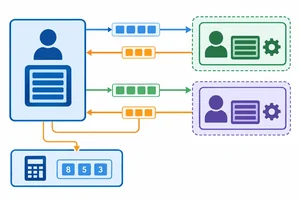
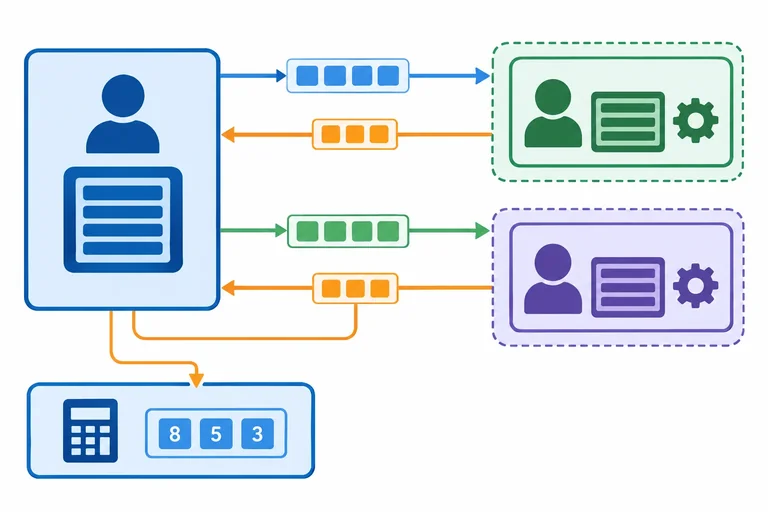
Quando uma lista é enviada a uma tarefa, ela atravessa a fronteira entre processos por serialização. O trabalhador recebe uma reconstrução dessa lista em sua própria memória. Portanto, alterar essa cópia não modifica a lista que ficou no processo principal.
A lista enviada e a lista original têm conteúdos iniciais equivalentes, mas são objetos independentes em memórias separadas.
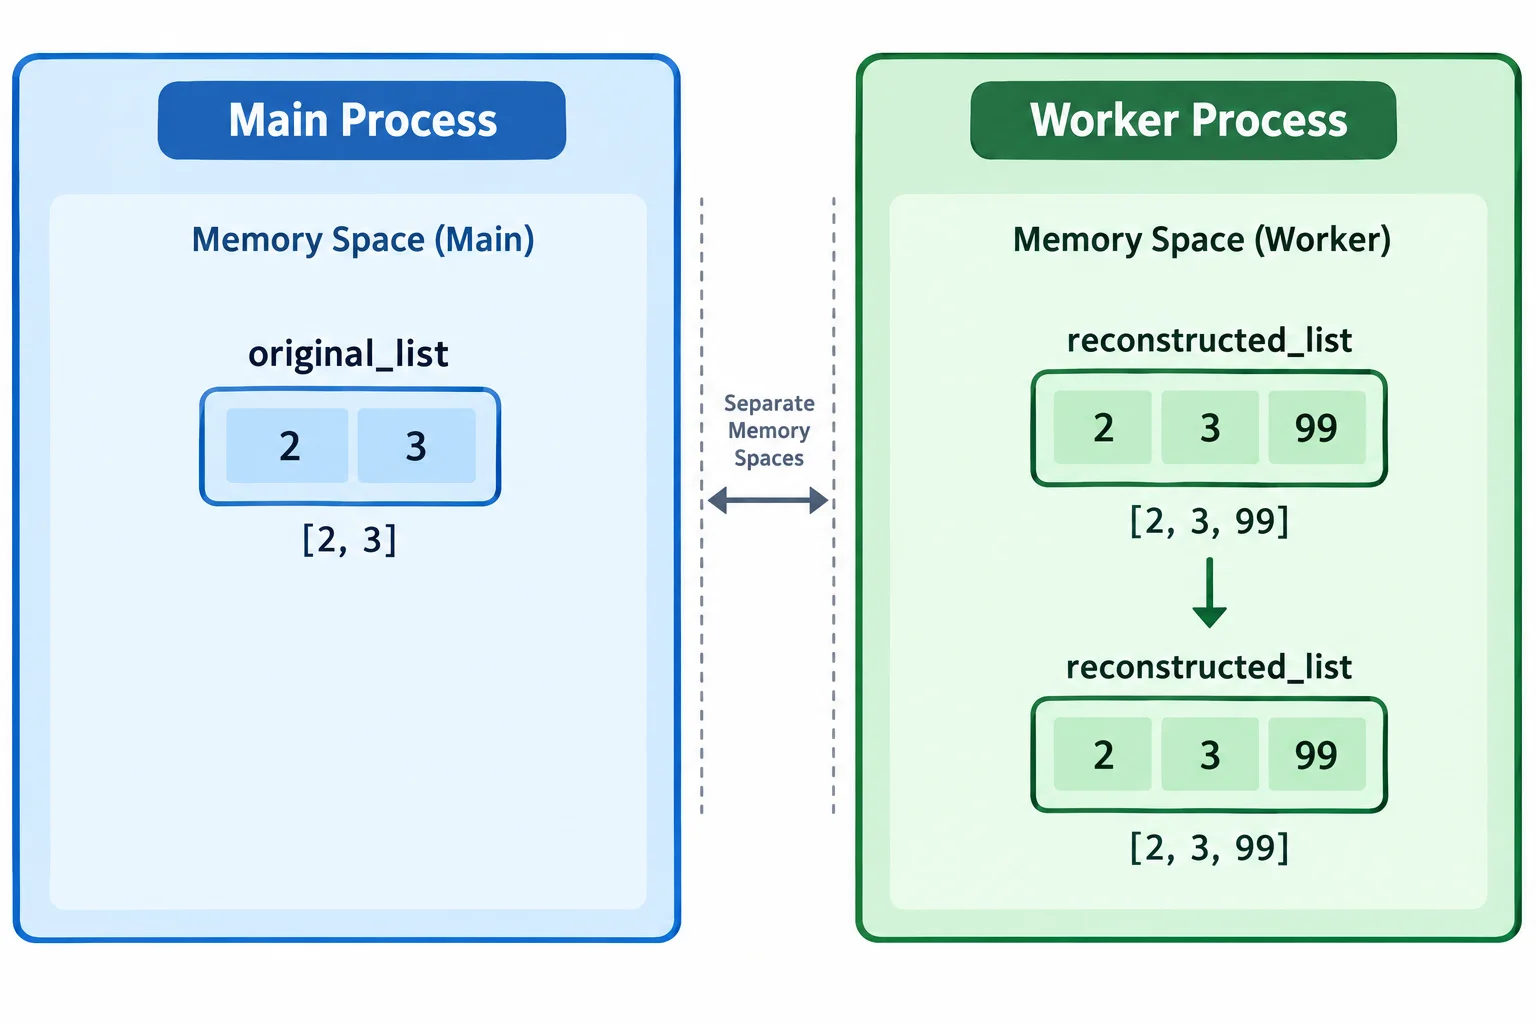
A seta transporta dados; ela não cria uma referência compartilhada entre os processos.
Se uma tarefa em um trabalhador executa valores.append(99), a lista valores do processo principal é alterada automaticamente.
Com o contexto spawn, o trabalhador inicia um novo interpretador e importa os módulos de que precisa. Uma alteração feita pelo principal em uma global depois da importação não vira configuração desse trabalhador. Além disso, um mesmo trabalhador pode executar mais de uma chamada e manter seu próprio estado global entre elas; não baseie a correção nisso.
Este desenho está incorreto: FATOR pode ter no trabalhador apenas o valor definido quando o módulo foi importado, não o valor atribuído pelo principal antes da submissão.
# tarefas.py
FATOR = 1

def quadrado_ajustado(numero: int) -> int:
    return numero * numero * FATOR

# main.py
from tarefas import FATOR, quadrado_ajustado

# Alterar esta global no principal não configura os trabalhadores.
FATOR = 10
# executor.submit(quadrado_ajustado, 3)
Dica
Se um valor influencia o cálculo, inclua-o nos argumentos da tarefa. Assim, cada chamada declara a configuração de que precisa, independentemente de qual trabalhador a executar.
Em vez de uma tarefa tentar atualizar um acumulador global, ela recebe um lote e a configuração necessária, calcula uma soma parcial e a retorna. O processo principal reúne os retornos. A ordem e a distribuição dos lotes podem variar sem mudar o total correto.
Crie os dois arquivos no mesmo diretório e execute python main.py no terminal. O exemplo usa lotes pequenos e contexto spawn explícito.
# tarefas.py
def soma_quadrados(lote: list[int], fator: int) -> int:
    return sum(numero * numero * fator for numero in lote)

# main.py
import multiprocessing
from concurrent.futures import ProcessPoolExecutor

from tarefas import soma_quadrados


def main() -> None:
    lotes = [[1, 2], [3, 4], [5]]
    fator = 2
    contexto = multiprocessing.get_context("spawn")

    with ProcessPoolExecutor(max_workers=2, mp_context=contexto) as executor:
        futuros = [
            executor.submit(soma_quadrados, lote, fator)
            for lote in lotes
        ]
        parciais = [futuro.result() for futuro in futuros]

    total = sum(parciais)
    referencia = sum(numero * numero * fator for lote in lotes for numero in lote)
    print(f"Parciais: {parciais}")
    print(f"Total: {total}; referência: {referencia}")


if __name__ == "__main__":
main()Execute o programa localmente. Quais valores foram mostrados em Parciais, Total e referência? Explique, em uma ou duas frases, por que esse desenho não depende de um acumulador global compartilhado.
Escreva pelo menos 80 caracteres (0/80).
Se cada lote recebe o mesmo fator como argumento e o principal soma todos os retornos, o resultado correto não deve depender de qual trabalhador executou cada lote.
Resumo
spawn, valores globais alterados pelo principal não são uma forma confiável de configurar trabalhadores.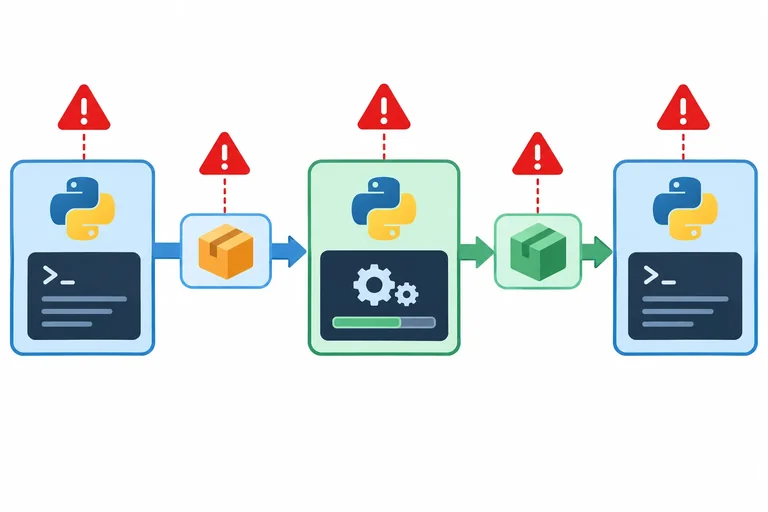
Passo 6 de 8
Compare falhas controladas para descobrir em que etapa uma chamada entre processos deixou de produzir um resultado.
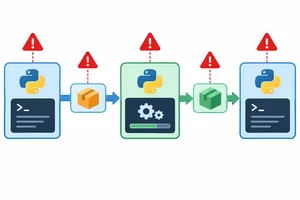
Uma chamada submetida ao ProcessPoolExecutor passa por três momentos: envio da função e dos argumentos, execução no trabalhador e transporte do retorno. Future.result() é o ponto em que você normalmente observa a falha, mas isso não informa sozinho em qual momento ela aconteceu.
Uma ValueError levantada pela própria função é uma falha de execução: o trabalhador recebeu a chamada e o pool pode continuar atendendo outras tarefas. Já uma falha de serialização pode ocorrer antes de o corpo da função começar ou depois que ele terminou, ao devolver o resultado.
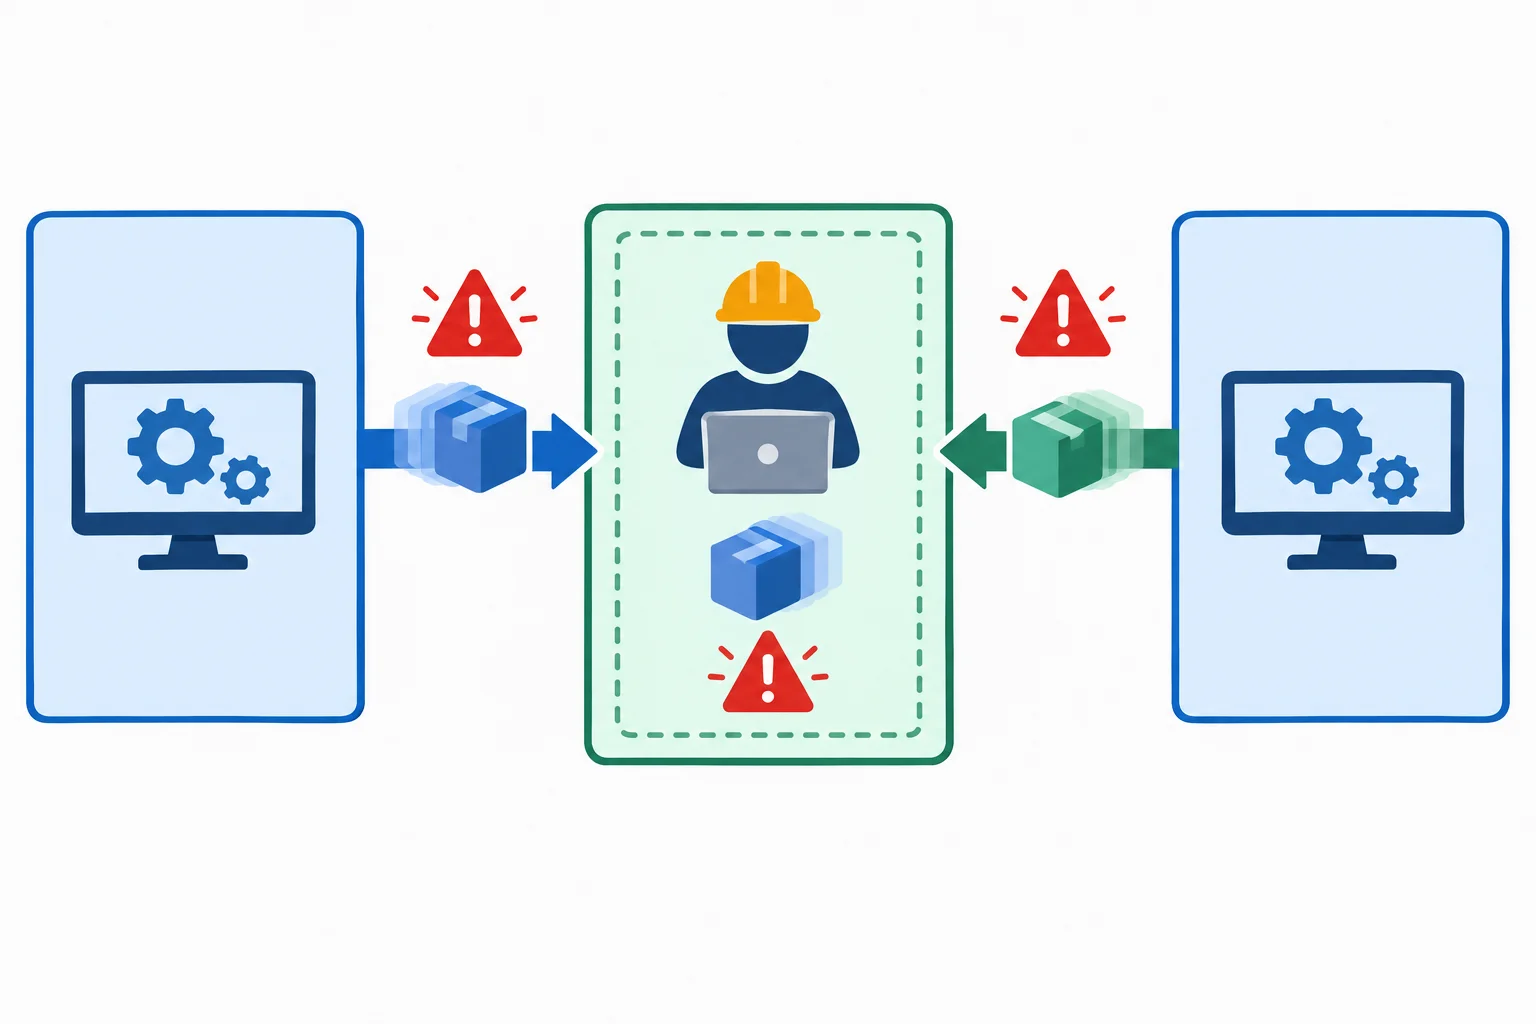
A mesma espera por future.result() pode revelar falhas ocorridas em etapas diferentes.
Atenção
executor.submit(...) devolver um futuro só confirma que a chamada foi aceita para acompanhamento. Se argumentos, referência da função ou retorno não puderem ser serializados, o erro pode aparecer apenas quando você consulta future.result(). Registre a entrada associada a cada futuro para diagnosticar qual caso falhou.
Crie este módulo com funções no nível superior, como nos steps anteriores.
def quadrado_validado(entrada: tuple[str, int]) -> tuple[str, int]:
    identificador, numero = entrada
    if numero < 0:
        raise ValueError(f"{identificador}: número não pode ser negativo")
    return identificador, numero * numero


def retorno_nao_transportavel(identificador: str) -> tuple[str, object]:
    # O corpo chega a executar, mas um gerador não pode ser devolvido por pickle.
return identificador, (n for n in range(3))Execute como script no terminal com python main.py. O bloqueio é propositalmente incompatível com o transporte entre processos.
from concurrent.futures import ProcessPoolExecutor
from multiprocessing import get_context
from threading import Lock

from tarefas import quadrado_validado, retorno_nao_transportavel


def main() -> None:
    casos = [
        ("validação", quadrado_validado, ("item-1", -2)),
        ("argumento", quadrado_validado, ("item-2", Lock())),
        ("retorno", retorno_nao_transportavel, "item-3"),
    ]

    contexto = get_context("spawn")
    with ProcessPoolExecutor(max_workers=2, mp_context=contexto) as executor:
        futuros = {
            executor.submit(funcao, entrada): identificador
            for identificador, funcao, entrada in casos
        }

        for futuro, identificador in futuros.items():
            try:
                print(identificador, "->", futuro.result())
            except Exception as erro:
                print(identificador, "->", type(erro).__name__, erro)


if __name__ == "__main__":
    main()
Exemplo
validação: quadrado_validado executa e levanta ValueError. A entrada chegou ao trabalhador; é uma regra do cálculo que recusou o valor.argumento: o Lock() não pode ser serializado. O corpo de quadrado_validado não recebe esse argumento e pode nem começar a executar.retorno: retorno_nao_transportavel cria o gerador e chega ao return, mas o gerador não pode atravessar a fronteira de volta. Portanto, não receber resultado não prova que a função não executou.O texto e até a classe concreta do erro de serialização variam conforme o objeto e a plataforma. Use a etapa e a entrada identificada no diagnóstico, em vez de depender de um único tipo de exceção.
Relacione cada situação à conclusão sobre o corpo da função trabalhadora.
Toque em um item e depois no par correspondente.
Passo 7 de 8
Diferencie uma falha isolada de tarefa de um pool inutilizável e escolha uma resposta segura para cada situação.
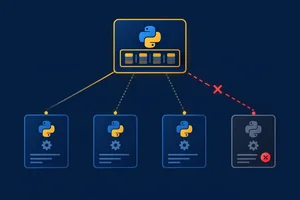
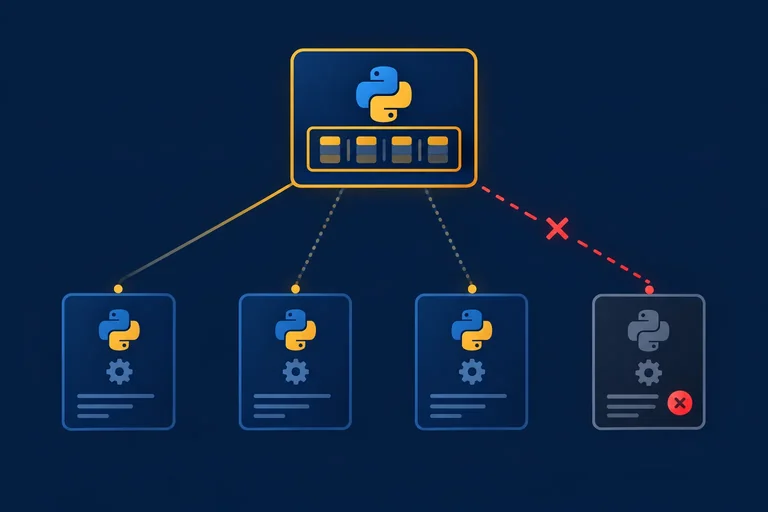
BrokenProcessPool, de concurrent.futures.process, indica que um trabalhador terminou de forma anormal e que o executor não pode mais ser usado com segurança. Isso pode ocorrer, por exemplo, após uma falha fatal durante a inicialização ou a importação no processo filho.
Isso é diferente de uma ValueError levantada por uma função: nesse caso, o futuro daquela chamada falha, mas o pool normalmente continua disponível para as demais tarefas.
Compare o alcance de cada falha antes de decidir como reagir.
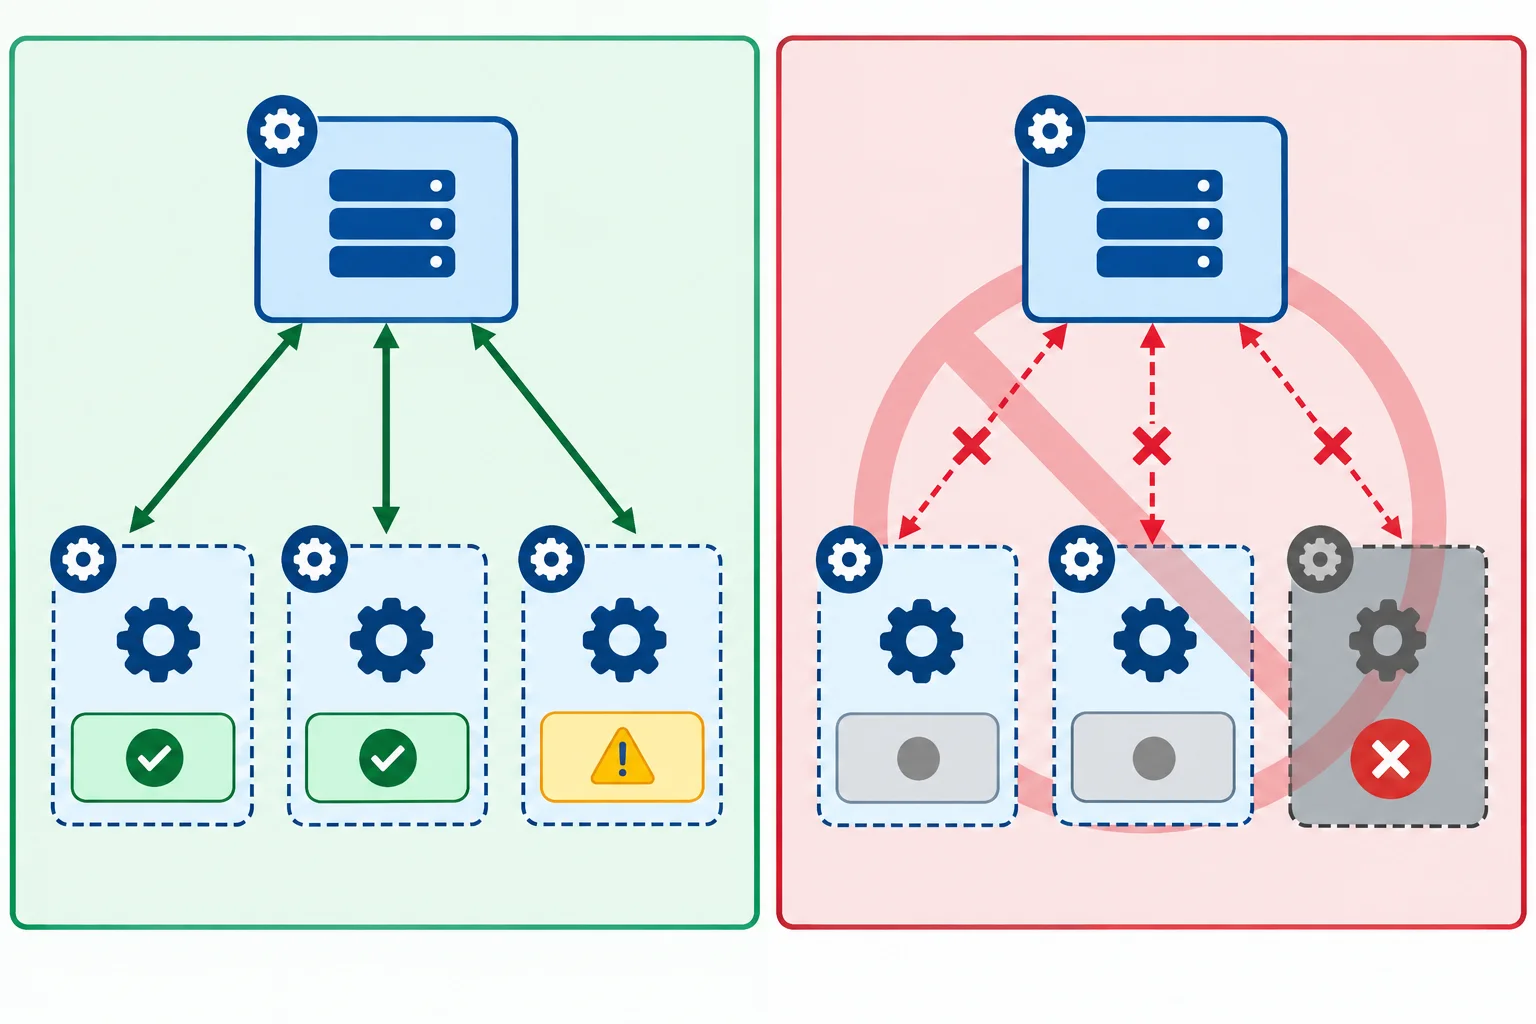
Uma exceção da tarefa afeta seu futuro; um encerramento anormal pode inutilizar o executor inteiro.
Atenção
Um BrokenProcessPool não informa sozinho a causa original nem quais tarefas chegaram a executar antes da interrupção. Não reenvie automaticamente os itens afetados: eles podem ter produzido efeitos externos ou ter sido concluídos sem que o resultado fosse recebido.
Exemplo
from concurrent.futures.process import BrokenProcessPool

for entrada, futuro in futuros.items():
    try:
        resultado = futuro.result()
    except BrokenProcessPool:
        print(f"pool quebrado ao observar {entrada!r}")
        # Pare de usar este executor e investigue a causa.
        break
    except ValueError as erro:
        print(f"entrada inválida {entrada!r}: {erro}")
    else:
        print(f"{entrada!r} -> {resultado}")
Após BrokenProcessPool, saia do fluxo que usa o executor. O with encerra o ciclo de vida do executor ao fim do bloco; só considere criar outro pool depois de investigar a causa e decidir se é seguro retomar o trabalho.
Procure primeiro mensagens emitidas durante a inicialização e a importação do processo filho, além de falhas externas que possam ter encerrado o trabalhador. Uma submissão que falha por serialização, por si só, não significa que o pool tenha quebrado.
Registre qual entrada está associada a cada futuro, mas trate essa associação como contexto de diagnóstico — não como prova de que aquela entrada causou a quebra.
Os futuros de um lote são observados. Para a entrada -3, future.result() levanta ValueError("valor deve ser não negativo"); os demais futuros continuam produzindo resultados. Qual ação é mais coerente?
Durante a observação de resultados, um futuro levanta BrokenProcessPool. Em seguida, uma nova chamada a submit() no mesmo executor também falha. Qual é a resposta apropriada?
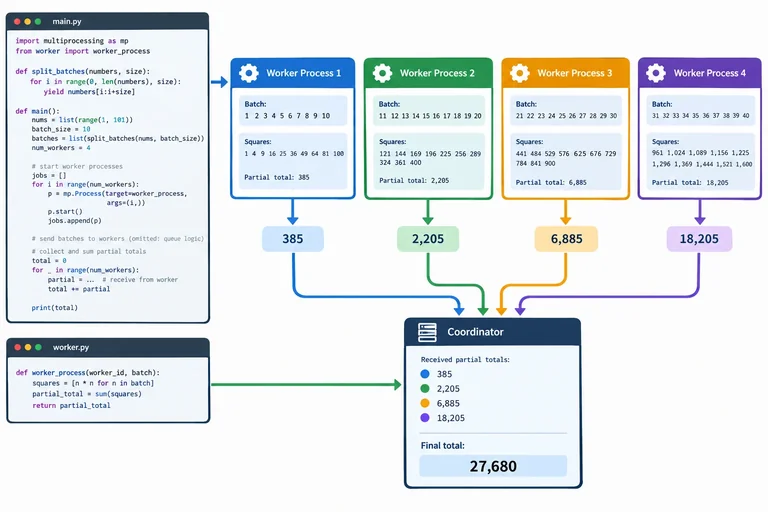
Passo 8 de 8
Monte e valide uma aplicação local completa com ProcessPoolExecutor, contexto spawn, dados transportáveis e consolidação no processo principal.
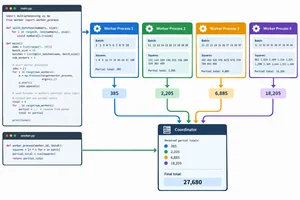
Nesta aplicação, main.py coordena e tarefas.py contém a função importável. O processo principal envia lotes finitos de números e uma configuração explícita; os trabalhadores devolvem subtotais. O principal soma esses retornos e compara o total com uma referência sequencial.
Não há dependência de memória global compartilhada: cada resultado necessário volta pela fronteira entre processos.
Observe que cada trabalhador recebe uma cópia transportada dos dados do lote e devolve apenas um valor calculado.
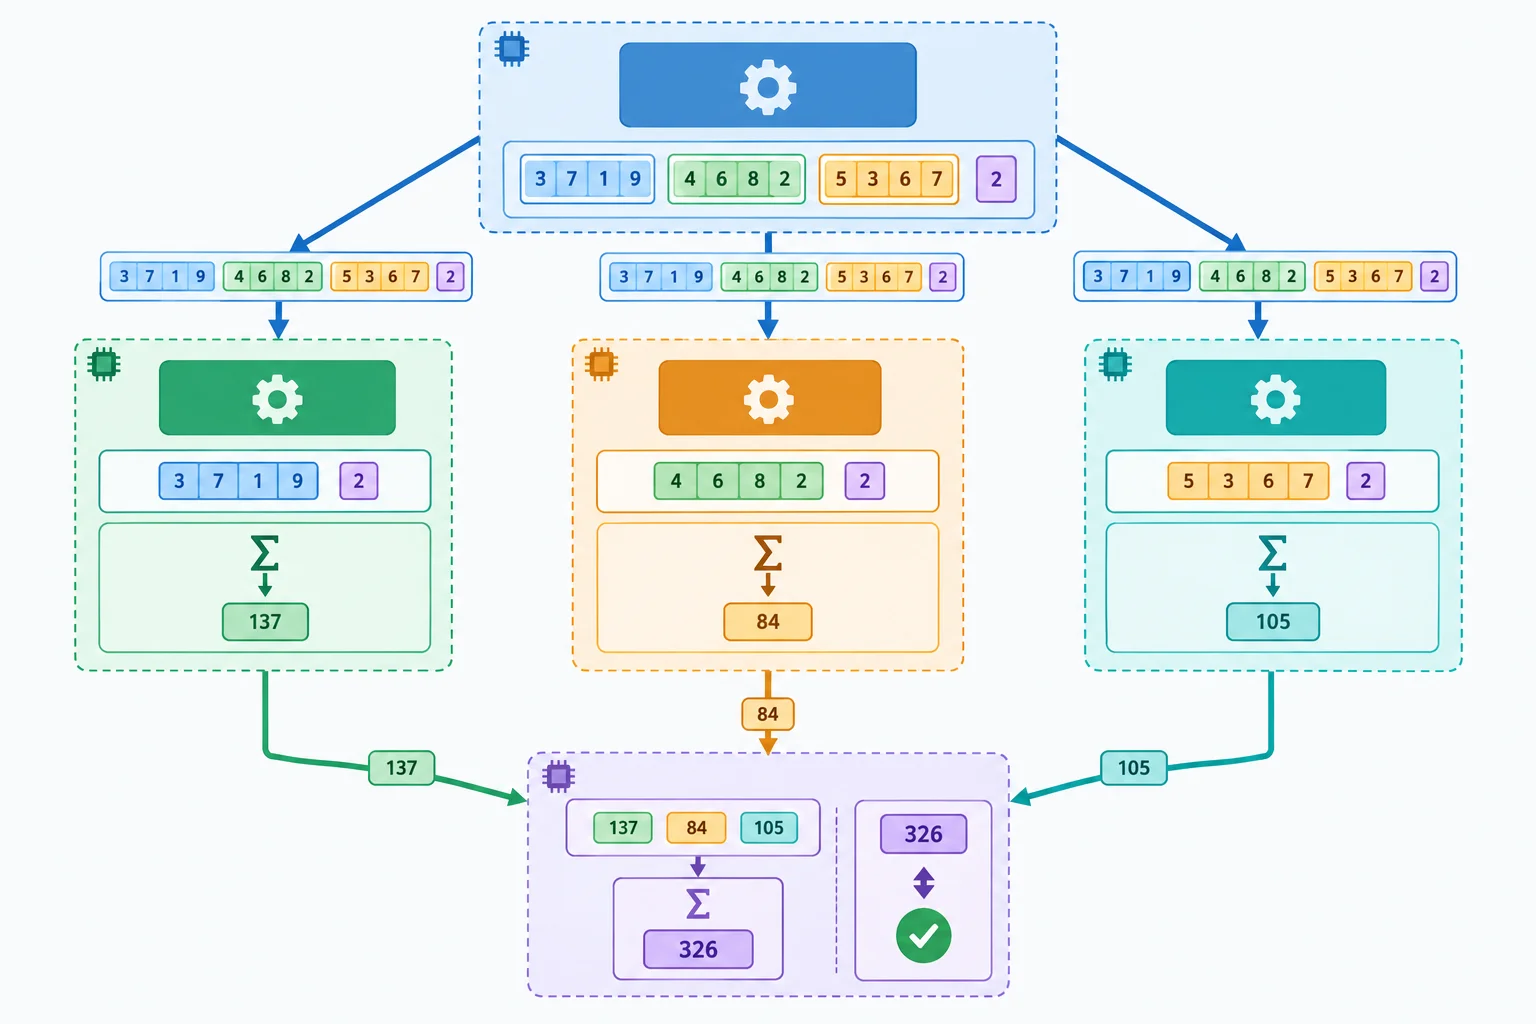
A correção vem dos argumentos e retornos explícitos, não da ordem de execução nem de mutações em memória.
Crie um arquivo chamado tarefas.py na mesma pasta do programa.
def soma_quadrados(valores: list[int], fator: int) -> int:
    """Calcula um subtotal sem depender de estado global."""
    if fator < 1:
        raise ValueError("fator deve ser positivo")

    return fator * sum(valor * valor for valor in valores)
Crie main.py na mesma pasta. A função trabalhadora fica em outro módulo, enquanto a criação do pool fica protegida dentro de main().
from concurrent.futures import ProcessPoolExecutor
import multiprocessing as mp

from tarefas import soma_quadrados


def main() -> None:
    lotes = [[1, 2, 3], [4, 5], [6]]
    fator = 2

    referencia_sequencial = fator * sum(
        valor * valor
        for lote in lotes
        for valor in lote
    )

    contexto = mp.get_context("spawn")
    with ProcessPoolExecutor(max_workers=2, mp_context=contexto) as executor:
        futuros = [
            executor.submit(soma_quadrados, lote, fator)
            for lote in lotes
        ]
        subtotais = [futuro.result() for futuro in futuros]

    total_processos = sum(subtotais)

    print(f"Subtotais: {subtotais}")
    print(f"Total pelos processos: {total_processos}")
    print(f"Referência sequencial: {referencia_sequencial}")
    print(f"Resultados equivalentes: {total_processos == referencia_sequencial}")


if __name__ == "__main__":
    main()
No terminal, entre na pasta que contém os dois arquivos e execute:
python main.py
A ordem dos subtotais pode variar se você alterar a forma de coleta, mas o total deve ser 182, igual à referência sequencial. Esta comparação verifica a correção do cálculo; ela não é um benchmark.
Execute o programa. Qual foi o resultado da comparação? Explique por que a consolidação usa os subtotais retornados, em vez de esperar alterações em uma coleção do processo principal.
Escreva pelo menos 80 caracteres (0/80).
Associe cada cenário à categoria mais adequada.
Toque em um item e depois no par correspondente.
Resumo
Use este checklist ao distribuir cálculos entre processos.
Parabéns! Você concluiu: Executar funções em processos com ProcessPoolExecutor
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks