Passo 1 de 9
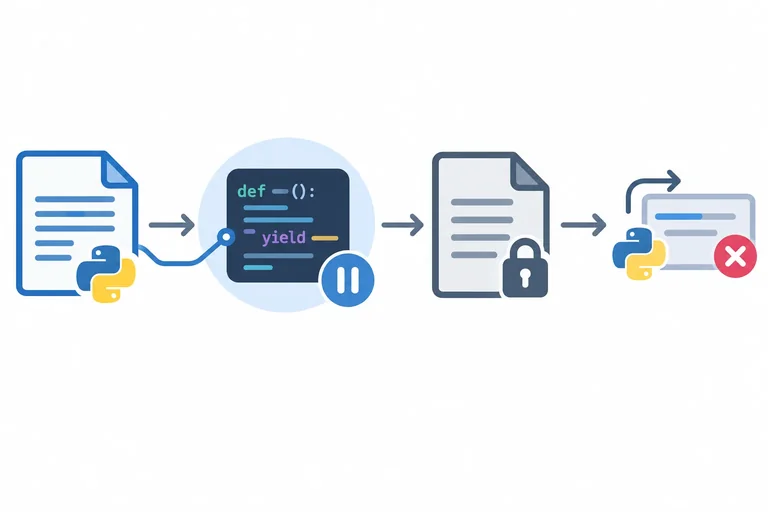
A fonte precisa estar aberta durante o consumo
Diagnostique a diferença entre criar um fluxo sob demanda e ler seus registros de fato.
Trilha de aprendizado · Nível 10 · Tutorial 8
Organizar o processamento incremental de arquivos mantendo a fonte disponível durante o consumo, evitando perda de registros e planejando novas passagens quando necessário.
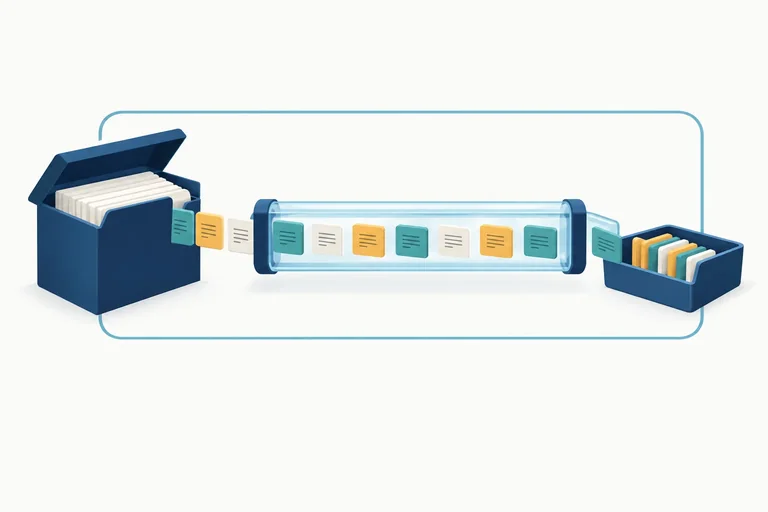
 A fonte precisa estar aberta durante o consumo
Diagnostique a diferença entre criar um fluxo sob demanda e ler seus registros de fato. 2 min
 Deixar o consumidor controlar o arquivo
Corrija o fluxo para que o arquivo permaneça aberto desde a composição das etapas até o consumo de seus valores. 3 min
 Fechar a fonte mesmo sem terminar o fluxo
Entenda por que o escopo do with, e não o destino do gerador, define quando o arquivo é fechado. 2 min
 Inspecionar também pode consumir registros
Entenda como prévias, verificações e depuração podem avançar um arquivo e retirar dados do processamento seguinte. 2 min
 Reabrir a fonte para uma nova passagem
Planeje uma segunda leitura completa recriando o arquivo aberto e o fluxo que depende dele. 2 min
 Materializar apenas o que tem limite
Escolha entre reabrir o arquivo para uma passagem completa e guardar uma amostra pequena para reutilização posterior. 2 min
 Reconhecer o que um gerador mantém referenciado
Diferencie objetos que continuam alcançáveis pelo estado suspenso de um gerador do estado aberto ou fechado do arquivo. 2 min
 Testar o ciclo de vida com arquivos temporários
Teste o resultado do fluxo e o fechamento do arquivo nos caminhos de consumo completo, interrupção antecipada e falha de conversão. 4 min
 Aplicar e revisar o processamento de consumo único
Integre o cálculo completo, uma amostra limitada reutilizável e testes do ciclo de vida do arquivo. 3 min
Passo 1 de 9
Diagnostique a diferença entre criar um fluxo sob demanda e ler seus registros de fato.
Uma expressão geradora produz valores sob demanda. Ao criá-la, o Python prepara o fluxo, mas ainda não lê as linhas necessárias para entregar o primeiro resultado.
Por isso, quando a fonte é um arquivo, ela precisa continuar aberta no momento em que o fluxo for avançado com for, next(), list() ou outro consumidor.
A criação do gerador ocorre enquanto o arquivo está aberto; a leitura só é solicitada depois que o bloco with já terminou.
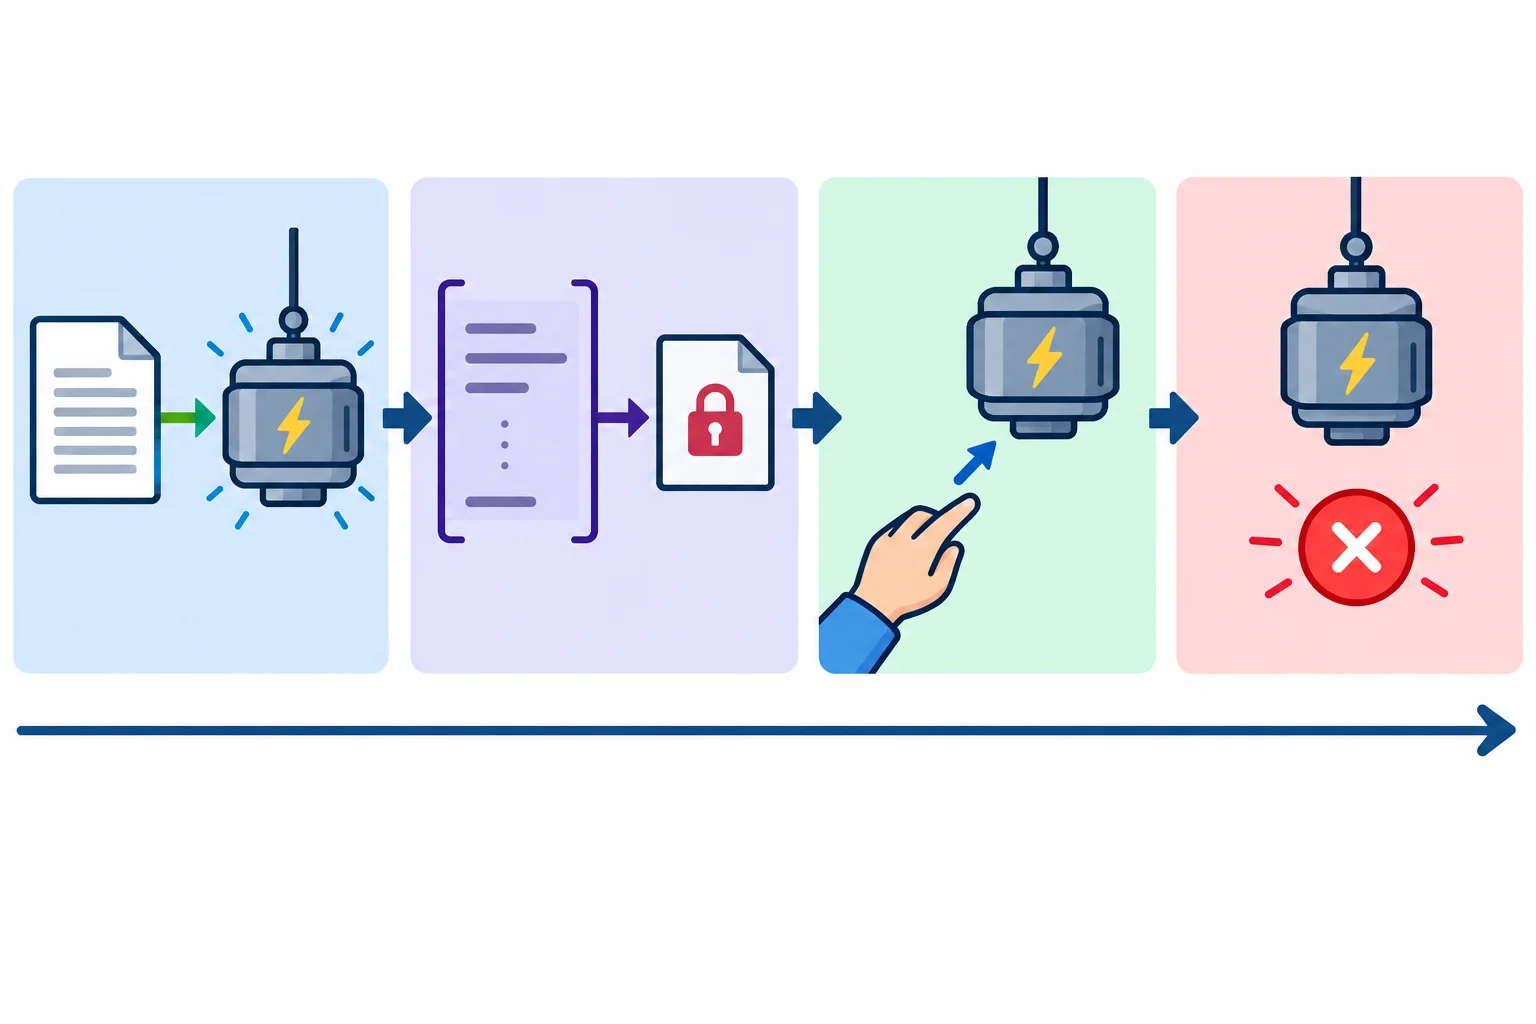
O gerador guarda a dependência da fonte; ele não guarda automaticamente todas as linhas lidas.
Considere este conteúdo em leituras.txt:
10\n\n25\n
def leituras_validas(caminho):
    with open(caminho, encoding="utf-8") as arquivo:
        return (int(linha) for linha in arquivo if linha.strip())

fluxo = leituras_validas("leituras.txt")
print("Fluxo criado")
print(next(fluxo))A chamada leituras_validas(...) cria e retorna a expressão geradora sem precisar avançá-la. Em seguida, o bloco with termina e fecha arquivo.
A falha ocorre em next(fluxo): para produzir o primeiro inteiro, o gerador tenta obter uma linha de arquivo, que já está fechado. O resultado é um ValueError, normalmente com uma mensagem como I/O operation on closed file.
Atenção
Um gerador pode continuar existindo depois que o arquivo foi fechado. Manter uma referência ao gerador não reabre o arquivo e não antecipa a leitura de seus registros.
No código apresentado, qual instrução tenta ler o arquivo fechado e provoca o erro?
Resumo
Use esta pergunta ao analisar um fluxo derivado de arquivo:
with.Dica
Desconfie de uma função que abre um arquivo com with e devolve diretamente um gerador, map, filter ou outra etapa sob demanda baseada nesse arquivo. No próximo passo, você reorganizará o uso para que abertura e consumo ocorram no mesmo período.
Passo 2 de 9
Corrija o fluxo para que o arquivo permaneça aberto desde a composição das etapas até o consumo de seus valores.
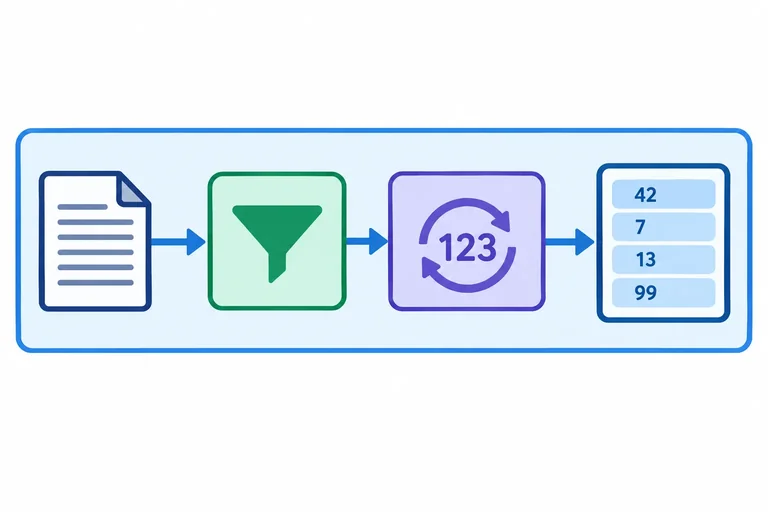
A função de transformação pode devolver um iterador incremental, mas ela deve receber o arquivo já aberto. Assim, o código consumidor controla o recurso: abre o arquivo com with, monta o fluxo e o consome antes de sair desse bloco.
O ponto essencial é que o list(...), o for ou outro consumidor final também fique dentro do with.
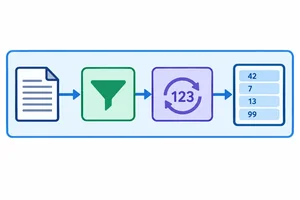
O arquivo pertence ao escopo externo; as etapas apenas transformam os registros fornecidos.
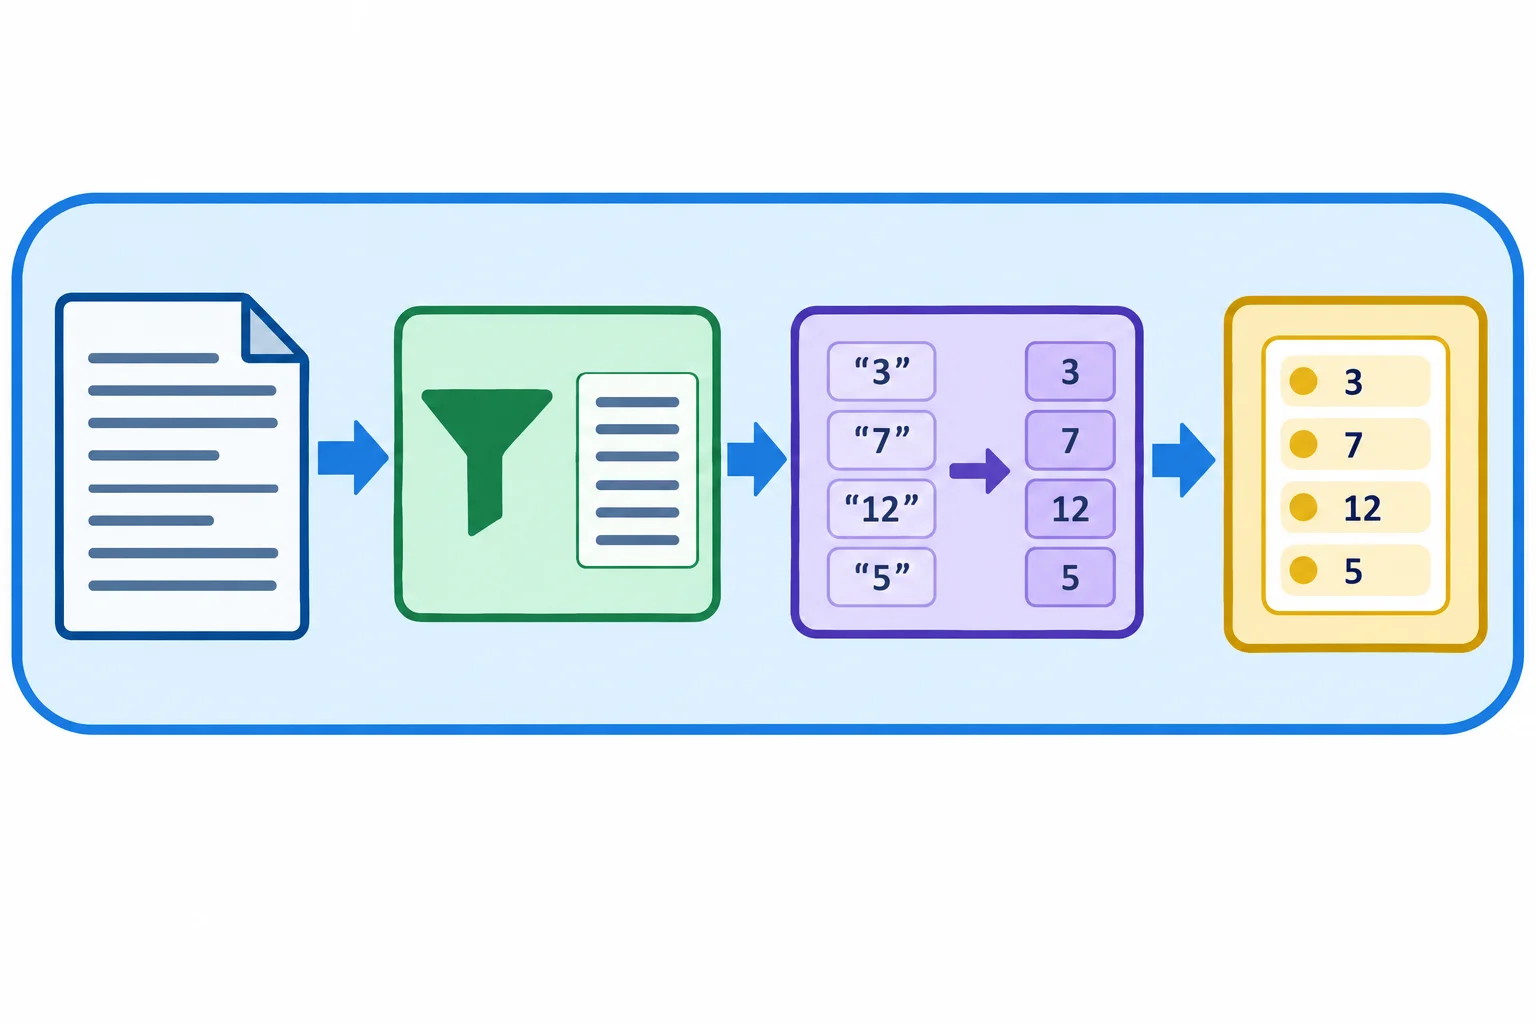
O with envolve a fonte, a composição do fluxo e seu consumo.
Dica
Uma função que recebe arquivo não deve chamar open() nem close(): ela trabalha somente com os registros que receber.
No seu computador, crie um arquivo chamado leituras.txt na mesma pasta do script, com este conteúdo. Há uma linha vazia entre 18 e 27:
12
18

27
35
A função devolve um iterador, mas a lista é criada enquanto o arquivo ainda está aberto.
from pathlib import Path


def leituras_validas(arquivo):
    linhas_nao_vazias = (linha.strip() for linha in arquivo)
    return (int(linha) for linha in linhas_nao_vazias if linha)


caminho = Path("leituras.txt")

with caminho.open(encoding="utf-8") as arquivo:
    fluxo = leituras_validas(arquivo)
    leituras = list(fluxo)

print(leituras)
Exemplo
Ao executar python processar_leituras.py, o resultado é:
[12, 18, 27, 35]
A linha vazia é descartada, e cada outra linha é convertida para int somente quando o fluxo é consumido.
Execute o código. Qual resultado apareceu? Em seguida, indique qual trecho garante que o arquivo continue aberto durante todo o consumo do fluxo.
Escreva pelo menos 80 caracteres (0/80).
Passo 3 de 9
Entenda por que o escopo do with, e não o destino do gerador, define quando o arquivo é fechado.
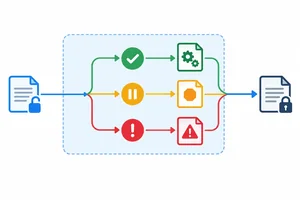
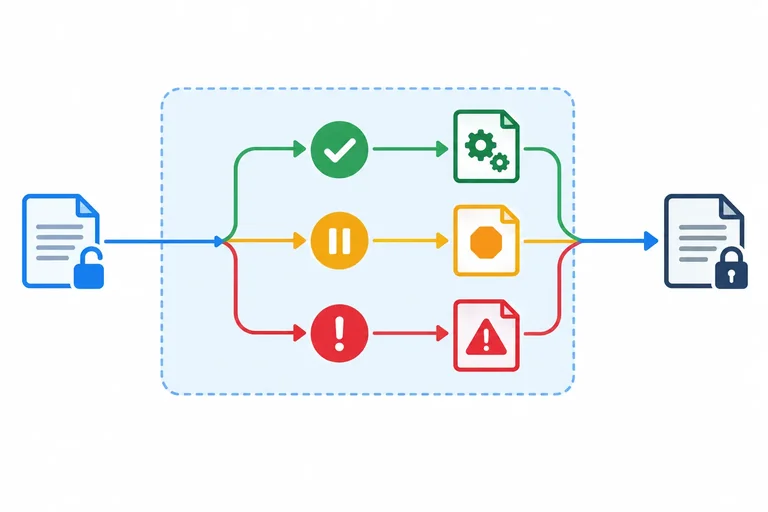
Quando o consumidor abre o arquivo com with, esse bloco é responsável por fechá-lo. Isso vale se o fluxo for consumido por inteiro, se o laço parar cedo ou se uma transformação lançar uma exceção.
Um break encerra apenas o laço mais próximo. Se a execução continuar dentro do with, o arquivo continua aberto.
Observe onde cada caminho termina: todos fecham o arquivo somente ao sair do bloco with.
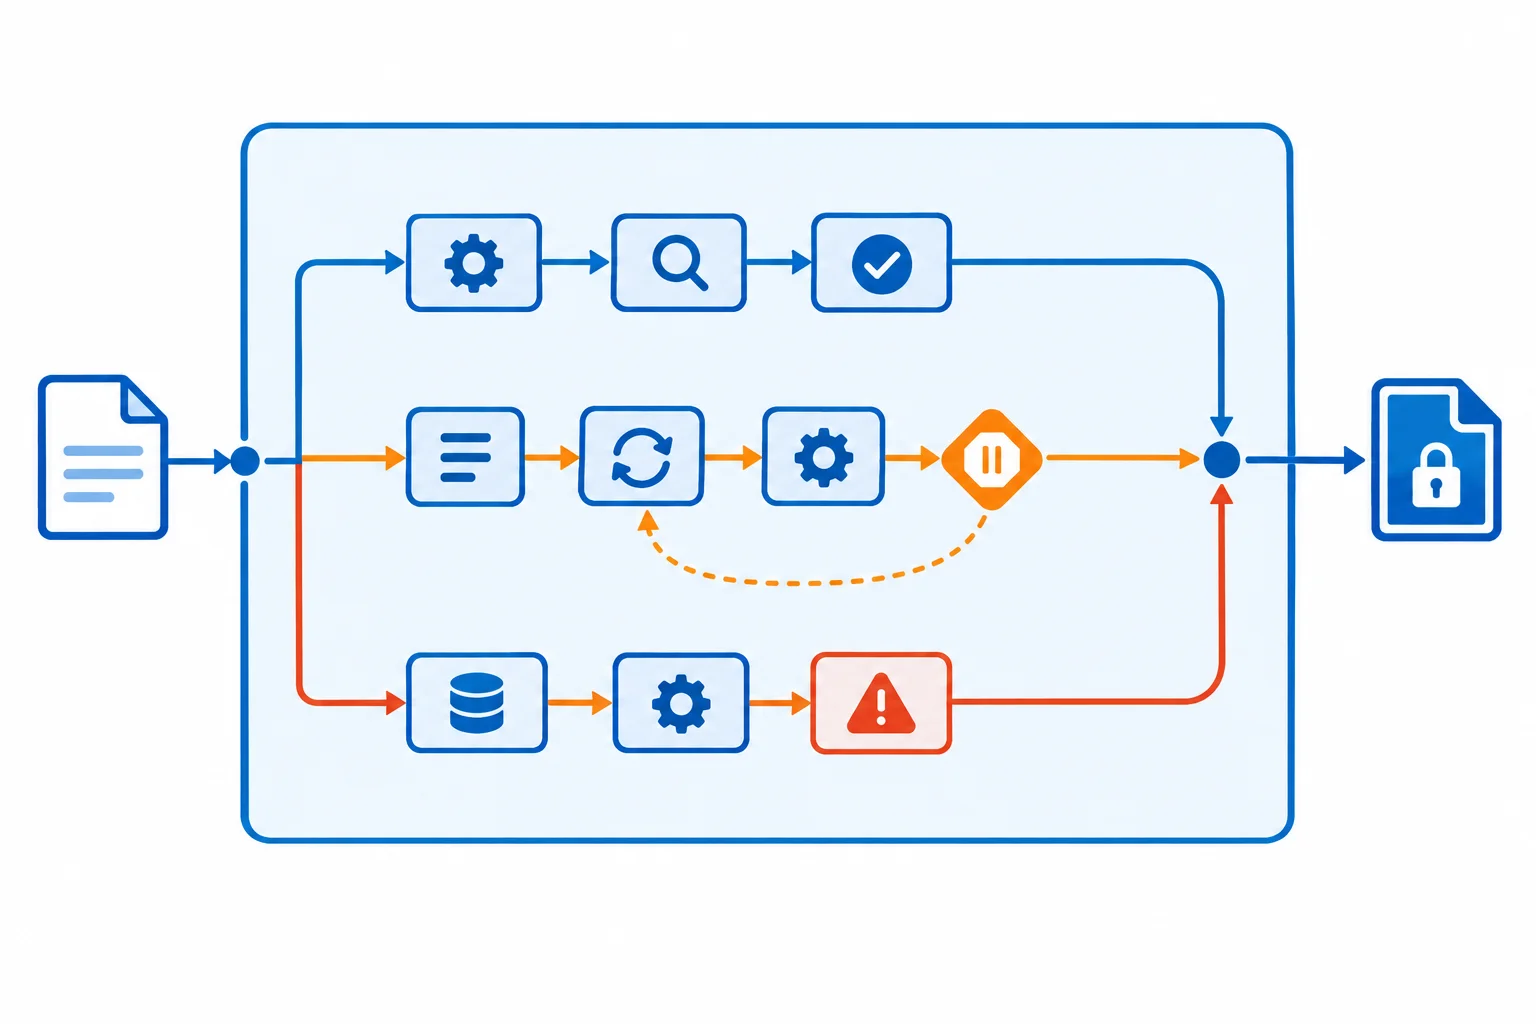
O arquivo fica aberto durante o bloco; a saída do with é o ponto comum de fechamento.
A mensagem após o laço ainda é executada com o arquivo aberto.
def leituras_validas(arquivo):
    for linha in arquivo:
        valor = linha.strip()
        if valor:
            yield int(valor)

with open("leituras.txt", encoding="utf-8") as arquivo:
    fluxo = leituras_validas(arquivo)

    for leitura in fluxo:
        print(leitura)
        break

    print(arquivo.closed)  # False: ainda estamos dentro do with

print(arquivo.closed)  # True: saímos do with
Dica
Interromper, esgotar ou simplesmente deixar de usar um gerador não é a regra que fecha este arquivo. Como ele foi aberto pelo consumidor, mantenha o consumo necessário dentro do with e deixe a saída desse bloco encerrar o recurso.
Se int(valor) receber um texto inválido, o ValueError se propaga. Antes de a exceção alcançar o código externo, a saída do with fecha o arquivo.
Com um arquivo contendo "10\nvalor-inválido\n30\n", a segunda solicitação ao fluxo falha.
def leituras_validas(arquivo):
    for linha in arquivo:
        valor = linha.strip()
        if valor:
            yield int(valor)

arquivo = None
try:
    with open("leituras.txt", encoding="utf-8") as arquivo:
        fluxo = leituras_validas(arquivo)
        print(next(fluxo))  # 10
        print(next(fluxo))  # ValueError
except ValueError:
    print(arquivo.closed)  # True
Atenção
Criar fluxo dentro do bloco e avançá-lo depois da saída continua sendo incorreto: nesse momento, a fonte já estará fechada. A transformação e o consumo devem ocorrer enquanto o with está ativo.
No código do exemplo, logo após o break e antes de sair do bloco with, arquivo.closed é False.
Se int(valor) lançar ValueError durante o consumo, o arquivo aberto pelo with será fechado na saída desse bloco.
Passo 4 de 9
Entenda como prévias, verificações e depuração podem avançar um arquivo e retirar dados do processamento seguinte.
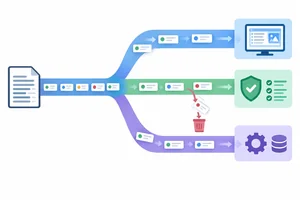
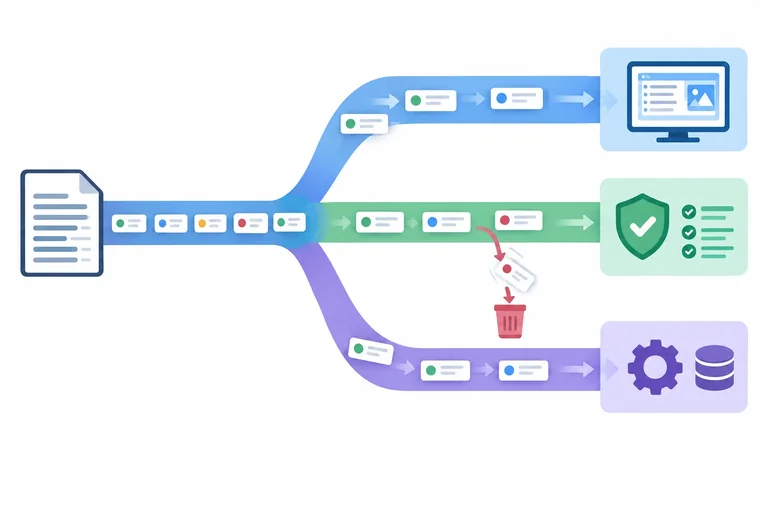
Um arquivo aberto é percorrido em uma única posição de leitura. Quando você usa next(arquivo) para ver uma prévia, esse registro é entregue e a posição avança. O próximo consumidor começa no registro seguinte.
O mesmo vale para any(...): ele consome até encontrar um elemento que torne o resultado verdadeiro — e esse elemento também já foi retirado da fonte. Já list(arquivo), usada como depuração, consome todos os registros que ainda restam.
A posição do arquivo é compartilhada por todas as etapas que o recebem.
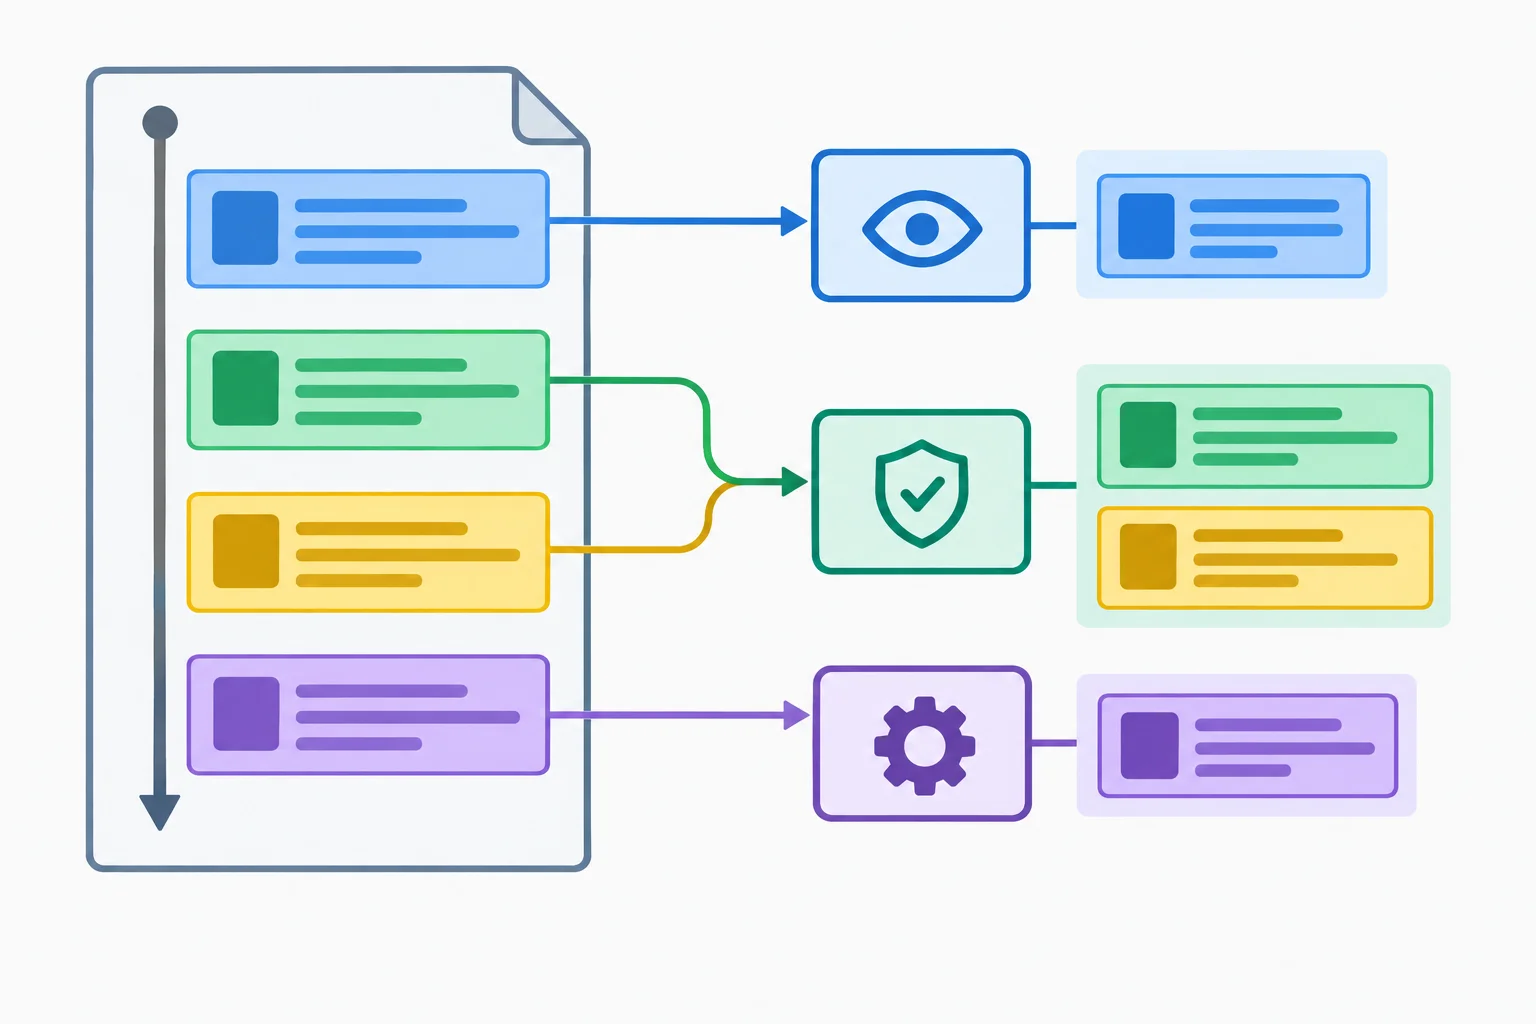
Cada operação avança a mesma fonte; registros já entregues não voltam para o próximo consumidor.
Execute com um arquivo aberto que contenha uma leitura por linha.
def apenas_validas(linhas):
    return (linha.strip() for linha in linhas if linha.strip())

with open("leituras.txt", encoding="utf-8") as arquivo:
    valores = apenas_validas(arquivo)
    alerta = (linha for linha in arquivo if "ERRO" in linha)

    print(next(valores))
print(list(alerta))Embora valores e alerta sejam geradores distintos, ambos pedem linhas ao mesmo arquivo. Após next(valores), a primeira linha foi retirada. Em seguida, list(alerta) percorre todas as linhas restantes para procurar "ERRO" e também deixa a fonte esgotada.
Criar outra etapa sobre o mesmo arquivo não cria uma cópia dos registros nem reinicia sua posição.
Faça o diagnóstico dentro do laço que recebeu a linha atual.
def converter_linhas(linhas):
    for numero, linha in enumerate(linhas, start=1):
        texto = linha.strip()
        if not texto:
            continue

        print(f"Processando linha {numero}: {texto!r}")
        yield int(texto)

with open("leituras.txt", encoding="utf-8") as arquivo:
    total = sum(converter_linhas(arquivo))

print(total)
Dica
Registre a linha ou o valor que a etapa já recebeu. Evite chamar next, any ou list apenas para investigar uma fonte que ainda será usada. Esses consumidores solicitam registros adicionais e alteram o que restará.
Considere um arquivo aberto com as linhas, nesta ordem: 10, 20, ERRO, 40.
Depois de executar:previa = next(arquivo)tem_erro = any("ERRO" in linha for linha in arquivo)
Qual linha será a próxima entregue por next(arquivo)?
Passo 5 de 9
Planeje uma segunda leitura completa recriando o arquivo aberto e o fluxo que depende dele.
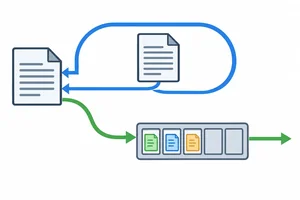
Criar uma nova expressão geradora sobre o mesmo arquivo não reinicia a leitura. O novo fluxo pede linhas a partir da posição atual do arquivo.
Se a primeira etapa já consumiu duas linhas, a segunda etapa enxergará apenas as linhas restantes. Se o arquivo já chegou ao fim, ela nascerá sem elementos para produzir.
Dois fluxos distintos podem depender do mesmo cursor de leitura.
Um novo gerador ligado ao mesmo arquivo continua da posição atual.
Um arquivo aberto contém quatro linhas. Um primeiro fluxo consome duas linhas. Em seguida, você cria outro gerador usando esse mesmo objeto de arquivo. O que ele poderá processar?
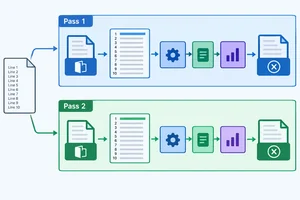
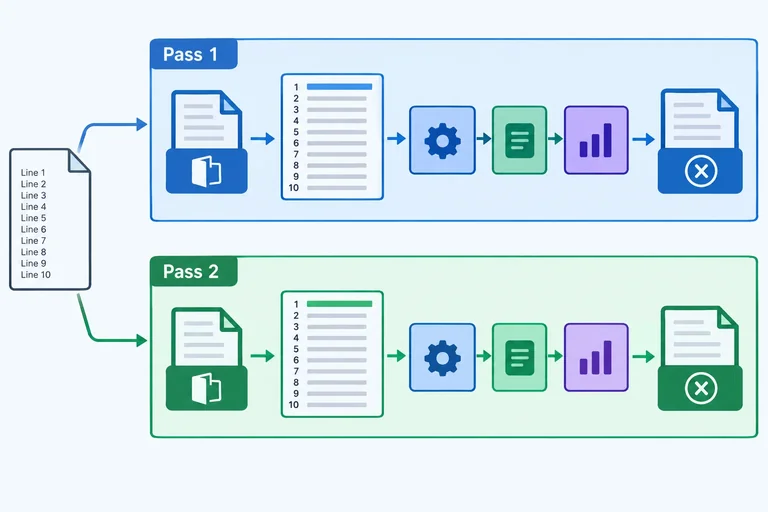
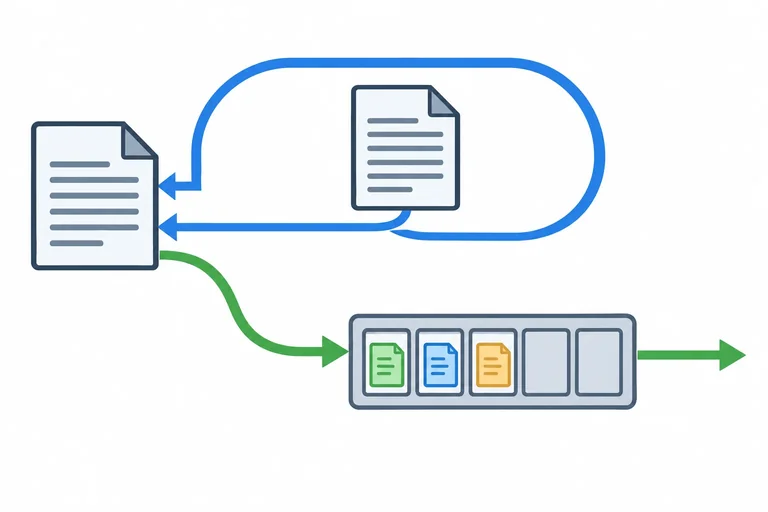
Para percorrer o arquivo completo outra vez, abra o caminho em um novo bloco with. Dentro dele, crie novamente as etapas que recebem o arquivo aberto.
Cada passagem tem seu próprio arquivo e seu próprio fluxo. Assim, a segunda começa na primeira linha e permanece dentro do período em que a nova fonte está aberta.
Cada chamada cria o arquivo e o fluxo adequados àquela passagem.
from pathlib import Path


def leituras_validas(arquivo):
    return (
        int(linha.strip())
        for linha in arquivo
        if linha.strip()
    )


caminho = Path("leituras.txt")

# Primeira passagem completa: calcula o total.
with caminho.open(encoding="utf-8") as arquivo:
    total = sum(leituras_validas(arquivo))

# Segunda passagem completa: conta os mesmos registros válidos.
with caminho.open(encoding="utf-8") as arquivo:
    quantidade = sum(1 for _ in leituras_validas(arquivo))

print(total)
print(quantidade)
Dica
Não guarde leituras_validas(arquivo) para uma passagem futura: esse objeto fica ligado ao arquivo daquela passagem e também pode estar esgotado. Na nova abertura, chame a função novamente com o novo arquivo.
Reabrir garante uma leitura que começa no início do conteúdo disponível naquele momento. Isso não cria uma cópia histórica: se outro processo alterou o arquivo entre as duas aberturas, a segunda passagem pode encontrar dados diferentes.
Para organizar uma nova passagem completa, siga esta sequência:
Ordene as ações para processar novamente o arquivo inteiro.
Passo 6 de 9
Escolha entre reabrir o arquivo para uma passagem completa e guardar uma amostra pequena para reutilização posterior.
Uma lista permite repetir operações, mas list(arquivo) consome todos os registros restantes e guarda todos eles na memória. Use essa materialização apenas quando o resultado tiver um limite conhecido e confortável — tanto na quantidade de registros quanto no tamanho de cada registro.
Se você precisa de um resultado sobre o arquivo completo em uma nova passagem, reabra o arquivo e reconstrua o fluxo. Se precisa reutilizar apenas uma prévia pequena, materialize somente essa amostra.
A amostra limitada pode ser reutilizada; ela não substitui uma leitura completa.
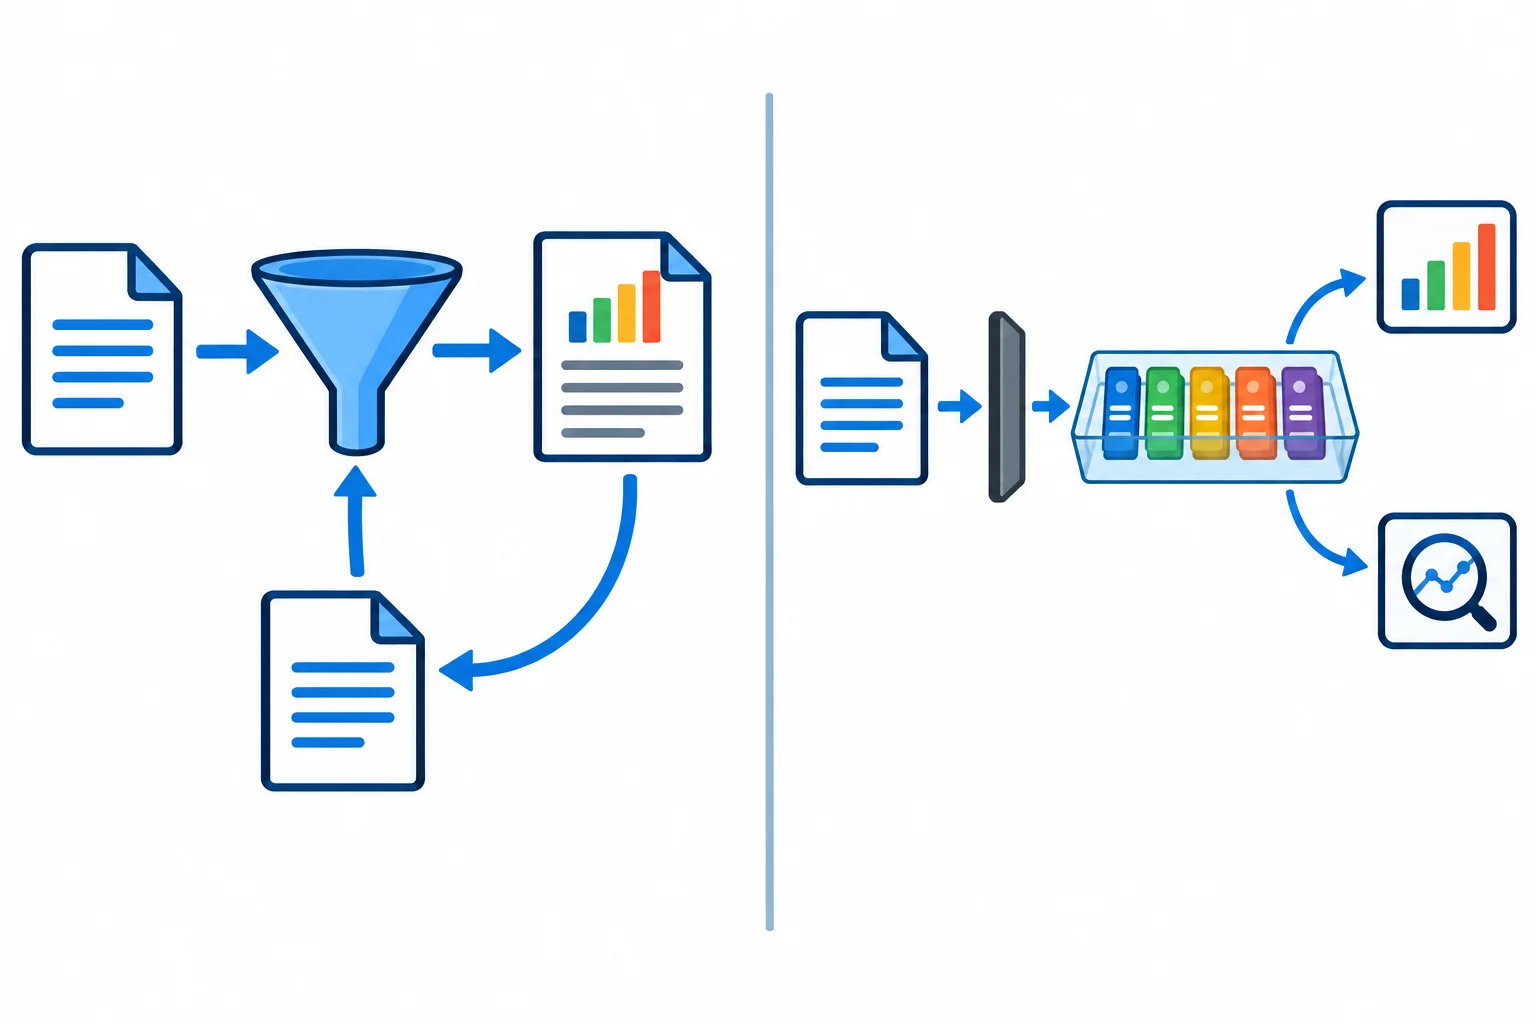
Reabra para percorrer todo o conteúdo novamente; guarde uma lista apenas para um resultado pequeno e delimitado.
islice interrompe a seleção depois da quantidade definida. Ao envolver o resultado com list, você guarda apenas os elementos selecionados. Faça isso dentro do with, enquanto o arquivo está aberto.
O arquivo contém uma leitura inteira por linha; linhas vazias são ignoradas.
from itertools import islice


def leituras_validas(arquivo):
    return (
        int(linha.strip())
        for linha in arquivo
        if linha.strip()
    )


with open("leituras.txt", encoding="utf-8") as arquivo:
    amostra = list(islice(leituras_validas(arquivo), 5))

# O arquivo já foi fechado, mas a lista continua disponível.
print(amostra)
print(sum(amostra))
print(max(amostra))
Dica
Mesmo cinco registros podem ser grandes se cada um contiver muito texto ou dados extensos. Defina um limite adequado ao formato dos registros e ao uso que fará da amostra.
Você precisa calcular o total de todas as leituras de um arquivo e, depois, exibir várias estatísticas sobre uma prévia de no máximo cinco leituras. Qual plano atende às duas necessidades?
Passo 7 de 9
Diferencie objetos que continuam alcançáveis pelo estado suspenso de um gerador do estado aberto ou fechado do arquivo.
Um gerador produz saídas somente quando solicitado, mas conserva o estado necessário para retomar sua execução. Enquanto estiver suspenso, ele pode manter alcançáveis a fonte recebida, coleções usadas no cálculo, o registro corrente e outras variáveis locais.
Isso não quer dizer que toda a saída já esteja guardada: valores futuros continuam sem ser produzidos. Porém, objetos dos quais a próxima retomada depende podem continuar existindo.
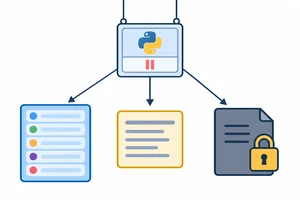
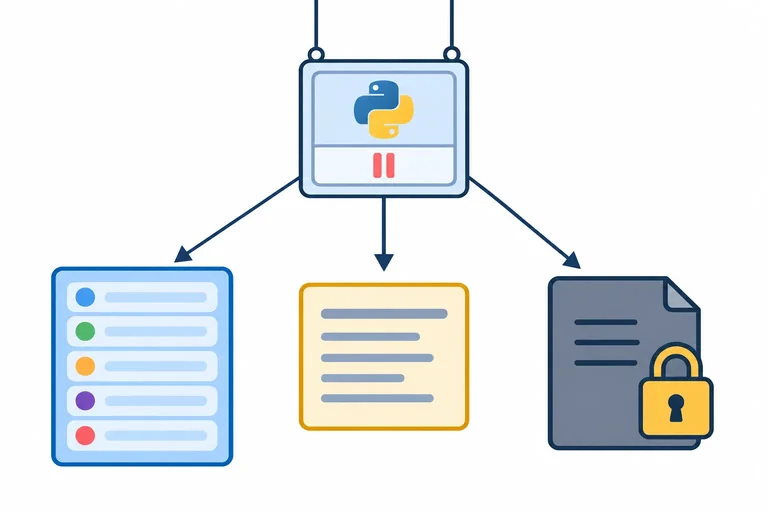
Observe a diferença entre referência conservada, recurso aberto e resultado já materializado.
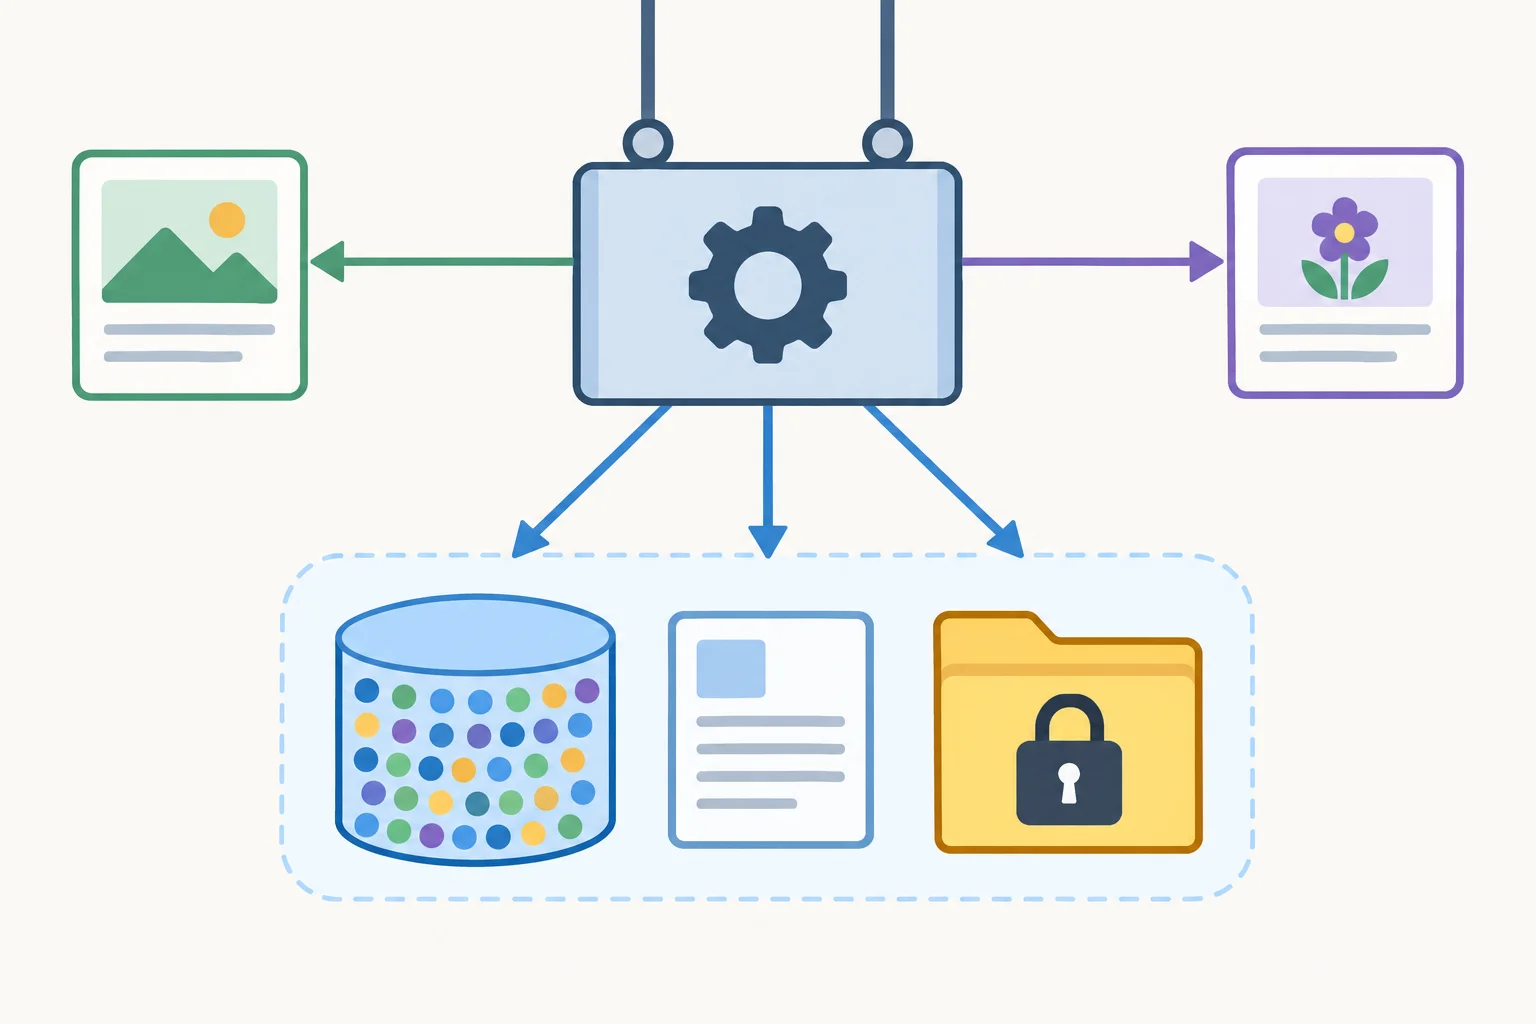
O gerador pode alcançar objetos necessários ao seu estado. O cadeado fechado indica que o arquivo está fechado, embora o objeto arquivo ainda seja referenciado.
Exemplo
def pares_formatados(numeros):
    for numero in numeros:
        if numero % 2 == 0:
            yield f"par={numero}"

numeros = list(range(1_000_000))
fluxo = pares_formatados(numeros)

print(next(fluxo))  # par=0
Após entregar apenas "par=0", os demais resultados ainda não foram materializados. Mas fluxo precisa continuar percorrendo numeros nas próximas retomadas; por isso, a lista recebida continua alcançável pelo gerador enquanto ele puder usá-la.
Produzir sob demanda evita criar automaticamente uma lista com todos os textos formatados. Não elimina, por si só, a referência à lista de entrada.
Dica
Ao manter um gerador para usar depois, pergunte: quais objetos ele ainda precisará consultar para produzir o próximo valor? Esses objetos podem permanecer alcançáveis, mesmo se poucos resultados já tiverem sido solicitados.
Exemplo
def linhas_nao_vazias(arquivo):
    for linha in arquivo:
        texto = linha.strip()
        if texto:
            yield texto

with open("leituras.txt", encoding="utf-8") as arquivo:
    fluxo = linhas_nao_vazias(arquivo)
    primeiro = next(fluxo)
    print(primeiro)

print(arquivo.closed)  # True
Depois do with, fluxo ainda pode manter uma referência ao objeto arquivo. Mesmo assim, o contexto já fechou o recurso: arquivo.closed é True. Tentar avançar esse fluxo depois disso falha, pois a próxima produção precisaria ler uma fonte fechada.
Uma referência permite alcançar um objeto; ela não substitui a responsabilidade do with de encerrar o arquivo.
Associe cada elemento à descrição correta depois que o with terminou, mas uma variável ainda aponta para o gerador fluxo.
Toque em um item e depois no par correspondente.
Passo 8 de 9
Teste o resultado do fluxo e o fechamento do arquivo nos caminhos de consumo completo, interrupção antecipada e falha de conversão.
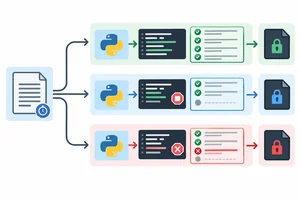
Um fluxo correto precisa produzir os valores esperados e liberar o arquivo no momento certo. Teste essas duas evidências separadamente: compare os registros produzidos e consulte fonte.closed depois de sair do with.
Nos três caminhos abaixo, a fonte deve terminar fechada: consumo completo, saída antecipada e falha durante o avanço do gerador.
O with é o ponto que determina o fechamento; esgotar ou manter uma referência ao gerador não substitui essa responsabilidade.
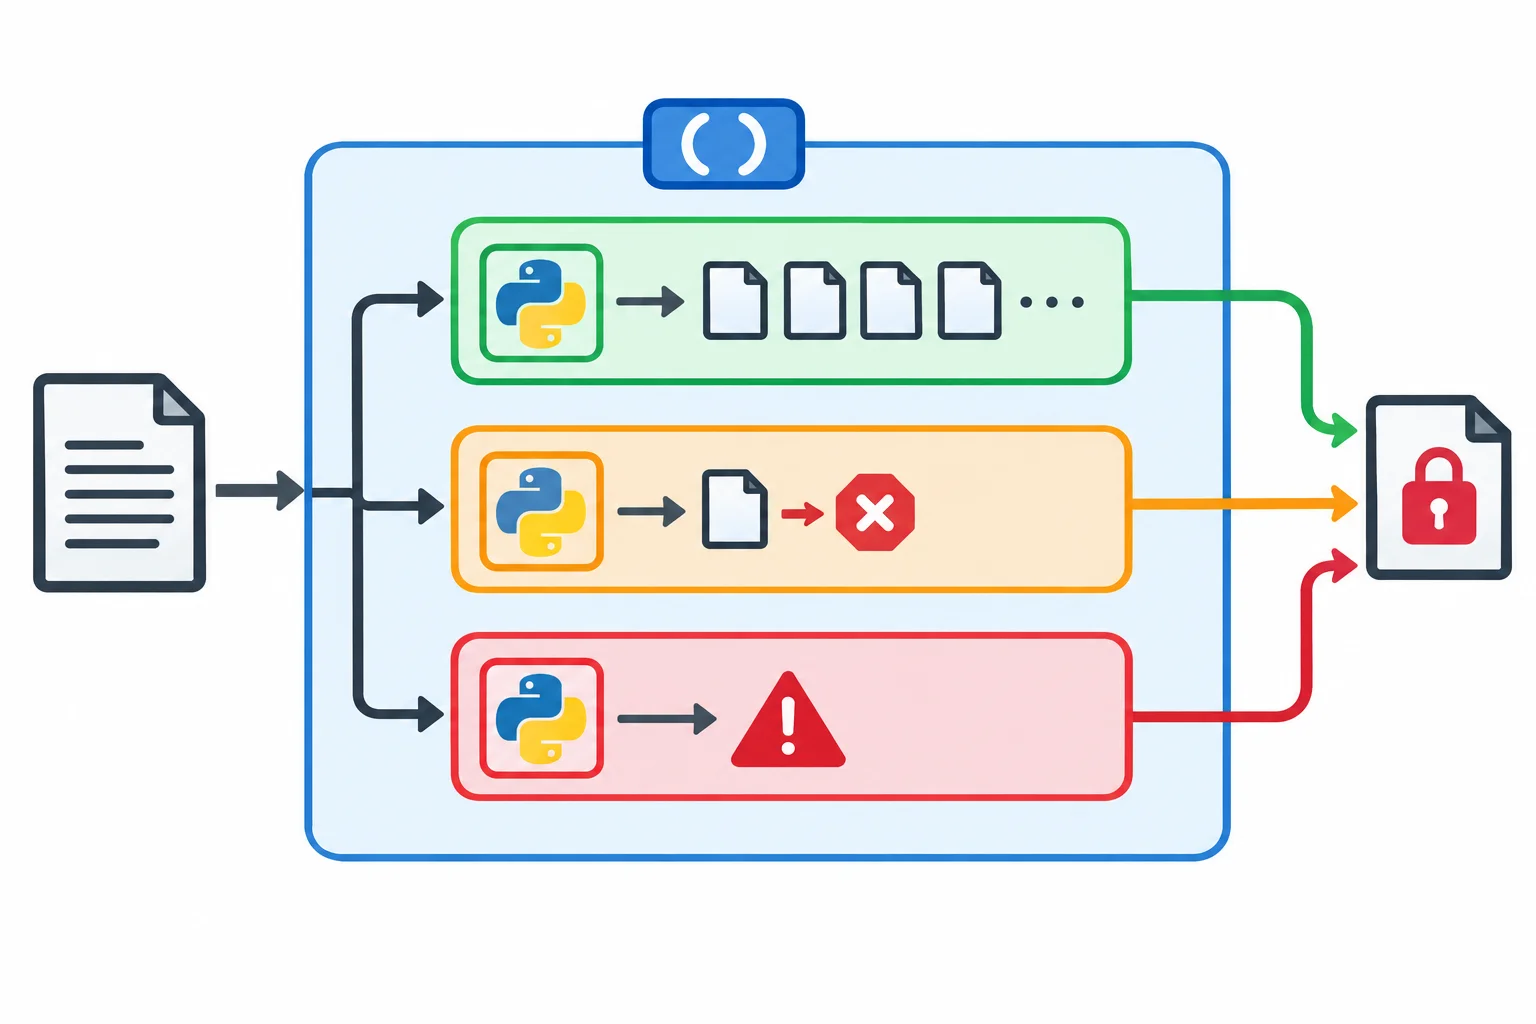
Em todos os caminhos, confirme o resultado apropriado e confirme closed após a saída do contexto.
Dica
Não use list(fluxo) apenas para “dar uma olhada” em um fluxo que outro consumidor ainda precisa usar. Neste módulo, cada teste cria sua própria fonte com tmp_path, então cada consumo acontece sobre um arquivo novo e isolado.
Crie um arquivo chamado test_fluxo_arquivo.py, copie todo o código abaixo e execute, no terminal da pasta do arquivo:
pytest -q
A função recebe o arquivo já aberto. Assim, os testes deixam explícito que abertura, consumo e fechamento pertencem ao mesmo escopo de uso.
import pytest


def leituras_validas(arquivo):
    for linha in arquivo:
        texto = linha.strip()
        if texto:
            yield int(texto)


def test_consumo_completo_preserva_primeiro_registro(tmp_path):
    caminho = tmp_path / "leituras.txt"
    caminho.write_text("12\n\n7\n4\n", encoding="utf-8")

    with caminho.open(encoding="utf-8") as fonte:
        fluxo = leituras_validas(fonte)
        resultado = list(fluxo)
        assert fonte.closed is False

    assert resultado == [12, 7, 4]
    assert fonte.closed is True


def test_interrupcao_antecipada_fecha_ao_sair_do_with(tmp_path):
    caminho = tmp_path / "leituras.txt"
    caminho.write_text("12\n7\n4\n", encoding="utf-8")

    with caminho.open(encoding="utf-8") as fonte:
        fluxo = leituras_validas(fonte)
        for primeiro in fluxo:
            break
        assert primeiro == 12
        assert fonte.closed is False

    # A referência ao gerador continua existindo, mas o arquivo foi fechado.
    assert fluxo is not None
    assert fonte.closed is True


def test_falha_de_conversao_ainda_fecha_a_fonte(tmp_path):
    caminho = tmp_path / "leituras.txt"
    caminho.write_text("12\ninvalido\n4\n", encoding="utf-8")

    with pytest.raises(ValueError):
        with caminho.open(encoding="utf-8") as fonte:
            fluxo = leituras_validas(fonte)
            list(fluxo)

    assert fonte.closed is True
Dica
O primeiro teste detecta inclusive a perda indevida de 12, que ocorreria se alguém chamasse next(fluxo) para uma prévia antes de montar resultado. O segundo prova que break não fecha o arquivo sozinho: ele ainda está aberto dentro do bloco. O terceiro prova que a exceção não impede o fechamento na saída do with.
Após executar o módulo, explique quais evidências mostram: (1) que o primeiro registro não foi perdido, (2) que a interrupção antecipada não deixa o arquivo aberto após o with e (3) que uma falha de conversão também fecha a fonte.
Escreva pelo menos 120 caracteres (0/120).
Passo 9 de 9
Integre o cálculo completo, uma amostra limitada reutilizável e testes do ciclo de vida do arquivo.
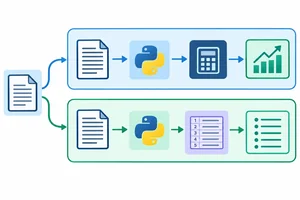
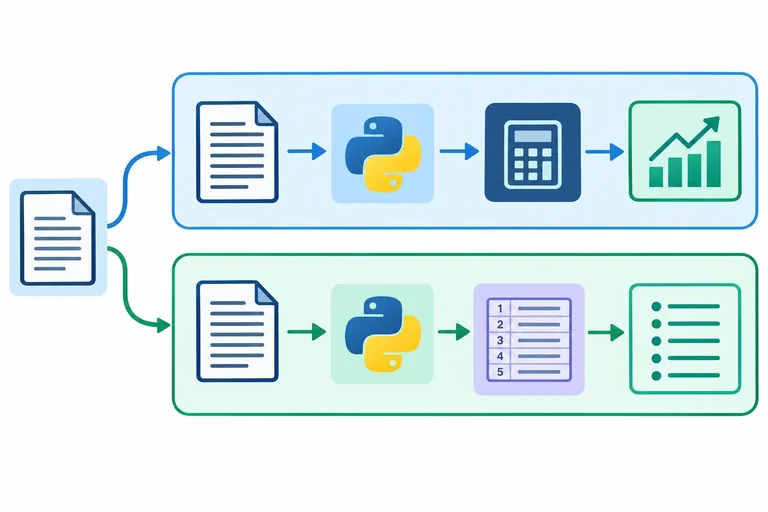
Você precisa de dois resultados: o total de leituras válidas do arquivo inteiro e uma amostra de até cinco leituras que poderá ser usada depois.
Não retire a amostra do mesmo fluxo que calcula o total: isso avançaria a fonte e poderia excluir registros do cálculo. Faça duas passagens independentes:
Em ambas, o with pertence ao código que consome o fluxo. Assim, a fonte permanece aberta durante a iteração e fecha ao sair do bloco.
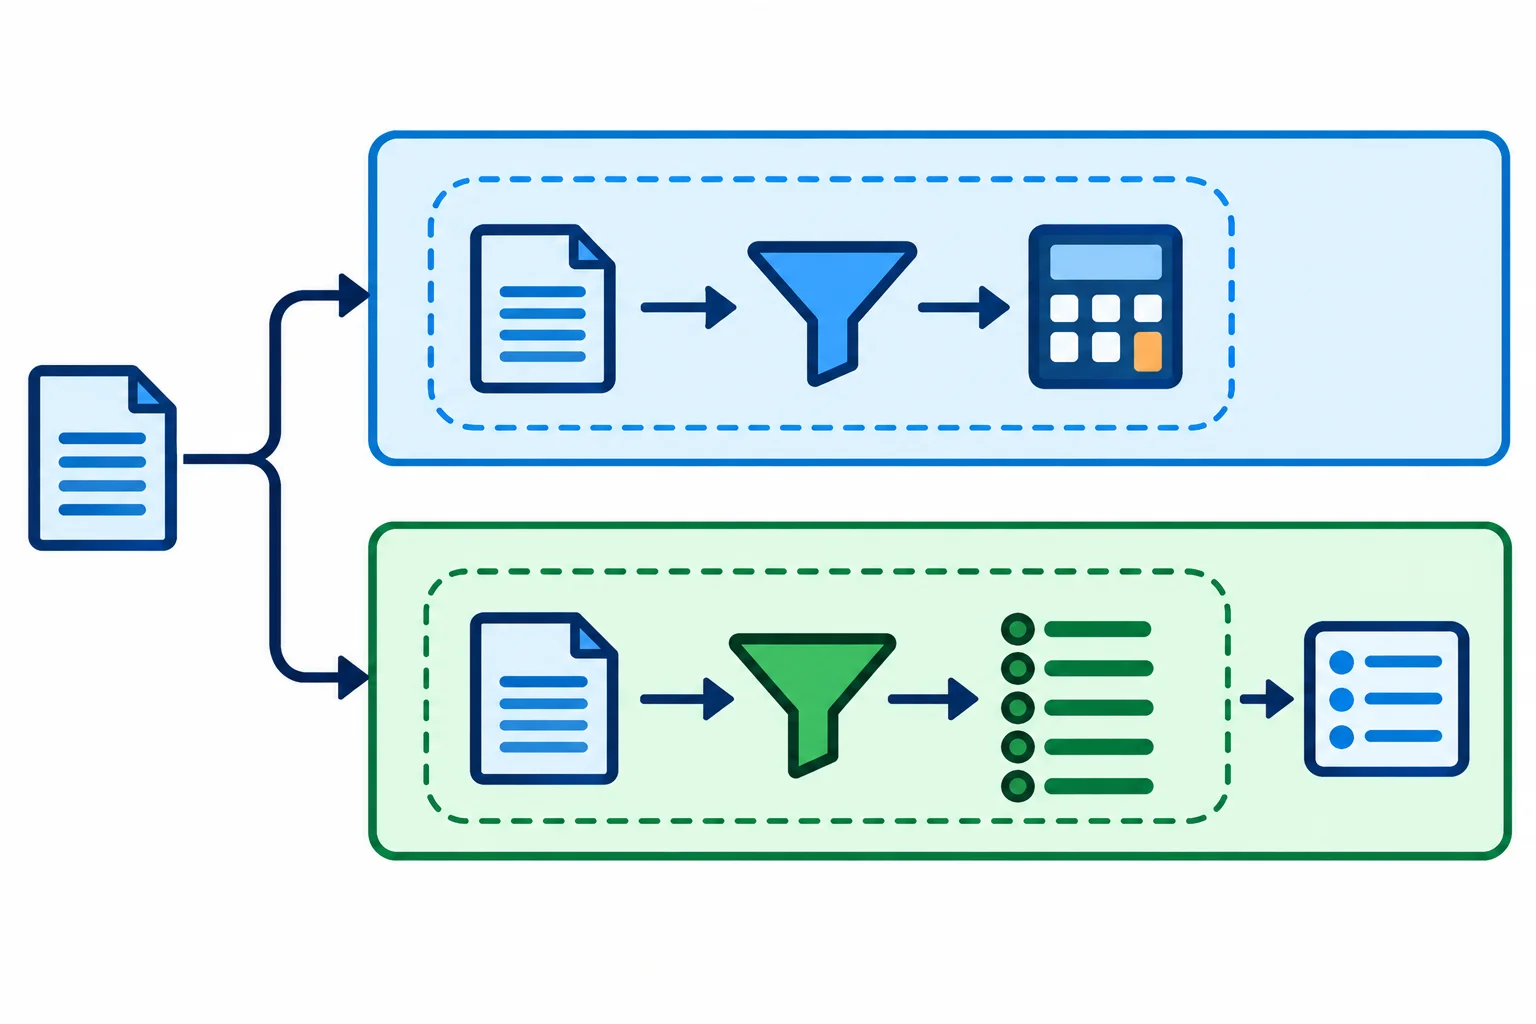
Reabrir cria uma nova leitura completa; limitar antes de list mantém a materialização restrita à amostra.
No seu computador, crie um arquivo UTF-8 chamado leituras.txt com este conteúdo completo:
10

20
invalida
30
40
50
60
Crie processamento.py com o código abaixo. O total considera apenas linhas numéricas; a amostra guarda no máximo cinco valores válidos. Repare que não há next, any nem list sobre o fluxo do total.
from itertools import islice
from pathlib import Path


def leituras_validas(arquivo):
    for linha in arquivo:
        texto = linha.strip()
        if texto.isdigit():
            yield int(texto)


def total_de_leituras(caminho):
    with caminho.open(encoding="utf-8") as arquivo:
        return sum(leituras_validas(arquivo))


def amostra_de_leituras(caminho, limite=5):
    with caminho.open(encoding="utf-8") as arquivo:
        return list(islice(leituras_validas(arquivo), limite))


caminho = Path("leituras.txt")
total = total_de_leituras(caminho)
amostra = amostra_de_leituras(caminho)

print(total)    # 210
print(amostra)  # [10, 20, 30, 40, 50]
print(sum(amostra))  # 150: a lista pode ser reutilizada
Crie test_processamento.py na mesma pasta. Estes testes verificam tanto os resultados quanto o fechamento do arquivo nos caminhos de consumo completo, interrupção antecipada e falha durante a transformação.
import pytest

from processamento import amostra_de_leituras, leituras_validas, total_de_leituras


def test_consumo_completo_nao_perde_o_primeiro_registro(tmp_path):
    caminho = tmp_path / "leituras.txt"
    caminho.write_text("10\n\n20\ninvalida\n30\n40\n50\n60\n", encoding="utf-8")

    assert total_de_leituras(caminho) == 210
    assert amostra_de_leituras(caminho) == [10, 20, 30, 40, 50]


def test_interrupcao_fecha_arquivo_ao_sair_do_with(tmp_path):
    caminho = tmp_path / "leituras.txt"
    caminho.write_text("10\n20\n30\n", encoding="utf-8")

    with caminho.open(encoding="utf-8") as arquivo:
        fluxo = leituras_validas(arquivo)
        assert next(fluxo) == 10
        assert not arquivo.closed

    assert arquivo.closed
    assert fluxo is not None


def test_falha_durante_consumo_tambem_fecha_arquivo(tmp_path):
    caminho = tmp_path / "leituras.txt"
    caminho.write_text("10\nERRO\n", encoding="utf-8")

    def converter_todas_as_linhas(arquivo):
        for linha in arquivo:
            yield int(linha.strip())

    with pytest.raises(ValueError):
        with caminho.open(encoding="utf-8") as arquivo:
            list(converter_todas_as_linhas(arquivo))

    assert arquivo.closed
Dica
No terminal, na pasta dos arquivos, execute pytest -q. O gerador mantido na variável fluxo não impede o fechamento: quem controla o recurso é a saída do with.
Depois de executar os testes, explique por que esta solução não perde registros no total, por que a amostra pode ser reutilizada e por que o arquivo fecha nos três caminhos testados.
Escreva pelo menos 120 caracteres (0/120).
Resumo
Use este checklist ao processar um arquivo incrementalmente.
with que o abriu ainda está ativo.next, any e list como consumidores: eles avançam ou esgotam a fonte.Parabéns! Você concluiu: Processar arquivos em fluxos de consumo único
Você concluiu este nível!
Agora você vai iniciar: Modelo de dados e gerenciamento de recursos
 Definir representações com __repr__ e __str__Ao concluir, você poderá definir representações úteis de objetos para diagnóstico e apresentação, integrando suas classes a repr, str, print e f-strings.
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks