Passo 1 de 6
Diferenciar texto de bytes
Reconheça quando um valor representa texto e quando representa bytes que devem ser preservados sem interpretação automática.
Trilha de aprendizado · Nível 6 · Tutorial 5
Preservar o conteúdo de arquivos binários e realizar conversões explícitas entre texto e bytes somente quando houver uma codificação conhecida.
 Diferenciar texto de bytes
Reconheça quando um valor representa texto e quando representa bytes que devem ser preservados sem interpretação automática. 2 min
 Criar e acessar sequências de bytes
Interprete literais bytes e descubra como índices, fatias e tentativas de alteração se comportam. 2 min
 Gravar bytes em um arquivo
Use o modo wb para gravar uma sequência de bytes exatamente como ela está na memória, sem codificação textual. 3 min
 Ler e conferir o conteúdo binário
Leia uma pequena amostra com rb, inspecione os bytes retornados e confirme o conteúdo por igualdade integral. 3 min
 Converter entre texto e bytes
Faça conversões explícitas com UTF-8, compare caracteres e bytes e reconheça quando dados binários não devem ser decodificados. 3 min
 Aplicação final: copiar sem alterar os bytes
Integre leitura, gravação e verificação para criar uma cópia binária idêntica e decidir quando conversões de texto são apropriadas. 3 min
Passo 1 de 6
Reconheça quando um valor representa texto e quando representa bytes que devem ser preservados sem interpretação automática.
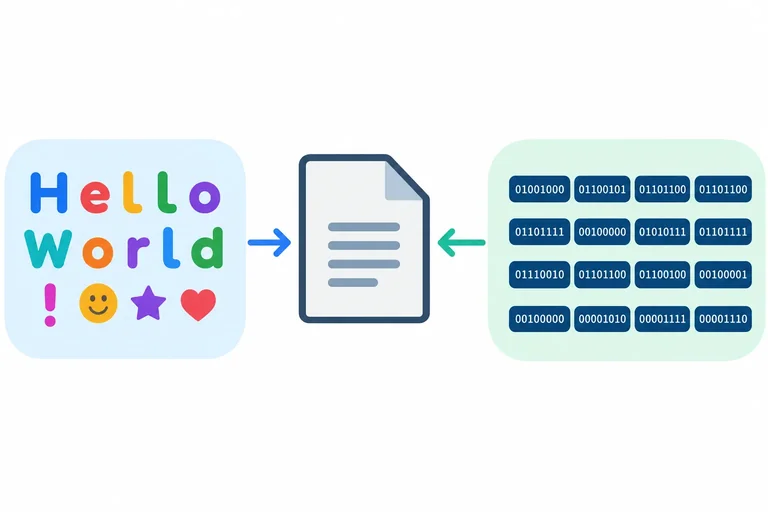
Em Python, str representa texto Unicode: uma sequência de caracteres destinada à interpretação como texto. Já bytes representa uma sequência imutável de valores inteiros entre 0 e 255.
Embora ambos possam aparecer como sequências, eles têm significados diferentes. Um valor bytes não deve ser tratado automaticamente como texto.
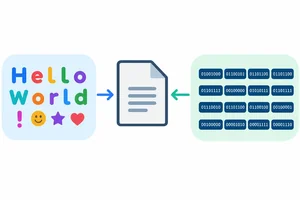
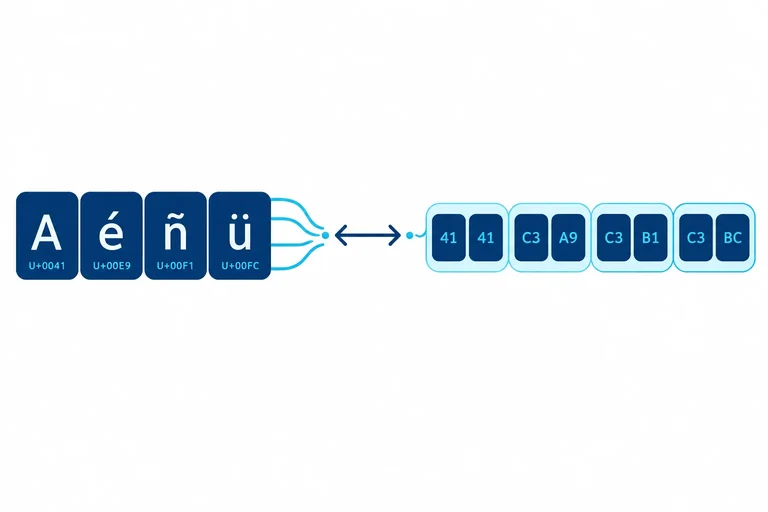
Compare as duas estruturas: à esquerda, cada posição contém um caractere; à direita, cada posição contém um valor de byte.
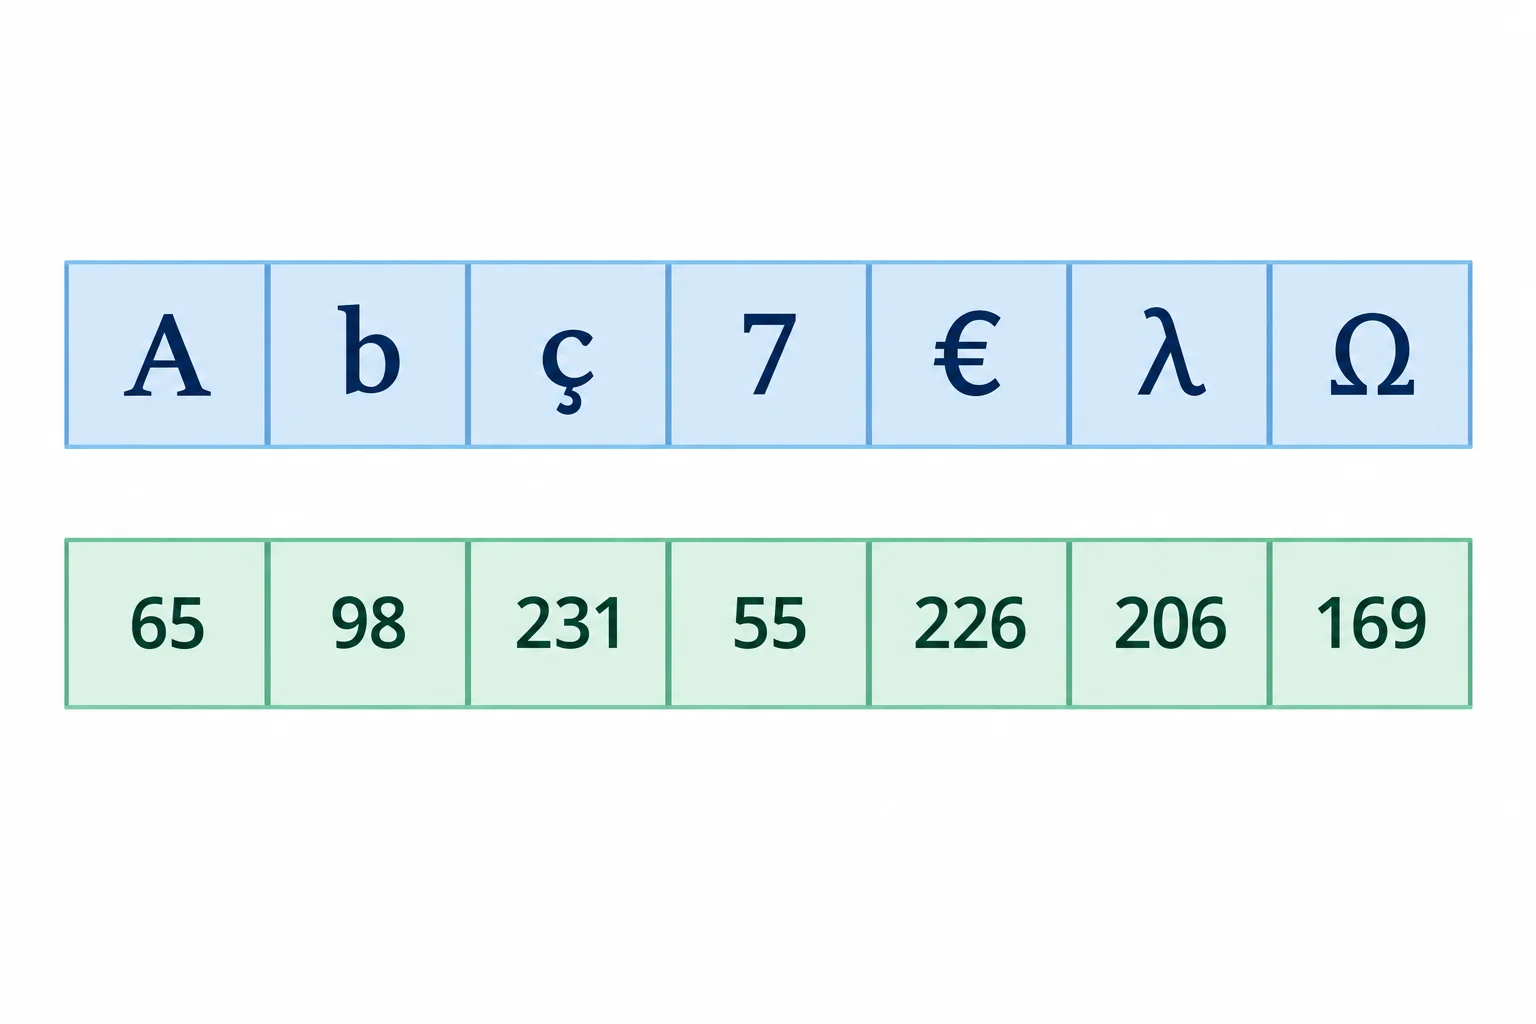
Uma sequência de caracteres representa texto; uma sequência de bytes preserva valores entre 0 e 255.
No armazenamento, arquivos contêm bytes. Considerar esses bytes como texto exige uma interpretação adicional; isso não é uma propriedade automática do conteúdo.
Quando você sabe que um arquivo contém texto, pode tratá-lo como texto. Quando a tarefa é preservar o conteúdo original — como ao copiar uma imagem — o modo binário evita interpretar os dados como caracteres.
Exemplo
str).bytes.Dica
Antes de abrir um arquivo, pergunte: “Preciso interpretar este conteúdo como texto ou apenas preservar seus bytes?” A resposta orienta a escolha entre tratamento textual e binário.
Associe cada situação à decisão mais adequada.
Toque em um item e depois no par correspondente.
Passo 2 de 6
Interprete literais bytes e descubra como índices, fatias e tentativas de alteração se comportam.
O prefixo b cria um literal do tipo bytes. Caracteres ASCII podem aparecer diretamente, enquanto valores não imprimíveis ou fora do ASCII podem ser representados por escapes hexadecimais \xNN.
Em b"ABC\x00\xff", cada parte representa um byte. Os escapes \x00 e \xff representam, respectivamente, os valores 0 e 255. Cada escape hexadecimal desse formato possui dois dígitos.
Execute no interpretador ou em um script local:
dados = b"ABC\x00\xff"

print(dados)
print(type(dados))
print(len(dados))

# Saída:
# b'ABC\x00\xff'
# <class 'bytes'>
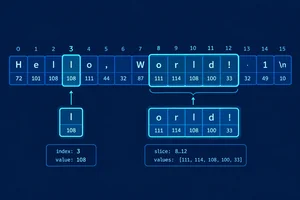
# 5A indexação de bytes produz um int entre 0 e 255. Já o fatiamento produz outro valor bytes, mesmo quando a fatia contém apenas um elemento.
A forma impressa pode mostrar alguns bytes como caracteres e outros como escapes. Isso é apenas uma representação conveniente da sequência — não é uma decodificação textual.
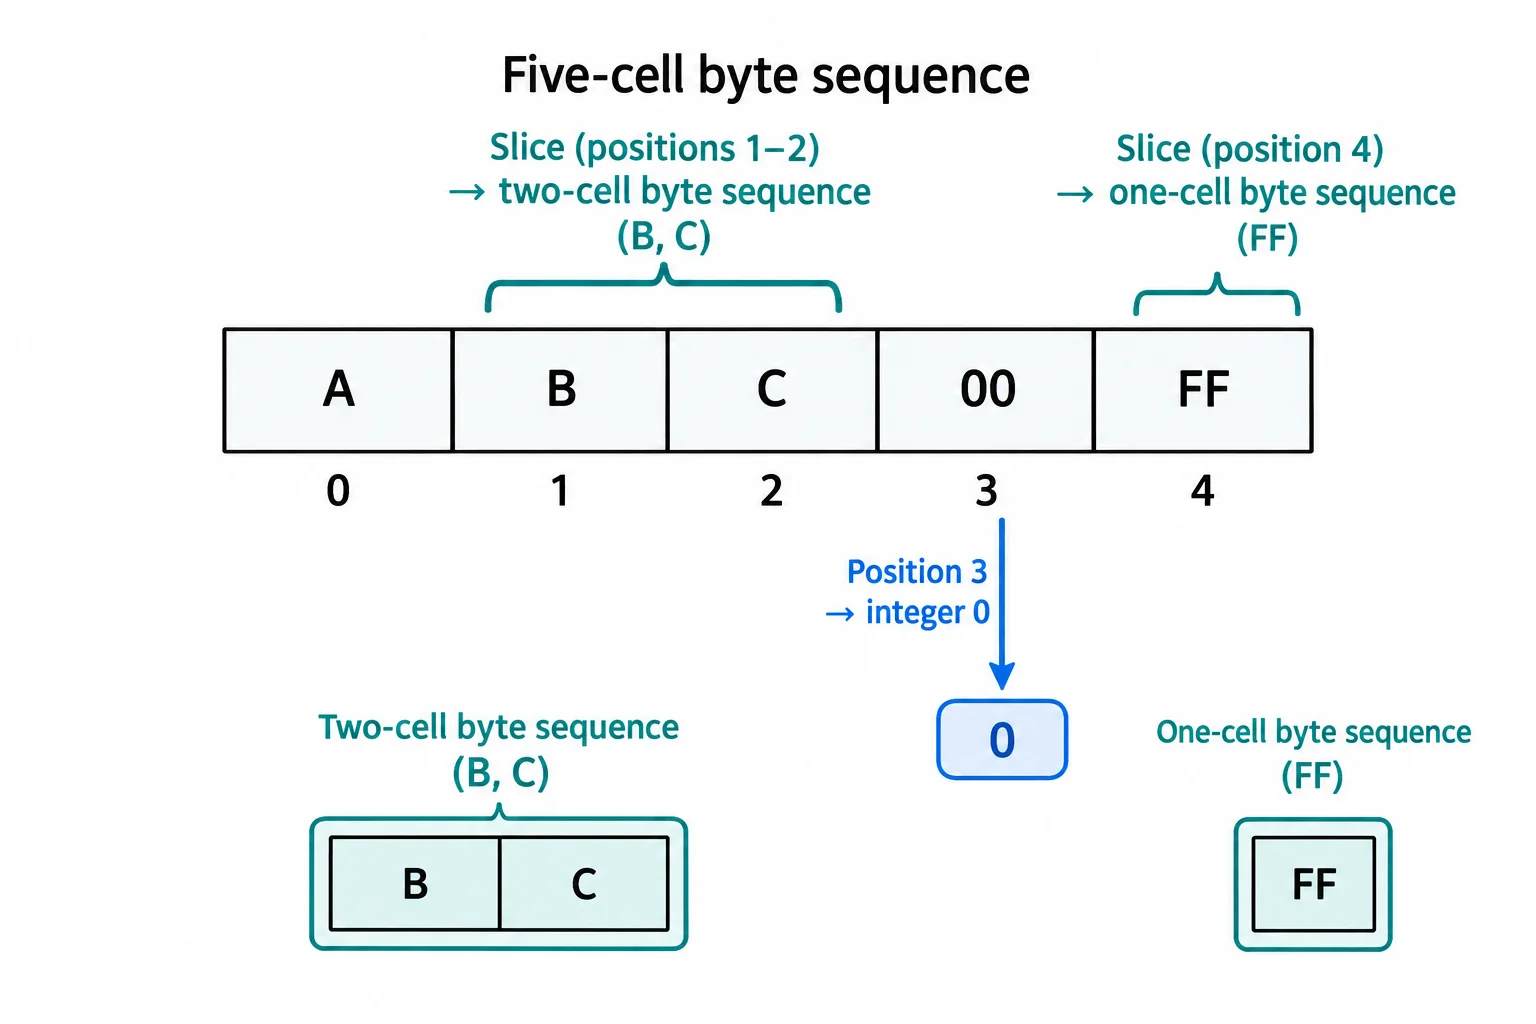
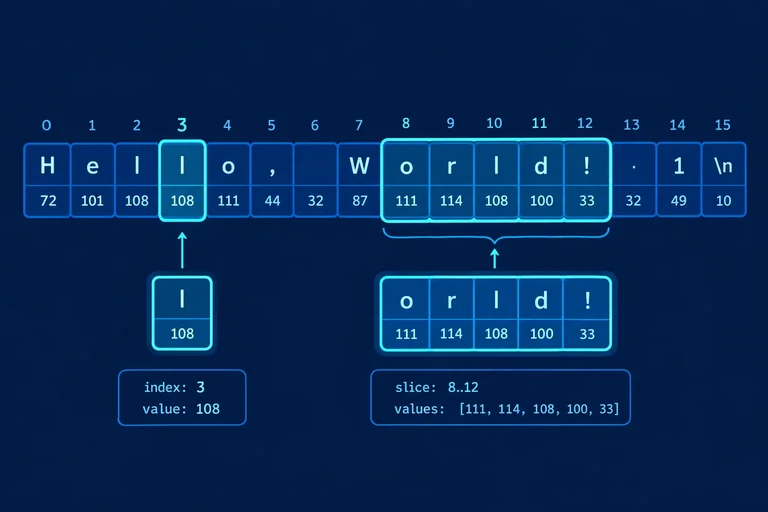
Selecionar uma posição produz um inteiro; selecionar um intervalo produz bytes.
Observe também que a sequência é imutável: a última linha provoca TypeError.
dados = b"ABC\x00\xff"

print(dados[0])      # 65, do tipo int
print(dados[3])      # 0, do tipo int
print(dados[-1])     # 255, do tipo int
print(dados[1:3])    # b'BC', do tipo bytes
print(dados[0:1])    # b'A', do tipo bytes

# Inválido: objetos bytes não aceitam substituição por posição
dados[0] = 90 # TypeErrorConsidere dados = b"ABC\x00\xff". Qual é o resultado de dados[3]?
Qual é o nome do tipo produzido por dados[4:5]?
Para dados = b"ABC", a instrução dados[0] = 90 altera o primeiro byte para o valor 90.
Passo 3 de 6
Use o modo wb para gravar uma sequência de bytes exatamente como ela está na memória, sem codificação textual.
O modo wb abre um arquivo para gravação binária. Nesse modo, write exige um valor bytes: fornecer uma str provoca TypeError.
Os bytes são gravados sem codificação textual e sem tradução de quebras de linha. Por isso, não use o parâmetro encoding: ele é incompatível com o modo binário.
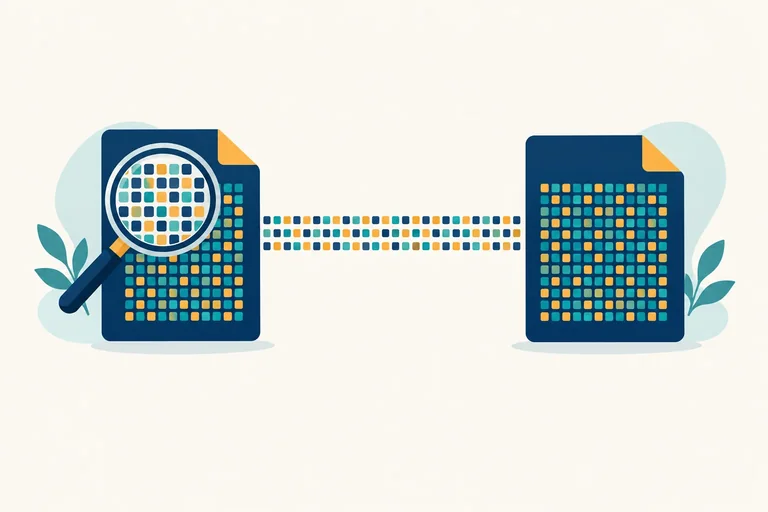
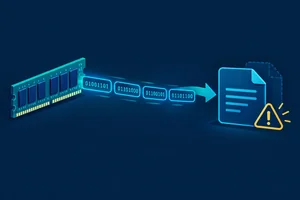
O mesmo conjunto de valores segue da sequência em memória para o arquivo, sem uma etapa de interpretação textual.
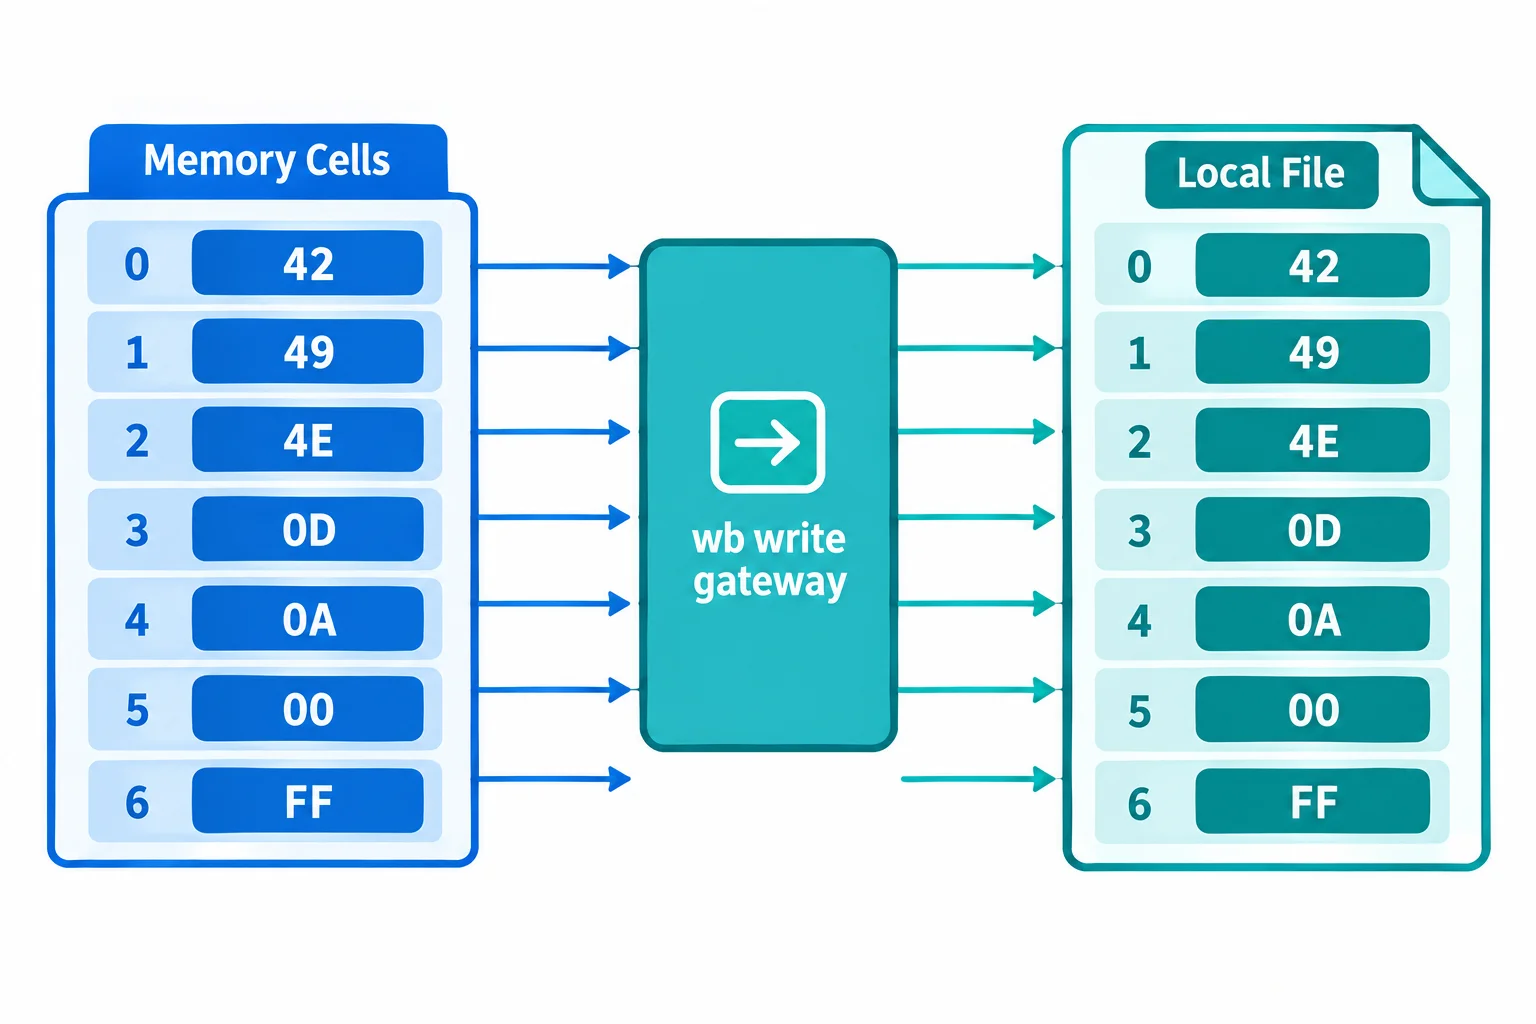
Em wb, write recebe bytes e os envia ao arquivo sem codificação ou tradução de quebras de linha.
Atenção
Se o destino não existir, wb o cria. Se já existir, o arquivo é truncado assim que a abertura é concluída com sucesso, antes mesmo da chamada a write. Pratique somente com um caminho descartável e confira o destino antes de executar o código.
Crie um script no seu editor e execute o código abaixo. Ele cria a pasta pratica_binaria na pasta de trabalho e grava uma amostra de 7 bytes em amostra.bin. O resultado esperado no terminal é uma mensagem informando que 7 bytes foram gravados.
A amostra contém letras ASCII, dois valores de quebra de linha e bytes que não precisam representar texto. A leitura e a conferência do arquivo serão feitas no próximo step.
Execute este script em uma pasta onde seja seguro criar arquivos de prática.
from pathlib import Path

pasta = Path("pratica_binaria")
pasta.mkdir(exist_ok=True)

destino = pasta / "amostra.bin"
amostra = b"BIN\r\n\x00\xff"

with open(destino, "wb") as arquivo:
    quantidade = arquivo.write(amostra)

print(f"{quantidade} bytes gravados em {destino}")
Dica
A abertura usa somente o caminho e "wb". Acrescentar encoding="utf-8", por exemplo, causa ValueError, pois uma codificação textual não se aplica a um arquivo aberto em modo binário.
Complete a abertura para gravar dados binários, sem informar encoding:
with open(destino, "____") as arquivo:
Considerando amostra = b"BIN\r\n\x00\xff", complete a chamada:
arquivo.write(____)
Você percebeu que destino aponta para um arquivo importante que já existe. O que deve fazer antes de executar o script?
Passo 4 de 6
Leia uma pequena amostra com rb, inspecione os bytes retornados e confirme o conteúdo por igualdade integral.
Ao abrir um arquivo com rb, read() devolve um valor do tipo bytes, não str. Nenhuma interpretação como texto é aplicada.
Neste tutorial, a leitura integral com read() será usada apenas em arquivos pequenos. Depois da leitura, você pode inspecionar o resultado com type, len, índices e fatias.
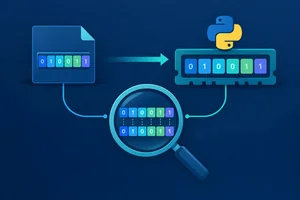
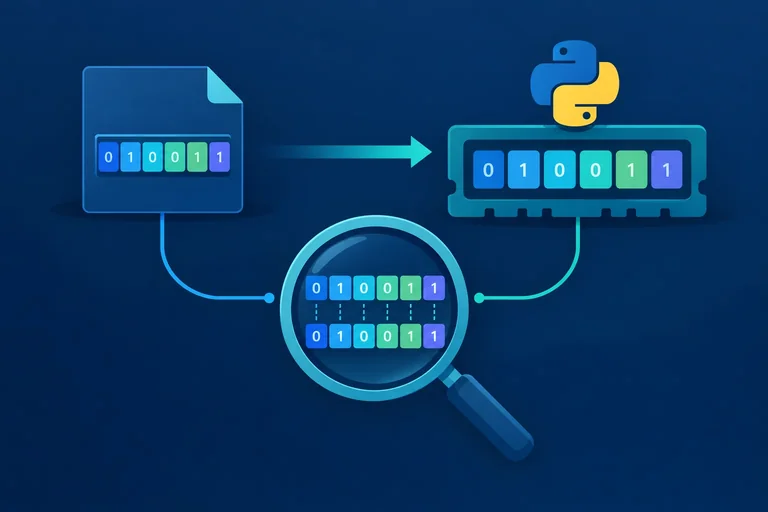
O modo rb transporta para a memória a mesma sequência de valores armazenada no arquivo. Isso inclui bytes como 0, 255 e o valor que poderia representar uma quebra de linha em um texto.
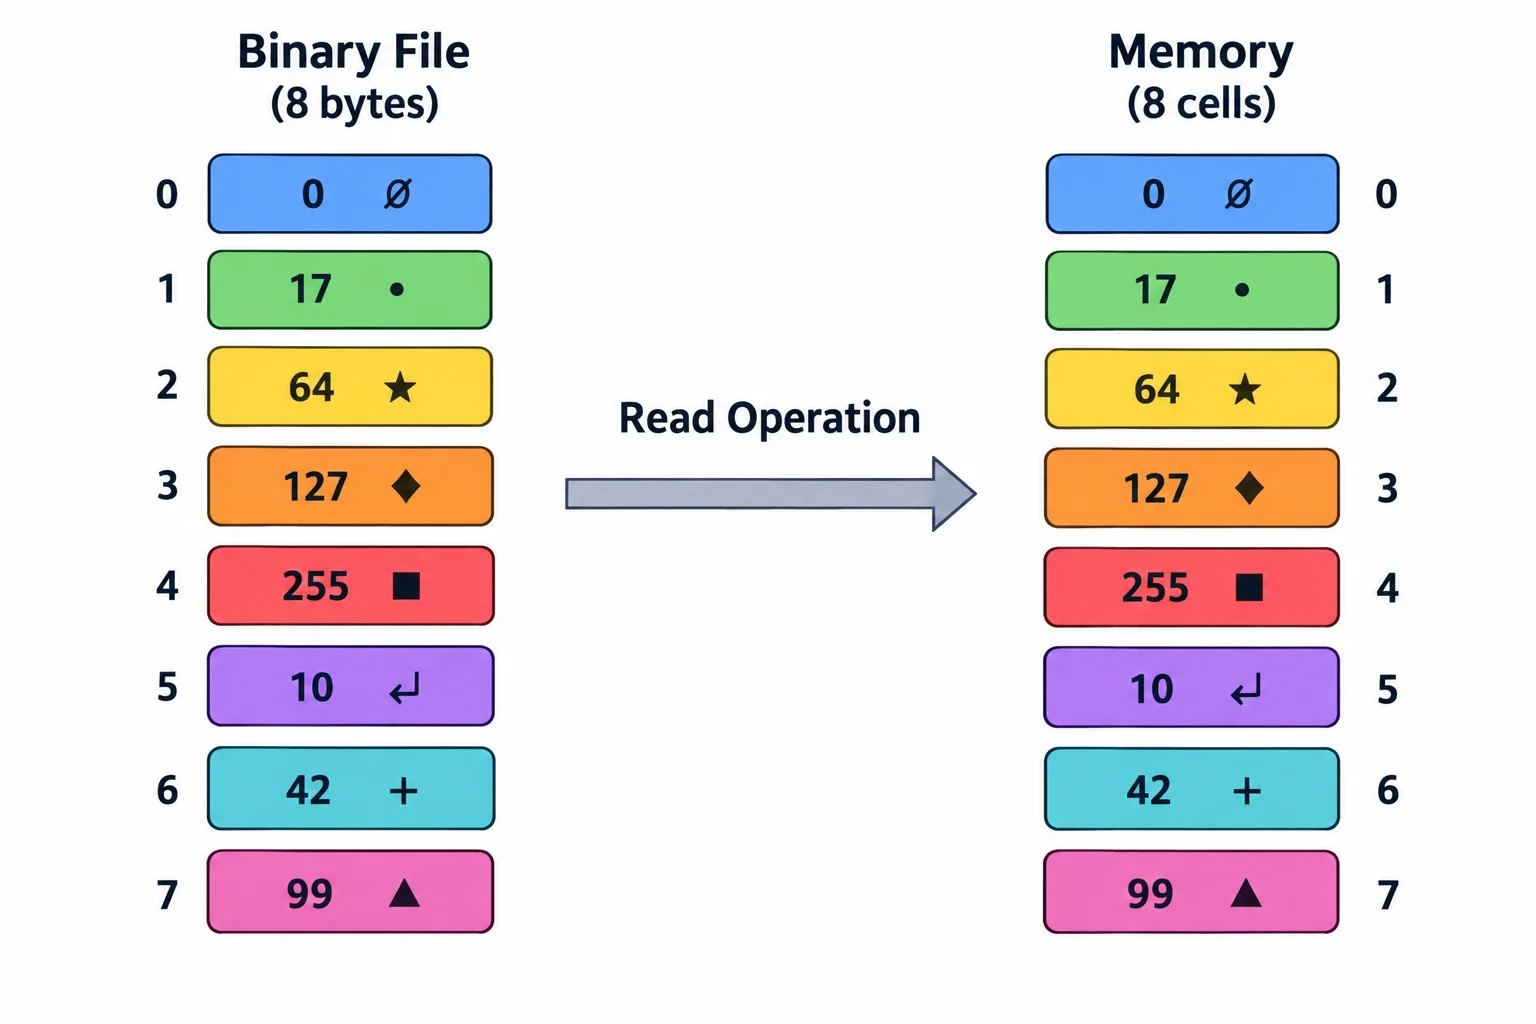
Cada posição lida corresponde ao mesmo byte do arquivo; nenhuma conversão textual acontece.
Execute o código no seu computador. Ele considera a amostra do step anterior no caminho pratica_binaria/amostra.bin, cujo conteúdo de referência é b"BIN\x00\xff\nOK".
Se você usou outro caminho anteriormente, ajuste somente o valor de caminho.
Salve como um script Python ou execute no ambiente local em que criou a amostra.
from pathlib import Path

caminho = Path("pratica_binaria") / "amostra.bin"
esperado = b"BIN\x00\xff\nOK"

with open(caminho, "rb") as arquivo:
    dados = arquivo.read()

print("Valor:", dados)
print("Tipo:", type(dados))
print("Comprimento:", len(dados))
print("Primeiro byte:", dados[0])
print("Fatia:", dados[3:6])
print("Mesmo tamanho:", len(dados) == len(esperado))
print("Mesmo conteúdo:", dados == esperado)
Dica
Para a amostra indicada, você deve obter o tipo bytes, comprimento 8, primeiro byte 66, fatia b'\x00\xff\n' e igualdade de conteúdo igual a True. A fatia continua sendo bytes, mesmo contendo apenas parte da sequência.
Depois de executar o código, qual foi o tipo retornado por read() e qual foi o resultado de dados == esperado? Explique também por que a igualdade dos bytes é uma verificação mais forte do que comparar apenas os comprimentos.
Escreva pelo menos 80 caracteres (0/80).
Passo 5 de 6
Faça conversões explícitas com UTF-8, compare caracteres e bytes e reconheça quando dados binários não devem ser decodificados.
Use encode quando você tem uma str e precisa produzir bytes. Use decode quando você tem bytes que representam texto e precisa obter uma str.
dados = texto.encode("utf-8")
texto = dados.decode("utf-8")
A codificação deve ser conhecida e informada na conversão. Ao trabalhar com um arquivo aberto em rb ou wb, não passe encoding para open: a conversão ocorre separadamente, com encode ou decode.
Em UTF-8, os quatro caracteres de ação são representados por seis bytes. Os bytes de ç e ã formam grupos de dois.
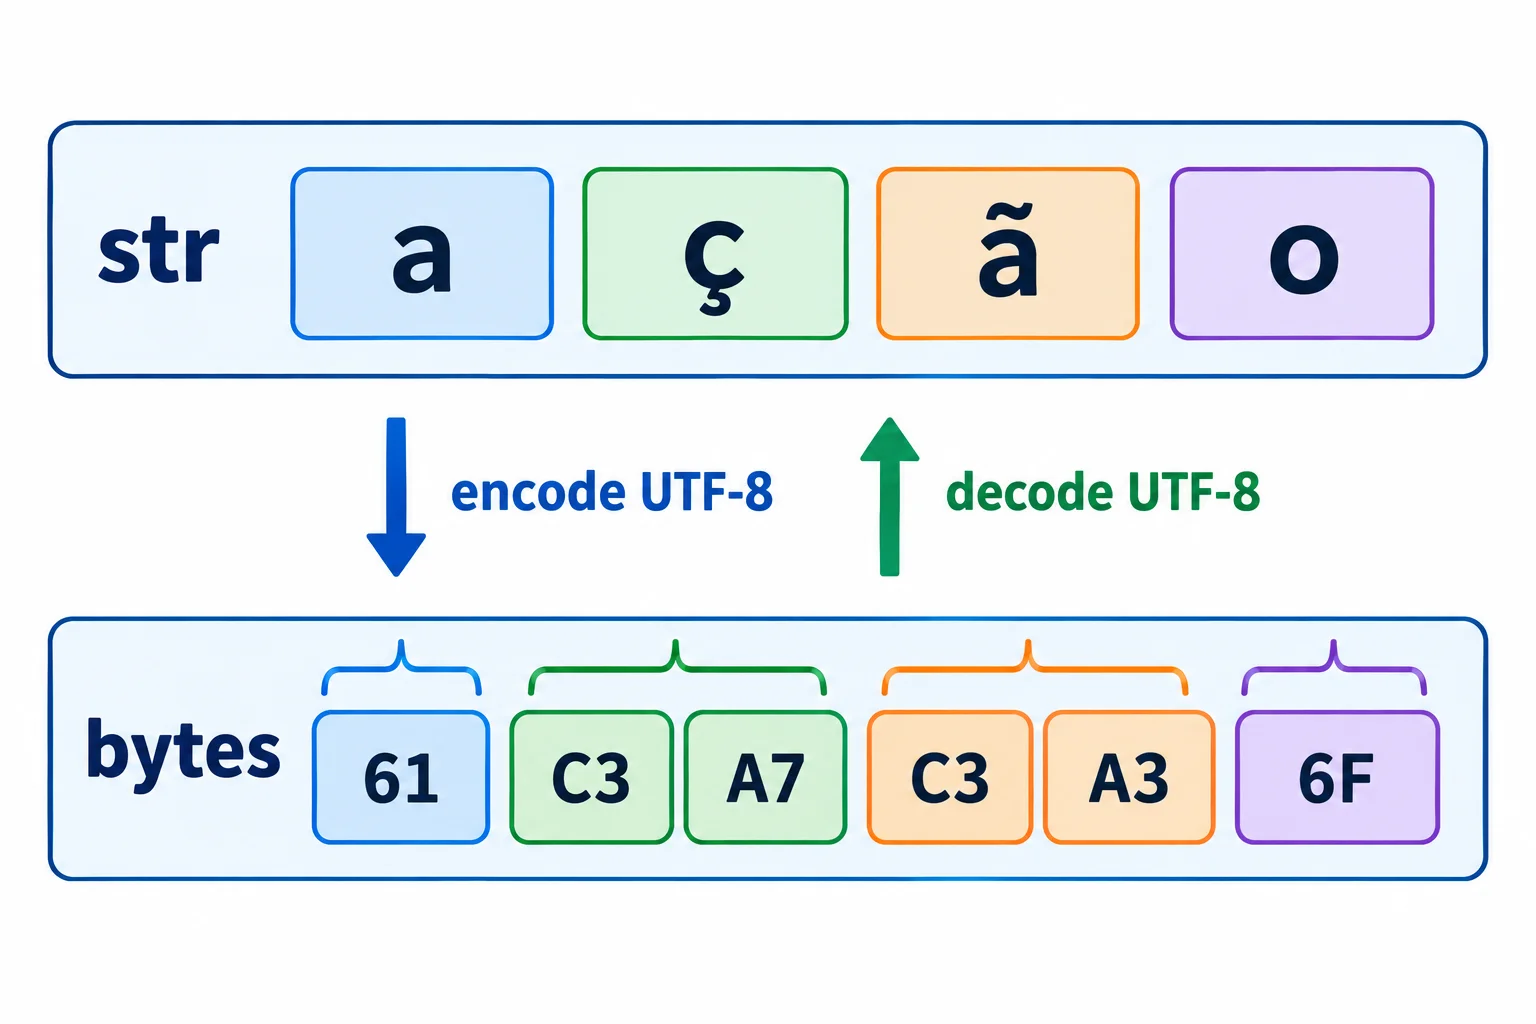
encode("utf-8") segue de str para bytes; decode("utf-8") percorre o caminho inverso.
Execute este código no seu ambiente Python e compare os tipos e comprimentos apresentados.
texto = "ação"
dados = texto.encode("utf-8")
recuperado = dados.decode("utf-8")

print(type(texto), len(texto))
print(type(dados), len(dados), dados)
print(recuperado)
print(recuperado == texto)
Exemplo
<class 'str'> 4
<class 'bytes'> 6 b'a\xc3\xa7\xc3\xa3o'
ação
True
len(texto) conta quatro caracteres. len(dados) conta seis bytes. A igualdade final confirma que a conversão de ida e volta com a mesma codificação recuperou o texto deste exemplo.
Atenção
Só use decode quando os bytes representarem texto e a codificação for conhecida. Uma decodificação terminar sem erro não prova que a codificação escolhida seja a correta. Para preservar dados binários arbitrários, como uma imagem, copie os bytes diretamente: não inclua decode nem encode no caminho.
Associe cada expressão ao seu resultado.
Toque em um item e depois no par correspondente.
Um programa leu uma pequena imagem com rb e recebeu um valor bytes. Qual procedimento preserva corretamente o conteúdo ao criar uma cópia?
Passo 6 de 6
Integre leitura, gravação e verificação para criar uma cópia binária idêntica e decidir quando conversões de texto são apropriadas.
Nesta aplicação, você criará uma origem descartável, lerá seu conteúdo com rb, gravará os mesmos bytes em outro caminho com wb e relerá o destino. A igualdade entre as duas sequências completas confirmará a cópia.
Não há encode nem decode: os dados já são bytes e não precisam ser interpretados como texto.
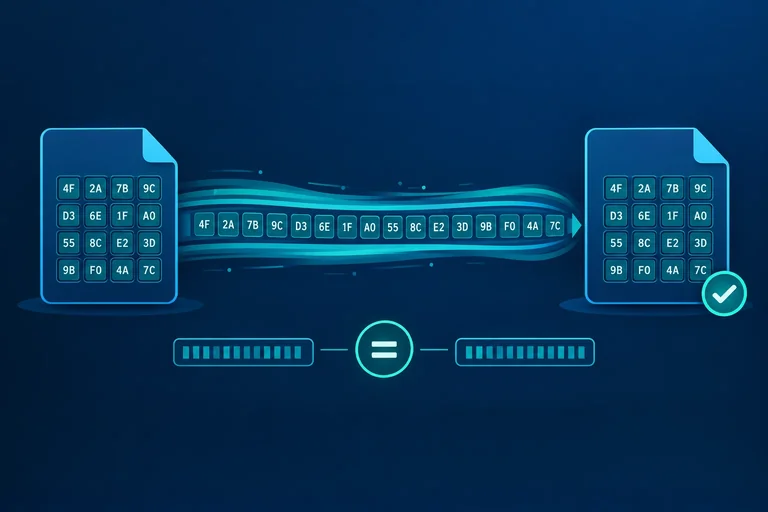
Os bytes saem do arquivo de origem, permanecem como bytes na memória e chegam ao destino na mesma ordem.
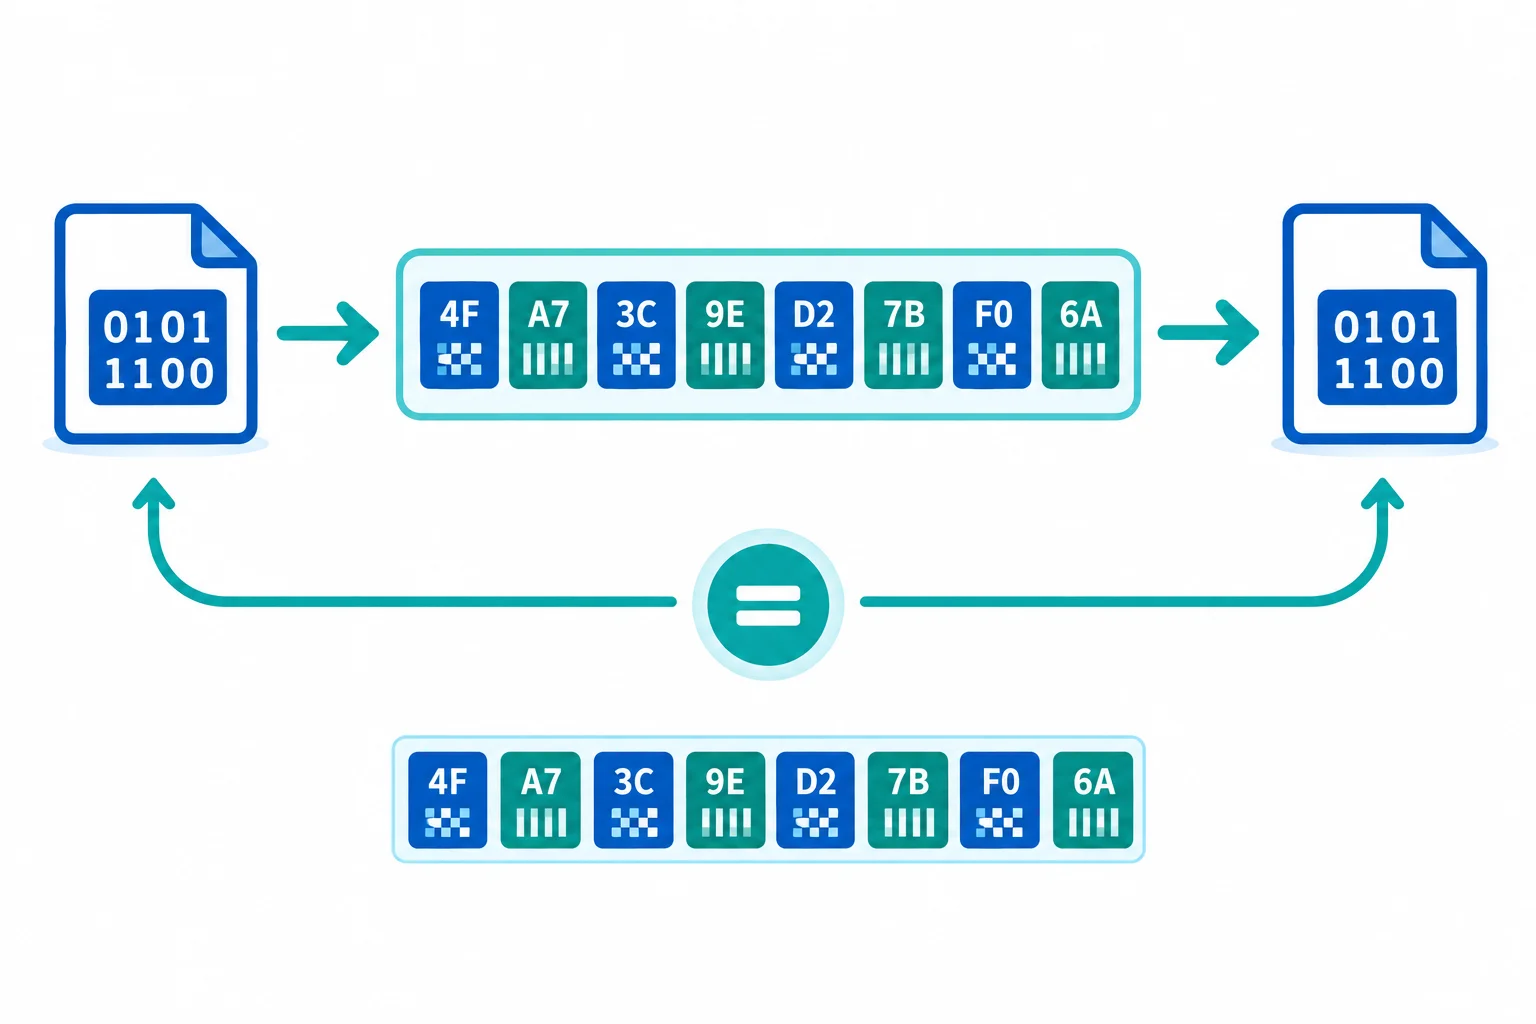
O conteúdo percorre origem, memória e destino sem passar por encode ou decode.
Salve como um script Python e execute-o em uma pasta na qual você possa criar arquivos. O programa criará a pasta pratica_binaria e dois arquivos descartáveis dentro dela.
from pathlib import Path

pasta = Path("pratica_binaria")
pasta.mkdir(exist_ok=True)

origem = pasta / "origem.bin"
destino = pasta / "copia.bin"
amostra = b"\x00\xffAMOSTRA\r\n\x10\x80fim"

# Prepara a origem binária.
with open(origem, "wb") as arquivo:
    arquivo.write(amostra)

# Lê os bytes da origem.
with open(origem, "rb") as arquivo:
    conteudo_origem = arquivo.read()

# Grava exatamente os mesmos bytes no destino.
with open(destino, "wb") as arquivo:
    arquivo.write(conteudo_origem)

# A gravação já foi fechada; agora o destino pode ser relido.
with open(destino, "rb") as arquivo:
    conteudo_copia = arquivo.read()

print(type(conteudo_copia))
print(len(conteudo_copia))
print(conteudo_copia[0])
print(conteudo_copia[:2])
print(conteudo_origem == amostra)
print(conteudo_copia == conteudo_origem)
Dica
A saída final deve mostrar duas comparações True. O primeiro índice produz o inteiro 0, enquanto a fatia dos dois primeiros elementos produz b'\x00\xff'. Se quiser repetir a prática, os arquivos podem ser sobrescritos porque foram abertos com wb.
O que confirmou que a cópia preservou o conteúdo? Por que inserir encode ou decode nesse fluxo seria inadequado?
Escreva pelo menos 80 caracteres (0/80).
Em qual situação uma conversão textual é apropriada?
Resumo
Você agora pode distinguir texto de dados binários, inspecionar sequências de bytes e preservar arquivos sem conversões indevidas.
str representa texto Unicode; bytes representa uma sequência imutável de valores entre 0 e 255.bytes produz um inteiro; uma fatia produz outro valor bytes.rb lê bytes e wb grava bytes, sem codificação textual nem tradução de quebras de linha.texto.encode(codificação) converte str em bytes; dados.decode(codificação) faz o caminho inverso quando os dados representam texto.Parabéns! Você concluiu: Ler e gravar arquivos binários
100 XP
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail
Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.
Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.

+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks