Passo 1 de 8
De padrões aprendidos a uma resposta
Conheça o papel dos padrões aprendidos na produção de respostas e inicie o caso do Clube de Leitura Aurora.

Trilha de aprendizado · Nível 2 · Tutorial 1
Entenda como um modelo de linguagem produz respostas a partir de padrões aprendidos. Com exemplos curtos, você será capaz de explicar tokens e janela de contexto, reconhecer limites de conversas extensas e distinguir uma resposta convincente de uma informação verificada.
 De padrões aprendidos a uma resposta
Conheça o papel dos padrões aprendidos na produção de respostas e inicie o caso do Clube de Leitura Aurora. 2 min
 Tokens: as unidades do texto
Entenda tokens como unidades de processamento de texto e reconheça por que palavras e tokens não têm correspondência fixa. 2 min
 Uma resposta, token após token
2 min
 O que cabe na janela de contexto
Identifique os componentes que ocupam a janela de contexto e entenda por que entrada e resposta compartilham uma capacidade limitada. 2 min
 Por que uma conversa longa pode perder detalhes
Diferencie o histórico visível do histórico efetivamente incluído e interprete o que acontece quando um detalhe necessário fica fora do contexto. 2 min
 Quando vale dividir uma tarefa
2 min
 Uma resposta convincente pode estar errada
Reconheça por que uma resposta fluente pode contradizer ou acrescentar informações ao texto-base, mesmo quando os dados necessários estão disponíveis. 2 min
 Aplicação final: explicar e avaliar uma resposta
Aplique os conceitos do tutorial para explicar uma resposta do Clube de Leitura Aurora, avaliar o que ela sustenta e reconhecer quando uma tarefa extensa pode ser dividida. 2 min
Passo 1 de 8
Conheça o papel dos padrões aprendidos na produção de respostas e inicie o caso do Clube de Leitura Aurora.
Um grande modelo de linguagem (LLM) é um modelo treinado com grandes volumes de texto para trabalhar com linguagem. Depois do treinamento, ele usa padrões aprendidos — como relações entre ideias, formas de escrever e combinações frequentes — para produzir uma resposta.
Ele não precisa encontrar uma resposta idêntica, já pronta, em um catálogo. Pode gerar uma nova formulação que combine com o material disponível e com o pedido recebido.
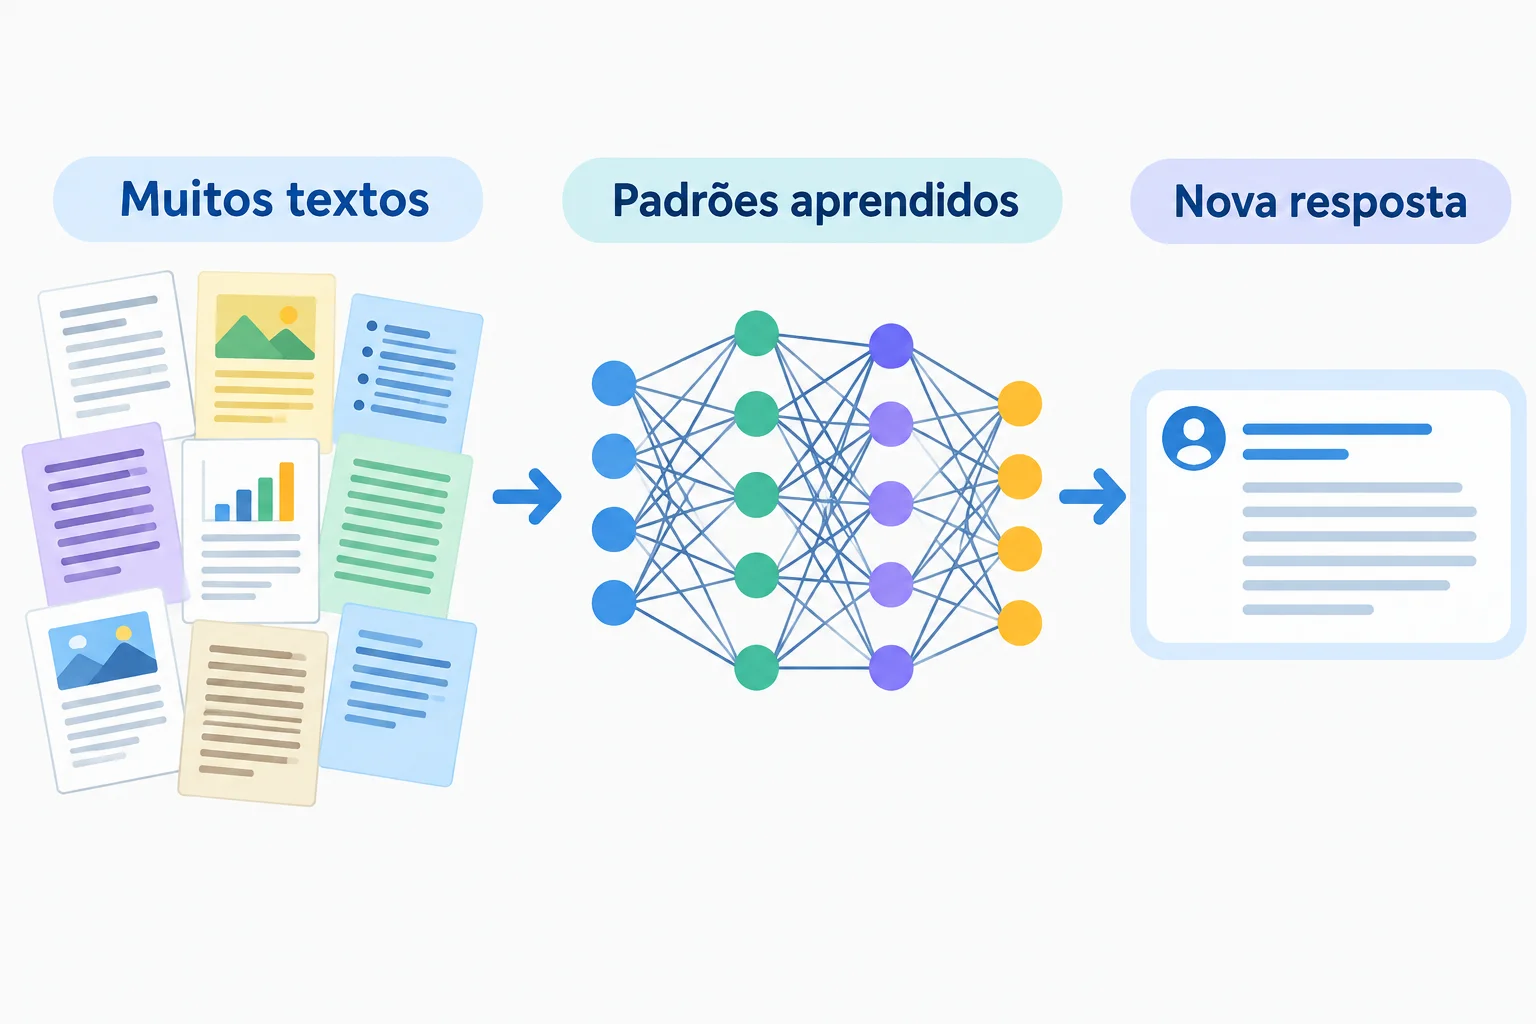
O modelo usa padrões aprendidos para produzir uma resposta nova, e não apenas para recuperar uma frase pronta.
Vamos usar um caso fictício ao longo do tutorial.
Texto-base
O Clube de Leitura Aurora terá um encontro no sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita.
Instrução
Escreva um convite curto para o encontro.
A instrução orienta a tarefa, e o texto-base oferece as informações que devem aparecer no convite.
Exemplo
Resposta simulada
Participe do próximo encontro do Clube de Leitura Aurora! Será no sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita.
Essa redação não precisa ter existido antes exatamente dessa forma. O modelo pode produzir essa formulação ao aplicar padrões de linguagem ao texto-base e à instrução.
Qual explicação descreve melhor como um modelo de linguagem pode produzir uma resposta para uma instrução?
Passo 2 de 8
Entenda tokens como unidades de processamento de texto e reconheça por que palavras e tokens não têm correspondência fixa.
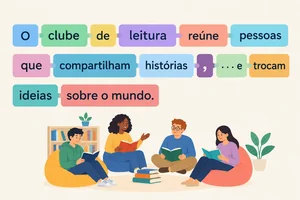
Um modelo de linguagem trabalha com tokens: unidades de texto usadas para processar uma mensagem e produzir uma resposta. Um token não é sinônimo de uma palavra.
Em uma segmentação ilustrativa, uma palavra pode aparecer inteira, como [Clube]; pode ser dividida, como [Lei] [tura]; e sinais como [,] também podem formar tokens. Um espaço pode vir junto de outro elemento, como em [ sábado].
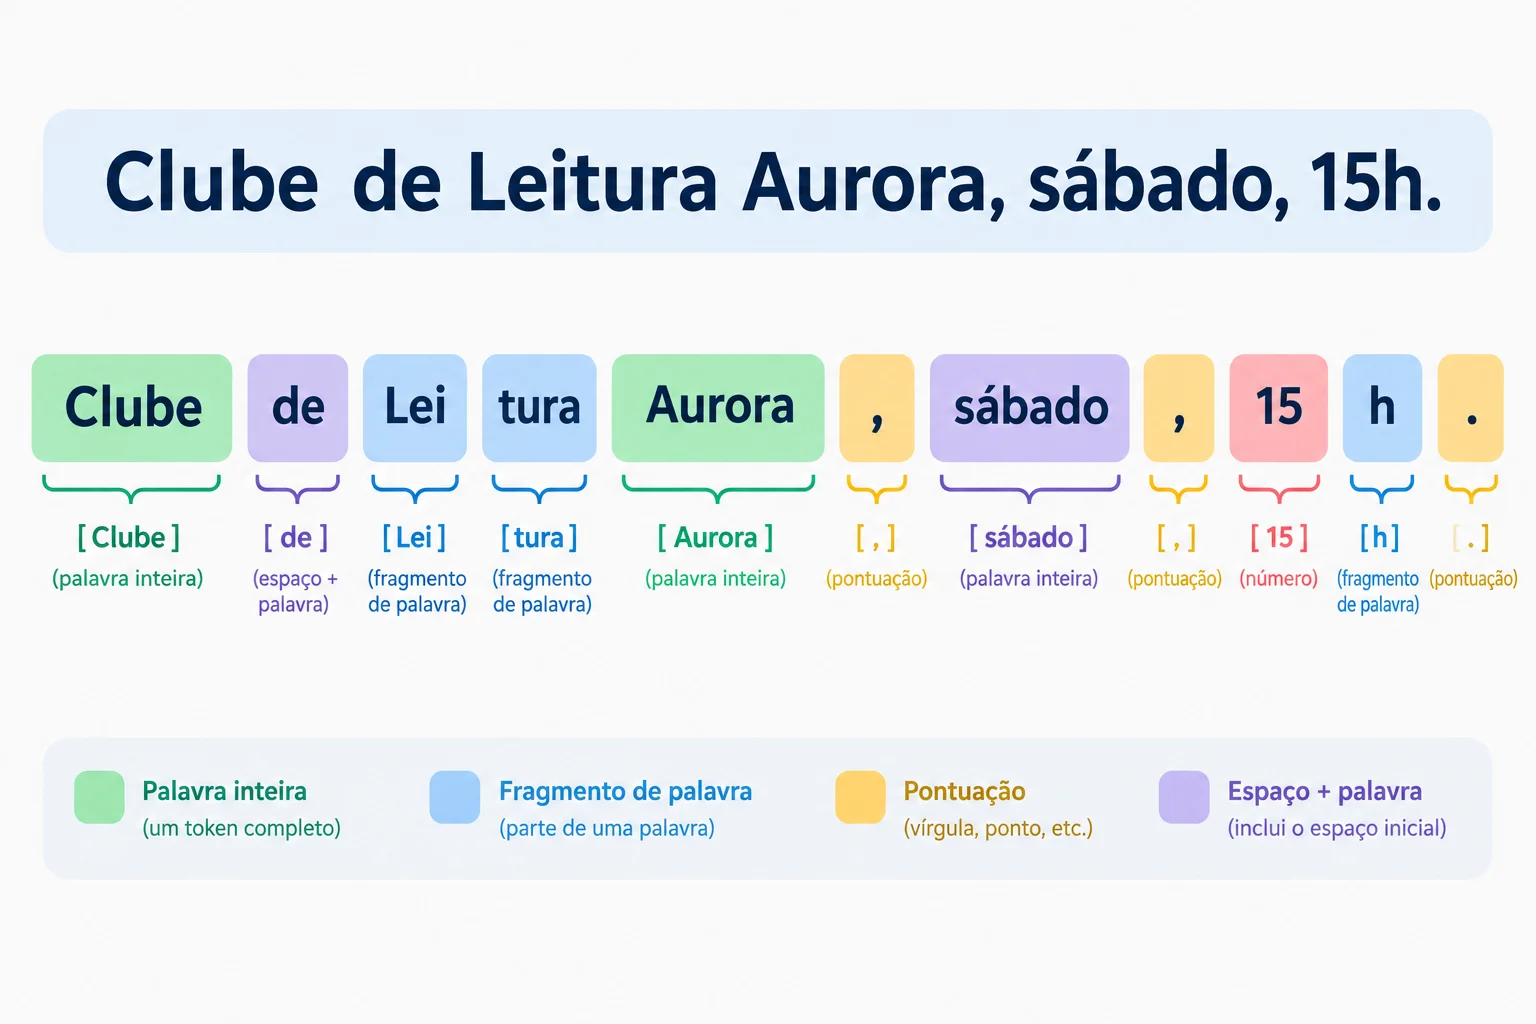
Segmentação ilustrativa: os blocos entre colchetes são exemplos didáticos, não a segmentação comprovada de um modelo específico.
Exemplo
Observe uma forma possível de representar o material do exemplo:
Texto-base
Clube de Leitura Aurora — encontro no sábado, às 15h, na Biblioteca do Bairro. Entrada gratuita.
Segmentação ilustrativa[Clube] [ de] [ Lei] [tura] [ Aurora] [ —] [ encontro] [ no] [ sábado] [,] [ às] [ 15] [h] [,] [ na] [ Biblioteca] [ do] [ Bairro] [.] [ Entrada] [ gratuita] [.]
Os colchetes mostram unidades ilustrativas. Note que Leitura foi dividida, enquanto Biblioteca ficou em um bloco nesta representação.
Dica
A segmentação pode mudar conforme o modelo e o sistema de tokenização. Por isso, não há uma conversão fixa entre palavras e tokens: contar palavras não revela com precisão quantos tokens um texto possui.
Também não presuma que pontuação ou espaço sempre estarão isolados. Eles podem aparecer separados ou combinados com texto, dependendo da segmentação.
Associe cada token à melhor descrição.
Toque em um item e depois no par correspondente.
Considere uma segmentação ilustrativa que contém [lei], [,] e [ sábado]. Qual conclusão é correta?
Passo 3 de 8
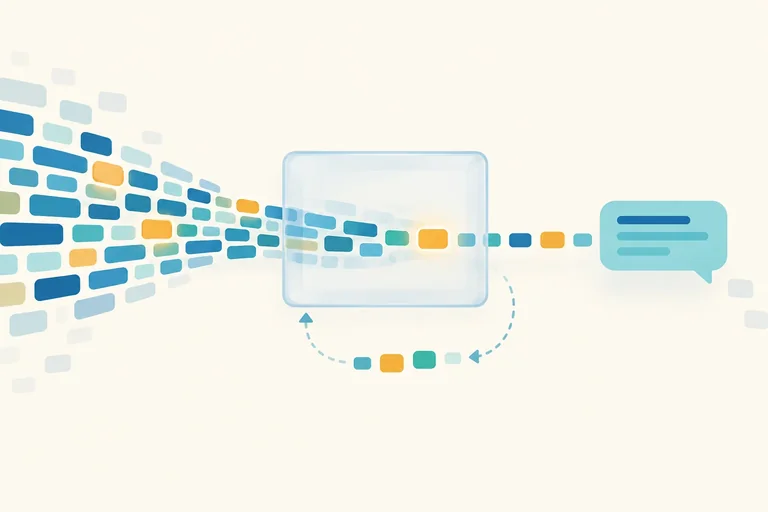
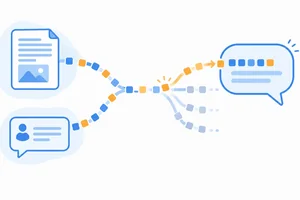
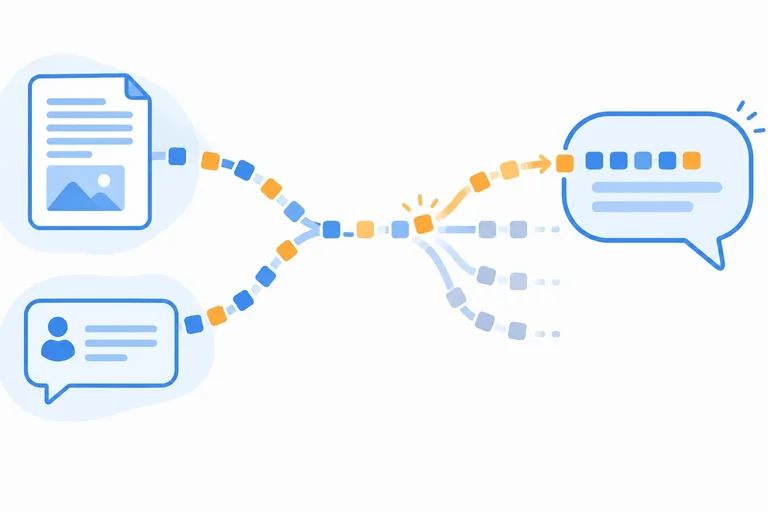
O modelo de linguagem usa o texto disponível até aquele ponto para estimar quais tokens podem vir em seguida. Ele não precisa buscar uma frase inteira pronta: produz a resposta passo a passo, com base em padrões aprendidos.
Em cada passo, há possibilidades com chances diferentes. O modelo seleciona um próximo token, junta esse token ao texto já produzido e passa a considerar a sequência ampliada. Então o ciclo recomeça, até a resposta terminar.
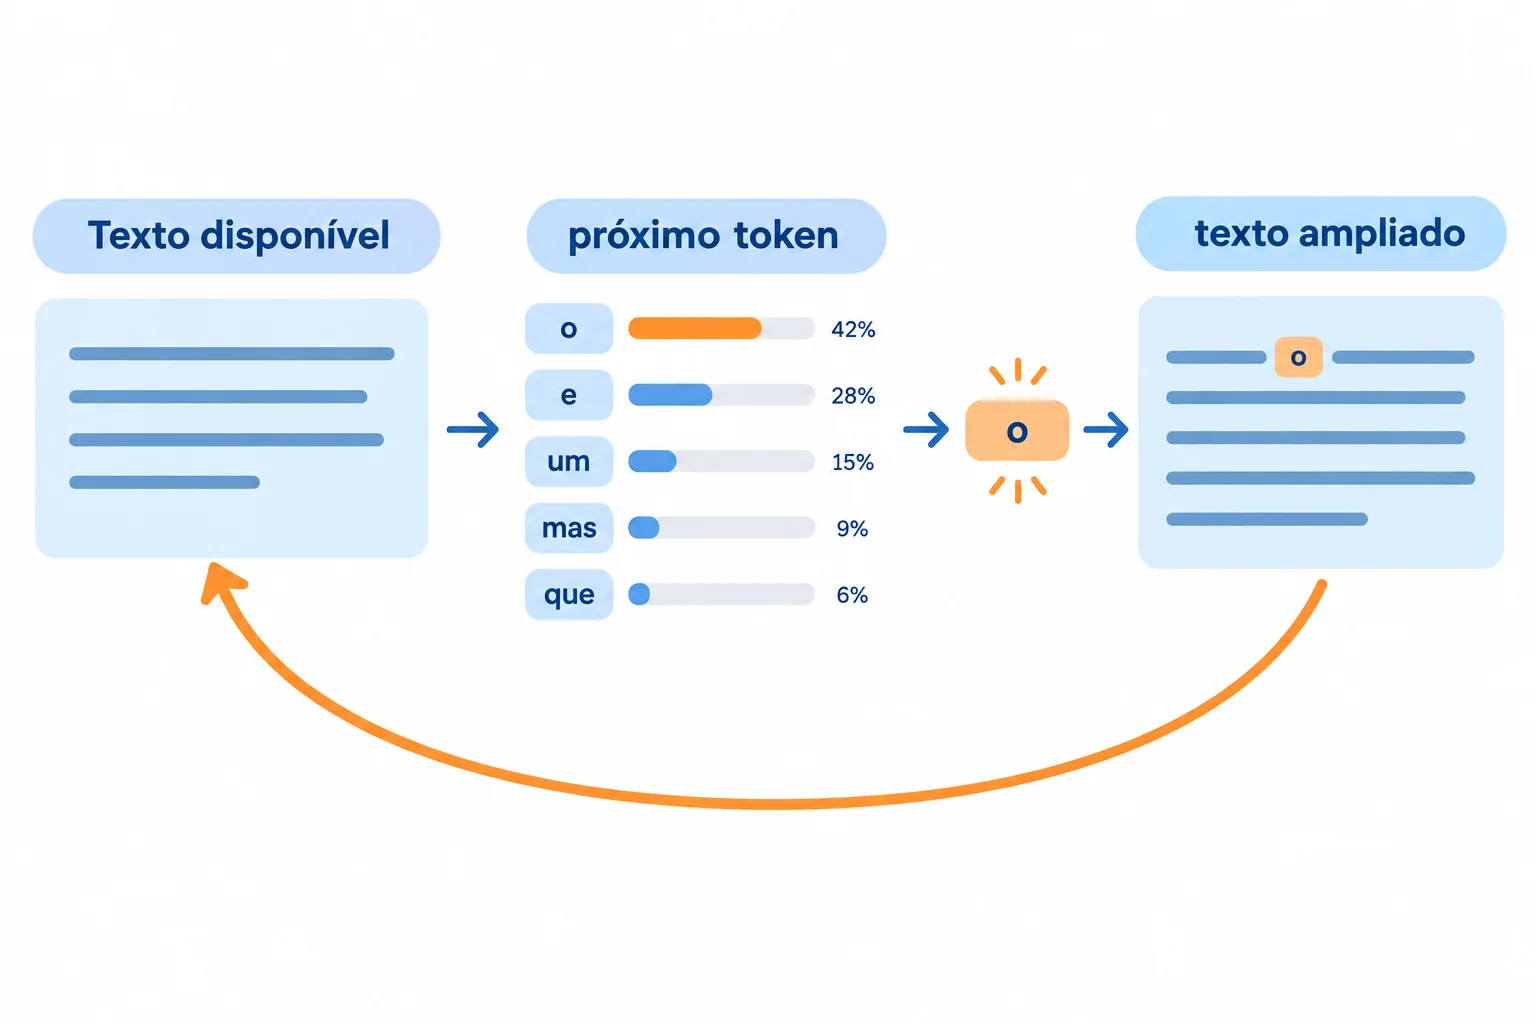
A cada token selecionado, o texto disponível muda e orienta a próxima escolha.
Exemplo
Texto-base
O Clube de Leitura Aurora terá encontro no sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita.
Instrução
Escreva um convite curto para o encontro.
Resposta simulada
Participe do encontro do Clube de Leitura Aurora no sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita.
Uma parte dessa construção poderia ser representada assim:
Segmentação ilustrativa
[Participe] [ do] [ encontro] [ do] [ Clube]
Depois de alguns tokens, podem existir várias continuações adequadas. Por exemplo, após [A] [ entrada] [ é], o modelo pode selecionar [ gratuita] ou selecionar [ sem] e continuar a frase de outra forma.
A seleção não precisa escolher sempre a possibilidade que parece mais provável. Por isso, a mesma instrução pode gerar respostas com formulações diferentes, sem que exista uma única continuação obrigatória.
Verdadeiro ou falso: se um token parece a continuação mais provável, ele é a única continuação que o modelo pode selecionar.
Ordene o ciclo de geração de uma resposta.
Passo 4 de 8
Identifique os componentes que ocupam a janela de contexto e entenda por que entrada e resposta compartilham uma capacidade limitada.
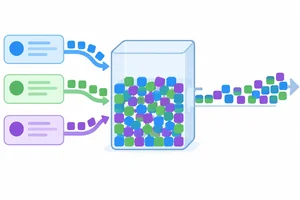
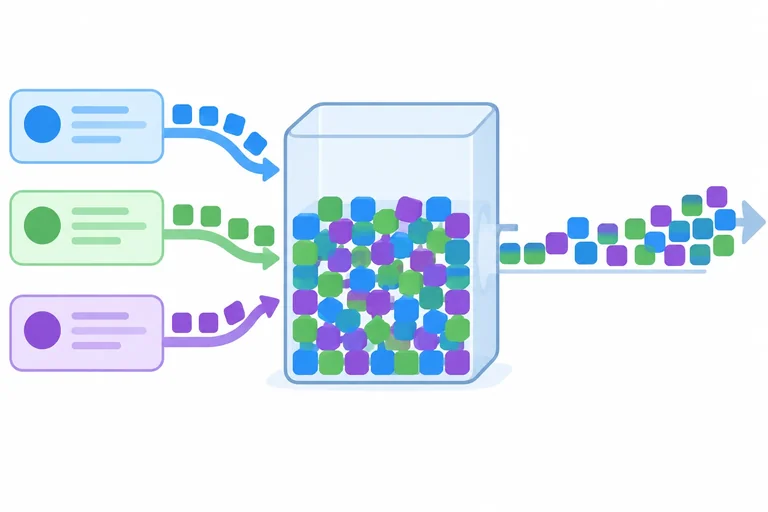
A janela de contexto é a quantidade limitada de tokens com que o modelo de linguagem trabalha para produzir uma resposta. Ela reúne o material disponível naquele momento — e não apenas a mensagem que o usuário acabou de enviar.
Enquanto a resposta é produzida token por token, os tokens já gerados também passam a ocupar espaço. Por isso, a capacidade precisa comportar tanto os materiais de entrada quanto a resposta em geração.
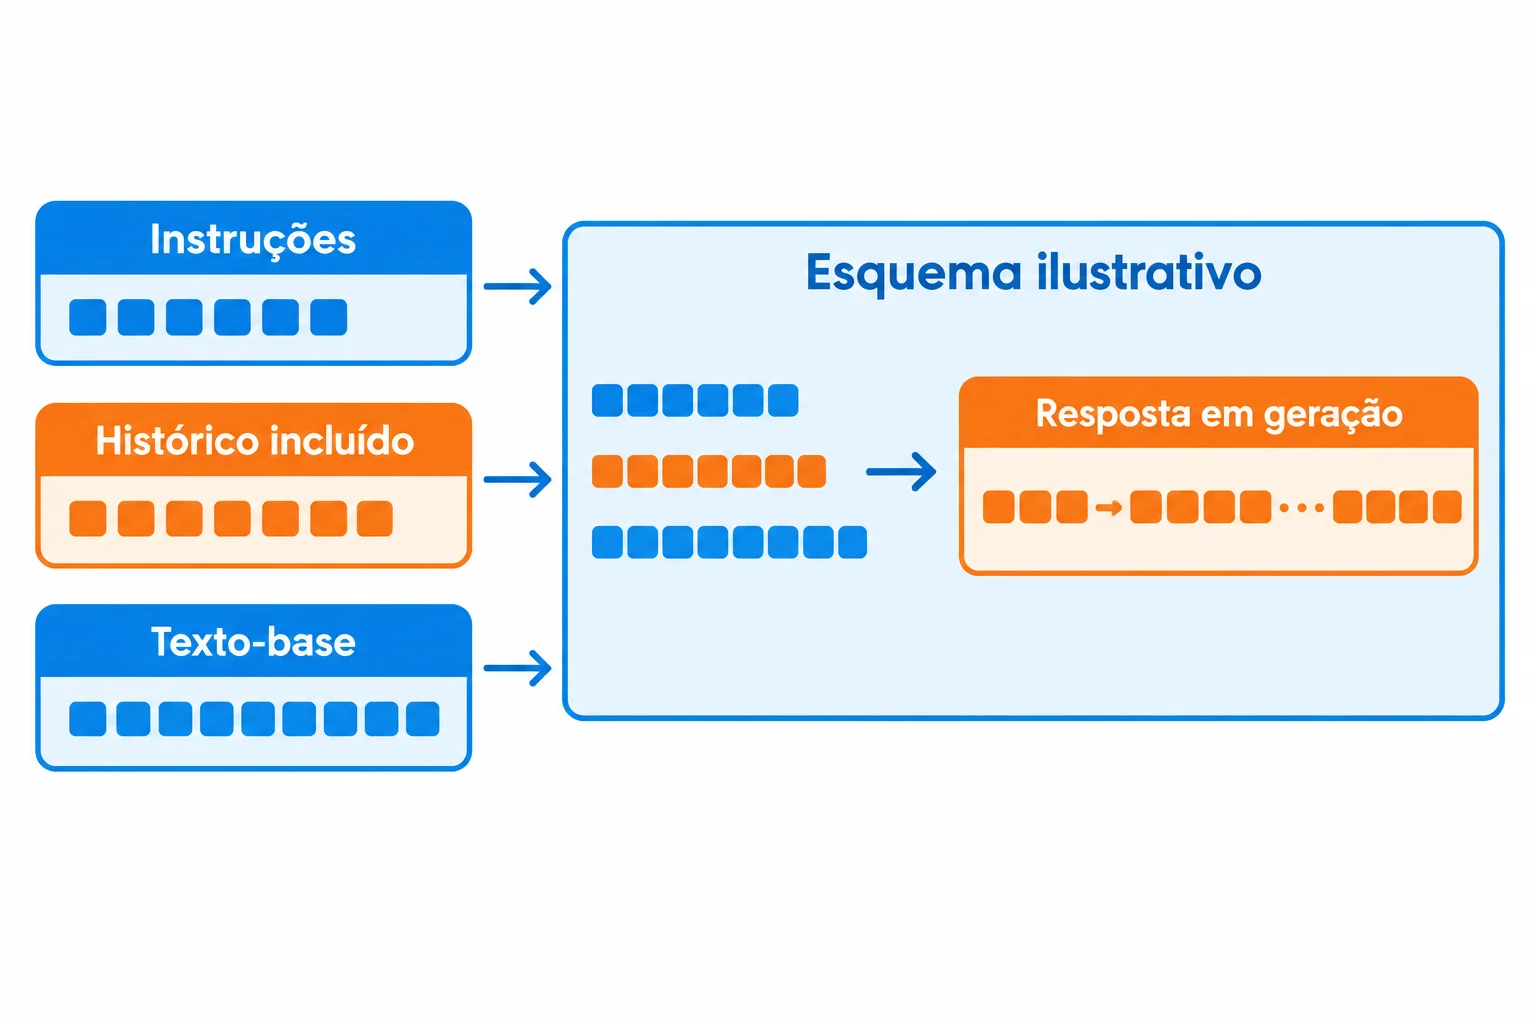
Esquema ilustrativo: entrada e resposta em geração compartilham uma capacidade limitada.
No exemplo do Clube de Leitura Aurora, o modelo recebe materiais que cumprem papéis diferentes. O texto-base fornece os fatos a usar; a instrução indica a tarefa; e o histórico incluído pode trazer mensagens anteriores que foram efetivamente disponibilizadas para esta geração.
Também podem existir Instruções incluídas pelo sistema, mesmo que não apareçam como mensagens do usuário. Neste momento, o importante é reconhecer que elas podem fazer parte do texto disponível e ocupar espaço na janela de contexto.
Exemplo
Texto-base
Clube de Leitura Aurora: encontro no sábado, às 15h, na Biblioteca do Bairro, com entrada gratuita.
Instrução
Escreva um convite curto usando apenas o texto-base.
Resposta simulada
Participe do Clube de Leitura Aurora neste sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita!
Os limites podem variar conforme o modelo. Em vez de supor uma única capacidade, diferencie o que cabe na entrada, no contexto total e na saída. Esses limites não precisam ser iguais.
A resposta em geração não fica fora da conta: cada novo token produzido usa parte do contexto total. Assim, uma entrada extensa pode caber, mas ainda deixar pouco espaço para uma resposta longa.
| Limite | O que considera | Consequência prática |
|---|---|---|
| Entrada | Instruções, histórico incluído e texto-base | Define quanto material pode ser fornecido. |
| Contexto total | Entrada e resposta em geração | Limita o conjunto usado durante a geração. |
| Saída | Tokens que a resposta pode produzir | Define até onde a resposta pode se estender. |
Associe cada elemento do esquema de contexto à descrição correspondente.
Toque em um item e depois no par correspondente.
Passo 5 de 8
Diferencie o histórico visível do histórico efetivamente incluído e interprete o que acontece quando um detalhe necessário fica fora do contexto.
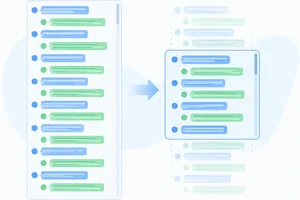
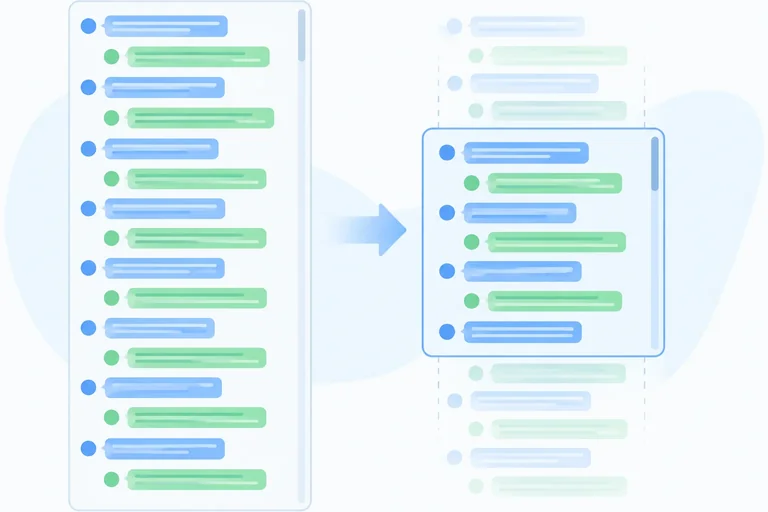
Em uma conversa longa, você pode rolar a tela e ler mensagens antigas. Porém, em uma geração específica, o modelo de linguagem trabalha apenas com o histórico incluído na sua janela de contexto.
Assim, duas coisas podem ser diferentes:
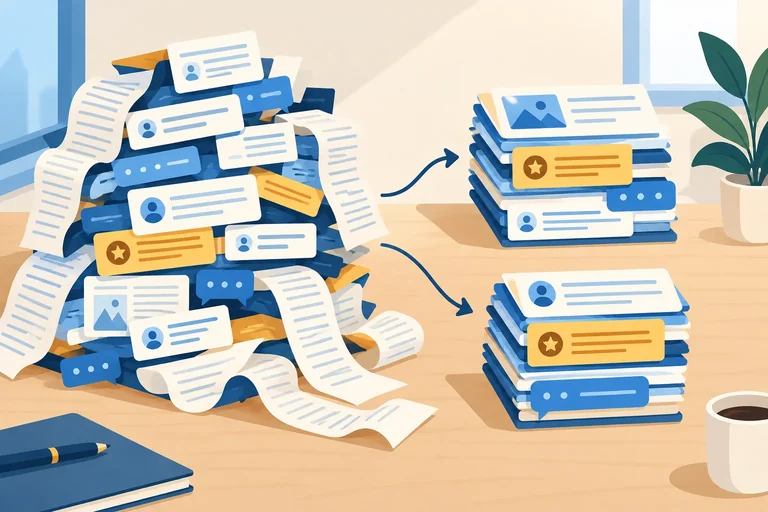
Quando o volume cresce, mensagens antigas ou partes delas podem deixar de ser incluídas, mesmo que permaneçam visíveis na tela.
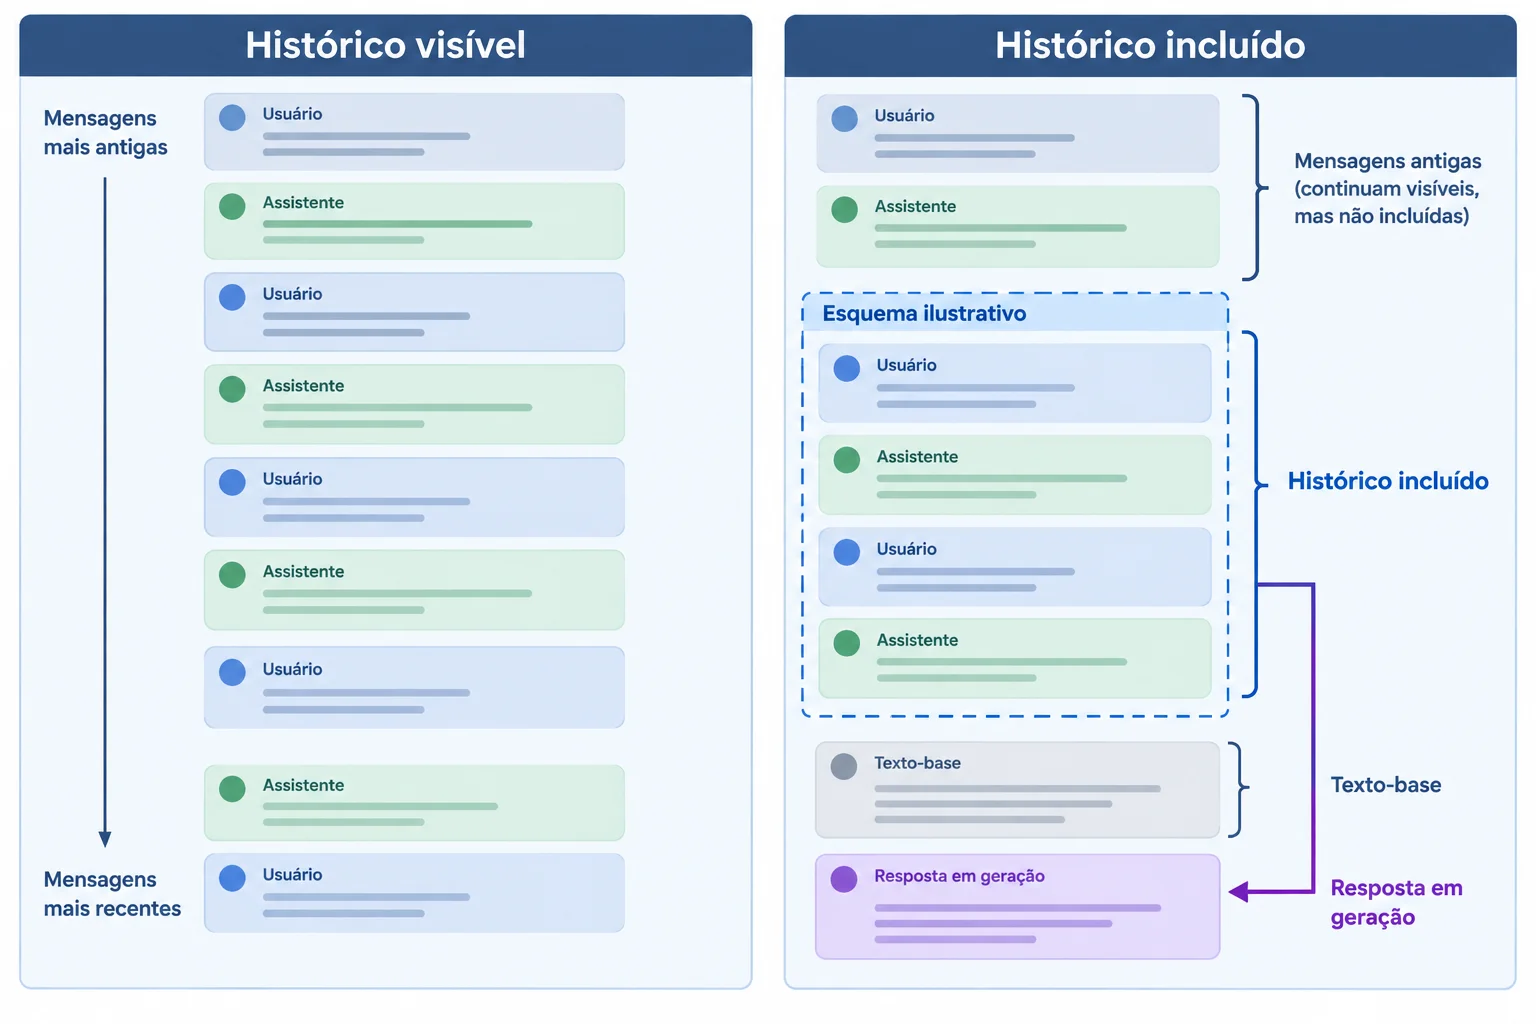
Esquema ilustrativo: o histórico que aparece na tela pode ser maior que o histórico incluído na geração atual.
Para caber no limite, um sistema pode deixar de incluir mensagens ou trechos antigos. Dependendo do sistema, também pode reduzir parte do histórico a um resumo. Um resumo preserva algumas ideias, mas pode perder detalhes específicos.
Se uma informação necessária não está no histórico incluído nem em outro texto disponível, ela não pode orientar diretamente a resposta atual. Isso não significa que toda conversa longa falhará: depende do que foi incluído e do tamanho dos materiais.
Exemplo
Texto-base no início da conversa: o Clube de Leitura Aurora terá encontro no sábado, às 15h, na Biblioteca do Bairro, com entrada gratuita.
Após muitas mensagens, a geração atual recebe apenas uma parte recente do histórico. O Texto-base original não está nesse recorte.
Instrução atual: “Informe se há cobrança para participar.”
Nesse cenário, o usuário ainda pode ver o Texto-base ao rolar a conversa, mas o modelo não tem esse detalhe disponível para usar na resposta atual.
Por outro lado, se uma Resposta simulada deixasse de mencionar a entrada gratuita quando o Texto-base estivesse incluído, essa omissão, sozinha, não provaria que houve perda de contexto. Pode haver outras razões para uma resposta não citar um detalhe.
Dica
Não conclua apenas pela ausência de uma informação na resposta. Para saber se ela estava indisponível, seria preciso observar quais trechos foram incluídos na geração ou ter informação confiável sobre esse recorte.
Considere este Esquema ilustrativo:
Qual interpretação é mais adequada?
Passo 6 de 8
Uma tarefa extensa pode pressionar a janela de contexto quando reúne muito texto-base, histórico e exigências em uma única instrução. Um pedido de resposta muito longa também ocupa espaço enquanto a resposta é produzida.
Esses elementos são sinais de risco, não uma prova de que haverá erro. A decisão de dividir depende do volume necessário para realizar aquela tarefa e do que precisa continuar disponível.
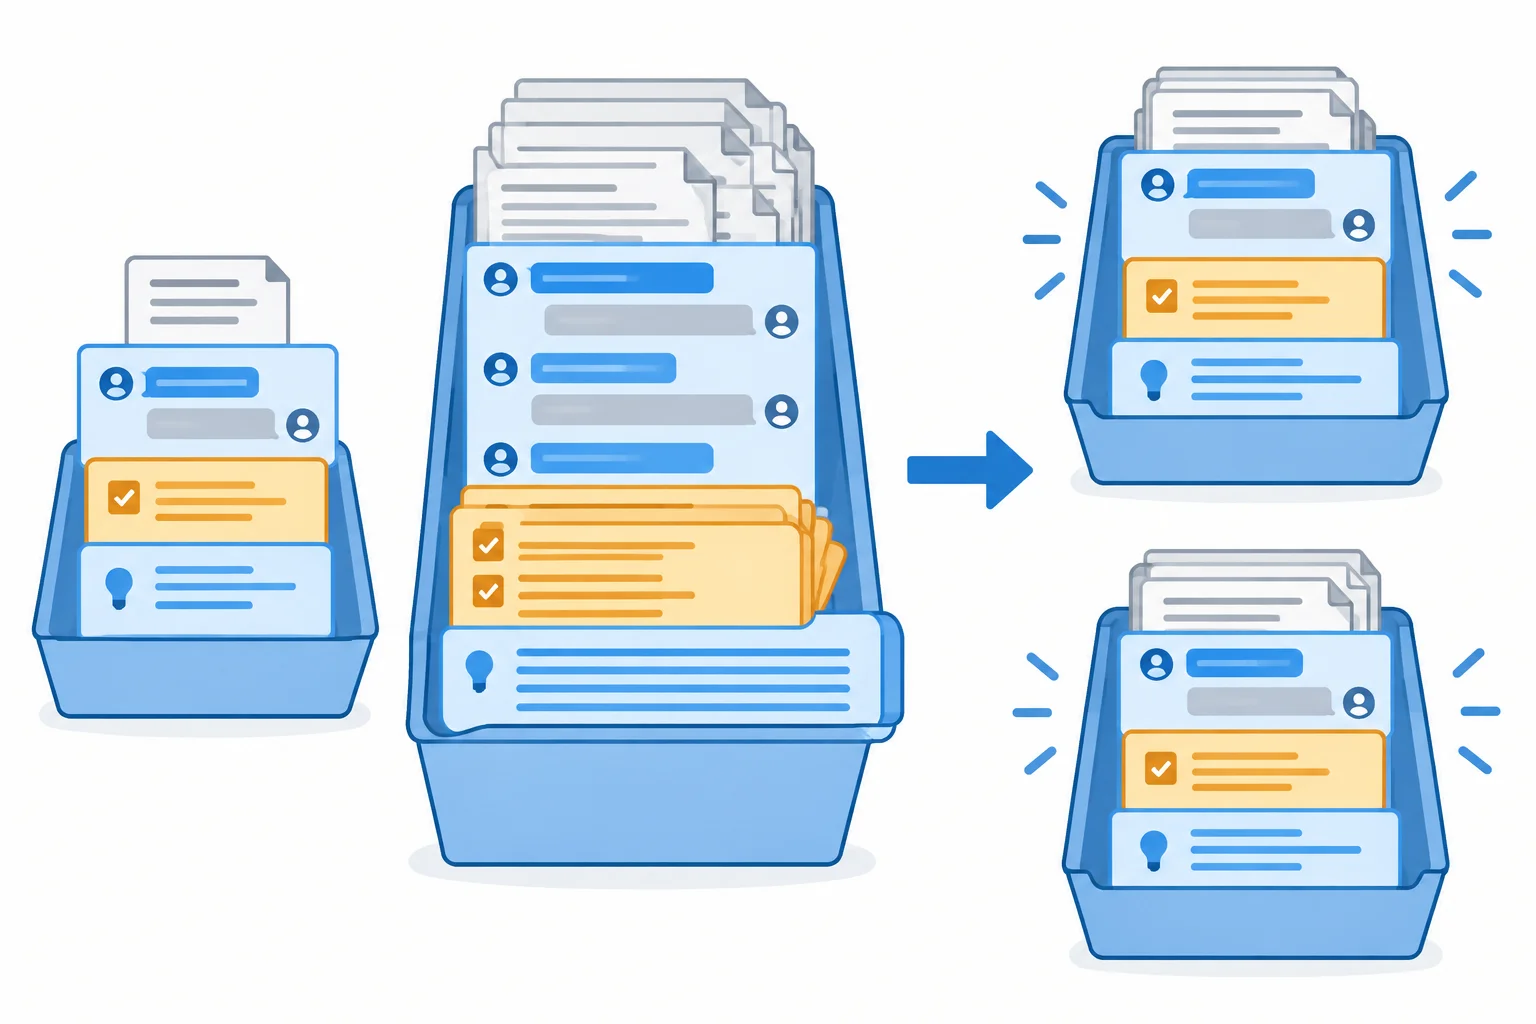
Quando muitos materiais e uma saída longa ficam concentrados, etapas menores podem reduzir o volume necessário por vez. Os dados essenciais precisam acompanhar a parte que os utiliza.
Dividir é uma decisão proporcional: uma pergunta simples não precisa virar várias etapas. Já uma tarefa que combina materiais extensos, histórico longo, muitas exigências e resposta longa pode se beneficiar de partes menores.
Isso reduz a quantidade de informação necessária em cada momento, mas não garante uma resposta correta. Se uma parte depende de um dado, esse dado essencial precisa estar disponível nela.
Compare o tamanho e a quantidade de materiais envolvidos antes de decidir.
| Situação | Volume por etapa | Decisão proporcional |
|---|---|---|
| Uma pergunta direta sobre um texto-base curto | Baixo | Em geral, não precisa dividir |
| Muitos textos, histórico longo e várias exigências | Alto | Dividir pode ajudar |
| Pedido de resposta muito longa | Alto na saída | Dividir pode ajudar |
| Tarefa curta com poucos dados essenciais | Baixo | Manter em uma etapa pode bastar |
Exemplo
Texto-base
Clube de Leitura Aurora: encontro no sábado, às 15h, na Biblioteca do Bairro, com entrada gratuita.
Instrução
"Em uma frase, informe o local e o horário do encontro."
Resposta simulada
"O encontro será na Biblioteca do Bairro, às 15h."
Esse pedido curto normalmente cabe em uma etapa. Agora compare com esta Instrução: "Usando o texto-base e um histórico longo com versões de convites e decisões, produza um material muito extenso que trate de todas as exigências." Nesse caso, o acúmulo de histórico, materiais e saída prevista é um motivo para considerar partes menores. Em qualquer parte que use os dados do clube, eles devem continuar disponíveis.
Qual situação tende a se beneficiar mais de ser dividida em partes?
Texto-base
Clube de Leitura Aurora: encontro no sábado, às 15h, na Biblioteca do Bairro, com entrada gratuita.
Compare as tarefas:
Qual tarefa se beneficia mais de divisão? Justifique pelo volume de contexto ou de saída necessário e explique como os dados essenciais do Texto-base devem continuar disponíveis nas partes relevantes.
Escreva pelo menos 120 caracteres (0/120).
Passo 7 de 8
Reconheça por que uma resposta fluente pode contradizer ou acrescentar informações ao texto-base, mesmo quando os dados necessários estão disponíveis.
Uma alucinação é um conteúdo que parece adequado, mas é incorreto ou inventado. Um modelo de linguagem produz uma resposta ao prever continuações plausíveis; esse processo não é, por si só, uma conferência dos fatos.
Por isso, uma resposta pode ser fluente, bem organizada e escrita em tom confiante, mas ainda conter um detalhe falso. Isso pode acontecer inclusive quando o texto-base inteiro está disponível na janela de contexto.
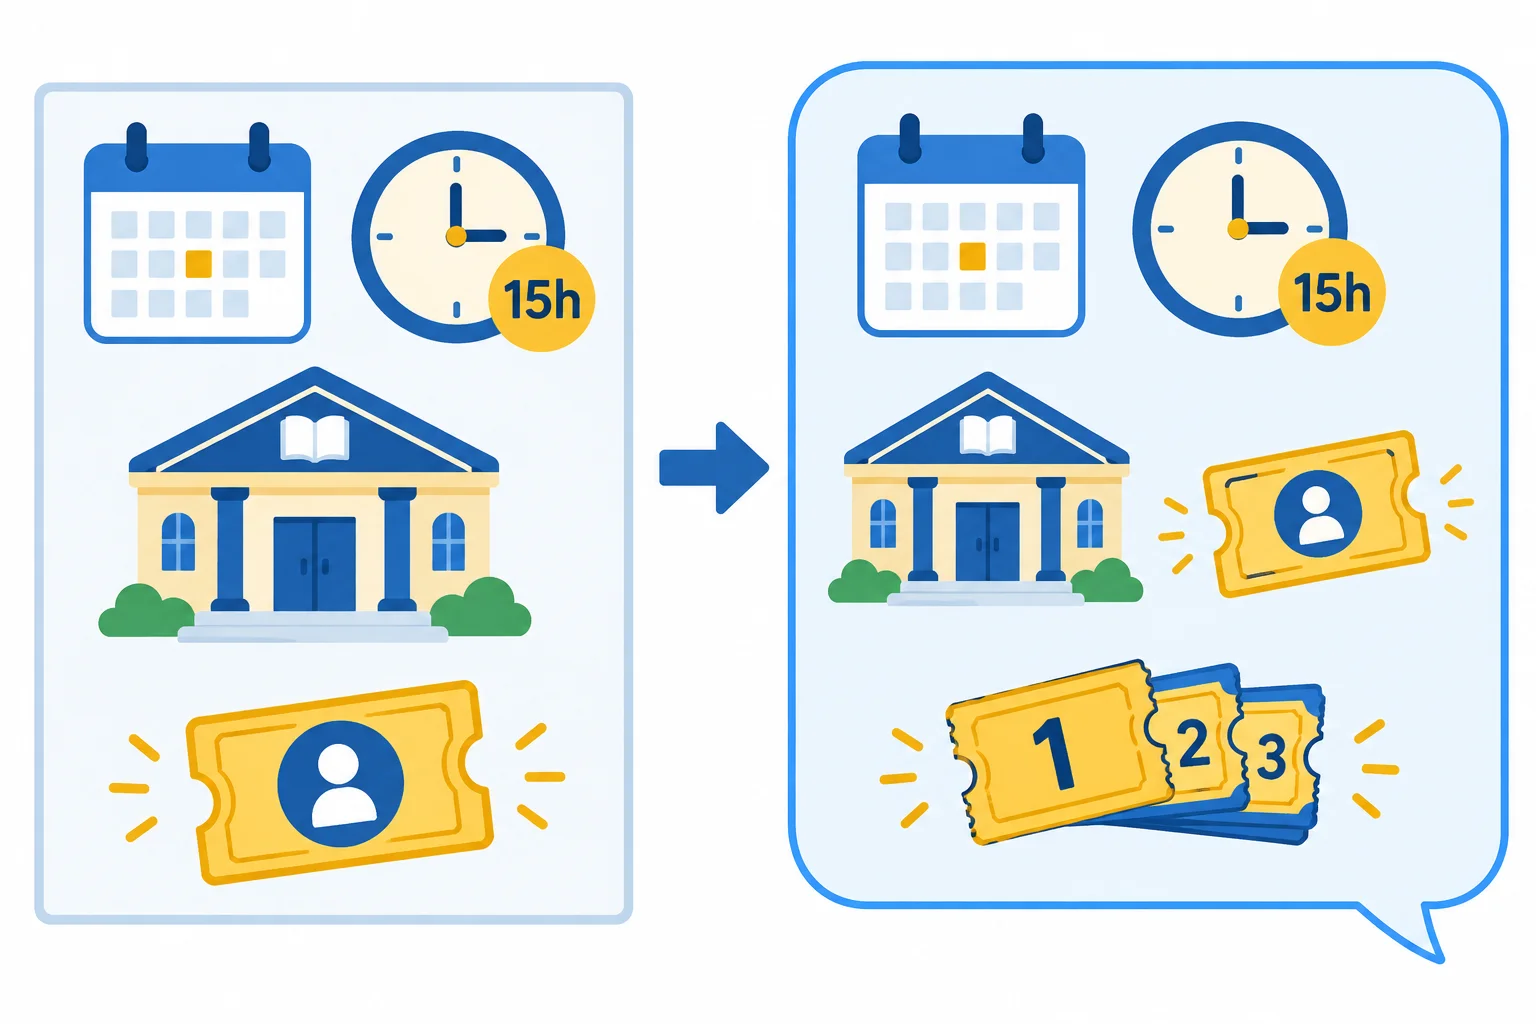
Uma resposta pode combinar informações corretas do texto-base com um detalhe adicional que não foi fornecido.
Ao comparar uma resposta com o texto-base, há duas situações diferentes:
Essa comparação avalia a fidelidade da resposta ao material fornecido. Ela não comprova automaticamente que os fatos do texto-base são verdadeiros fora daquele material.
Exemplo
Texto-base
Clube de Leitura Aurora: encontro no sábado, às 15h, na Biblioteca do Bairro, com entrada gratuita.
Instrução
Escreva um convite breve usando somente o texto-base.
Resposta simulada
“Venha ao Clube de Leitura Aurora no domingo, às 15h, na Biblioteca do Bairro. A entrada é gratuita e há 40 vagas.”
Compare cada trecho da Resposta simulada com o Texto-base, sem supor informações que não foram fornecidas.
| Trecho da resposta | Classificação | Motivo |
|---|---|---|
| “no domingo” | Contradita | O texto-base informa sábado. |
| “há 40 vagas” | Não sustentada | O texto-base não informa quantidade de vagas. |
| “às 15h” | Sustentada | O texto-base informa 15h. |
Compare os materiais integralmente.
Texto-base
Clube de Leitura Aurora: encontro no sábado, às 15h, na Biblioteca do Bairro, com entrada gratuita. A quantidade de vagas não é informada.
Instrução
Escreva um convite breve usando somente o texto-base.
Resposta simulada
“O Clube de Leitura Aurora será no domingo, às 15h, na Biblioteca do Bairro. A entrada é gratuita, e a organização reservou 30 vagas.”
Aponte um detalhe contraditório ou não sustentado na Resposta simulada. Em seguida, explique por que esse erro não pode ser atribuído necessariamente à falta de espaço na janela de contexto.
Escreva pelo menos 80 caracteres (0/80).
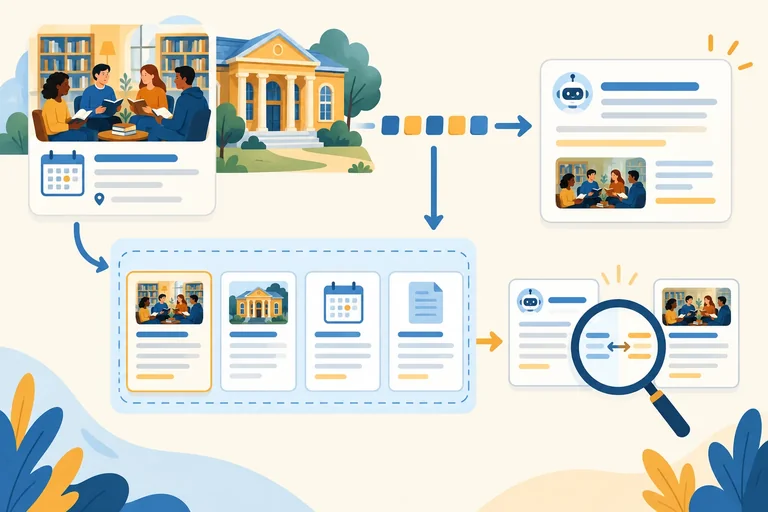
Passo 8 de 8
Aplique os conceitos do tutorial para explicar uma resposta do Clube de Leitura Aurora, avaliar o que ela sustenta e reconhecer quando uma tarefa extensa pode ser dividida.
No caso do Clube de Leitura Aurora, o modelo de linguagem usa o texto disponível — como a instrução e o texto-base — para construir uma resposta. Ele não precisa retirar uma frase pronta de um catálogo: prevê um token, incorpora esse token ao texto e repete o processo.
Essa geração pode produzir uma formulação coerente com os fatos recebidos. Porém, coerência não transforma uma informação ausente em informação confirmada.
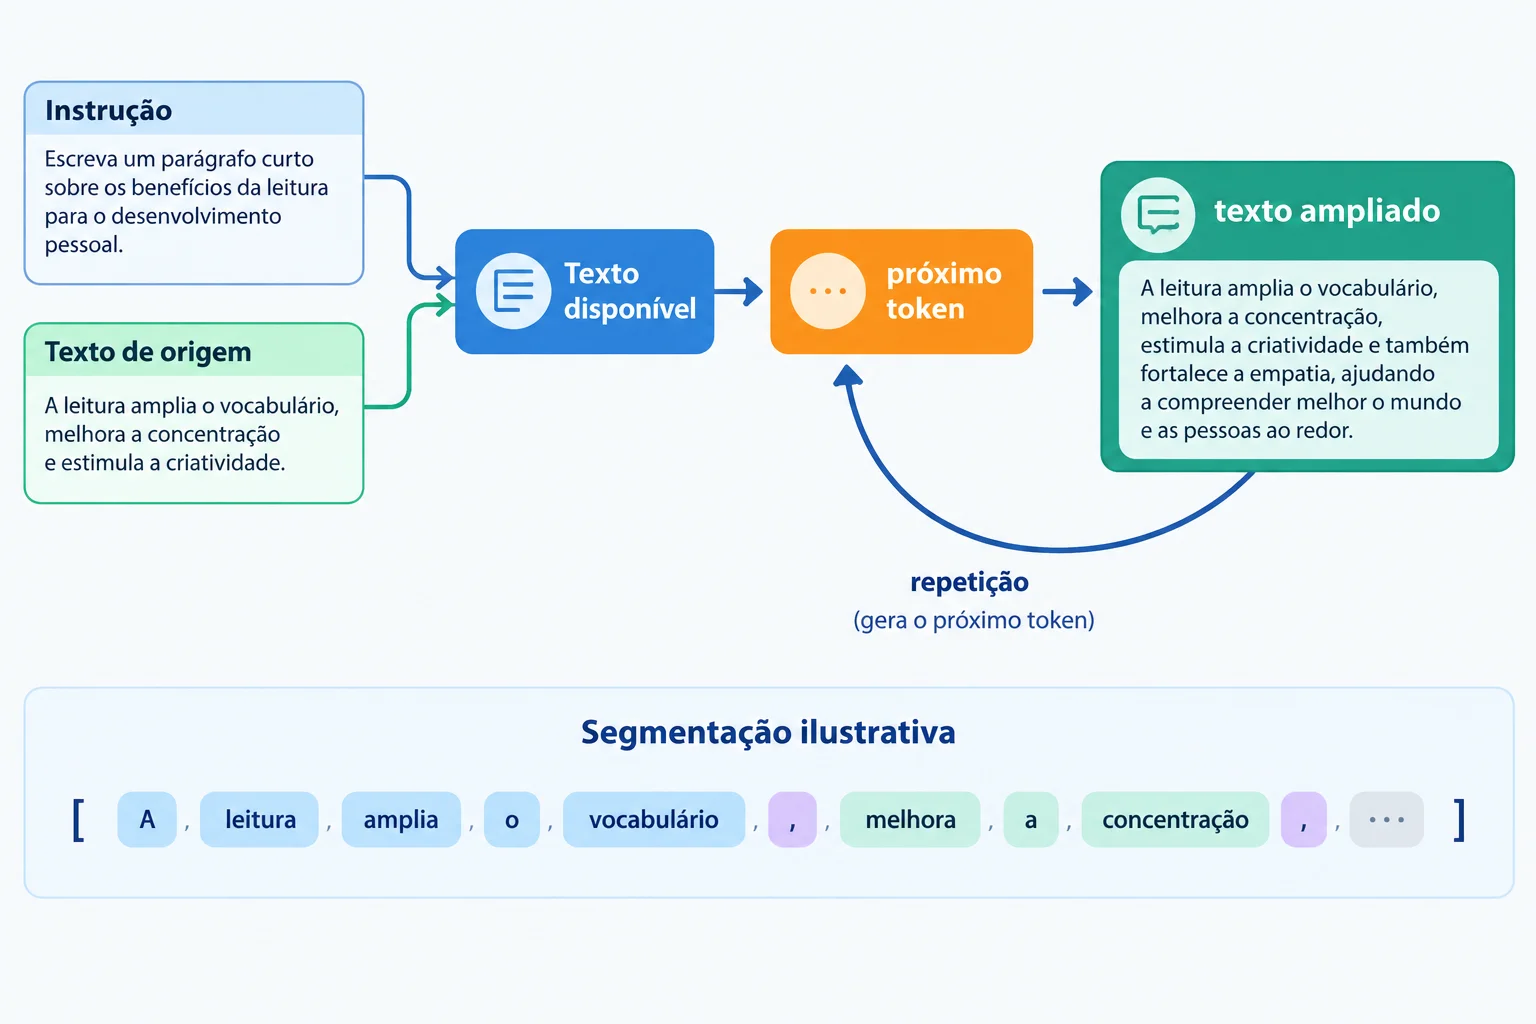
O texto ampliado volta a servir de base para prever o próximo token.
Exemplo
Texto-base
O Clube de Leitura Aurora terá encontro no sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita.
Instrução
Escreva um convite curto para o encontro.
Resposta simulada
Participe do encontro do Clube de Leitura Aurora neste sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita e as vagas são limitadas.
Organize o ciclo que produz uma resposta, do início ao fim.
Há dois pontos diferentes a avaliar. Primeiro: quais informações estavam disponíveis ao modelo? Segundo: o que a resposta afirma?
No exemplo, o texto-base cabe integralmente no contexto. Ainda assim, a frase sobre vagas pode ser uma alucinação: é plausível, mas não é sustentada pelo texto-base. Portanto, ela não prova que houve perda de contexto.
Em uma conversa extensa, o histórico visível ao usuário pode não ser o histórico incluído. Muitos materiais, muitas mensagens e uma resposta longa aumentam a pressão sobre a janela de contexto. Dividir a tarefa pode reduzir esse volume, desde que os dados essenciais de cada parte continuem disponíveis. Isso reduz um risco; não garante uma resposta correta.
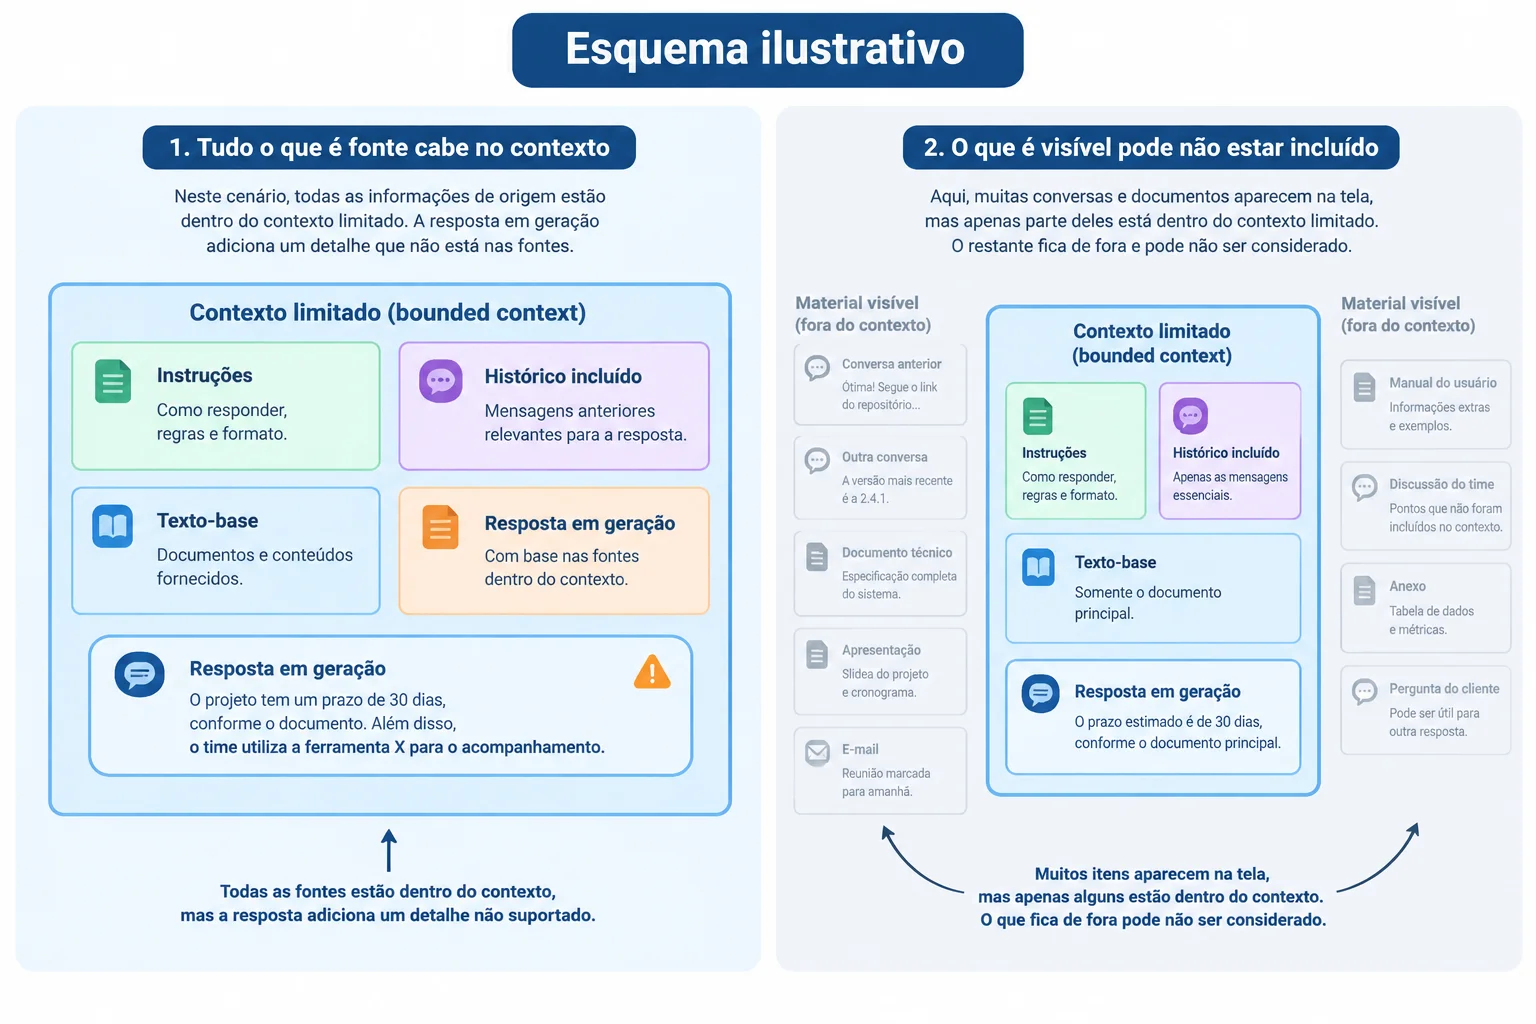
Uma afirmação não sustentada pode ocorrer mesmo com o texto-base disponível; uma conversa longa também pode deixar detalhes fora do histórico incluído.
Resumo
Resolva o caso em uma única resposta.
Momento 1
Texto-base
O Clube de Leitura Aurora terá encontro no sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita.
Instrução
Escreva um convite curto para o encontro.
Resposta simulada
Participe do encontro do Clube de Leitura Aurora neste sábado, às 15h, na Biblioteca do Bairro. A entrada é gratuita e as vagas são limitadas.
Explique como o modelo pode gerar essa resposta a partir do texto disponível e da previsão sucessiva de tokens. Identifique qual afirmação não é sustentada pelo texto-base e explique por que isso, por si só, não indica perda de contexto.
Momento 2
Agora imagine que a mesma tarefa reúne muitos textos-base, um histórico visível muito extenso e um pedido de resposta longa. Explique quando dividir a tarefa pode ajudar e qual cuidado é necessário em cada parte. Conclua sem tratar fluência como verificação de fatos nem atribuir toda alucinação ao limite de contexto.
Escreva pelo menos 300 caracteres (0/300).
Parabéns! Você concluiu: Como modelos de linguagem geram respostas
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail

Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.



Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.


+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks