Passo 1 de 6

Trilha de aprendizado · Nível 1 · Tutorial 5
Interprete pequenas tabelas de resultados para reconhecer sinais de sobreajuste e limites de generalização. Relacione possíveis falhas à qualidade e à representatividade dos dados, evitando concluir que um bom resultado no treino garante bom desempenho em qualquer situação.
 Leia o que os acertos e erros mostram
2 min
 Reconheça sinais de sobreajuste
Compare resultados de treino e teste para reconhecer sinais de possível sobreajuste, sem transformar uma diferença em diagnóstico definitivo. 3 min
 Procure problemas nos dados
Reconheça problemas em registros de dados e relacione cada um a possíveis efeitos no aprendizado ou na avaliação. 3 min
 Confira se os dados representam o uso
Entenda por que um bom resultado em um contexto avaliado não permite prever, sem evidência compatível, o desempenho em outro contexto de uso. 3 min
 Veja o que a taxa geral esconde
3 min
 Faça uma leitura crítica do resultado
Integre resultados de Treino e Teste, qualidade dos dados, representatividade e desempenho por categoria em um parecer breve e responsável. 3 min
Passo 1 de 6
Em uma avaliação, há acerto quando a previsão do modelo concorda com o rótulo de referência. Há erro quando elas discordam. O rótulo de referência é a resposta considerada correta para aquele exemplo.
Registros fictícios da Loja Ipê. Cada linha permite conferir se a classificação do modelo concordou com o rótulo de referência.
| Canal | Mensagem | Rótulo de referência | Previsão do modelo |
|---|---|---|---|
| Site | Meu pedido ainda não chegou. | Entrega | Entrega |
| Site | Quero devolver um produto. | Troca | Entrega |
| Site | Como acompanho a entrega? | Entrega | Entrega |
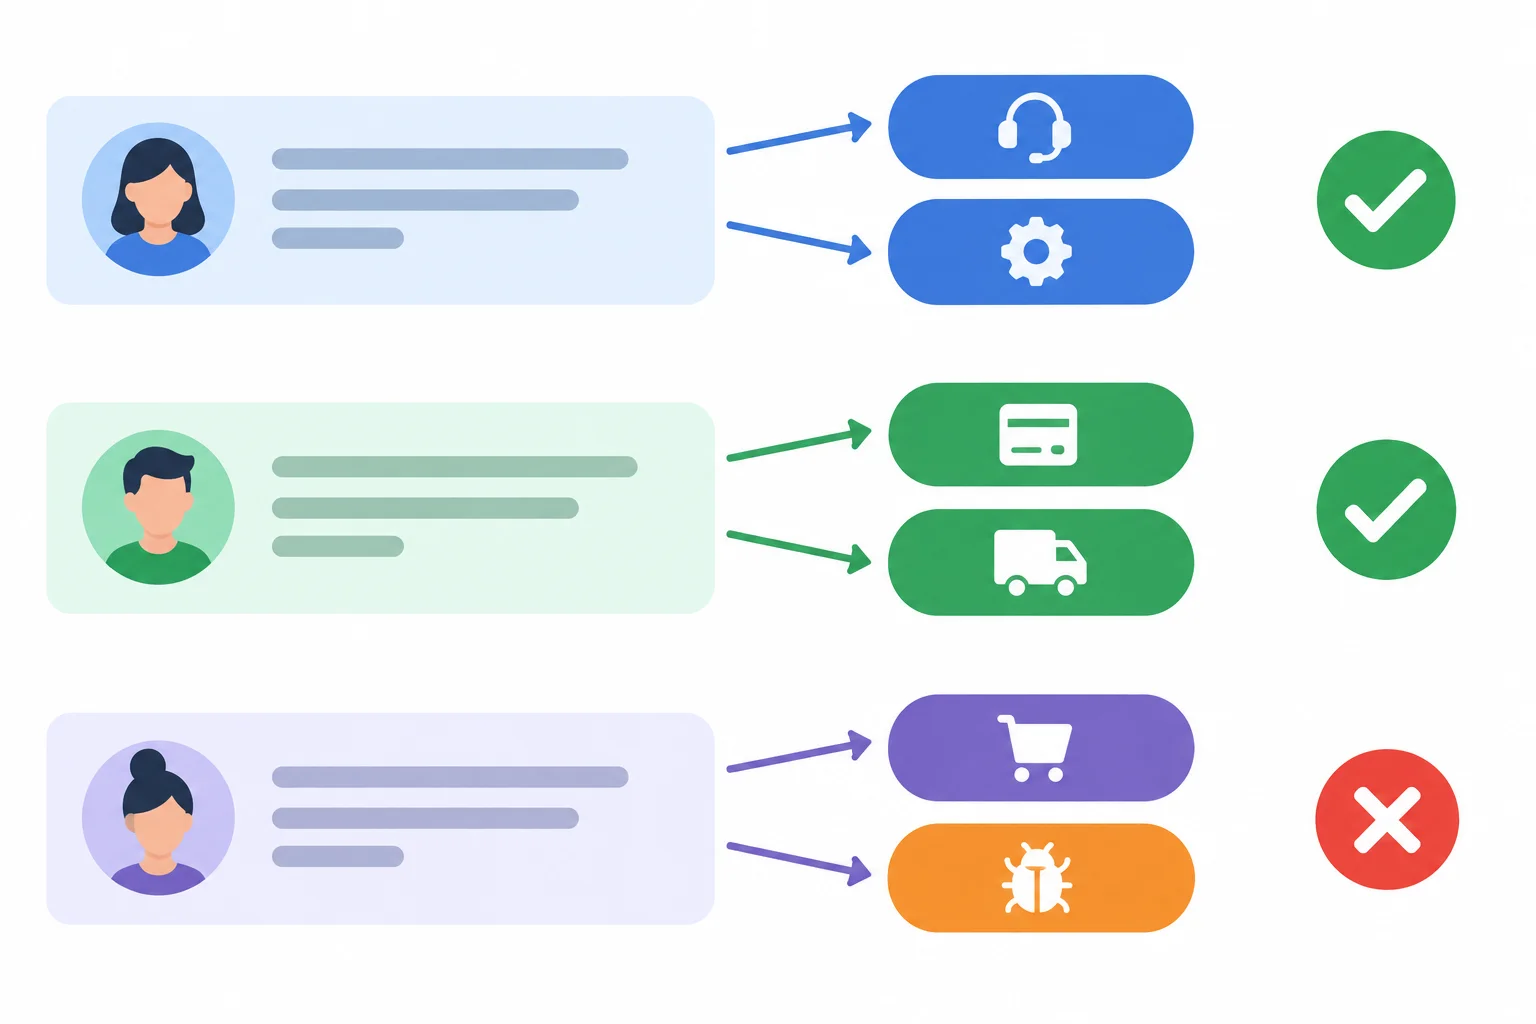
Quando referência e previsão coincidem, é um acerto; quando divergem, é um erro.
A tabela reúne a avaliação do Modelo B na Loja Ipê. Em cada linha, os Acertos e os Erros somam o total de Exemplos. No Teste, 90 acertos + 10 erros = 100 exemplos.
O conjunto de Teste contém exemplos separados do treinamento. A taxa de acerto do Teste é lida diretamente como 90 em 100 (90%): entre os 100 exemplos avaliados, o modelo acertou 90.
| Exemplos | Acertos | Erros | Taxa de acerto |
|---|---|---|---|
| Treino: 100 | 92 | 8 | 92 em 100 (92%) |
| Teste: 100 | 90 | 10 | 90 em 100 (90%) |
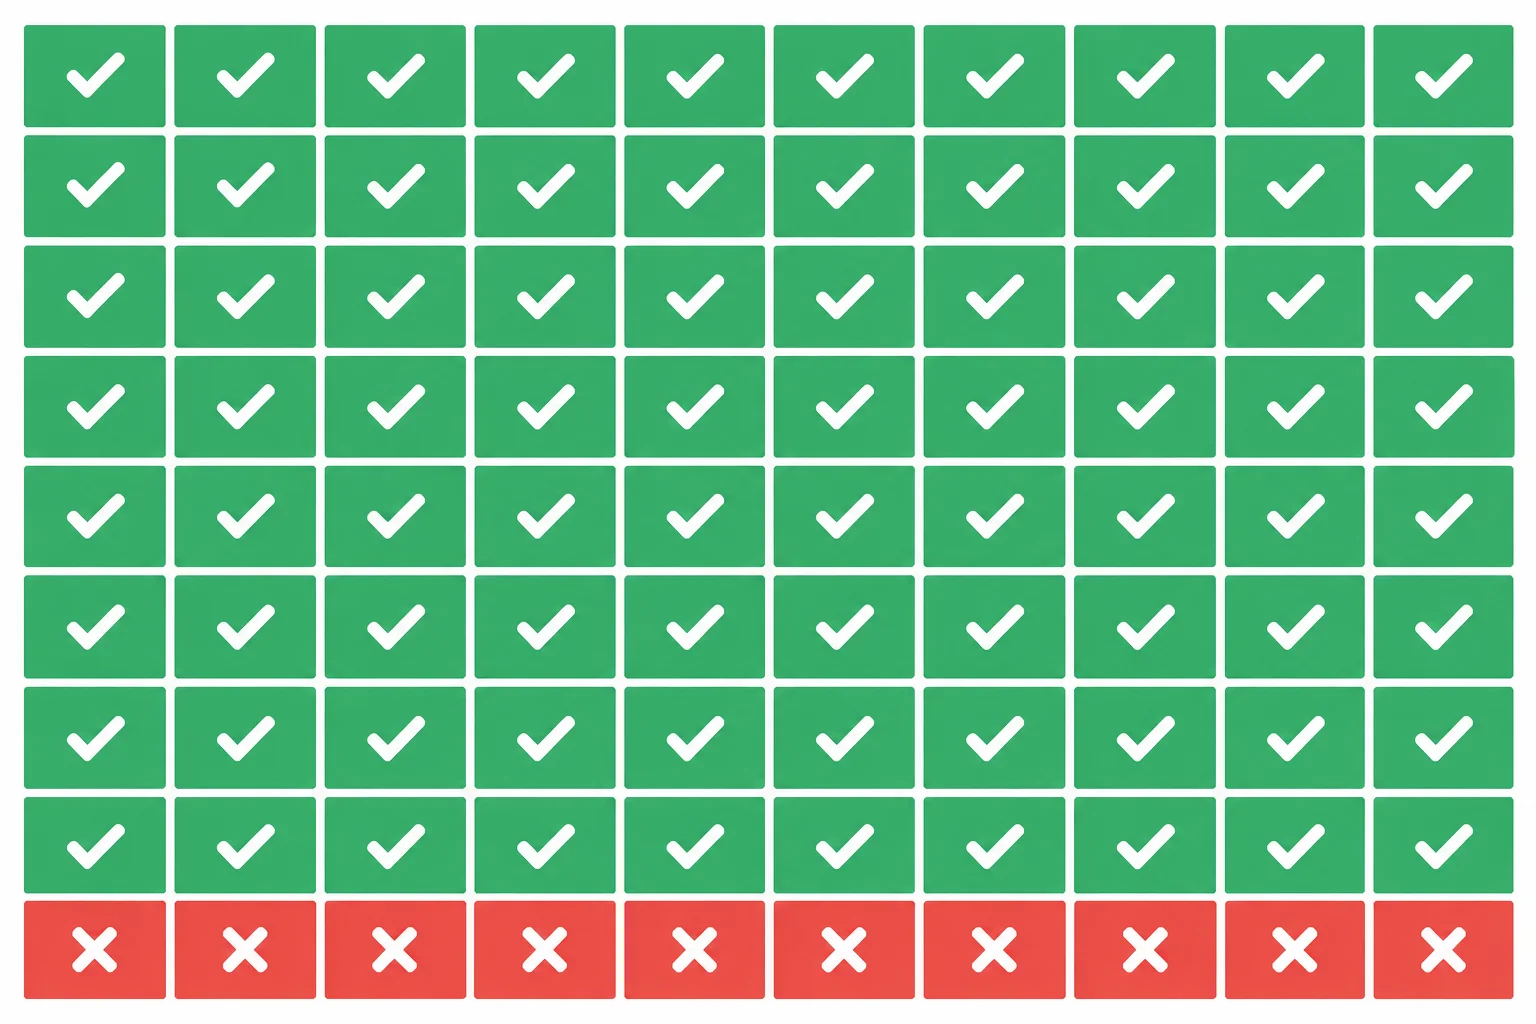
A taxa de acerto de 90% resume 90 acertos e 10 erros entre 100 exemplos avaliados.
Generalização é a capacidade de o modelo funcionar em exemplos novos, que não foram usados no treinamento. Por isso, o resultado no Teste ajuda a observar como o modelo se saiu em exemplos separados.
Dica
O resultado de 90 em 100 (90%) é uma evidência sobre os 100 exemplos avaliados e as condições desse teste. Ele não é uma promessa de que o modelo acertará toda mensagem futura. Para uma conclusão responsável, diga o que foi observado e mantenha claro o limite dessa observação.
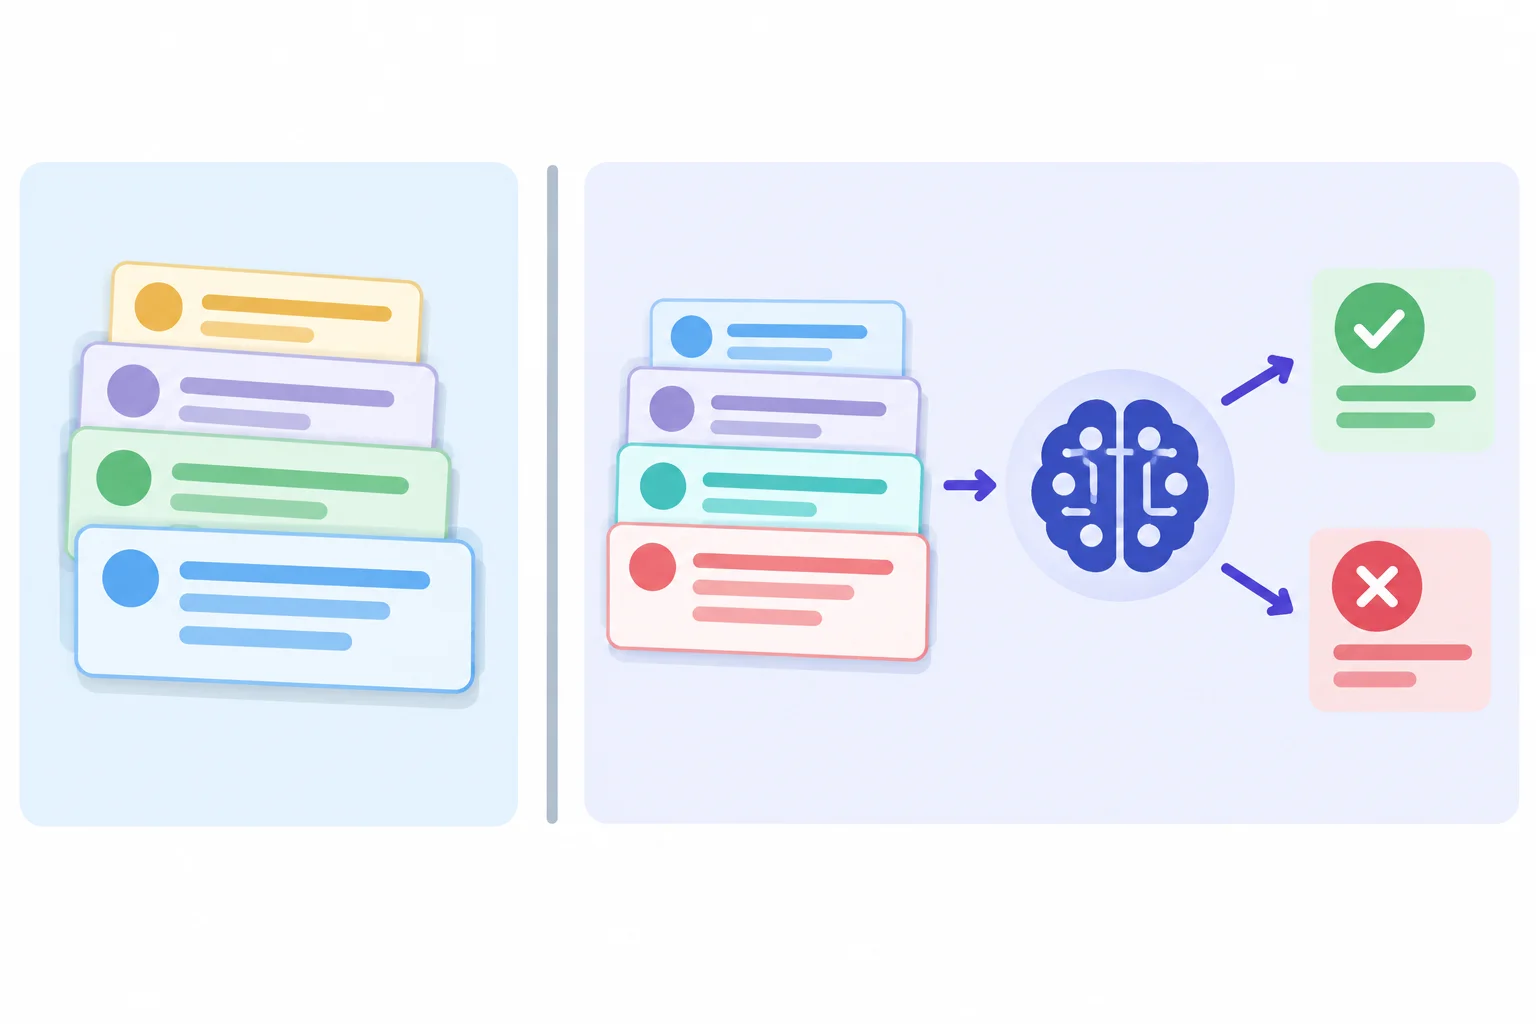
O Teste usa exemplos novos e separados para observar o desempenho do modelo nessa avaliação.
Na avaliação de Teste da Loja Ipê, o Modelo B obteve 90 em 100 (90%). Complete a leitura: quantos foram os acertos e os erros? Em seguida, escreva uma frase dizendo o que esse resultado permite observar e por que ele não garante acerto em toda mensagem futura.
Escreva pelo menos 80 caracteres (0/80).
Passo 2 de 6
Compare resultados de treino e teste para reconhecer sinais de possível sobreajuste, sem transformar uma diferença em diagnóstico definitivo.
Para comparar treino e teste, observe a mesma tarefa, o mesmo critério de acerto e contextos comparáveis. Aqui, os dois modelos classificam mensagens da Loja Ipê como Entrega ou Troca.
Os exemplos de teste foram separados do treino. Tanto treino quanto teste são mensagens do canal Site, em português e sem abreviações. Assim, a diferença entre os resultados ajuda a observar como cada modelo vai além dos exemplos usados para aprender.
Resultados do Modelo A nas mensagens da Loja Ipê.
| Exemplos | Acertos | Erros | Taxa de acerto |
|---|---|---|---|
| Treino: 100 | 98 | 2 | 98 em 100 (98%) |
| Teste: 100 | 70 | 30 | 70 em 100 (70%) |
Resultados do Modelo B nos mesmos tipos de mensagens da Loja Ipê.
| Exemplos | Acertos | Erros | Taxa de acerto |
|---|---|---|---|
| Treino: 100 | 92 | 8 | 92 em 100 (92%) |
| Teste: 100 | 90 | 10 | 90 em 100 (90%) |
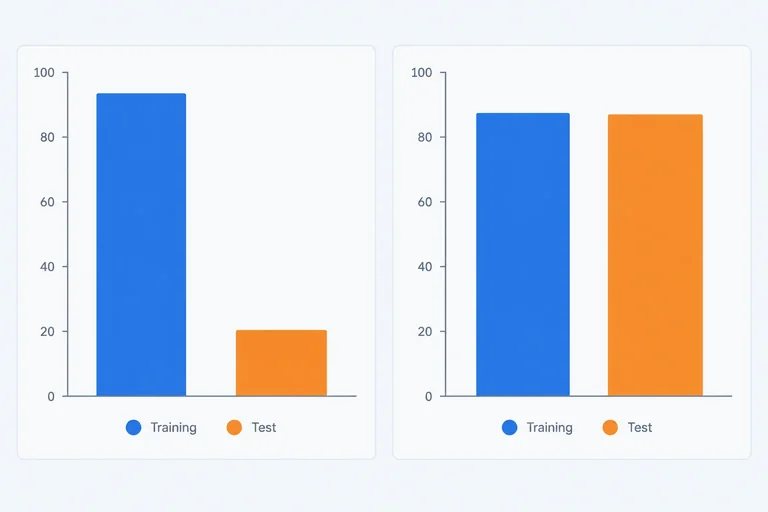
As barras usam a mesma escala: isso torna visível que a distância entre treino e teste é muito maior no Modelo A.
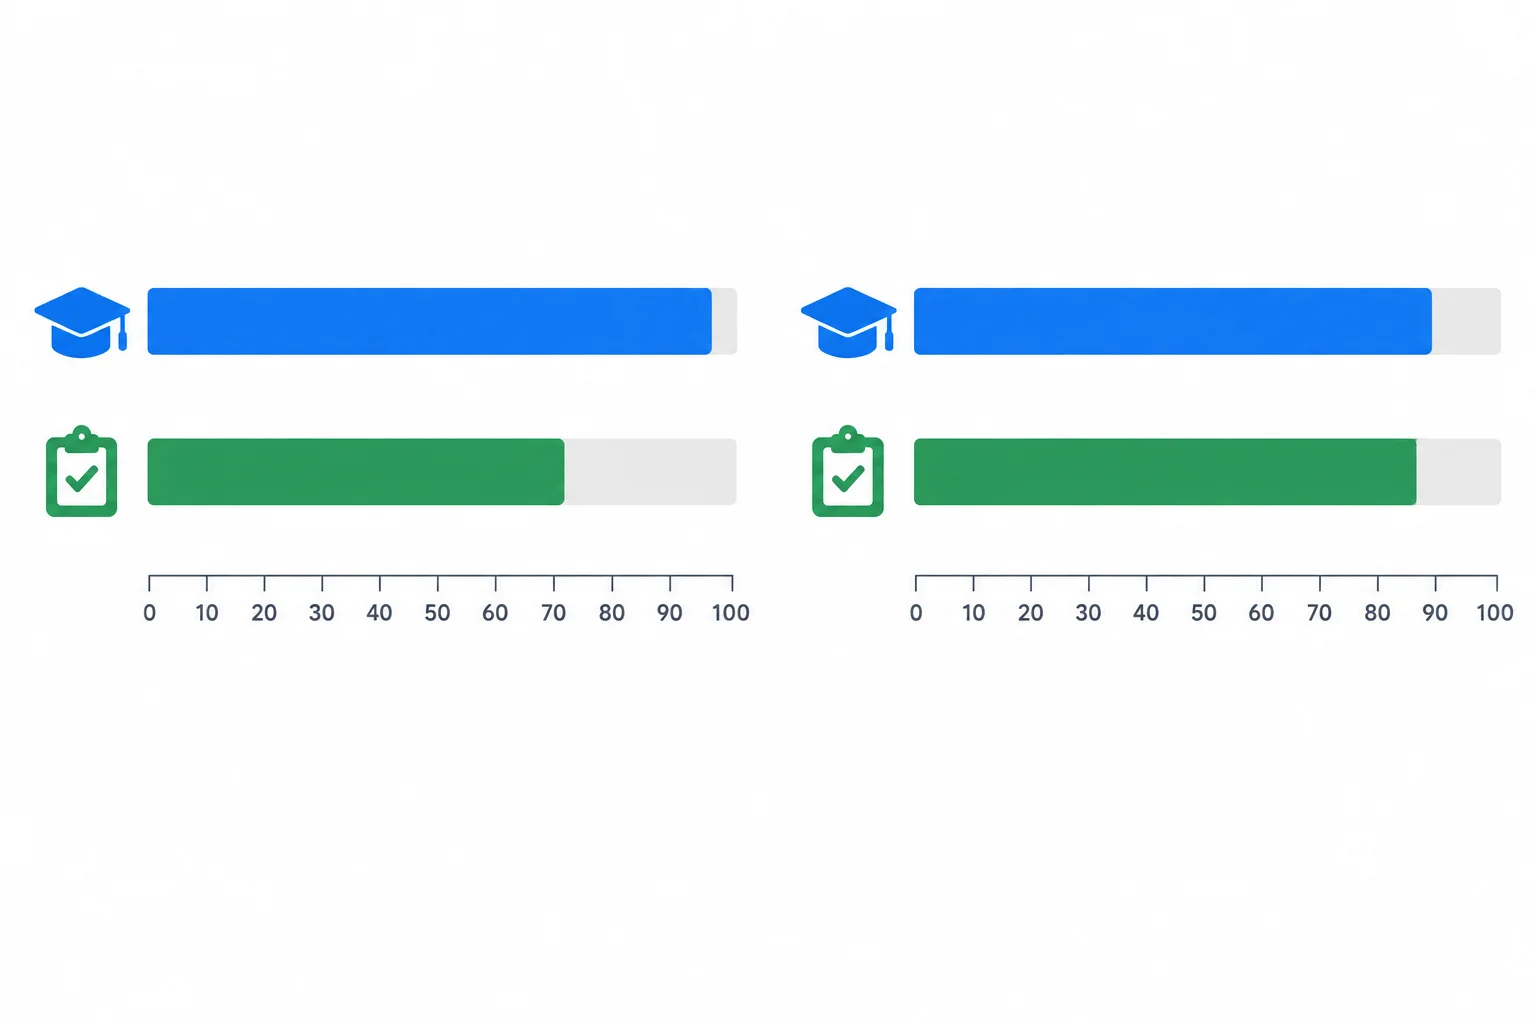
Uma grande distância entre treino e teste merece atenção; barras próximas indicam resultados mais semelhantes nessas condições.
Há sobreajuste (overfitting) quando o modelo se adapta demais aos exemplos de treino e tem mais dificuldade para generalizar para exemplos novos comparáveis.
O Modelo A acertou 98 em 100 (98%) no treino, mas 70 em 100 (70%) no teste: a diferença é grande. Esse padrão é um sinal de possível sobreajuste.
O Modelo B teve resultados próximos: 92 em 100 (92%) no treino e 90 em 100 (90%) no teste. Isso não prova que ele seja adequado para qualquer situação; apenas não mostra o mesmo sinal forte nessa comparação.
Exemplo
Um erro isolado no teste, ou uma pequena diferença entre treino e teste, não demonstra sobreajuste. Todo modelo pode errar alguns exemplos novos.
Também não é possível descobrir a causa exata de uma diferença apenas olhando essas taxas. O resultado observado sugere investigar, mas não prova sozinho por que o modelo teve mais erros no teste.
Dica
Ao comparar conjuntos separados, descreva primeiro o padrão observado: desempenho muito maior no treino, desempenho parecido entre os conjuntos ou outra diferença visível. Só depois trate isso como uma hipótese que precisa de mais investigação.
Qual leitura é mais bem sustentada pelos resultados apresentados?
Passo 3 de 6
Reconheça problemas em registros de dados e relacione cada um a possíveis efeitos no aprendizado ou na avaliação.
Uma avaliação depende dos registros e do rótulo de referência usados na comparação. Antes de explicar um resultado, vale inspecionar a tabela: pode haver informação ausente, um registro repetido ou uma referência que não combina com a mensagem.
Na tabela, a 2ª linha foi usada no Treino e a 3ª no Teste. Compare-as com atenção.
Amostra fictícia de mensagens da Loja Ipê. A 2ª e a 3ª linhas representam o mesmo registro em conjuntos diferentes.
| Canal | Mensagem | Rótulo de referência | Previsão do modelo |
|---|---|---|---|
| Site | Quero trocar o tamanho do item | Troca | Troca |
| Site | Meu pedido ainda não chegou | Entrega | Entrega |
| Site | Meu pedido ainda não chegou | Entrega | Entrega |
| Site | — | Troca | Entrega |
| Site | Quero devolver o produto | Entrega | Troca |
Registros repetidos, campos ausentes e referências possivelmente incorretas merecem atenção antes de tirar conclusões.
Um dado ausente pode retirar uma informação relevante para aprender ou avaliar. Uma duplicação acidental do mesmo registro pode dar peso excessivo àquele caso. Se o mesmo registro aparece no Treino e no Teste, o resultado do Teste pode parecer mais otimista, pois esse caso já estava presente no Treino.
Um rótulo de referência incorreto também importa: ele pode ensinar uma associação errada e pode transformar uma previsão adequada em um erro apenas na contagem da avaliação.
Exemplo
Mensagens parecidas não são automaticamente duplicações. Por exemplo, “Meu pedido 381 está atrasado” e “Meu pedido 992 ainda não chegou” tratam de Entrega, mas são registros diferentes.
Já duas linhas com os mesmos dados relevantes, repetidas sem intenção, merecem investigação. Na última linha da tabela anterior, a mensagem fala em devolução, mas o rótulo de referência é Entrega; isso sugere que a referência pode estar errada.
Atenção
Um problema encontrado na tabela é uma possível explicação, não uma prova de que ele causou todos os erros. É preciso separar o que foi observado do que ainda precisa ser verificado.
Relacione cada situação à interpretação ou ao possível efeito mais adequado.
Toque em um item e depois no par correspondente.
Passo 4 de 6
Entenda por que um bom resultado em um contexto avaliado não permite prever, sem evidência compatível, o desempenho em outro contexto de uso.
Representatividade é a presença, nos dados avaliados, dos tipos de situação relevantes para o uso pretendido.
Uma base pode ter registros corretos e ainda representar apenas parte do uso real. Na Loja Ipê, o Modelo B foi avaliado no canal Site, com mensagens em português sem abreviações. Esse resultado sustenta uma conclusão sobre mensagens novas com essas características — não sobre qualquer forma de contato.
O canal e o estilo das mensagens podem mudar. Para tirar conclusões sobre um contexto, a avaliação precisa incluir exemplos compatíveis com ele.
A tabela compara o que foi avaliado com um cenário adicional de uso da Loja Ipê.
| Contexto | Mensagens presentes na avaliação | O que o resultado permite observar |
|---|---|---|
| Site | Português sem abreviações | Desempenho em exemplos novos desse contexto |
| Aplicativo | Abreviações | Desempenho ainda não avaliado com essas características |
Exemplo
O Modelo B acertou 90 em 100 (90%) exemplos de teste no Site. Isso é uma boa evidência para novas mensagens do Site parecidas com as avaliadas.
Mas mensagens do Aplicativo com abreviações estão ausentes dessa avaliação. A ausência não prova que o modelo errará nelas; apenas impede concluir, com base nesses 100 exemplos, qual será seu desempenho nesse cenário.
O Modelo B acertou 90 em 100 (90%) no teste do Site. Portanto, seu desempenho no Aplicativo, onde há mensagens com abreviações, também é de 90%.
Essa conclusão é sustentada pelos dados?
Passo 5 de 6
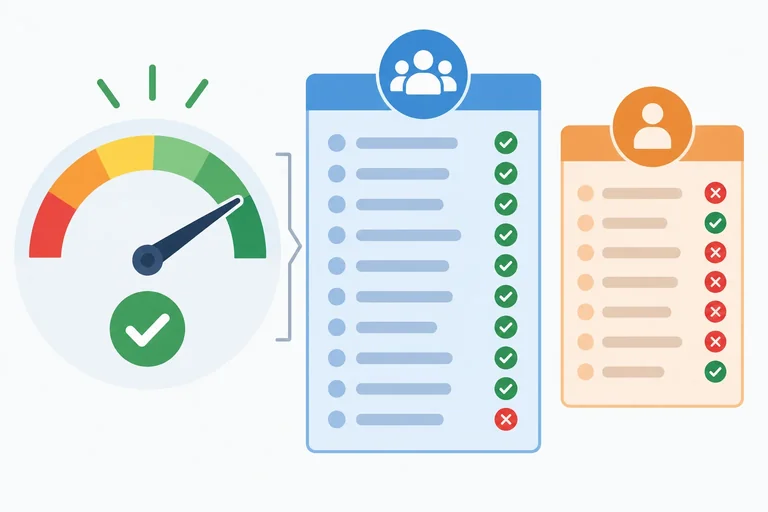
No teste do Modelo B, com 100 mensagens do canal Site, houve 90 acertos e 10 erros. A taxa geral de acerto é um resumo de todas as categorias juntas: 90 em 100 (90%).
Esse resumo mostra o desempenho observado no conjunto inteiro, mas ainda não informa se Entrega e Troca tiveram o mesmo resultado.
Resultado agregado do Modelo B no conjunto de Teste.
| Conjunto | Exemplos | Acertos | Erros | Taxa de acerto |
|---|---|---|---|---|
| Teste | 100 | 90 | 10 | 90 em 100 (90%) |
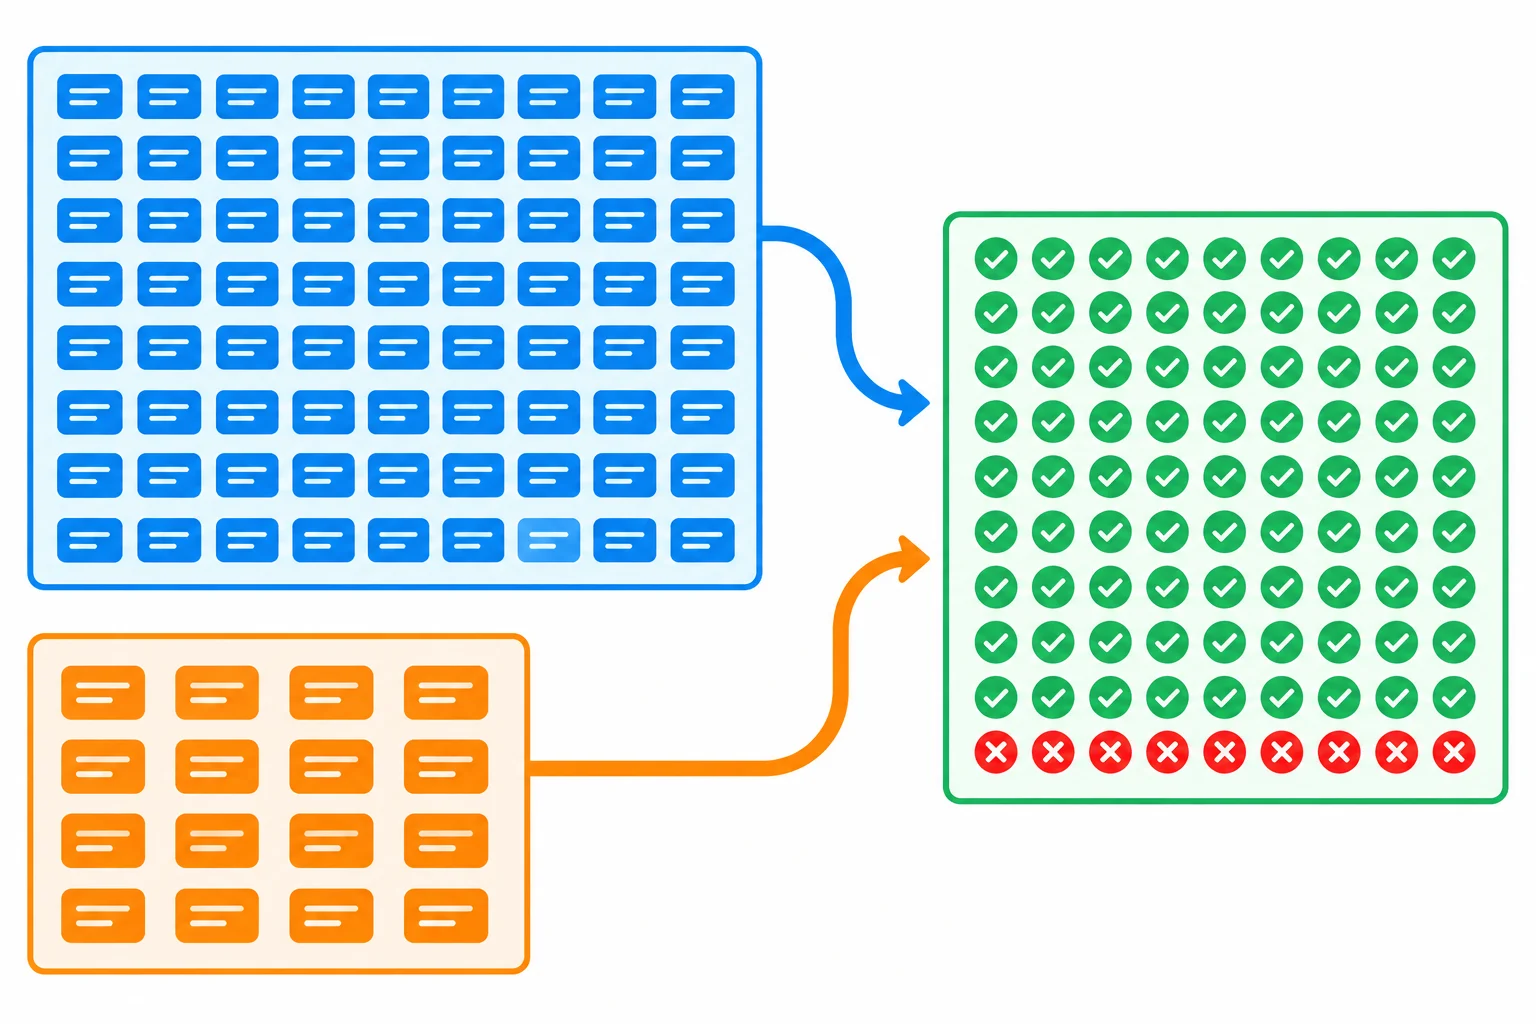
Como Entrega tem mais exemplos que Troca, seu resultado participa mais da taxa geral.
Ao separar o teste pelo Rótulo de referência, aparece uma diferença que os 90% gerais escondem.
Entrega teve 76 acertos em 80 exemplos: 76 em 80 (95%). Troca teve 14 acertos em 20 exemplos: 14 em 20 (70%). As taxas permitem comparar categorias mesmo quando seus totais são diferentes.
Resultados do Modelo B no conjunto de Teste, agrupados pelo Rótulo de referência.
| Rótulo de referência | Exemplos | Acertos | Erros | Taxa de acerto |
|---|---|---|---|---|
| Entrega | 80 | 76 | 4 | 76 em 80 (95%) |
| Troca | 20 | 14 | 6 | 14 em 20 (70%) |
Exemplo
A limitação observada é o desempenho menor em Troca. Embora Troca tenha menos exemplos, seus 6 erros representam uma parcela maior de seu grupo do que os 4 erros de Entrega representam do grupo de Entrega.
Os 90% gerais não descrevem igualmente as duas categorias. Eles não revelam, por si só, a causa do resultado inferior em Troca.
Complete com a taxa de acerto observada para a categoria de desempenho inferior: ____
Escreva um parecer breve, em duas frases, sobre o teste do Modelo B. Identifique a categoria com desempenho inferior e cite uma evidência numérica da tabela. Depois, explique por que a taxa geral de acerto não descreve igualmente as duas categorias.
Escreva pelo menos 100 caracteres (0/100).
Passo 6 de 6
Integre resultados de Treino e Teste, qualidade dos dados, representatividade e desempenho por categoria em um parecer breve e responsável.
Um parecer crítico não tenta explicar tudo de uma vez. Organize a leitura em três partes:
Assim, um resultado alto no Teste pode sustentar uma conclusão sobre aqueles exemplos avaliados, mas não sobre qualquer mensagem que a Loja Ipê venha a receber.
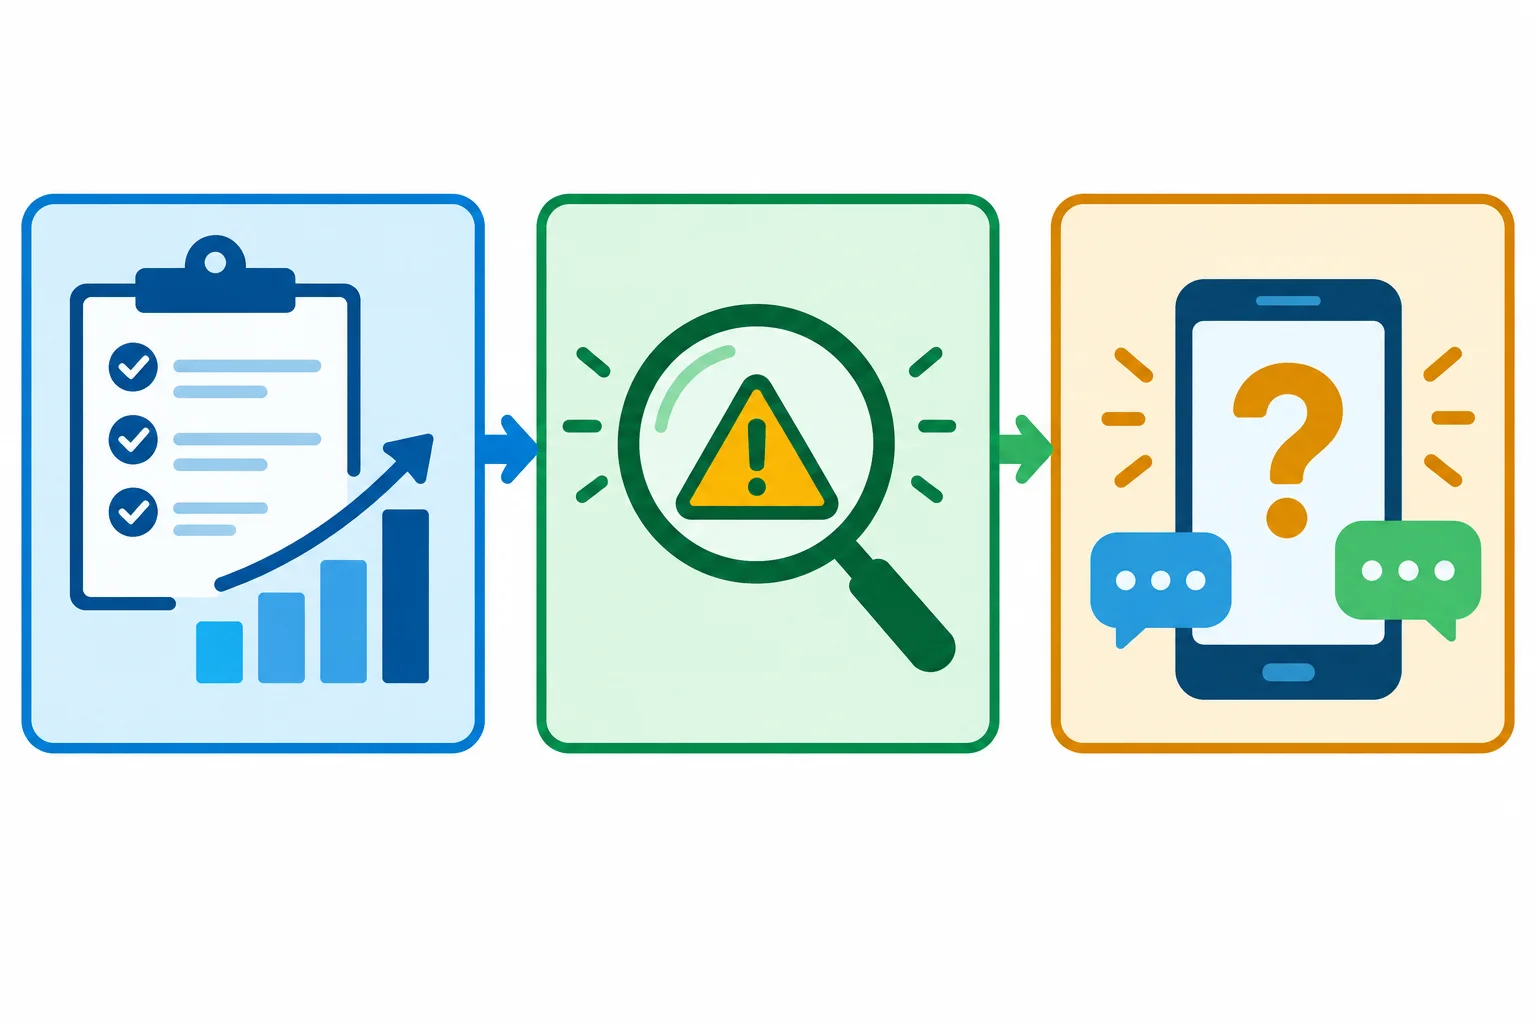
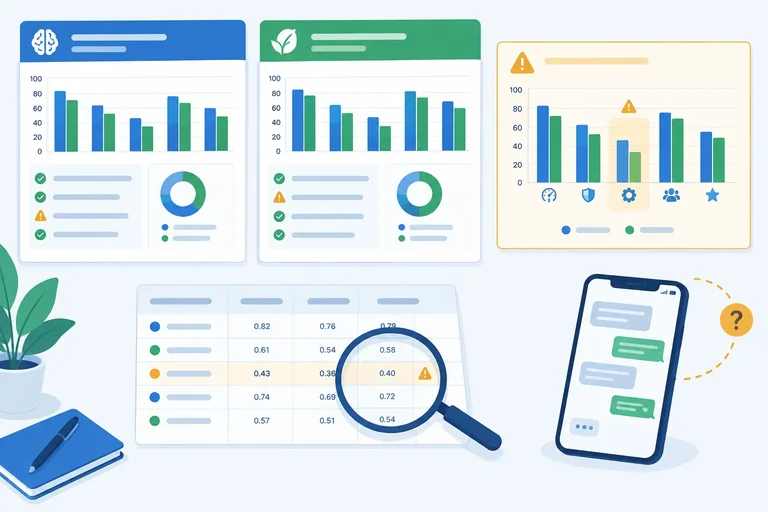
Uma leitura crítica separa evidência observada, pontos de atenção e informação ainda desconhecida.
Os dois modelos foram avaliados nos mesmos exemplos de Teste, separados do Treino. Isso permite comparar seus resultados nessas condições. O Modelo A tem uma diferença grande entre Treino e Teste: é um sinal de possível sobreajuste, mas a tabela não revela sozinha a causa. O Modelo B teve o melhor resultado observado no Teste; ainda assim, essa conclusão vale para a tarefa e o contexto avaliados.
Resultados da classificação de mensagens da Loja Ipê nas categorias Entrega e Troca.
| Modelo e conjunto | Exemplos | Acertos | Erros | Taxa de acerto |
|---|---|---|---|---|
| Modelo A — Treino | 100 | 98 | 2 | 98 em 100 (98%) |
| Modelo A — Teste | 100 | 70 | 30 | 70 em 100 (70%) |
| Modelo B — Treino | 100 | 92 | 8 | 92 em 100 (92%) |
| Modelo B — Teste | 100 | 90 | 10 | 90 em 100 (90%) |
Exemplo
Resultado observado: o Modelo B acertou mais exemplos no Teste do que o Modelo A.
Possível explicação: se houver um registro repetido entre Treino e Teste, a avaliação pode ficar otimista.
Ainda desconhecido: esse problema explica os erros do modelo? Não necessariamente. É preciso verificar os registros e avaliar exemplos adequados.
Dica
Evite trocar “melhor resultado observado no Teste” por “melhor para qualquer uso”. Uma conclusão responsável sempre informa as condições da avaliação.
Escreva um parecer de 4 a 6 frases sobre esta ficha da Loja Ipê.
Condições da avaliação: os conjuntos de Treino e Teste são separados; o Teste contém mensagens do canal Site, em português e sem abreviações.
Modelo A: Treino: 98 acertos e 2 erros em 100 exemplos, taxa de acerto de 98 em 100 (98%). Teste: 70 acertos e 30 erros em 100 exemplos, taxa de acerto de 70 em 100 (70%).
Modelo B: Treino: 92 acertos e 8 erros em 100 exemplos, taxa de acerto de 92 em 100 (92%). Teste: 90 acertos e 10 erros em 100 exemplos, taxa de acerto de 90 em 100 (90%). No Teste do Modelo B, Entrega teve 76 acertos e 4 erros em 80 exemplos, taxa de acerto de 76 em 80 (95%); Troca teve 14 acertos e 6 erros em 20 exemplos, taxa de acerto de 14 em 20 (70%).
Revisão dos dados: foi encontrado um registro idêntico presente no Treino e no Teste e há um rótulo de referência que parece precisar de revisão.
Novo cenário: a Loja Ipê pretende usar o modelo no Aplicativo, onde as mensagens incluem abreviações; não há resultados desse canal.
Seu parecer deve indicar: o sinal visto no Modelo A; qual resultado do Modelo B é melhor observado; a limitação em Troca; o que os indícios dos dados podem afetar; e o que ainda falta verificar para o Aplicativo. Não afirme uma causa como se estivesse comprovada.
Escreva pelo menos 320 caracteres (0/320).
Resumo
Parabéns! Você concluiu: Como interpretar erros e limites de um modelo
Você concluiu este nível!
Agora você vai iniciar: Modelos generativos e prompts eficazes
 Como modelos de linguagem geram respostasEntenda como um modelo de linguagem produz respostas a partir de padrões aprendidos. Com exemplos curtos, você será capaz de explicar tokens e janela de contexto, reconhecer limites de conversas extensas e distinguir uma resposta convincente de uma informação verificada.
Milhares de cursos online em vídeo, ebooks e áudiobooks.
Para testar seus conhecimentos no decorrer dos cursos online
Gerado diretamente na galeria de fotos do seu celular e enviado ao seu e-mail

Baixe nosso aplicativo pelo QR Code ou pelos links abaixo:.



Leve o conhecimento no seu bolso.
Baixe o aplicativo Cursa.
São centenas de Cursos gratuitos a disposição, com Certificado de conclusão gratuito que é salvo em sua galeria de imagens do celular.
Baixe o app para ter acesso ao Certificado de conclusão de Curso Gratuitamente.


+ de 10 milhões
de alunos

Certificado grátis e
válido em todo o Brasil

60 mil exercícios
gratuitos

4,8/5 classificação
nas lojas de apps

Cursos gratuitos em
vídeo, ebooks e audiobooks