

Ao longo do livro você aprendeu a instalar, configurar, dirigir e estender o Codex. Neste capítulo final, o objetivo é diferente: sair com um conjunto de critérios de julgamento para usar essa ferramenta todos os dias sem colocar em risco o seu código, os dados da sua empresa e o seu orçamento. Ao terminar, você saberá revisar com método, identificar respostas inventadas, proteger segredos, pensar em licenças, evitar as falhas de segurança mais comuns, controlar custo e medir se o ganho de produtividade é real.
Quem assina o código é você
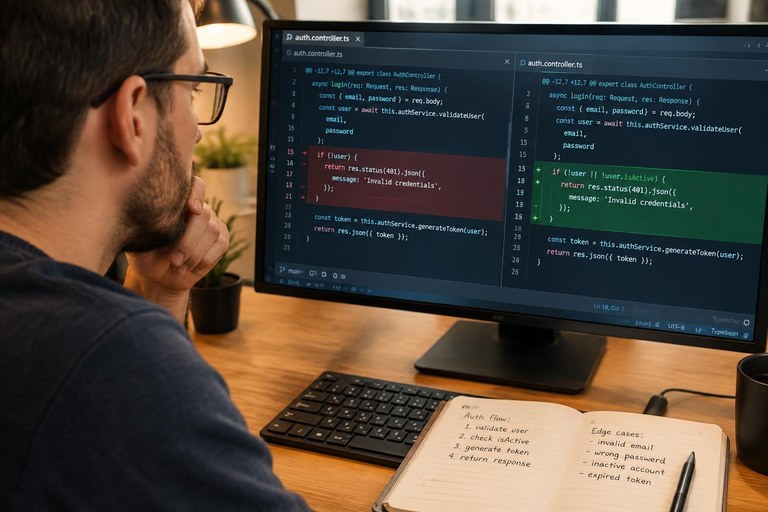
Comece por aqui, porque todo o resto depende disso. O Codex não tem responsabilidade profissional, não responde a um cliente e não é chamado às três da manhã quando o sistema cai. Quando um diff entra na branch principal com o seu nome no commit, o autor é você. Isso tem uma consequência prática e desconfortável: não existe código gerado que você possa integrar sem entender. Se você não é capaz de explicar em voz alta o que uma função faz e por que ela faz assim, ela ainda não está pronta para ser aceita, mesmo que os testes passem.
A regra que resume o capítulo é simples. A velocidade do agente é enorme na escrita e nula na responsabilidade. Você compra tempo na digitação e paga esse tempo em leitura atenta. Quem tenta economizar nos dois lados acumula dívida técnica em ritmo acelerado.
Um roteiro de revisão em três camadas
Revisar todo diff não significa revisar tudo do mesmo jeito. Use três camadas, sempre na mesma ordem.
- Camada de intenção. O diff resolve o problema que você pediu, e só ele? Arquivos fora do escopo, dependências novas, configurações alteradas e testes modificados são sinais de alerta que você já aprendeu a procurar.
- Camada de correção. A lógica está certa nos limites? Verifique valores nulos, listas vazias, números negativos, fuso horário, arredondamento de dinheiro e erros tratados de forma silenciosa.
- Camada de consequência. O que acontece em produção com dez mil registros, com a rede lenta, com dois usuários simultâneos? Essa camada é a que o agente erra mais, porque ele não conhece a escala real do seu sistema.
Se o diff for grande demais para as três camadas, o problema não é a revisão, é o tamanho do pedido. Volte e divida.
- Ouça o áudio com a tela desligada
- Ganhe Certificado após a conclusão
- + de 5000 cursos para você explorar!

Baixar o aplicativo
Como reconhecer uma alucinação
Você já sabe que o Codex pode alucinar. O que falta é um método rápido de detecção. As alucinações aparecem quase sempre em três formas.
A primeira é a API inexistente: um método com nome plausível que a biblioteca nunca teve, ou que existia em uma versão antiga. A defesa é conferir na documentação oficial da versão que está no seu arquivo de dependências, e não na documentação mais recente do site.
A segunda é a dependência inventada, um pacote que não existe no repositório público. Isso cria um risco de segurança real, conhecido como typosquatting de pacotes alucinados (em inglês, slopsquatting): atacantes observam nomes de pacotes sugeridos por ferramentas de inteligência artificial e publicam pacotes maliciosos com exatamente esses nomes. Não confunda com a confusão de dependência, que é outro ataque, no qual alguém registra no repositório público o nome de um pacote interno da empresa para que o gerenciador baixe a versão maliciosa. Nunca instale um pacote só porque o agente escreveu o nome dele. Verifique antes:
npm view nome-do-pacote versions
pip index versions nome-do-pacote
Atenção: pip index versions é um comando experimental e exige pip 21.2 ou mais recente. Se ele não funcionar na sua versão, não conclua que o pacote não existe: consulte a página oficial do pacote no PyPI antes de instalar.
Olhe também data da última publicação, número de downloads e o repositório de origem. Um pacote com o nome perfeito, criado há duas semanas e sem histórico, é motivo para parar.
A terceira forma é a mais sutil: a explicação confiante e errada sobre o seu próprio código. Contra ela, use as perguntas de controle e a conferência das citações que você aprendeu no capítulo de análise de código. Um bom hábito é pedir ao agente o trecho exato, com arquivo e linha, que sustenta cada afirmação importante. Se ele não conseguir citar, provavelmente não existe.
Segredos, dados sensíveis e política da empresa
Tudo que está na pasta de trabalho pode ser lido pelo agente e enviado ao modelo. Portanto:
- Mantenha credenciais em variáveis de ambiente e arquivos ignorados pelo Git, nunca em arquivos de exemplo versionados. Lembre-se de que estar no .gitignore não impede o agente de abrir o arquivo: segredos de produção devem ficar em um gerenciador de segredos ou em um arquivo fora da pasta de trabalho.
- Não cole trechos de banco de dados de produção, documentos de clientes ou dados pessoais em um prompt. Se precisar de dados para depurar, anonimize antes.
- Ative varredura de segredos no repositório, isto é, uma verificação automática que bloqueia commits contendo chaves e senhas. Ela protege contra o seu descuido e contra o do agente. E se um segredo escapar, remover o arquivo ou reescrever o histórico não basta: revogue a chave imediatamente e gere uma nova, porque ela pode já ter sido copiada por terceiros.
- Antes de usar o Codex em código da empresa, confirme a política interna: quais repositórios podem ser processados por serviços externos, se a conta corporativa desativa treinamento com os seus dados e quais setores têm restrição contratual ou regulatória.
Sobre licenças, o cuidado é duplo. O código sugerido pode reproduzir trechos de projetos com licença copyleft. No copyleft forte, como a GPL, o trabalho derivado precisa ser distribuído sob a mesma licença; em licenças de copyleft fraco, como LGPL e MPL, a obrigação é mais limitada e recai sobre os arquivos ou a biblioteca modificada. E as dependências que o agente adiciona vêm com licenças próprias. Trate qualquer inclusão de biblioteca como decisão de arquitetura: confira a licença e registre no AGENTS.md quais são aceitas no projeto. Nada disso é orientação jurídica: em produto comercial ou em caso de dúvida sobre compatibilidade de licenças, consulte o time jurídico da sua empresa.
Vulnerabilidades que aparecem com frequência
O modelo otimiza para código que funciona no caminho feliz, não para código hostil ao atacante. Estas são as falhas que mais aparecem e como procurá-las no diff.
| Falha | Como aparece no código gerado | Como verificar |
|---|---|---|
| Injeção em consultas | Consulta montada com concatenação de texto | Exigir parâmetros ligados à consulta, nunca interpolação |
| Autorização ausente | Rota que checa login, mas não checa se o recurso é do usuário | Teste com dois usuários diferentes |
| Validação frouxa de entrada | Aceita qualquer campo recebido e grava direto | Conferir esquema de entrada e limites de tamanho |
| Segredo no código | Chave ou senha em constante para "facilitar o teste" | Varredura de segredos e revisão de configuração |
| Erro engolido | Bloco que captura exceção e segue em silêncio | Exigir registro de log e propagação |
| Dependência desatualizada | Versão antiga fixada por hábito do modelo | Auditoria de vulnerabilidades do gerenciador de pacotes |
Uma prática que rende muito: depois de implementar algo exposto à internet, abra uma sessão nova em modo somente leitura e peça uma revisão de segurança focada, pedindo especificamente autorização, validação e tratamento de erros. Com perguntas específicas o agente encontra problemas óbvios, mas tende a repetir os próprios pontos cegos ao revisar o que ele mesmo escreveu, por isso essa revisão não substitui ferramentas de análise estática, auditoria de vulnerabilidades das dependências e revisão humana.
Custo, limites de uso e escolha do modelo
O consumo do Codex se mede em tokens, que são os pedaços de texto em que o modelo divide tudo que lê e escreve. A janela de contexto é o total de tokens que o modelo consegue considerar de uma vez. Duas consequências práticas: sessões longas custam mais, porque a conversa inteira volta a ser lida; e qualidade cai quando o contexto fica cheio de material irrelevante.
Para gastar menos e acertar mais:
- Uma conversa por tarefa. Pedidos independentes em conversas novas.
- Escopo estreito. Aponte arquivos em vez de deixar o agente varrer o repositório.
- Poucos servidores MCP ativos ao mesmo tempo.
- Nível de raciocínio alto só quando o problema é difícil. Para renomear, escrever um teste simples ou ajustar documentação, o nível baixo entrega igual e responde mais rápido.
Na escolha do modelo, use o tipo de tarefa como guia. Tarefas mecânicas e de grande volume pedem o modelo mais rápido e barato. Depuração de causa raiz, planejamento de arquitetura e migrações pedem o modelo de raciocínio mais forte. Quando bater o limite de uso do seu plano, primeiro verifique se os pedidos não estão amplos demais; em alguns casos, porém, o limite realmente reflete um plano insuficiente para o seu volume de trabalho.
Medindo ganho real de produtividade
A sensação de velocidade engana. Quem mede, descobre onde o agente ajuda de verdade. Acompanhe por algumas semanas, mesmo que de forma simples, quatro indicadores: tempo do pedido até o pull request aprovado, quantidade de rodadas de correção por pull request, proporção de diffs do agente que você descartou e número de defeitos encontrados depois da entrega. Se o tempo de escrita cai mas as rodadas de revisão sobem, você apenas moveu o trabalho de lugar.
Na prática, o ganho tende a ser grande em tarefas bem especificadas e repetitivas, e pequeno ou negativo em problemas mal definidos, em sistemas que você não conhece e em decisões de produto. Isso é informação valiosa: use o agente onde ele ganha e assuma o volante onde ele perde.
Hábitos para continuar evoluindo
- Escreva a especificação antes do prompt, sempre que a tarefa passar de trivial.
- Promova para o AGENTS.md todo aprendizado que se repetiu duas vezes.
- Reserve tempo para ler código sem o agente. A sua capacidade de revisar é o teto da sua capacidade de usar a ferramenta.
- Releia as notas de versão do Codex de vez em quando, porque comandos e padrões mudam.
- Faça um retrospecto mensal: quais tarefas delegar mais, quais parar de delegar.
Recapitulando
Você é o responsável final pelo código, e por isso revisa em três camadas: intenção, correção e consequência. Alucinações aparecem como APIs inexistentes, dependências inventadas e explicações confiantes sem citação, e todas se combatem com verificação na fonte. Segredos e dados pessoais ficam fora dos prompts e do repositório, com varredura automática ativa. Licenças e política da empresa entram na decisão antes de qualquer dependência nova. As vulnerabilidades típicas do código gerado são previsíveis e podem ser procuradas com uma lista curta. Custo se controla com escopo estreito, conversas separadas e nível de raciocínio ajustado ao tipo de tarefa. E ganho de produtividade só existe quando medido, não quando sentido.